Lernpfad
Entwicklung von KI-Anwendungen
21 Std.
Stell dir ein KI-Modell als Team von Spezialistinnen und Spezialisten vor, jeweils mit eigener Expertise. Ein Mixture-of-Experts-(MoE)-Modell arbeitet nach diesem Prinzip, indem es eine komplexe Aufgabe auf kleinere, spezialisierte Netzwerke – die „Expertinnen und Experten“ – verteilt.
Jede Expertin bzw. jeder Experte konzentriert sich auf einen spezifischen Aspekt des Problems. So lässt sich die Aufgabe effizienter und präziser lösen. Ähnlich wie Ärztin, Mechaniker und Köchin – jede Person übernimmt, worin sie am besten ist.
Durch Zusammenarbeit lösen diese Spezialisten ein breiteres Spektrum an Problemen effektiver als ein einzelnes Generalistenmodell.
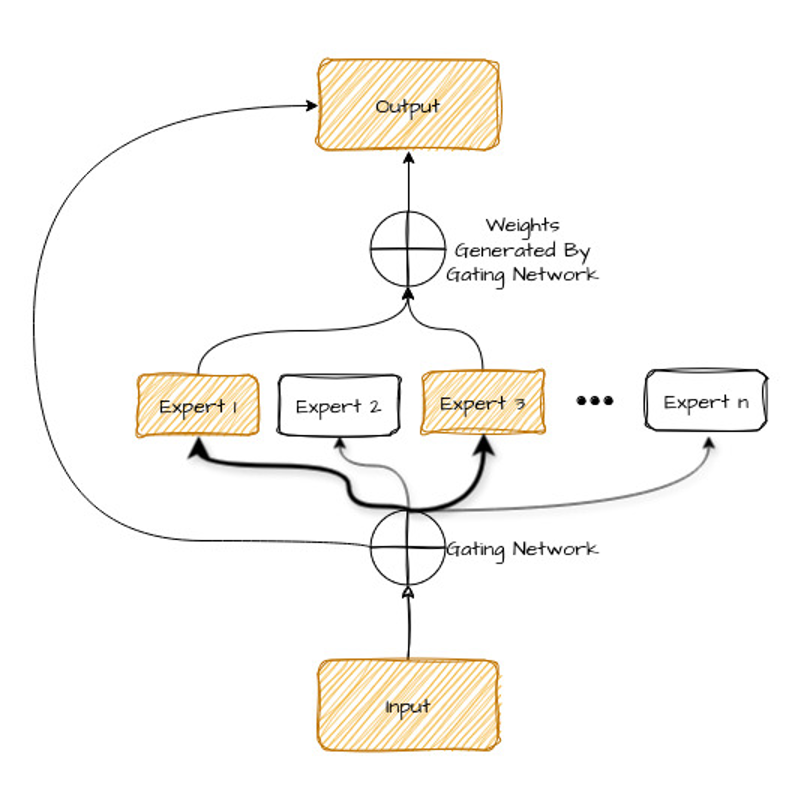
Schau dir die Grafik unten an – gleich erklären wir sie im Detail.
Zerlegen wir die Bestandteile der Grafik:
Die Vorteile von MoE sind:
Schauen wir uns nun Expertennetze und Gating-Netzwerke genauer an.
Die „Expertennetze“ in einem MoE-Modell sind wie ein Team von Spezialistinnen und Spezialisten. Statt ein einzelnes KI-Modell alles erledigen zu lassen, fokussiert sich jede Expertin bzw. jeder Experte auf eine bestimmte Art von Aufgabe oder Daten.
In einem MoE-Modell sind diese Expertinnen und Experten einzelne Neuronale Netze, die jeweils auf unterschiedlichen Datensätzen oder Aufgaben trainiert wurden.
Sparsity ist dabei gewollt: Nur wenige Expertinnen und Experten sind gleichzeitig aktiv – abhängig vom Input. So wird das System nicht überlastet und die relevantesten Personen arbeiten am Problem.
Woher weiß das Modell, wen es auswählt? Hier kommt das Gating-Netzwerk ins Spiel.
Das Gating-Netzwerk (der Router) ist ein weiteres Neuronales Netz. Es lernt, den Input (z. B. einen zu übersetzenden Satz) zu analysieren und zu entscheiden, welche Expertinnen und Experten ihn am besten bearbeiten.
Dazu weist es jeder Expertin bzw. jedem Experten ein Gewicht bzw. einen Wichtigkeitsscore zu – basierend auf den Eigenschaften des Inputs. Die höchsten Gewichte werden ausgewählt und verarbeiten die Daten.
Es gibt verschiedene Wege (sogenannte „Routing-Algorithmen“), wie das Gating-Netzwerk passende Expertinnen und Experten auswählt. Häufig sind:
Während der Vorhersage kombiniert das Modell die Ausgaben der Expertinnen und Experten – nach demselben Prinzip, nach dem es die Aufgaben verteilt hat. Je nach Komplexität können für eine Aufgabe mehrere Expertinnen und Experten nötig sein.
Schauen wir uns nun an, wie ein MoE konkret funktioniert.
MoE arbeitet in zwei Phasen:
Ähnlich wie bei anderen Machine-Learning-Modellen startet MoE mit dem Training auf einem Datensatz. Allerdings wird nicht das gesamte Modell auf einmal trainiert, sondern seine Komponenten separat.
Jede Komponente im MoE-Framework wird auf einem spezifischen Datenausschnitt oder einer Teilaufgabe trainiert. Ziel ist, dass jede Komponente einen klaren Fokus im Gesamtproblem bekommt.
Das gelingt, indem jede Komponente Daten erhält, die zu ihrer Aufgabe passen. In der Sprachverarbeitung könnte eine Komponente etwa Syntax, eine andere Semantik lernen.
Das Training folgt dem üblichen Ablauf für Neuronale Netze: Minimierung der Loss-Funktion auf dem jeweiligen Datenteil.
Das Gating-Netzwerk lernt, für einen gegebenen Input die passendste Expertin bzw. den passendsten Experten auszuwählen.
Beim Training wird es gemeinsam mit den Expert:innen-Netzen optimiert. Es erhält denselben Input und lernt, eine Wahrscheinlichkeitsverteilung über die Expertinnen und Experten vorherzusagen – also, wer den aktuellen Input am besten bearbeiten kann.
Typischerweise wird es mit Optimierungsverfahren trainiert, die sowohl die Güte der Auswahl als auch die Performance der gewählten Expertinnen und Experten berücksichtigen.
In der Phase des gemeinsamen Trainings wird das gesamte MoE-System – also Expertinnen-/Experten-Modelle und Gating-Netzwerk – zusammen optimiert.
So wird sichergestellt, dass Auswahl und Expertise harmonieren. Die Loss-Funktion kombiniert die Verluste der Einzelnetze und des Gating-Netzwerks und fördert eine gemeinsame Optimierung.
Die kombinierten Gradienten werden sowohl durch das Gating-Netzwerk als auch die Expert:innen-Modelle zurückpropagiert und verbessern die Gesamtleistung des MoE-Systems.
Inferenz bedeutet, Ausgaben zu generieren, indem Kontext aus dem Gating-Netzwerk mit den Ergebnissen der Expertinnen und Experten kombiniert wird. In MoE ist der Prozess so gestaltet, dass die Inferenzkosten gering bleiben.
Im MoE-Kontext entscheidet das Gating-Netzwerk maßgeblich, welche Modelle einen bestimmten Input verarbeiten sollen.
Nach Eingang eines Inputs bewertet es diesen und erstellt eine Wahrscheinlichkeitsverteilung über alle Modelle. Diese Verteilung leitet den Input an die geeignetsten Modelle weiter – basierend auf den Mustern, die im Training gelernt wurden. So kommt für jede Aufgabe die richtige Expertise zum Einsatz und die Entscheidungen werden optimiert.
Nur eine kleine Auswahl an Modellen – meist eines oder wenige – wird für jeden Input aktiviert. Die Auswahl richtet sich nach den Wahrscheinlichkeiten des Gating-Netzwerks.
Wenige Modelle pro Input zu wählen, spart Ressourcen und nutzt trotzdem das Spezialwissen im MoE.
Die Ausgabe des Gating-Netzwerks stellt sicher, dass die gewählten Modelle am besten zum Input passen – das steigert Effizienz und Leistung.
Der letzte Schritt der Inferenz fasst die Ausgaben der ausgewählten Modelle zusammen.
Oft geschieht das per gewichteten Mittelwerten, wobei die Gewichte aus den Wahrscheinlichkeiten des Gating-Netzwerks stammen. In manchen Fällen kommen Alternativen wie Voting oder gelernte Kombinationsmethoden zum Einsatz. Ziel ist eine einheitliche, präzise Vorhersage, die die Stärken der MoE-Architektur bündelt.
Mit dem rasanten technologischen Fortschritt wächst der Bedarf an schnellen, effizienten und optimierten Verfahren für große Modelle. MoE etabliert sich hier als vielversprechender Ansatz. Welche weiteren Vorteile bringt MoE?
Die MoE-Architektur bietet mehrere Stärken:
Dass MoEs seit 30 Jahren existieren, hat sie zu einer weitverbreiteten Technik in verschiedenen Bereichen des Machine Learnings gemacht.
MoE ermöglicht das Training großer Modelle effizienter – mit schnellerem Pretraining und wettbewerbsfähigen Inferenzzeiten.
In klassischen dichten Modellen werden alle Parameter für alle Inputs genutzt. Sparsity erlaubt dagegen, je nach Input nur Teile des Systems auszuführen – das reduziert die Rechenlast deutlich.
Ein Beispiel ist Microsofts Übersetzungs-API Z-code. Die MoE-Architektur in Z-code unterstützt eine enorme Anzahl an Modellparametern, während der Rechenaufwand konstant bleibt.
Googles V-MoEs – eine Sparse-Architektur auf Basis von Vision-Transformers (ViT) – zeigen die Wirksamkeit von MoE bei CV-Aufgaben.
Indem Bilder in kleine Patches zerlegt und durch eine Gating-/Routing-Schicht geschickt werden, wählen V-MoEs dynamisch die passendsten Expertinnen und Experten je Patch – für mehr Genauigkeit und Effizienz.
Ein großer Vorteil ist die Flexibilität: Du kannst die Anzahl der pro Token ausgewählten Expertinnen und Experten reduzieren, um Zeit und Compute zu sparen – ohne die Modellgewichte nachzutrainieren.
MoE wird auch in Empfehlungssystemen erfolgreich genutzt. So haben Google-Forschende ein MMoE-(Multi-Gate Mixture of Experts)-basiertes Ranking für YouTube-Empfehlungen vorgeschlagen.
Sie gruppieren ihre Zielgrößen in zwei Kategorien: Engagement und Zufriedenheit. Ausgehend von der Kandidatenliste aus dem Retrieval nutzt das Ranking-System Kandidaten-, Nutzer- und Kontextmerkmale, um die Wahrscheinlichkeiten für beide Verhaltenskategorien zu lernen.
Wichtig: Die MoE-Schicht wurde nicht direkt auf den Input angewandt, da dessen hohe Dimensionalität die Trainings- und Serving-Kosten stark erhöht hätte.
MoEs sind in der Industrie breit im Einsatz. Die Lernprozedur zerlegt Aufgaben in passende Teilaufgaben, die jeweils von sehr einfachen Expert:innen-Netzen gelöst werden können. Das ermöglicht paralleles Training und schnelle Inferenz – attraktiv für große Systeme.
MoE spielt seine Stärken besonders in High-Throughput-Szenarien auf vielen Maschinen aus. Bei festem Compute-Budget fürs Pretraining kann ein sparse Modell effizienter sein.
Allerdings benötigen sparse Modelle zur Laufzeit viel Speicher, da alle Expertinnen und Experten im Speicher gehalten werden müssen. In Systemen mit wenig VRAM ist das oft ein Engpass.
Schauen wir uns weitere Einschränkungen an.
MoE-Modelle zu trainieren ist komplexer als ein Einzelmodell. Gründe:
Die Inferenz kann aus mehreren Gründen weniger effizient sein:
Durch die Vielzahl an Expertinnen und Experten sind MoE-Modelle tendenziell größer als Einzelmodelle:
In diesem Artikel haben wir die Mixture-of-Experts-(MoE)-Technik beleuchtet – einen Ansatz, um Neuronale Netze für komplexe Aufgaben und vielfältige Daten zu skalieren. MoE nutzt mehrere spezialisierte Expertinnen und Experten plus ein Gating-Netzwerk für zielgenaues Routing.
Wir haben die Kernkomponenten – Expertennetze und Gating-Netzwerk – sowie Training und Inferenz behandelt.
Vorteile wie höhere Performance, Skalierbarkeit und Anpassungsfähigkeit sowie Anwendungen in NLP, Computer Vision und Empfehlungssystemen standen im Fokus.
Trotz Herausforderungen bei Trainingskomplexität und Modellgröße bietet MoE einen vielversprechenden Weg, KI-Fähigkeiten voranzubringen.
Lerne KI mit diesen Kursen!
Lernpfad
Lernpfad
Kurs