Cursus
Développer des applications d'IA
21 h
Imaginez un modèle d’IA comme une équipe de spécialistes, chacun avec une expertise propre. Un modèle mixture of experts (MoE) fonctionne sur ce principe en répartissant une tâche complexe entre de petits réseaux spécialisés appelés « experts ».
Chaque expert se concentre sur un aspect précis du problème, ce qui permet au modèle de traiter la tâche plus efficacement et avec davantage de précision. C’est comme consulter un médecin pour la santé, un mécanicien pour la voiture et un chef pour la cuisine : chaque expert gère ce qu’il fait le mieux.
En collaborant, ces spécialistes résolvent un éventail de problèmes bien plus large qu’un seul généraliste.
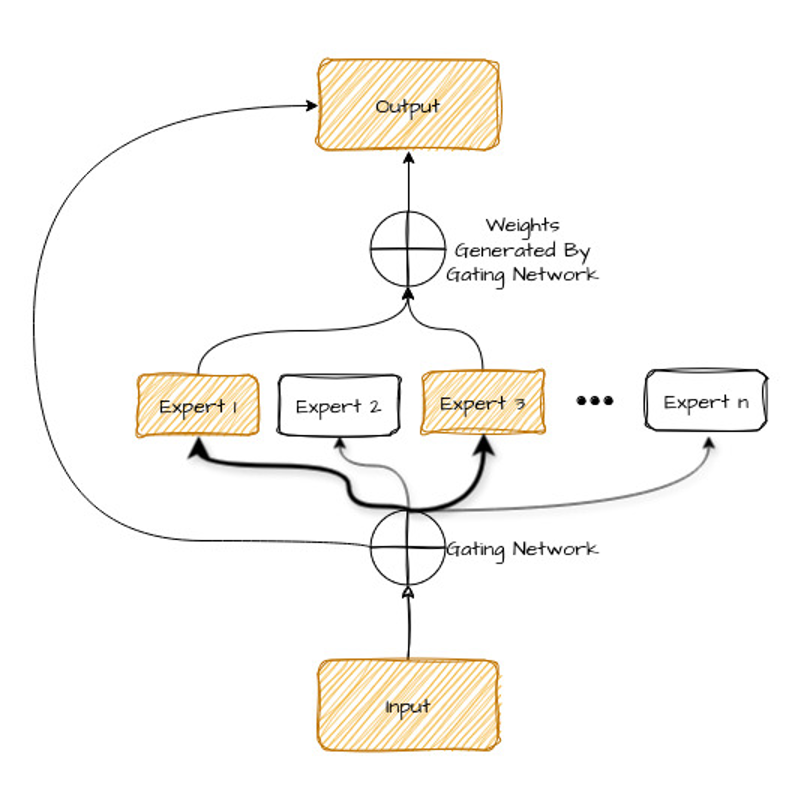
Regardons le schéma ci-dessous — nous l’expliquons juste après.
Décomposons les éléments de ce schéma :
Les avantages d’un MoE :
Passons maintenant en détail aux réseaux d’experts et au réseau de routage.
Voyez les « réseaux d’experts » d’un modèle MoE comme une équipe de spécialistes. Plutôt que de tout confier à un seul modèle, chaque expert traite un type de tâche ou de données particulier.
Dans un MoE, ces experts sont des réseaux de neurones distincts, chacun entraîné sur des jeux de données ou des tâches différents.
Ils sont conçus pour être parcimonieux : seuls quelques experts s’activent à un instant donné, selon la nature de l’entrée. Cela évite d’engorger le système et garantit que les experts les plus pertinents travaillent sur le problème.
Mais comment le modèle sait-il quels experts choisir ? C’est le rôle du réseau de routage.
Le réseau de routage (le « router ») est un autre type de réseau de neurones qui apprend à analyser l’entrée (par exemple une phrase à traduire) et à déterminer quels experts sont les mieux adaptés pour la traiter.
Il attribue pour cela un « poids » ou score d’importance à chaque expert, en fonction des caractéristiques de l’entrée. Les experts au poids le plus élevé sont alors sélectionnés pour traiter les données.
Il existe plusieurs façons (appelées « algorithmes de routage ») pour sélectionner les bons experts. Voici les plus courantes :
Lors de la prédiction, le modèle combine les sorties des experts, selon le même principe que celui utilisé pour leur attribuer les tâches. Une tâche peut mobiliser plusieurs experts, selon sa complexité et sa variété.
Voyons maintenant comment fonctionne un MoE.
Un MoE opère en deux étapes :
Comme pour d’autres modèles d’apprentissage automatique, un MoE commence par s’entraîner sur un jeu de données. Toutefois, l’entraînement ne s’applique pas à l’ensemble du modèle : chaque composant est entraîné individuellement.
Chaque composant d’un cadre MoE est entraîné sur un sous-ensemble spécifique de données ou de tâches. L’objectif est que chaque composant se spécialise sur un aspect particulier du problème global.
Cette spécialisation s’obtient en fournissant à chaque composant des données pertinentes pour sa mission. Par exemple, pour le traitement du langage, un composant peut se concentrer sur la syntaxe et un autre sur la sémantique.
Chaque composant suit un entraînement standard de réseau de neurones, où il apprend à minimiser la fonction de perte sur son propre sous-ensemble de données.
Le réseau de routage apprend à sélectionner l’expert le plus adapté pour une entrée donnée.
Pendant son entraînement, il est optimisé conjointement avec les réseaux d’experts. Il reçoit la même entrée que les experts et apprend à prédire une distribution de probabilités sur les experts, indiquant lequel est le mieux placé pour traiter l’entrée courante.
Le réseau de routage est généralement entraîné avec des méthodes d’optimisation qui tiennent compte à la fois de sa précision et des performances des experts sélectionnés.
Lors de la phase d’entraînement conjoint, l’ensemble du système MoE, c’est‑à‑dire les modèles experts et le réseau de routage, est entraîné simultanément.
Cette stratégie garantit que le réseau de routage et les experts sont optimisés pour fonctionner de concert. La fonction de perte combine celles des experts et du réseau de routage, favorisant une optimisation collaborative.
Les gradients de perte combinés sont ensuite propagés à travers le réseau de routage et les experts, afin d’améliorer la performance globale du système MoE.
L’inférence consiste à générer des sorties en combinant le contexte du réseau de routage avec les sorties des experts. Dans un MoE, ce processus est conçu pour minimiser les coûts d’inférence.
Dans un MoE, le réseau de routage joue un rôle clé pour décider quels modèles doivent traiter une entrée donnée.
À la réception d’une entrée, il l’évalue et crée une distribution de probabilités sur l’ensemble des modèles. Cette distribution oriente ensuite l’entrée vers les modèles les plus appropriés, en s’appuyant sur les schémas appris pendant l’entraînement. Ainsi, la bonne expertise est mobilisée pour chaque tâche, optimisant la prise de décision.
Seuls un ou quelques modèles sont choisis pour traiter chaque entrée, selon les probabilités attribuées par le réseau de routage.
Limiter le nombre de modèles par entrée permet d’utiliser efficacement les ressources de calcul tout en tirant parti des savoir‑faire spécialisés du cadre MoE.
La sortie du réseau de routage garantit que les modèles choisis sont les plus adaptés, améliorant ainsi l’efficacité et les performances globales du système.
La dernière étape d’inférence consiste à fusionner les sorties des modèles sélectionnés.
Cette fusion se fait souvent par moyenne pondérée, où les poids reflètent les probabilités du réseau de routage. Selon les cas, d’autres méthodes comme le vote ou des techniques de combinaison apprises peuvent être utilisées. L’objectif est d’intégrer des points de vue complémentaires en une prédiction finale unifiée et précise, tirant pleinement parti de l’architecture MoE.
Avec l’accélération technologique, le besoin de techniques rapides, efficaces et optimisées pour traiter de grands modèles s’intensifie. Le MoE s’impose comme une solution prometteuse. Quels autres bénéfices offre‑t‑il ?
L’architecture Mixture of Experts (MoE) présente plusieurs atouts :
Le MoE existe depuis plus de 30 ans et s’est imposé comme une technique largement utilisée dans différents domaines de l’apprentissage automatique.
Le MoE offre une manière singulière d’entraîner de grands modèles avec plus d’efficacité, un pré‑entraînement plus rapide et des vitesses d’inférence compétitives.
Dans les modèles denses classiques, tous les paramètres sont utilisés pour chaque entrée. La parcimonie permet au contraire d’activer uniquement certaines parties du système selon l’entrée, réduisant fortement le calcul.
Un exemple est l’API de traduction de Microsoft, Z-code. L’architecture MoE de Z-code gère un volume massif de paramètres tout en maintenant un coût de calcul constant.
Les V‑MoE de Google, une architecture clairsemée basée sur les Vision Transformers (ViT), démontrent l’efficacité des MoE pour les tâches de vision.
En découpant les images en patchs et en les envoyant à une couche de routage, les V‑MoE sélectionnent dynamiquement les experts les plus adaptés à chaque patch, optimisant précision et efficacité.
Un avantage notable est la flexibilité : vous pouvez réduire le nombre d’experts sélectionnés par jeton pour gagner en temps et en calcul, sans réentraîner les poids du modèle.
Le MoE s’est également imposé dans les systèmes de recommandation. Par exemple, des chercheurs de Google ont proposé un système de classement MMoE (Multi‑Gate Mixture of Experts) pour les recommandations de vidéos YouTube.
Ils regroupent d’abord leurs objectifs en deux catégories : engagement et satisfaction. À partir de la liste de vidéos candidates issue de l’étape de récupération, leur système apprend, à partir des caractéristiques des candidats, de l’utilisateur et du contexte, à prédire les probabilités associées à ces deux comportements.
À noter : ils n’appliquent pas la couche MoE directement à l’entrée, car la forte dimensionnalité des données impliquerait des coûts d’entraînement et de service très élevés.
Les MoE sont largement adoptés dans l’industrie pour de multiples usages. Leur procédure d’apprentissage divise la tâche en sous‑tâches adaptées, chacune pouvant être résolue par un réseau expert très simple. Résultat : un entraînement parallélisable et une inférence rapide, des atouts décisifs pour les systèmes à grande échelle.
Les experts sont particulièrement utiles dans des scénarios à fort débit impliquant de nombreuses machines. À budget de calcul fixe pour le pré‑entraînement, un modèle épars peut être plus efficace.
Cependant, les modèles épars exigent beaucoup de mémoire à l’exécution, puisque tous les experts doivent être chargés en mémoire. C’est une limite importante sur des systèmes avec peu de VRAM, où ces modèles peuvent peiner.
Voyons d’autres limites des MoE.
Former un MoE est plus complexe que d’entraîner un modèle unique. Voici pourquoi :
L’inférence peut être moins efficace dans un MoE pour plusieurs raisons :
Les MoE sont généralement plus volumineux qu’un modèle unique, du fait de la multiplicité des experts :
Nous avons exploré la technique Mixture of Experts (MoE), une approche avancée pour faire passer à l’échelle des réseaux de neurones afin de traiter des tâches complexes et des données hétérogènes. Le MoE s’appuie sur plusieurs experts spécialisés et un réseau de routage pour acheminer efficacement les entrées.
Nous avons couvert ses composants clés (réseaux d’experts et réseau de routage) ainsi que ses processus d’entraînement et d’inférence.
Nous avons mis en avant des bénéfices tels que la performance, la montée en charge et l’adaptabilité, ainsi que des applications en traitement du langage, vision par ordinateur et systèmes de recommandation.
Malgré des défis liés à la complexité d’entraînement et à la taille des modèles, le MoE constitue une piste prometteuse pour faire progresser les capacités de l’IA.
Formez-vous à l’IA avec ces cours !
Cursus
Cursus
Cours