随着人工智能渗透并重塑各行各业,人们的注意力往往集中在新功能与新特性上,但幕后究竟发生了什么?每个 AI 应用背后都有一套也许不那么耀眼却至关重要的支撑——为其提供动力的基础设施。那么,究竟是什么工具让机器学习得以蓬勃发展?
在这个以数据为驱动的世界里,一切都始于数据如何被存储,更重要的是如何被搜索。这正是向量数据库大显身手之处。
向量数据库解密
那么,向量数据库到底是什么?向量数据库是一种专门用于存储和检索向量嵌入(vector embeddings)的数据库,使开发者能够实现语义搜索、图像识别、聊天机器人等多种 AI 功能。
但这具体意味着什么?要真正理解向量数据库,我们需要往回倒推几步。从一开始就把基础讲清楚,先从这个过程中的关键角色——向量嵌入——谈起。
什么是向量嵌入?
向量(在人工智能语境下)就是一串数字,用来表示图像、句子、音频甚至视频的语义含义。这组数字帮助计算机理解各个数据之间的相似程度:它们把数据(如词语或图片)放在一个“数学地图”上,使相似概念彼此更接近。
可以把向量嵌入想象成把一条数据变成一个 GPS 坐标——含义相近的数据(比如“dog”和“puppy”)最终会落在同一个“社区”里!
为什么要把数据转换成向量?想象一下,您要向机器解释猫和狗的区别。人类能理解这种差异,但机器只能理解数字:要向您的电脑解释托托和加菲猫的不同几乎是不可能的。
通过把数据转换为特定的向量结构,并根据源数据以唯一顺序排列每个数值,机器就能够理解不同数据点之间的关系!
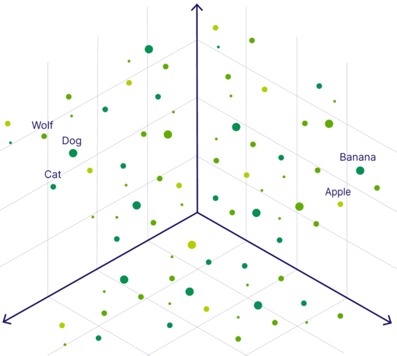
展示多维空间中的向量嵌入。图片来源。
下面通过讨论相似度搜索来了解这如何成为可能。
相似度搜索
相似度搜索是一种技术,用于找出与用户原始查询最相似的文档。用向量搜索就像在问:“这些图片里,哪一张最像猫?”而不是只去匹配“cat”这个词。
由于我们处理的是多维空间中的向量,这个过程会涉及一些数学,帮助我们判断哪些嵌入最为相似。
相似度搜索算法有很多,但最常见的三种是:
余弦相似度
余弦相似度衡量的是两个向量之间的夹角(不关心向量的长度),最常用于文本嵌入、语义相似度与推荐系统。它帮助开发者比较向量的整体方向,从而把握文档的整体内容,因此在上述场景中尤为重要。
欧氏距离
所谓欧氏距离,是指两个向量在空间中的直线距离。可以把它理解为地图上两点之间的最短路径!
这种距离最直观:如果计算结果很小,就意味着向量坐标非常接近,也就是彼此非常相似。
由于这个度量对向量的幅度非常敏感,因此在嵌入与数值大小相关时最有用。它在推荐引擎中尤其有用,比如根据用户以往的购买次数来推荐接下来可能下单的商品。
点积相似度
点积相似度既考虑向量的幅度乘积,也考虑它们夹角的余弦。也就是说,点积同时关注向量的长度(幅度)和方向!
当向量被归一化(向量幅度为 1,但方向不变)后,点积相似度就等同于余弦相似度,因为幅度不再被考虑。
点积相似度最常用于自然语言处理(NLP)和计算机视觉等领域。
为什么向量在 AI 应用中有用?
现在,您的原始数据已经用向量嵌入来表示。让我们看看,这种表示方式能为您开启哪些令人惊叹的可能性。
语义搜索
语义搜索是一种基于用户查询“真实含义”进行检索的方式,而不是仅做精确匹配。也就是说,搜索不再依赖特定关键词:就算拼写有误,也能返回结果;还会基于查询的同义表达展示结果。
例如,用户搜索“best cafes near me”(我附近最好的咖啡馆),在精确匹配下,只有明确标注为“cafes”的地方才会出现;而语义搜索引擎会理解上下文,展示与“茶”“咖啡”“糕点”等相关的地点,以及其他基于更深层语境理解得到的结果。
这种搜索如何实现?靠的就是向量嵌入!把用户查询与数据(例如地点描述)都进行嵌入,就能在多维空间中将它们相互比较,并通过相似度搜索等方法寻找彼此最接近的向量。
例如,用户的查询是“best cafes near me”,而数据库中存放了抓取自 Google 地图、并已完成嵌入的地点描述。语义搜索会返回那些嵌入与查询最相似的地点——即使这些地点描述中从未出现过“cafe”这个词!
推荐系统
推荐系统利用数据,基于过往购买、搜索历史、环境与人口统计信息等,帮助人们找到最可能喜欢的内容。几乎各行各业都会用到它,从娱乐到金融无所不包。
最显而易见的例子包括 Spotify、Netflix 与 Amazon 等平台,但随着越来越多公司采纳 AI 策略,推荐系统几乎遍布所有行业。
系统会基于点击、点赞、浏览等多种交互,全面学习用户的各项特征、历史决策与偏好。我们都习惯于基于过往购买被推荐新商品、电影或歌曲,但算法如何知道我们可能喜欢什么?靠的就是向量嵌入!
从高层来看,推荐系统会把各类物品与用户已知偏好进行比较。为使推荐更有意义,用户与物品都会被转换为向量嵌入。常见的两种技术是:基于内容的推荐与协同过滤。
以电影为例,基于内容的推荐会根据电影的各项特征进行嵌入,而用户的嵌入则基于他们过去看过的电影。系统随后会推荐那些与用户偏好向量(或过去看过的电影向量)最接近的新电影。
协同过滤则会同时考虑大量用户。它不再只关注单个用户与单个物品,而是找到与您最接近的用户向量,并推荐他们喜欢的物品或电影。
聊天机器人与检索增强生成(RAG)
向量嵌入在聊天机器人或 RAG 中也大有用武之地。
检索增强生成(RAG)是一种充分发挥大语言模型(LLM)能力的方式,它通过整合外部的、最新的信息,使 LLM 能够生成更准确的回答。因为 LLM 通常训练于静态数据,知识库有限,无法访问本地或个性化数据。
借助向量嵌入,可以将自定义数据保存在向量数据库中,从而打造一个可完全自定义的个性化数据仓库,适用于任何项目!数据以向量嵌入形式存储后,就可以基于用户查询直接从数据库中检索语义相似的文档。
RAG 的优秀之处在于它非常适合多种任务,例如问答与文本生成。这意味着它非常适合构建基于个性化数据训练的聊天机器人!
以上只是向量嵌入所能实现能力的一部分。
向量数据库有何不同?
向量数据库的基本特性当然包括:能够存储并高效处理向量,擅长处理高维数据,并支持超快速查询。
在传统的关系型数据库中,用户必须处理结构化数据,因为关系型数据库以表的列与行来管理数据。要处理与向量相关的流程,用户还不得不借助第三方包,因为结构化数据库既不能原生存储向量嵌入,也不能原生进行向量搜索。
向量数据库正是为这类工作而生:以向量的形式存储和处理数据,从而能更容易地构建复杂、面向 AI 的应用。向量数据库还以其性能、可扩展性、灵活性与可靠性闻名。它们被设计用于处理海量数据集,能够支持非结构化与半结构化数据,并为开发者在项目中提供更大的灵活性。
以下是向量数据库与传统关系型数据库之间差异的更深入对比:
|
方面
|
向量数据库
|
传统关系型数据库
|
|
主要数据模型
|
将数据存为高维向量(通常数百至上千维)。
|
在由行与带类型的列组成的表中存储结构化数据。
|
|
核心查询范式
|
基于向量嵌入的相似度搜索(如最近邻)。
|
在定义良好的列上进行精确匹配、范围、聚合与连接查询。
|
|
对嵌入的原生支持
|
内置向量嵌入的存储、索引(如 HNSW、IVF)与快速检索。
|
无原生向量类型;处理嵌入需借助外部扩展或流水线。
|
|
大规模性能
|
针对数百万至数十亿向量的毫秒级相似度搜索进行优化。
|
针对 ACID 事务与关系操作优化;向量搜索较慢或需外部系统承担。
|
|
数据灵活性
|
在转换为向量后可处理非结构化与半结构化输入(文本、图像、音频)。
|
最适合严格结构化的模式;非结构化数据需转换或单独存储(如 BLOB)。
|
|
可扩展模型
|
对向量索引进行水平分片/分区;为分布式运行而设计。
|
对表格数据具备成熟的垂直与水平扩展,但高维向量会导致索引膨胀。
|
|
开发者工作流
|
一个系统即可存储嵌入并运行 AI/语义查询;简化 ML/AI 应用技术栈。
|
需要单独的向量存储或库,并用 ETL 胶水代码与关系库同步。
|
|
典型用例
|
语义搜索、推荐、图像/音频检索、面向 LLM 的 RAG、异常检测。
|
OLTP/OLAP 应用、财务台账、库存、CRM、传统 BI 分析。
|
|
优势
|
高维搜索速度快、对 AI 项目更简洁、可扩展性强、灵活性高。
|
强一致性(ACID)、成熟工具链、丰富的 SQL 分析、复杂连接能力。
|
|
权衡/限制
|
较弱的复杂关系连接与多行事务能力。
|
对向量相似度的原生支持不足,不太适合 AI 密集型负载。
|
MongoDB + 向量搜索 = 天作之合
很多人知道 MongoDB 是一种面向文档的 NoSQL 数据库,但鲜有人意识到,借助 MongoDB Atlas Vector Search,它其实也是一款向量数据库!
考虑到 MongoDB 源自 NoSQL 数据库,初次接触这类数据库的读者不妨先阅读 Introduction to NoSQL。
MongoDB 作为向量数据库的强大之处在于:向量嵌入与其灵活的文档模型天然契合。MongoDB Atlas Vector Search 允许开发者将向量嵌入直接存储和查询于任意集合中。也就是说,向量嵌入可与源数据并排存放,便于引用。
得益于这种格式,开发者可以进行 混合搜索,即全文检索与语义搜索的组合,不仅能确保呈现语境相近的结果,还能覆盖同义表达。可以把混合搜索理解为一位“超级聪明的图书管理员”,他不仅能找到您点名的书名,还能推荐情节相似的书!
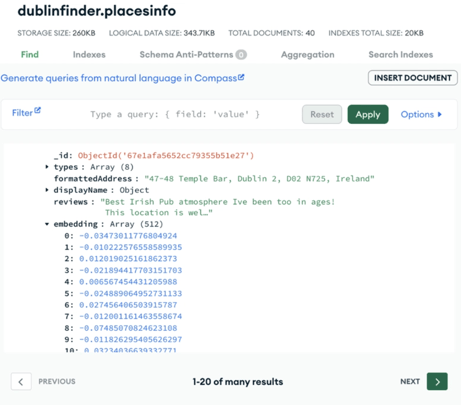
在 MongoDB Atlas 中将向量嵌入与源数据并排存储的示例。图片来源。
这种格式的另一个好处是,开发者可以在高性能、复杂的 AI 应用中充分利用 MongoDB 的整个平台能力。诸如流处理、实时分析、地理空间查询等功能,都能轻松集成进同一个应用。
MongoDB 近期收购 Voyage AI,进一步简化了这一流程。其提供的世界级嵌入模型与重排序器,使开发者能够将数据转换为高准确度、在业界具备竞争力的向量,并支持快速推理与多语言。
下面介绍如何开始使用 MongoDB Atlas Vector Search。
设置流程:MongoDB 向量搜索
要开始使用 MongoDB Atlas Vector Search,请按照 快速入门指南操作,全程约 15 分钟。
该指南将向您展示如何:
- 创建一个 Atlas 集群。
- 加载包含向量嵌入的示例文档。
- 在这些嵌入之上创建 MongoDB Atlas Vector Search 索引。
- 最后执行语义搜索,返回与初始查询最接近的文档。
结语
向量数据库已被证明是构建复杂 AI 应用的必需品。它们在处理高级应用所需的向量嵌入时能显著简化开发流程,而 MongoDB 的优势在于,开发者无需推倒重来重建技术栈,就能开始受益。
借助文档模型的力量,MongoDB 用其向量数据库赋能开发者。您可以在同一处同时管理结构化字段、非结构化数据与高维嵌入!
要点回顾:
- 向量数据库将数据存为数字列表(向量),以便快速找到相似数据。
- 嵌入把任意数据转换为数字,帮助 AI 更好地理解它们。
- 相似度搜索用于寻找“近似匹配”(如推荐相似电影)。
- MongoDB 让一切更简单——把向量与常规数据并排存储即可!
要切身感受向量数据库能为您的 AI 应用带来多大能量,通过 MongoDB 平台启动一个免费集群,亲自试一试。


随着人工智能渗透并重塑各行各业,人们的注意力往往集中在新功能与新特性上,但幕后究竟发生了什么?每个 AI 应用背后都有一套也许不那么耀眼却至关重要的支撑——为其提供动力的基础设施。那么,究竟是什么工具让机器学习得以蓬勃发展?
在这个以数据为驱动的世界里,一切都始于数据如何被存储,更重要的是如何被搜索。这正是向量数据库大显身手之处。
向量数据库解密
那么,向量数据库到底是什么?向量数据库是一种专门用于存储和检索向量嵌入(vector embeddings)的数据库,使开发者能够实现语义搜索、图像识别、聊天机器人等多种 AI 功能。
但这具体意味着什么?要真正理解向量数据库,我们需要往回倒推几步。从一开始就把基础讲清楚,先从这个过程中的关键角色——向量嵌入——谈起。
什么是向量嵌入?
向量(在人工智能语境下)就是一串数字,用来表示图像、句子、音频甚至视频的语义含义。这组数字帮助计算机理解各个数据之间的相似程度:它们把数据(如词语或图片)放在一个“数学地图”上,使相似概念彼此更接近。
可以把向量嵌入想象成把一条数据变成一个 GPS 坐标——含义相近的数据(比如“dog”和“puppy”)最终会落在同一个“社区”里!
为什么要把数据转换成向量?想象一下,您要向机器解释猫和狗的区别。人类能理解这种差异,但机器只能理解数字:要向您的电脑解释托托和加菲猫的不同几乎是不可能的。
通过把数据转换为特定的向量结构,并根据源数据以唯一顺序排列每个数值,机器就能够理解不同数据点之间的关系!
展示多维空间中的向量嵌入。图片来源。
下面通过讨论相似度搜索来了解这如何成为可能。
相似度搜索
相似度搜索是一种技术,用于找出与用户原始查询最相似的文档。用向量搜索就像在问:“这些图片里,哪一张最像猫?”而不是只去匹配“cat”这个词。
由于我们处理的是多维空间中的向量,这个过程会涉及一些数学,帮助我们判断哪些嵌入最为相似。
相似度搜索算法有很多,但最常见的三种是:
余弦相似度
余弦相似度衡量的是两个向量之间的夹角(不关心向量的长度),最常用于文本嵌入、语义相似度与推荐系统。它帮助开发者比较向量的整体方向,从而把握文档的整体内容,因此在上述场景中尤为重要。
欧氏距离
所谓欧氏距离,是指两个向量在空间中的直线距离。可以把它理解为地图上两点之间的最短路径!
这种距离最直观:如果计算结果很小,就意味着向量坐标非常接近,也就是彼此非常相似。
由于这个度量对向量的幅度非常敏感,因此在嵌入与数值大小相关时最有用。它在推荐引擎中尤其有用,比如根据用户以往的购买次数来推荐接下来可能下单的商品。
点积相似度
点积相似度既考虑向量的幅度乘积,也考虑它们夹角的余弦。也就是说,点积同时关注向量的长度(幅度)和方向!
当向量被归一化(向量幅度为 1,但方向不变)后,点积相似度就等同于余弦相似度,因为幅度不再被考虑。
点积相似度最常用于自然语言处理(NLP)和计算机视觉等领域。
为什么向量在 AI 应用中有用?
现在,您的原始数据已经用向量嵌入来表示。让我们看看,这种表示方式能为您开启哪些令人惊叹的可能性。
语义搜索
语义搜索是一种基于用户查询“真实含义”进行检索的方式,而不是仅做精确匹配。也就是说,搜索不再依赖特定关键词:就算拼写有误,也能返回结果;还会基于查询的同义表达展示结果。
例如,用户搜索“best cafes near me”(我附近最好的咖啡馆),在精确匹配下,只有明确标注为“cafes”的地方才会出现;而语义搜索引擎会理解上下文,展示与“茶”“咖啡”“糕点”等相关的地点,以及其他基于更深层语境理解得到的结果。
这种搜索如何实现?靠的就是向量嵌入!把用户查询与数据(例如地点描述)都进行嵌入,就能在多维空间中将它们相互比较,并通过相似度搜索等方法寻找彼此最接近的向量。
例如,用户的查询是“best cafes near me”,而数据库中存放了抓取自 Google 地图、并已完成嵌入的地点描述。语义搜索会返回那些嵌入与查询最相似的地点——即使这些地点描述中从未出现过“cafe”这个词!
推荐系统
推荐系统利用数据,基于过往购买、搜索历史、环境与人口统计信息等,帮助人们找到最可能喜欢的内容。几乎各行各业都会用到它,从娱乐到金融无所不包。
最显而易见的例子包括 Spotify、Netflix 与 Amazon 等平台,但随着越来越多公司采纳 AI 策略,推荐系统几乎遍布所有行业。
系统会基于点击、点赞、浏览等多种交互,全面学习用户的各项特征、历史决策与偏好。我们都习惯于基于过往购买被推荐新商品、电影或歌曲,但算法如何知道我们可能喜欢什么?靠的就是向量嵌入!
从高层来看,推荐系统会把各类物品与用户已知偏好进行比较。为使推荐更有意义,用户与物品都会被转换为向量嵌入。常见的两种技术是:基于内容的推荐与协同过滤。
以电影为例,基于内容的推荐会根据电影的各项特征进行嵌入,而用户的嵌入则基于他们过去看过的电影。系统随后会推荐那些与用户偏好向量(或过去看过的电影向量)最接近的新电影。
协同过滤则会同时考虑大量用户。它不再只关注单个用户与单个物品,而是找到与您最接近的用户向量,并推荐他们喜欢的物品或电影。
聊天机器人与检索增强生成(RAG)
向量嵌入在聊天机器人或 RAG 中也大有用武之地。
检索增强生成(RAG)是一种充分发挥大语言模型(LLM)能力的方式,它通过整合外部的、最新的信息,使 LLM 能够生成更准确的回答。因为 LLM 通常训练于静态数据,知识库有限,无法访问本地或个性化数据。
借助向量嵌入,可以将自定义数据保存在向量数据库中,从而打造一个可完全自定义的个性化数据仓库,适用于任何项目!数据以向量嵌入形式存储后,就可以基于用户查询直接从数据库中检索语义相似的文档。
RAG 的优秀之处在于它非常适合多种任务,例如问答与文本生成。这意味着它非常适合构建基于个性化数据训练的聊天机器人!
以上只是向量嵌入所能实现能力的一部分。
向量数据库有何不同?
向量数据库的基本特性当然包括:能够存储并高效处理向量,擅长处理高维数据,并支持超快速查询。
在传统的关系型数据库中,用户必须处理结构化数据,因为关系型数据库以表的列与行来管理数据。要处理与向量相关的流程,用户还不得不借助第三方包,因为结构化数据库既不能原生存储向量嵌入,也不能原生进行向量搜索。
向量数据库正是为这类工作而生:以向量的形式存储和处理数据,从而能更容易地构建复杂、面向 AI 的应用。向量数据库还以其性能、可扩展性、灵活性与可靠性闻名。它们被设计用于处理海量数据集,能够支持非结构化与半结构化数据,并为开发者在项目中提供更大的灵活性。
以下是向量数据库与传统关系型数据库之间差异的更深入对比:
方面
向量数据库
传统关系型数据库
主要数据模型
将数据存为高维向量(通常数百至上千维)。
在由行与带类型的列组成的表中存储结构化数据。
核心查询范式
基于向量嵌入的相似度搜索(如最近邻)。
在定义良好的列上进行精确匹配、范围、聚合与连接查询。
对嵌入的原生支持
内置向量嵌入的存储、索引(如 HNSW、IVF)与快速检索。
无原生向量类型;处理嵌入需借助外部扩展或流水线。
大规模性能
针对数百万至数十亿向量的毫秒级相似度搜索进行优化。
针对 ACID 事务与关系操作优化;向量搜索较慢或需外部系统承担。
数据灵活性
在转换为向量后可处理非结构化与半结构化输入(文本、图像、音频)。
最适合严格结构化的模式;非结构化数据需转换或单独存储(如 BLOB)。
可扩展模型
对向量索引进行水平分片/分区;为分布式运行而设计。
对表格数据具备成熟的垂直与水平扩展,但高维向量会导致索引膨胀。
开发者工作流
一个系统即可存储嵌入并运行 AI/语义查询;简化 ML/AI 应用技术栈。
需要单独的向量存储或库,并用 ETL 胶水代码与关系库同步。
典型用例
语义搜索、推荐、图像/音频检索、面向 LLM 的 RAG、异常检测。
OLTP/OLAP 应用、财务台账、库存、CRM、传统 BI 分析。
优势
高维搜索速度快、对 AI 项目更简洁、可扩展性强、灵活性高。
强一致性(ACID)、成熟工具链、丰富的 SQL 分析、复杂连接能力。
权衡/限制
较弱的复杂关系连接与多行事务能力。
对向量相似度的原生支持不足,不太适合 AI 密集型负载。
MongoDB + 向量搜索 = 天作之合
很多人知道 MongoDB 是一种面向文档的 NoSQL 数据库,但鲜有人意识到,借助 MongoDB Atlas Vector Search,它其实也是一款向量数据库!
考虑到 MongoDB 源自 NoSQL 数据库,初次接触这类数据库的读者不妨先阅读 Introduction to NoSQL。
MongoDB 作为向量数据库的强大之处在于:向量嵌入与其灵活的文档模型天然契合。MongoDB Atlas Vector Search 允许开发者将向量嵌入直接存储和查询于任意集合中。也就是说,向量嵌入可与源数据并排存放,便于引用。
得益于这种格式,开发者可以进行 混合搜索,即全文检索与语义搜索的组合,不仅能确保呈现语境相近的结果,还能覆盖同义表达。可以把混合搜索理解为一位“超级聪明的图书管理员”,他不仅能找到您点名的书名,还能推荐情节相似的书!
在 MongoDB Atlas 中将向量嵌入与源数据并排存储的示例。图片来源。
这种格式的另一个好处是,开发者可以在高性能、复杂的 AI 应用中充分利用 MongoDB 的整个平台能力。诸如流处理、实时分析、地理空间查询等功能,都能轻松集成进同一个应用。
MongoDB 近期收购 Voyage AI,进一步简化了这一流程。其提供的世界级嵌入模型与重排序器,使开发者能够将数据转换为高准确度、在业界具备竞争力的向量,并支持快速推理与多语言。
下面介绍如何开始使用 MongoDB Atlas Vector Search。
设置流程:MongoDB 向量搜索
要开始使用 MongoDB Atlas Vector Search,请按照 快速入门指南操作,全程约 15 分钟。
该指南将向您展示如何:
结语
向量数据库已被证明是构建复杂 AI 应用的必需品。它们在处理高级应用所需的向量嵌入时能显著简化开发流程,而 MongoDB 的优势在于,开发者无需推倒重来重建技术栈,就能开始受益。
借助文档模型的力量,MongoDB 用其向量数据库赋能开发者。您可以在同一处同时管理结构化字段、非结构化数据与高维嵌入!
要点回顾:
要切身感受向量数据库能为您的 AI 应用带来多大能量,通过 MongoDB 平台启动一个免费集群,亲自试一试。