Dengan kecerdasan buatan yang menyusup dan membentuk ulang setiap industri, fokus utama selalu tertuju pada fitur dan fungsionalitas baru, tetapi apa yang terjadi di balik layar? Di balik setiap aplikasi AI ada sesuatu yang mungkin kurang glamor namun sangat krusial: infrastruktur yang mendukungnya. Jadi, alat apa yang memungkinkan pembelajaran mesin berkembang?
Di dunia yang berorientasi data, semuanya benar-benar dimulai dari bagaimana data disimpan, dan yang paling penting, bagaimana data dicari. Di sinilah basis data vektor berperan.
Mengenal Basis Data Vektor
Jadi, apa sebenarnya basis data vektor itu? Basis data vektor adalah basis data yang dirancang khusus untuk menyimpan dan melakukan pencarian atas embedding vektor, sehingga pengembang dapat memanfaatkan berbagai fungsionalitas AI seperti pencarian semantik, pengenalan gambar, chatbot, dan masih banyak lagi.
Namun, apa sebenarnya artinya itu? Untuk benar-benar memahami apa itu basis data vektor, mari kita mundur beberapa langkah. Mari kita kupas tuntas basis data penting ini dengan mengulas dasar-dasarnya sejak awal, dimulai dari pemeran kunci dalam proses ini: embedding vektor.
Apa itu Embedding Vektor?
Vektor (dalam konteks kecerdasan buatan) sederhananya adalah daftar angka yang merepresentasikan makna semantik dari sebuah gambar, kalimat, audio, bahkan video. Urutan angka ini membantu komputer memahami seberapa mirip setiap potongan data satu sama lain: Data (seperti kata atau gambar) ditempatkan sebagai titik-titik dalam “peta matematika” di mana konsep yang serupa berada lebih dekat satu sama lain.
Kita bisa membayangkan embedding vektor seperti mengubah sepotong data menjadi koordinat GPS—data dengan makna yang mirip (seperti “anjing” dan “anak anjing”) akan berada di lingkungan yang sama!
Mengapa kita perlu mengubah data menjadi vektor? Bayangkan mencoba menjelaskan kepada mesin perbedaan antara kucing dan anjing. Manusia mampu memahami perbedaan ini, tetapi mesin hanya dapat memahami angka: Tidak mungkin menjelaskan kepada laptop Anda perbedaan antara Toto dan Garfield.
Dengan mengubah data Anda menjadi struktur vektor spesifik di mana setiap angka diurutkan secara unik menurut data sumbernya, mesin Anda mampu memahami hubungan antar berbagai titik data!
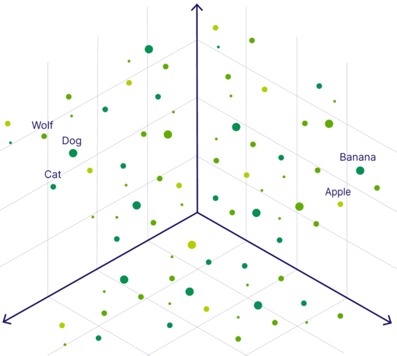
Menampilkan embedding vektor dalam ruang multidimensi. Sumber gambar.
Mari kita bahas bagaimana hal ini dimungkinkan dengan menyinggung pencarian kemiripan.
Pencarian kemiripan
Pencarian kemiripan adalah teknik yang digunakan untuk membantu menemukan dokumen yang paling mirip dengan kueri asli pengguna. Mencari dengan vektor seperti menanyakan, “Gambar mana yang paling mirip kucing?” alih-alih hanya mencocokkan kata “kucing” secara persis.
Karena kita berurusan dengan vektor dalam ruang multidimensi, beberapa perhitungan matematika terlibat dalam proses ini untuk membantu kita mengetahui embedding mana yang paling mirip.
Ada banyak algoritme pencarian kemiripan, tetapi tiga yang paling umum adalah:
Cosine similarity
Cosine similarity mengukur sudut antara dua vektor (tidak memperhatikan besar vektor) dan paling umum digunakan untuk embedding teks, kemiripan semantik, dan sistem rekomendasi. Ini membantu pengembang membandingkan arah keseluruhan vektor, yang pada gilirannya membantu mengetahui konten keseluruhan dokumen—itulah mengapa metrik ini sangat penting untuk topik-topik tersebut.
Jarak Euclidean
Jarak Euclidean mengukur jarak garis lurus antara dua vektor dalam ruang. Cara berpikir yang mudah adalah mengukur jalur terpendek antara dua titik pada peta!
Jarak ini paling mudah dipahami karena jika jarak yang dihitung sangat kecil, itu berarti koordinat vektor sangat dekat, atau sangat mirip satu sama lain.
Karena metrik ini sangat sensitif terhadap magnitudo, ia paling berguna ketika embedding berkaitan dengan nilai numerik. Ini sangat bermanfaat untuk mesin rekomendasi guna memberi tahu pengguna apa yang dipesan selanjutnya berdasarkan seberapa sering mereka membeli suatu item di masa lalu.
Kemiripan dot product
Kemiripan dot product tidak hanya mengukur hasil kali magnitudo vektor, tetapi juga cosinus sudut di antara keduanya. Ini berarti dot product memperhatikan panjang (magnitudo) dan arah vektor sekaligus!
Saat vektor dinormalisasi (magnitudo vektor menjadi satu tetapi arahnya tetap sama), kemiripan dot product menjadi sama dengan cosine similarity karena magnitudo tidak lagi diperhitungkan.
Kemiripan dot product paling umum digunakan di bidang seperti pemrosesan bahasa alami (NLP) dan visi komputer.
Mengapa Vektor Berguna dalam Aplikasi AI?
Sekarang data mentah Anda telah direpresentasikan sebagai embedding vektor. Mari telusuri semua kemungkinan luar biasa yang terbuka karena data Anda direpresentasikan oleh embedding ini.
Pencarian semantik
Pencarian semantik adalah cara menelusuri data berdasarkan makna sebenarnya dari kueri pengguna, bukan hanya pencarian kecocokan persis. Artinya, alih-alih mencari berdasarkan kata kunci spesifik, hasil tetap akan ditampilkan meskipun ada salah eja, dan hasil akan ditampilkan berdasarkan sinonim dari kueri asli.
Sebagai contoh, jika pengguna mencari “kafe terbaik di dekat saya”, dengan pencarian eksak, hanya yang berlabel khusus “kafe” yang akan muncul, sedangkan mesin pencari semantik akan memahami dan menampilkan tempat yang memiliki “teh”, “kopi”, “pastri”, atau temuan lain yang dihasilkan dari pemahaman kontekstual yang lebih dalam.
Jadi, bagaimana pencarian ini dimungkinkan? Embedding vektor! Misalnya kita meng-embed kueri pengguna dan data (seperti deskripsi lokasi). Ini memungkinkan untuk membandingkannya satu sama lain dalam ruang multidimensi, mencari vektor yang paling berdekatan menggunakan metode seperti pencarian kemiripan.
Sebagai contoh, jika pengguna memiliki kueri “kafe terbaik di dekat saya” dan ada basis data penuh deskripsi lokasi dari Google Maps yang di-scrape dan telah di-embed, pencarian semantik akan menampilkan tempat-tempat yang embedding-nya paling mirip dengan kueri asli—bahkan jika kata “kafe” tidak pernah digunakan dalam deskripsi lokasi tersebut!
Sistem rekomendasi
Sistem rekomendasi menggunakan data untuk membantu orang menemukan apa yang secara statistik paling mereka sukai, berdasarkan pembelian sebelumnya, riwayat pencarian, informasi lingkungan dan demografis, dan banyak lagi. Sistem ini digunakan hampir di setiap industri, mulai dari hiburan hingga keuangan.
Beberapa platform yang jelas menggunakan sistem rekomendasi adalah perusahaan seperti Spotify, Netflix, dan Amazon, tetapi sistem ini ada di setiap industri, terutama seiring semakin banyak perusahaan mengadopsi kebijakan AI.
Sistem ini sepenuhnya dilatih untuk memahami berbagai karakteristik, keputusan sebelumnya, dan preferensi pengguna berdasarkan banyak interaksi, termasuk klik, suka, dan tayangan. Jadi, kita semua akrab dengan rekomendasi produk, film, atau lagu baru berdasarkan pembelian sebelumnya, tetapi bagaimana sebuah algoritme bisa tahu apa yang mungkin kita sukai? Embedding vektor!
Secara garis besar, sistem rekomendasi membandingkan berbagai item dengan preferensi yang diketahui pengguna. Agar rekomendasi ini bermakna, baik pengguna maupun item dikonversi menjadi embedding vektor. Ada dua teknik yang sangat umum untuk ini: rekomendasi berbasis konten dan collaborative filtering.
Mari gunakan film sebagai contoh. Dengan rekomendasi berbasis konten, film di-embed berdasarkan berbagai fiturnya, dan pengguna di-embed berdasarkan film yang telah mereka tonton di masa lalu. Sistem kemudian dapat merekomendasikan film baru dengan vektor yang paling dekat dengan vektor preferensi pengguna, atau film yang pernah mereka tonton sebelumnya.
Dengan collaborative filtering, banyak pengguna dipertimbangkan. Alih-alih hanya berfokus pada satu pengguna dan satu item, collaborative filtering menemukan berbagai pengguna yang vektornya paling dekat dengan vektor Anda dan merekomendasikan item atau film yang mereka sukai.
Chatbot dan retrieval-augmented generation (RAG)
Kegunaan hebat lainnya untuk embedding vektor adalah pada chatbot atau RAG.
Retrieval-augmented generation adalah salah satu cara untuk benar-benar memaksimalkan kemampuan model bahasa besar (LLM) dengan mengintegrasikan informasi eksternal yang mutakhir sehingga LLM dapat menghasilkan respons yang lebih akurat. Ini karena LLM biasanya dilatih pada data statis, sehingga memiliki basis pengetahuan terbatas dan tidak dapat mengakses data lokal atau data yang dipersonalisasi.
Dengan embedding vektor, dimungkinkan untuk menyimpan data kustom dalam basis data vektor, memungkinkan pembuatan basis data yang sepenuhnya dapat disesuaikan berisi data personal yang dapat digunakan di proyek apa pun! Dengan data yang disimpan sebagai embedding vektor, kita dapat mengambil dokumen yang secara semantik mirip langsung dari basis data berdasarkan kueri pengguna.
Aspek hebat tentang RAG adalah cocok untuk berbagai tugas, seperti menjawab pertanyaan dan menghasilkan teks. Ini berarti RAG sempurna untuk membangun chatbot yang dilatih pada data personal!
Ini hanyalah beberapa kemampuan yang dimungkinkan dengan embedding vektor.
Apa yang Membuat Basis Data Vektor Berbeda?
Sifat fundamental basis data vektor tentu saja adalah kemampuannya menyimpan dan menangani vektor secara efisien, sangat andal bekerja dengan data berdimensi sangat tinggi, dan memungkinkan pengkuerian yang sangat cepat.
Dengan basis data relasional tradisional, pengguna harus berurusan dengan data terstruktur, karena basis data relasional menangani kolom dan baris data dalam tabel. Pengguna juga terpaksa menggunakan paket pihak ketiga untuk menangani basis data relasional dan proses terkait vektor, karena basis data terstruktur tidak dapat menyimpan atau melakukan pencarian atas embedding vektor secara native.
Basis data vektor dirancang untuk pekerjaan semacam ini: Data disimpan dan diproses sebagai vektor, yang berarti aplikasi yang lebih kompleks dan berfokus pada AI dapat dibangun dengan lebih sederhana. Basis data vektor juga dikenal karena kinerjanya, kemampuannya untuk diskalakan, fleksibilitas, dan keandalannya. Basis data ini dirancang untuk menangani set data masif, mampu mendukung data tidak terstruktur dan semi-terstruktur, serta memberi fleksibilitas bagi pengembang atas proyek mereka.
Berikut tinjauan lebih dalam tentang perbedaan antara basis data vektor dan basis data relasional tradisional:
|
Aspek
|
Basis Data Vektor
|
Basis Data Relasional Tradisional
|
|
Model data utama
|
Menyimpan data sebagai vektor berdimensi tinggi (sering ratusan–ribuan dimensi).
|
Menyimpan data terstruktur dalam tabel berisi baris & kolom bertipe.
|
|
Paradigma kueri inti
|
Pencarian kemiripan (misalnya, tetangga terdekat) atas embedding vektor.
|
Kueri kecocokan persis, rentang, agregasi, dan join pada kolom yang terdefinisi baik.
|
|
Dukungan native untuk embedding
|
Penyimpanan bawaan, pengindeksan (misalnya, HNSW, IVF), dan pengambilan embedding vektor yang cepat.
|
Tidak ada tipe vektor native; memerlukan ekstensi atau pipeline eksternal untuk menangani embedding.
|
|
Kinerja pada skala besar
|
Dioptimalkan untuk pencarian kemiripan sub-detik di jutaan hingga miliaran vektor.
|
Dioptimalkan untuk transaksi ACID dan operasi relasional; pencarian vektor lambat atau dialihkan.
|
|
Fleksibilitas data
|
Menangani masukan tidak terstruktur & semi-terstruktur (teks, gambar, audio) setelah dikonversi ke vektor.
|
Terbaik dengan skema yang benar-benar terstruktur; data tidak terstruktur harus diubah atau disimpan terpisah (misalnya, BLOB).
|
|
Model skalabilitas
|
Sharding/partisi horizontal atas indeks vektor; dirancang untuk operasi terdistribusi.
|
Skalabilitas vertikal & horizontal yang matang untuk data tabular, tetapi indeks membengkak dengan vektor berdimensi tinggi.
|
|
Alur kerja pengembang
|
Satu sistem untuk menyimpan embedding + menjalankan kueri AI/semantik; tumpukan lebih sederhana untuk aplikasi ML/AI.
|
Memerlukan penyimpanan vektor atau pustaka terpisah, ditambah kode ETL sebagai perekat untuk menyinkronkan dengan basis data relasional.
|
|
Use case umum
|
Pencarian semantik, rekomendasi, pengambilan gambar/audio, RAG untuk LLM, deteksi anomali.
|
Aplikasi OLTP/OLAP, pembukuan keuangan, inventaris, CRM, analitik BI tradisional.
|
|
Kekuatan
|
Kecepatan pencarian berdimensi tinggi, kesederhanaan untuk proyek AI, skala, fleksibilitas.
|
Konsistensi kuat (ACID), tooling matang, analitik SQL kaya, join kompleks.
|
|
Kompromi / batasan
|
Lebih lemah pada join relasional kompleks & transaksi multi-baris.
|
Dukungan native yang buruk untuk kemiripan vektor, kurang cocok untuk beban kerja yang sarat AI.
|
MongoDB dan Pencarian Vektor = Pasangan Sempurna
Walau banyak orang mengenal MongoDB sebagai basis data NoSQL berbasis dokumen, banyak yang belum menyadari bahwa MongoDB sebenarnya adalah basis data vektor, berkat MongoDB Atlas Vector Search!
Mengingat akar MongoDB sebagai basis data NoSQL, mereka yang baru pada tipe basis data ini mungkin akan memperoleh manfaat dari Introduction to NoSQL.
Aspek kuat dari MongoDB sebagai basis data vektor adalah betapa alaminya embedding vektor dapat masuk ke dalam model dokumen yang fleksibel. MongoDB Atlas Vector Search memungkinkan pengembang menyimpan dan melakukan kueri embedding vektor langsung di dalam koleksi mana pun. Ini berarti embedding vektor Anda disimpan tepat di sebelah data sumber untuk referensi yang mudah.
Berkat format ini, pengembang dapat melakukan hybrid search, yaitu kombinasi pencarian full-text dan semantik untuk manfaat tambahan memastikan tidak hanya hasil yang mirip secara kontekstual yang ditampilkan, tetapi juga hasil yang bersinonim. Kita bisa memandang hybrid search seperti memiliki pustakawan supercerdas yang tidak hanya menemukan buku dengan judul persis yang Anda minta, tetapi juga menyarankan buku dengan alur cerita serupa!
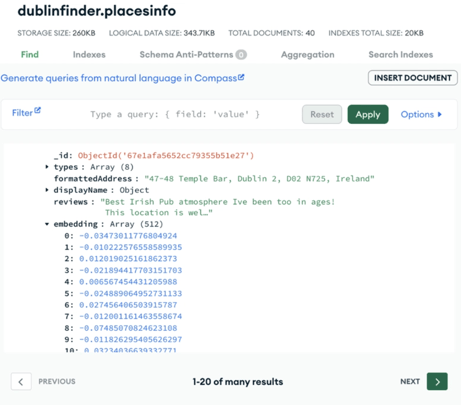
Contoh menyimpan embedding vektor Anda di sebelah data sumber di MongoDB Atlas. Sumber gambar.
Manfaat lain dari format ini adalah pengembang dapat sepenuhnya memanfaatkan seluruh platform MongoDB dalam aplikasi AI yang sangat berkinerja dan kompleks. Fitur seperti pemrosesan stream, analitik real-time, kueri geospasial, dan lainnya dapat dengan mudah diintegrasikan ke dalam satu aplikasi apa pun.
Akuisisi terbaru MongoDB atas Voyage AI membantu membuat proses ini menjadi lebih sederhana lagi. Model embedding dan reranker kelas dunia yang disediakan memungkinkan data pengembang diubah menjadi vektor dengan akurasi sangat tinggi, kompetitif di ranahnya, serta memungkinkan inferensi cepat dan dukungan multibahasa.
Mari bahas cara memulai dengan MongoDB Atlas Vector Search.
Proses penyiapan: pencarian vektor di MongoDB
Untuk memulai dengan MongoDB Atlas Vector Search, silakan ikuti panduan cepat yang akan memandu Anda melalui proses penyiapan selama 15 menit.
Panduan tersebut akan menunjukkan cara:
- Membuat klaster Atlas.
- Memuat dokumen contoh yang sudah berisi embedding vektor.
- Membuat indeks MongoDB Atlas Vector Search di atas embedding tersebut.
- Dan akhirnya, melakukan pencarian semantik untuk mengembalikan dokumen yang paling dekat dengan kueri awal.
Kesimpulan
Basis data vektor terbukti menjadi kebutuhan untuk membangun aplikasi AI yang kompleks. Basis data ini membantu memperlancar proses pengembangan saat bekerja dengan embedding vektor yang diperlukan untuk aplikasi yang lebih maju, dan keunggulan MongoDB adalah pengembang tidak perlu membangun ulang seluruh tumpukan mereka untuk mulai memanfaatkannya.
Dengan memanfaatkan kekuatan model dokumen, MongoDB memberdayakan pengembang dengan basis data vektornya. Dimungkinkan untuk menggabungkan field terstruktur, data tidak terstruktur, dan embedding berdimensi tinggi di satu tempat!
Beberapa hal penting:
- Basis data vektor menyimpan data sebagai daftar angka (vektor) untuk membantu pengguna menemukan data serupa dengan cepat.
- Embedding mengubah data apa pun menjadi angka agar AI dapat lebih memahaminya.
- Pencarian kemiripan membantu menemukan “kecocokan dekat” (seperti merekomendasikan film serupa).
- MongoDB memudahkan semuanya dengan menyimpan vektor di samping data reguler Anda!
Untuk benar-benar memahami kekuatan basis data vektor dalam aplikasi AI Anda, buat klaster gratis melalui platform MongoDB dan coba sendiri.




Dengan kecerdasan buatan yang menyusup dan membentuk ulang setiap industri, fokus utama selalu tertuju pada fitur dan fungsionalitas baru, tetapi apa yang terjadi di balik layar? Di balik setiap aplikasi AI ada sesuatu yang mungkin kurang glamor namun sangat krusial: infrastruktur yang mendukungnya. Jadi, alat apa yang memungkinkan pembelajaran mesin berkembang?
Di dunia yang berorientasi data, semuanya benar-benar dimulai dari bagaimana data disimpan, dan yang paling penting, bagaimana data dicari. Di sinilah basis data vektor berperan.
Mengenal Basis Data Vektor
Jadi, apa sebenarnya basis data vektor itu? Basis data vektor adalah basis data yang dirancang khusus untuk menyimpan dan melakukan pencarian atas embedding vektor, sehingga pengembang dapat memanfaatkan berbagai fungsionalitas AI seperti pencarian semantik, pengenalan gambar, chatbot, dan masih banyak lagi.
Namun, apa sebenarnya artinya itu? Untuk benar-benar memahami apa itu basis data vektor, mari kita mundur beberapa langkah. Mari kita kupas tuntas basis data penting ini dengan mengulas dasar-dasarnya sejak awal, dimulai dari pemeran kunci dalam proses ini: embedding vektor.
Apa itu Embedding Vektor?
Vektor (dalam konteks kecerdasan buatan) sederhananya adalah daftar angka yang merepresentasikan makna semantik dari sebuah gambar, kalimat, audio, bahkan video. Urutan angka ini membantu komputer memahami seberapa mirip setiap potongan data satu sama lain: Data (seperti kata atau gambar) ditempatkan sebagai titik-titik dalam “peta matematika” di mana konsep yang serupa berada lebih dekat satu sama lain.
Kita bisa membayangkan embedding vektor seperti mengubah sepotong data menjadi koordinat GPS—data dengan makna yang mirip (seperti “anjing” dan “anak anjing”) akan berada di lingkungan yang sama!
Mengapa kita perlu mengubah data menjadi vektor? Bayangkan mencoba menjelaskan kepada mesin perbedaan antara kucing dan anjing. Manusia mampu memahami perbedaan ini, tetapi mesin hanya dapat memahami angka: Tidak mungkin menjelaskan kepada laptop Anda perbedaan antara Toto dan Garfield.
Dengan mengubah data Anda menjadi struktur vektor spesifik di mana setiap angka diurutkan secara unik menurut data sumbernya, mesin Anda mampu memahami hubungan antar berbagai titik data!
Menampilkan embedding vektor dalam ruang multidimensi. Sumber gambar.
Mari kita bahas bagaimana hal ini dimungkinkan dengan menyinggung pencarian kemiripan.
Pencarian kemiripan
Pencarian kemiripan adalah teknik yang digunakan untuk membantu menemukan dokumen yang paling mirip dengan kueri asli pengguna. Mencari dengan vektor seperti menanyakan, “Gambar mana yang paling mirip kucing?” alih-alih hanya mencocokkan kata “kucing” secara persis.
Karena kita berurusan dengan vektor dalam ruang multidimensi, beberapa perhitungan matematika terlibat dalam proses ini untuk membantu kita mengetahui embedding mana yang paling mirip.
Ada banyak algoritme pencarian kemiripan, tetapi tiga yang paling umum adalah:
Cosine similarity
Cosine similarity mengukur sudut antara dua vektor (tidak memperhatikan besar vektor) dan paling umum digunakan untuk embedding teks, kemiripan semantik, dan sistem rekomendasi. Ini membantu pengembang membandingkan arah keseluruhan vektor, yang pada gilirannya membantu mengetahui konten keseluruhan dokumen—itulah mengapa metrik ini sangat penting untuk topik-topik tersebut.
Jarak Euclidean
Jarak Euclidean mengukur jarak garis lurus antara dua vektor dalam ruang. Cara berpikir yang mudah adalah mengukur jalur terpendek antara dua titik pada peta!
Jarak ini paling mudah dipahami karena jika jarak yang dihitung sangat kecil, itu berarti koordinat vektor sangat dekat, atau sangat mirip satu sama lain.
Karena metrik ini sangat sensitif terhadap magnitudo, ia paling berguna ketika embedding berkaitan dengan nilai numerik. Ini sangat bermanfaat untuk mesin rekomendasi guna memberi tahu pengguna apa yang dipesan selanjutnya berdasarkan seberapa sering mereka membeli suatu item di masa lalu.
Kemiripan dot product
Kemiripan dot product tidak hanya mengukur hasil kali magnitudo vektor, tetapi juga cosinus sudut di antara keduanya. Ini berarti dot product memperhatikan panjang (magnitudo) dan arah vektor sekaligus!
Saat vektor dinormalisasi (magnitudo vektor menjadi satu tetapi arahnya tetap sama), kemiripan dot product menjadi sama dengan cosine similarity karena magnitudo tidak lagi diperhitungkan.
Kemiripan dot product paling umum digunakan di bidang seperti pemrosesan bahasa alami (NLP) dan visi komputer.
Mengapa Vektor Berguna dalam Aplikasi AI?
Sekarang data mentah Anda telah direpresentasikan sebagai embedding vektor. Mari telusuri semua kemungkinan luar biasa yang terbuka karena data Anda direpresentasikan oleh embedding ini.
Pencarian semantik
Pencarian semantik adalah cara menelusuri data berdasarkan makna sebenarnya dari kueri pengguna, bukan hanya pencarian kecocokan persis. Artinya, alih-alih mencari berdasarkan kata kunci spesifik, hasil tetap akan ditampilkan meskipun ada salah eja, dan hasil akan ditampilkan berdasarkan sinonim dari kueri asli.
Sebagai contoh, jika pengguna mencari “kafe terbaik di dekat saya”, dengan pencarian eksak, hanya yang berlabel khusus “kafe” yang akan muncul, sedangkan mesin pencari semantik akan memahami dan menampilkan tempat yang memiliki “teh”, “kopi”, “pastri”, atau temuan lain yang dihasilkan dari pemahaman kontekstual yang lebih dalam.
Jadi, bagaimana pencarian ini dimungkinkan? Embedding vektor! Misalnya kita meng-embed kueri pengguna dan data (seperti deskripsi lokasi). Ini memungkinkan untuk membandingkannya satu sama lain dalam ruang multidimensi, mencari vektor yang paling berdekatan menggunakan metode seperti pencarian kemiripan.
Sebagai contoh, jika pengguna memiliki kueri “kafe terbaik di dekat saya” dan ada basis data penuh deskripsi lokasi dari Google Maps yang di-scrape dan telah di-embed, pencarian semantik akan menampilkan tempat-tempat yang embedding-nya paling mirip dengan kueri asli—bahkan jika kata “kafe” tidak pernah digunakan dalam deskripsi lokasi tersebut!
Sistem rekomendasi
Sistem rekomendasi menggunakan data untuk membantu orang menemukan apa yang secara statistik paling mereka sukai, berdasarkan pembelian sebelumnya, riwayat pencarian, informasi lingkungan dan demografis, dan banyak lagi. Sistem ini digunakan hampir di setiap industri, mulai dari hiburan hingga keuangan.
Beberapa platform yang jelas menggunakan sistem rekomendasi adalah perusahaan seperti Spotify, Netflix, dan Amazon, tetapi sistem ini ada di setiap industri, terutama seiring semakin banyak perusahaan mengadopsi kebijakan AI.
Sistem ini sepenuhnya dilatih untuk memahami berbagai karakteristik, keputusan sebelumnya, dan preferensi pengguna berdasarkan banyak interaksi, termasuk klik, suka, dan tayangan. Jadi, kita semua akrab dengan rekomendasi produk, film, atau lagu baru berdasarkan pembelian sebelumnya, tetapi bagaimana sebuah algoritme bisa tahu apa yang mungkin kita sukai? Embedding vektor!
Secara garis besar, sistem rekomendasi membandingkan berbagai item dengan preferensi yang diketahui pengguna. Agar rekomendasi ini bermakna, baik pengguna maupun item dikonversi menjadi embedding vektor. Ada dua teknik yang sangat umum untuk ini: rekomendasi berbasis konten dan collaborative filtering.
Mari gunakan film sebagai contoh. Dengan rekomendasi berbasis konten, film di-embed berdasarkan berbagai fiturnya, dan pengguna di-embed berdasarkan film yang telah mereka tonton di masa lalu. Sistem kemudian dapat merekomendasikan film baru dengan vektor yang paling dekat dengan vektor preferensi pengguna, atau film yang pernah mereka tonton sebelumnya.
Dengan collaborative filtering, banyak pengguna dipertimbangkan. Alih-alih hanya berfokus pada satu pengguna dan satu item, collaborative filtering menemukan berbagai pengguna yang vektornya paling dekat dengan vektor Anda dan merekomendasikan item atau film yang mereka sukai.
Chatbot dan retrieval-augmented generation (RAG)
Kegunaan hebat lainnya untuk embedding vektor adalah pada chatbot atau RAG.
Retrieval-augmented generation adalah salah satu cara untuk benar-benar memaksimalkan kemampuan model bahasa besar (LLM) dengan mengintegrasikan informasi eksternal yang mutakhir sehingga LLM dapat menghasilkan respons yang lebih akurat. Ini karena LLM biasanya dilatih pada data statis, sehingga memiliki basis pengetahuan terbatas dan tidak dapat mengakses data lokal atau data yang dipersonalisasi.
Dengan embedding vektor, dimungkinkan untuk menyimpan data kustom dalam basis data vektor, memungkinkan pembuatan basis data yang sepenuhnya dapat disesuaikan berisi data personal yang dapat digunakan di proyek apa pun! Dengan data yang disimpan sebagai embedding vektor, kita dapat mengambil dokumen yang secara semantik mirip langsung dari basis data berdasarkan kueri pengguna.
Aspek hebat tentang RAG adalah cocok untuk berbagai tugas, seperti menjawab pertanyaan dan menghasilkan teks. Ini berarti RAG sempurna untuk membangun chatbot yang dilatih pada data personal!
Ini hanyalah beberapa kemampuan yang dimungkinkan dengan embedding vektor.
Apa yang Membuat Basis Data Vektor Berbeda?
Sifat fundamental basis data vektor tentu saja adalah kemampuannya menyimpan dan menangani vektor secara efisien, sangat andal bekerja dengan data berdimensi sangat tinggi, dan memungkinkan pengkuerian yang sangat cepat.
Dengan basis data relasional tradisional, pengguna harus berurusan dengan data terstruktur, karena basis data relasional menangani kolom dan baris data dalam tabel. Pengguna juga terpaksa menggunakan paket pihak ketiga untuk menangani basis data relasional dan proses terkait vektor, karena basis data terstruktur tidak dapat menyimpan atau melakukan pencarian atas embedding vektor secara native.
Basis data vektor dirancang untuk pekerjaan semacam ini: Data disimpan dan diproses sebagai vektor, yang berarti aplikasi yang lebih kompleks dan berfokus pada AI dapat dibangun dengan lebih sederhana. Basis data vektor juga dikenal karena kinerjanya, kemampuannya untuk diskalakan, fleksibilitas, dan keandalannya. Basis data ini dirancang untuk menangani set data masif, mampu mendukung data tidak terstruktur dan semi-terstruktur, serta memberi fleksibilitas bagi pengembang atas proyek mereka.
Berikut tinjauan lebih dalam tentang perbedaan antara basis data vektor dan basis data relasional tradisional:
Aspek
Basis Data Vektor
Basis Data Relasional Tradisional
Model data utama
Menyimpan data sebagai vektor berdimensi tinggi (sering ratusan–ribuan dimensi).
Menyimpan data terstruktur dalam tabel berisi baris & kolom bertipe.
Paradigma kueri inti
Pencarian kemiripan (misalnya, tetangga terdekat) atas embedding vektor.
Kueri kecocokan persis, rentang, agregasi, dan join pada kolom yang terdefinisi baik.
Dukungan native untuk embedding
Penyimpanan bawaan, pengindeksan (misalnya, HNSW, IVF), dan pengambilan embedding vektor yang cepat.
Tidak ada tipe vektor native; memerlukan ekstensi atau pipeline eksternal untuk menangani embedding.
Kinerja pada skala besar
Dioptimalkan untuk pencarian kemiripan sub-detik di jutaan hingga miliaran vektor.
Dioptimalkan untuk transaksi ACID dan operasi relasional; pencarian vektor lambat atau dialihkan.
Fleksibilitas data
Menangani masukan tidak terstruktur & semi-terstruktur (teks, gambar, audio) setelah dikonversi ke vektor.
Terbaik dengan skema yang benar-benar terstruktur; data tidak terstruktur harus diubah atau disimpan terpisah (misalnya, BLOB).
Model skalabilitas
Sharding/partisi horizontal atas indeks vektor; dirancang untuk operasi terdistribusi.
Skalabilitas vertikal & horizontal yang matang untuk data tabular, tetapi indeks membengkak dengan vektor berdimensi tinggi.
Alur kerja pengembang
Satu sistem untuk menyimpan embedding + menjalankan kueri AI/semantik; tumpukan lebih sederhana untuk aplikasi ML/AI.
Memerlukan penyimpanan vektor atau pustaka terpisah, ditambah kode ETL sebagai perekat untuk menyinkronkan dengan basis data relasional.
Use case umum
Pencarian semantik, rekomendasi, pengambilan gambar/audio, RAG untuk LLM, deteksi anomali.
Aplikasi OLTP/OLAP, pembukuan keuangan, inventaris, CRM, analitik BI tradisional.
Kekuatan
Kecepatan pencarian berdimensi tinggi, kesederhanaan untuk proyek AI, skala, fleksibilitas.
Konsistensi kuat (ACID), tooling matang, analitik SQL kaya, join kompleks.
Kompromi / batasan
Lebih lemah pada join relasional kompleks & transaksi multi-baris.
Dukungan native yang buruk untuk kemiripan vektor, kurang cocok untuk beban kerja yang sarat AI.
MongoDB dan Pencarian Vektor = Pasangan Sempurna
Walau banyak orang mengenal MongoDB sebagai basis data NoSQL berbasis dokumen, banyak yang belum menyadari bahwa MongoDB sebenarnya adalah basis data vektor, berkat MongoDB Atlas Vector Search!
Mengingat akar MongoDB sebagai basis data NoSQL, mereka yang baru pada tipe basis data ini mungkin akan memperoleh manfaat dari Introduction to NoSQL.
Aspek kuat dari MongoDB sebagai basis data vektor adalah betapa alaminya embedding vektor dapat masuk ke dalam model dokumen yang fleksibel. MongoDB Atlas Vector Search memungkinkan pengembang menyimpan dan melakukan kueri embedding vektor langsung di dalam koleksi mana pun. Ini berarti embedding vektor Anda disimpan tepat di sebelah data sumber untuk referensi yang mudah.
Berkat format ini, pengembang dapat melakukan hybrid search, yaitu kombinasi pencarian full-text dan semantik untuk manfaat tambahan memastikan tidak hanya hasil yang mirip secara kontekstual yang ditampilkan, tetapi juga hasil yang bersinonim. Kita bisa memandang hybrid search seperti memiliki pustakawan supercerdas yang tidak hanya menemukan buku dengan judul persis yang Anda minta, tetapi juga menyarankan buku dengan alur cerita serupa!
Contoh menyimpan embedding vektor Anda di sebelah data sumber di MongoDB Atlas. Sumber gambar.
Manfaat lain dari format ini adalah pengembang dapat sepenuhnya memanfaatkan seluruh platform MongoDB dalam aplikasi AI yang sangat berkinerja dan kompleks. Fitur seperti pemrosesan stream, analitik real-time, kueri geospasial, dan lainnya dapat dengan mudah diintegrasikan ke dalam satu aplikasi apa pun.
Akuisisi terbaru MongoDB atas Voyage AI membantu membuat proses ini menjadi lebih sederhana lagi. Model embedding dan reranker kelas dunia yang disediakan memungkinkan data pengembang diubah menjadi vektor dengan akurasi sangat tinggi, kompetitif di ranahnya, serta memungkinkan inferensi cepat dan dukungan multibahasa.
Mari bahas cara memulai dengan MongoDB Atlas Vector Search.
Proses penyiapan: pencarian vektor di MongoDB
Untuk memulai dengan MongoDB Atlas Vector Search, silakan ikuti panduan cepat yang akan memandu Anda melalui proses penyiapan selama 15 menit.
Panduan tersebut akan menunjukkan cara:
Kesimpulan
Basis data vektor terbukti menjadi kebutuhan untuk membangun aplikasi AI yang kompleks. Basis data ini membantu memperlancar proses pengembangan saat bekerja dengan embedding vektor yang diperlukan untuk aplikasi yang lebih maju, dan keunggulan MongoDB adalah pengembang tidak perlu membangun ulang seluruh tumpukan mereka untuk mulai memanfaatkannya.
Dengan memanfaatkan kekuatan model dokumen, MongoDB memberdayakan pengembang dengan basis data vektornya. Dimungkinkan untuk menggabungkan field terstruktur, data tidak terstruktur, dan embedding berdimensi tinggi di satu tempat!
Beberapa hal penting:
Untuk benar-benar memahami kekuatan basis data vektor dalam aplikasi AI Anda, buat klaster gratis melalui platform MongoDB dan coba sendiri.