Con l’intelligenza artificiale che entra in ogni settore e lo trasforma, l’attenzione è spesso su nuove funzionalità, ma cosa succede dietro le quinte? Dietro ogni applicazione di AI c’è qualcosa di meno appariscente ma fondamentale: l’infrastruttura che la alimenta. Quali strumenti rendono possibile il machine learning?
In un mondo guidato dai dati, tutto parte da come i dati vengono archiviati e, soprattutto, da come vengono cercati. È qui che entrano in gioco i database vettoriali.
Database vettoriali, facciamo chiarezza
Dunque, che cos’è esattamente un database vettoriale? È un database progettato per archiviare e cercare embedding vettoriali, consentendo agli sviluppatori di utilizzare funzionalità di AI come la ricerca semantica, il riconoscimento di immagini, i chatbot e molto altro.
Ma cosa significa davvero? Per capire a fondo cos’è un database vettoriale, torniamo indietro di un paio di passi. Facciamo chiarezza partendo dalle basi e dal protagonista di questo processo: l’embedding vettoriale.
Cos’è un embedding vettoriale?
Un vettore (nel contesto dell’intelligenza artificiale) è semplicemente un elenco di numeri che rappresenta il significato semantico di un’immagine, una frase, un audio o persino un video. Questa sequenza di numeri aiuta i computer a capire quanto ogni dato è simile a un altro: posizionano i dati (come parole o immagini) come punti in una “mappa matematica” in cui i concetti simili sono più vicini tra loro.
Possiamo pensare agli embedding vettoriali come a trasformare un dato in una coordinata GPS: i dati con significati simili (come “dog” e “puppy”) finiscono nello stesso quartiere!
Perché dobbiamo trasformare i dati in vettori? Immagina di spiegare a una macchina la differenza tra un gatto e un cane. Gli esseri umani la capiscono, ma una macchina comprende solo numeri: è impossibile spiegare al tuo laptop la differenza tra Toto e Garfield.
Convertendo i tuoi dati in strutture vettoriali specifiche, in cui ogni numero è ordinato in modo univoco in base a quel dato sorgente, la macchina può cogliere le relazioni tra vari punti dati!
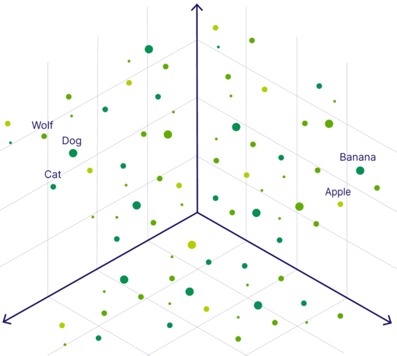
Esempio di un embedding vettoriale in uno spazio multidimensionale. Fonte immagine.
Vediamo come questo è possibile parlando di similarity search.
Similarity search
La similarity search è la tecnica usata per trovare i documenti più simili alla query originale dell’utente. Cercare con i vettori è come chiedere: “Quale di queste immagini assomiglia di più a un gatto?” invece di limitarsi a trovare la parola “gatto” esatta.
Poiché lavoriamo con vettori in uno spazio multidimensionale, entra in gioco un po’ di matematica per capire quali embedding si assomigliano di più.
Esistono molti algoritmi di similarity search, ma i tre più comuni sono:
Similarità del coseno
La similarità del coseno misura l’angolo tra due vettori (non considera la dimensione del vettore) ed è usata soprattutto per embedding di testo, similarità semantica e sistemi di raccomandazione. Aiuta a confrontare la direzione complessiva dei vettori e quindi a cogliere il contenuto generale dei documenti, motivo per cui è così importante per questi casi d’uso.
Distanza euclidea
La distanza euclidea misura la distanza in linea retta tra due vettori nello spazio. Un buon modo per pensarci è come il percorso più breve tra due punti su una mappa!
Questa distanza è la più intuitiva: se è molto piccola, le coordinate vettoriali sono molto vicine, quindi molto simili tra loro.
Poiché è molto sensibile alle magnitudini, è utile quando gli embedding riguardano valori numerici. È particolarmente utile nei motori di raccomandazione per suggerire cosa ordinare in base a quante volte un utente ha acquistato un articolo in passato.
Similarità tramite prodotto scalare
La similarità tramite prodotto scalare misura non solo il prodotto delle magnitudini dei vettori, ma anche il coseno dell’angolo tra di essi. Quindi tiene conto sia della lunghezza (magnitudine) sia della direzione dei vettori!
Quando i vettori sono normalizzati (magnitudine pari a uno ma stessa direzione), la similarità tramite prodotto scalare coincide con la similarità del coseno, perché la magnitudine non viene più considerata.
Il prodotto scalare è usato soprattutto in ambiti come la elaborazione del linguaggio naturale (NLP) e la computer vision.
Perché i vettori sono utili nelle applicazioni di AI?
Ora hai i dati grezzi rappresentati come embedding vettoriali. Vediamo le possibilità che si aprono grazie a questa rappresentazione.
Ricerca semantica
La ricerca semantica permette di cercare nei dati in base al significato reale della query dell’utente, non solo alla corrispondenza esatta. Invece di basarsi su keyword specifiche, mostra risultati anche se una parola è scritta male e in base ai sinonimi della query originale.
Per esempio, se un utente cerca “best cafes near me”, con la ricerca esatta compariranno solo elementi etichettati come “cafes”, mentre un motore semantico capirà e mostrerà posti con “tea”, “coffee”, “pastries” o altri risultati che emergono da una comprensione più profonda del contesto.
Come è possibile? Grazie agli embedding vettoriali! Se creiamo embedding sia della query sia dei dati (ad esempio descrizioni di luoghi), possiamo confrontarli nello spazio multidimensionale cercando i vettori più vicini, usando metodi come la similarity search.
Ad esempio, con la query “best cafes near me” e un database pieno di descrizioni di Google Maps già trasformate in embedding, la ricerca semantica mostrerà i luoghi i cui embedding sono più simili alla query iniziale, anche se la parola “cafe” non è mai citata in quelle descrizioni!
Sistemi di raccomandazione
I sistemi di raccomandazione usano i dati per aiutare le persone a trovare ciò che con alta probabilità piacerà loro, basandosi su acquisti precedenti, cronologia delle ricerche, informazioni ambientali e demografiche e altro. Sono usati in quasi tutti i settori, dall’intrattenimento alla finanza.
Piattaforme come Spotify, Netflix e Amazon sono esempi evidenti, ma esistono in ogni settore, specialmente man mano che sempre più aziende adottano politiche di AI.
Questi sistemi apprendono le caratteristiche, le decisioni passate e le preferenze degli utenti a partire da molteplici interazioni, come clic, like e visualizzazioni. Conosciamo tutti i suggerimenti di nuovi prodotti, film o canzoni basati sul passato, ma come fa un algoritmo a sapere cosa potrebbe piacerci? Grazie agli embedding vettoriali!
A livello alto, i sistemi di raccomandazione confrontano vari elementi con le preferenze note di un utente. Per rendere queste raccomandazioni utili, sia gli utenti sia gli elementi vengono convertiti in embedding vettoriali. Due tecniche comuni sono: raccomandazioni basate sui contenuti e collaborative filtering.
Prendiamo i film come esempio. Con le raccomandazioni basate sui contenuti, i film sono rappresentati in base alle loro caratteristiche e gli utenti in base ai film visti in passato. Il sistema può quindi consigliare nuovi film con vettori più vicini ai vettori di preferenza dell’utente, ossia ai film già visti.
Con il collaborative filtering, si considerano molti utenti: invece di concentrarsi su un singolo utente e un elemento, si trovano utenti con vettori più vicini al tuo e si consigliano elementi o film che loro hanno apprezzato.
Chatbot e retrieval-augmented generation (RAG)
Un altro ottimo uso degli embedding vettoriali è con i chatbot o la RAG.
La retrieval-augmented generation è un modo per sfruttare appieno i modelli linguistici di grandi dimensioni (LLM) integrando informazioni esterne e aggiornate, così che possano generare risposte più accurate. Gli LLM sono infatti addestrati su dati statici: hanno una base di conoscenza limitata e non accedono a dati locali o personalizzati.
Con gli embedding vettoriali, è possibile salvare dati personalizzati in un database vettoriale, creando un database su misura utilizzabile in qualsiasi progetto! Archiviando i dati come embedding, si possono recuperare documenti semanticamente simili direttamente dal database in base alla query dell’utente.
La RAG è perfetta per vari compiti, come rispondere a domande e generare testo. È quindi ideale per costruire chatbot addestrati su dati personalizzati!
Queste sono solo alcune delle possibilità abilitate dagli embedding vettoriali.
Cosa rende diverso un database vettoriale?
Le proprietà fondamentali dei database vettoriali sono la capacità di archiviare e gestire efficientemente i vettori, l’efficacia con dati ad altissima dimensionalità e le interrogazioni velocissime.
Con un database relazionale tradizionale, si lavora con dati strutturati, perché i database relazionali gestiscono colonne e righe nelle tabelle. Inoltre, occorrono pacchetti di terze parti per i processi legati ai vettori, perché i database strutturati non possono archiviare o cercare embedding vettoriali in modo nativo.
I database vettoriali sono progettati proprio per questo: i dati vengono archiviati e processati come vettori, semplificando la creazione di applicazioni più complesse e orientate all’AI. Sono noti anche per prestazioni, scalabilità, flessibilità e affidabilità. Gestiscono dataset enormi, supportano dati non strutturati e semi-strutturati e offrono grande flessibilità agli sviluppatori.
Ecco uno sguardo più approfondito alla differenza tra database vettoriali e database relazionali tradizionali:
|
Aspetto
|
Database vettoriali
|
Database relazionali tradizionali
|
|
Modello dati primario
|
Archivia i dati come vettori ad alta dimensionalità (spesso centinaia–migliaia di dimensioni).
|
Archivia dati strutturati in tabelle di righe e colonne tipizzate.
|
|
Paradigma di query principale
|
Similarity search (ad es. nearest-neighbor) su embedding vettoriali.
|
Corrispondenza esatta, range, aggregazioni e join su colonne ben definite.
|
|
Supporto nativo per embedding
|
Archiviazione, indicizzazione (ad es. HNSW, IVF) e recupero veloce di embedding vettoriali.
|
Nessun tipo vettoriale nativo; richiede estensioni o pipeline esterne per gestire gli embedding.
|
|
Prestazioni su larga scala
|
Ottimizzato per ricerche di similarità sotto il secondo su milioni-miliardi di vettori.
|
Ottimizzato per transazioni ACID e operazioni relazionali; la ricerca vettoriale è lenta o esternalizzata.
|
|
Flessibilità dei dati
|
Gestisce input non strutturati e semi-strutturati (testo, immagini, audio) una volta convertiti in vettori.
|
Rende al meglio con schemi rigidamente strutturati; i dati non strutturati vanno trasformati o archiviati a parte (ad es. BLOB).
|
|
Modello di scalabilità
|
Sharding/partizionamento orizzontale degli indici vettoriali; progettato per l’operatività distribuita.
|
Scalabilità verticale e orizzontale matura per dati tabellari, ma gli indici esplodono con vettori ad alta dimensionalità.
|
|
Flusso di lavoro per sviluppatori
|
Un unico sistema per archiviare embedding e lanciare query AI/semantiche; stack più semplice per app ML/AI.
|
Richiede store vettoriali o librerie separate, più codice ETL per sincronizzarli col DB relazionale.
|
|
Casi d’uso tipici
|
Ricerca semantica, raccomandazione, retrieval di immagini/audio, RAG per LLM, rilevamento anomalie.
|
App OLTP/OLAP, registri finanziari, inventario, CRM, analytics BI tradizionali.
|
|
Punti di forza
|
Velocità di ricerca in alta dimensionalità, semplicità per progetti AI, scala, flessibilità.
|
Forte consistenza (ACID), strumenti maturi, ricche analytics SQL, join complessi.
|
|
Trade-off / limiti
|
Meno adatti a join relazionali complessi e transazioni multi-riga.
|
Scarso supporto nativo alla similarità vettoriale, meno adatti a carichi forti di AI.
|
MongoDB e Vector Search = una coppia perfetta
Molti conoscono MongoDB come database NoSQL basato su documenti, ma non tutti sanno che è anche un database vettoriale, grazie a MongoDB Atlas Vector Search!
Dato il suo DNA NoSQL, chi è nuovo a questo tipo di database potrebbe trarre vantaggio da un’introduzione a NoSQL.
La forza di MongoDB come database vettoriale sta in quanto naturalmente gli embedding si inseriscono nel suo modello a documenti flessibile. Atlas Vector Search permette di archiviare e interrogare embedding direttamente in qualsiasi collezione. I tuoi embedding sono quindi salvati accanto ai dati sorgente, per un facile riferimento.
Grazie a questo formato, gli sviluppatori possono effettuare ricerca ibrida, che combina full-text e ricerca semantica per garantire non solo risultati contestualmente simili, ma anche sinonimi. Possiamo pensarla come un bibliotecario super in gamba che non solo trova i libri con il titolo esatto che hai chiesto, ma ti suggerisce anche storie simili!
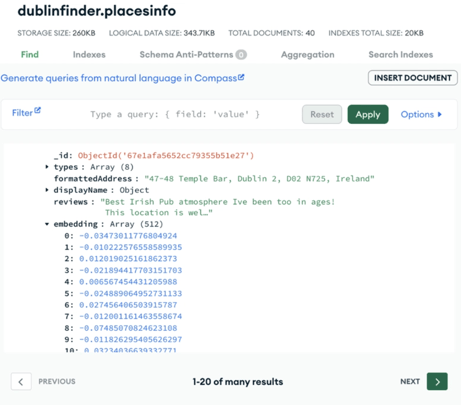
Esempio di archiviazione di un embedding vettoriale accanto ai dati sorgente in MongoDB Atlas. Fonte immagine.
Un altro vantaggio è che gli sviluppatori possono sfruttare l’intera piattaforma MongoDB nelle loro applicazioni AI complesse e ad alte prestazioni. Funzionalità come stream processing, analytics in tempo reale, query geospaziali e altro possono essere integrate facilmente in un’unica applicazione.
La recente acquisizione di Voyage AI da parte di MongoDB consente di semplificare ulteriormente il processo. I modelli di embedding e i reranker di livello mondiale permettono di trasformare i dati in vettori con altissima accuratezza, competitivi sul mercato, con inferenza rapida e supporto multilingue.
Vediamo come iniziare con MongoDB Atlas Vector Search.
Il setup: vector search in MongoDB
Per iniziare con MongoDB Atlas Vector Search, segui la guida quickstart che ti porterà attraverso un setup di 15 minuti.
Vedrai come:
- Creare un cluster Atlas.
- Caricare documenti di esempio che contengono già embedding vettoriali.
- Creare un indice MongoDB Atlas Vector Search su quegli embedding.
- E infine eseguire una ricerca semantica per restituire i documenti più vicini alla query iniziale.
Conclusione
I database vettoriali si sono rivelati indispensabili per costruire applicazioni AI complesse. Semplificano lo sviluppo quando si lavora con embedding vettoriali, necessari per queste applicazioni avanzate, e la bellezza di MongoDB è che non serve reinventare l’intero stack per iniziare a beneficiarne.
Sfruttando la potenza del modello a documenti, MongoDB mette in mano agli sviluppatori un database vettoriale: è possibile combinare campi strutturati, dati non strutturati e embedding ad alta dimensionalità in un unico posto!
Punti chiave:
- I database vettoriali archiviano i dati come elenchi di numeri (vettori) per trovare rapidamente dati simili.
- Gli embedding trasformano qualsiasi dato in numeri affinché l’AI possa capirli meglio.
- La similarity search aiuta a trovare “corrispondenze vicine” (come raccomandare film simili).
- MongoDB semplifica tutto archiviando i vettori accanto ai tuoi dati normali!
Per capire davvero l’impatto di un database vettoriale nella tua applicazione di AI, avvia un cluster gratuito tramite la piattaforma di MongoDB e provalo in prima persona.





Con l’intelligenza artificiale che entra in ogni settore e lo trasforma, l’attenzione è spesso su nuove funzionalità, ma cosa succede dietro le quinte? Dietro ogni applicazione di AI c’è qualcosa di meno appariscente ma fondamentale: l’infrastruttura che la alimenta. Quali strumenti rendono possibile il machine learning?
In un mondo guidato dai dati, tutto parte da come i dati vengono archiviati e, soprattutto, da come vengono cercati. È qui che entrano in gioco i database vettoriali.
Database vettoriali, facciamo chiarezza
Dunque, che cos’è esattamente un database vettoriale? È un database progettato per archiviare e cercare embedding vettoriali, consentendo agli sviluppatori di utilizzare funzionalità di AI come la ricerca semantica, il riconoscimento di immagini, i chatbot e molto altro.
Ma cosa significa davvero? Per capire a fondo cos’è un database vettoriale, torniamo indietro di un paio di passi. Facciamo chiarezza partendo dalle basi e dal protagonista di questo processo: l’embedding vettoriale.
Cos’è un embedding vettoriale?
Un vettore (nel contesto dell’intelligenza artificiale) è semplicemente un elenco di numeri che rappresenta il significato semantico di un’immagine, una frase, un audio o persino un video. Questa sequenza di numeri aiuta i computer a capire quanto ogni dato è simile a un altro: posizionano i dati (come parole o immagini) come punti in una “mappa matematica” in cui i concetti simili sono più vicini tra loro.
Possiamo pensare agli embedding vettoriali come a trasformare un dato in una coordinata GPS: i dati con significati simili (come “dog” e “puppy”) finiscono nello stesso quartiere!
Perché dobbiamo trasformare i dati in vettori? Immagina di spiegare a una macchina la differenza tra un gatto e un cane. Gli esseri umani la capiscono, ma una macchina comprende solo numeri: è impossibile spiegare al tuo laptop la differenza tra Toto e Garfield.
Convertendo i tuoi dati in strutture vettoriali specifiche, in cui ogni numero è ordinato in modo univoco in base a quel dato sorgente, la macchina può cogliere le relazioni tra vari punti dati!
Esempio di un embedding vettoriale in uno spazio multidimensionale. Fonte immagine.
Vediamo come questo è possibile parlando di similarity search.
Similarity search
La similarity search è la tecnica usata per trovare i documenti più simili alla query originale dell’utente. Cercare con i vettori è come chiedere: “Quale di queste immagini assomiglia di più a un gatto?” invece di limitarsi a trovare la parola “gatto” esatta.
Poiché lavoriamo con vettori in uno spazio multidimensionale, entra in gioco un po’ di matematica per capire quali embedding si assomigliano di più.
Esistono molti algoritmi di similarity search, ma i tre più comuni sono:
Similarità del coseno
La similarità del coseno misura l’angolo tra due vettori (non considera la dimensione del vettore) ed è usata soprattutto per embedding di testo, similarità semantica e sistemi di raccomandazione. Aiuta a confrontare la direzione complessiva dei vettori e quindi a cogliere il contenuto generale dei documenti, motivo per cui è così importante per questi casi d’uso.
Distanza euclidea
La distanza euclidea misura la distanza in linea retta tra due vettori nello spazio. Un buon modo per pensarci è come il percorso più breve tra due punti su una mappa!
Questa distanza è la più intuitiva: se è molto piccola, le coordinate vettoriali sono molto vicine, quindi molto simili tra loro.
Poiché è molto sensibile alle magnitudini, è utile quando gli embedding riguardano valori numerici. È particolarmente utile nei motori di raccomandazione per suggerire cosa ordinare in base a quante volte un utente ha acquistato un articolo in passato.
Similarità tramite prodotto scalare
La similarità tramite prodotto scalare misura non solo il prodotto delle magnitudini dei vettori, ma anche il coseno dell’angolo tra di essi. Quindi tiene conto sia della lunghezza (magnitudine) sia della direzione dei vettori!
Quando i vettori sono normalizzati (magnitudine pari a uno ma stessa direzione), la similarità tramite prodotto scalare coincide con la similarità del coseno, perché la magnitudine non viene più considerata.
Il prodotto scalare è usato soprattutto in ambiti come la elaborazione del linguaggio naturale (NLP) e la computer vision.
Perché i vettori sono utili nelle applicazioni di AI?
Ora hai i dati grezzi rappresentati come embedding vettoriali. Vediamo le possibilità che si aprono grazie a questa rappresentazione.
Ricerca semantica
La ricerca semantica permette di cercare nei dati in base al significato reale della query dell’utente, non solo alla corrispondenza esatta. Invece di basarsi su keyword specifiche, mostra risultati anche se una parola è scritta male e in base ai sinonimi della query originale.
Per esempio, se un utente cerca “best cafes near me”, con la ricerca esatta compariranno solo elementi etichettati come “cafes”, mentre un motore semantico capirà e mostrerà posti con “tea”, “coffee”, “pastries” o altri risultati che emergono da una comprensione più profonda del contesto.
Come è possibile? Grazie agli embedding vettoriali! Se creiamo embedding sia della query sia dei dati (ad esempio descrizioni di luoghi), possiamo confrontarli nello spazio multidimensionale cercando i vettori più vicini, usando metodi come la similarity search.
Ad esempio, con la query “best cafes near me” e un database pieno di descrizioni di Google Maps già trasformate in embedding, la ricerca semantica mostrerà i luoghi i cui embedding sono più simili alla query iniziale, anche se la parola “cafe” non è mai citata in quelle descrizioni!
Sistemi di raccomandazione
I sistemi di raccomandazione usano i dati per aiutare le persone a trovare ciò che con alta probabilità piacerà loro, basandosi su acquisti precedenti, cronologia delle ricerche, informazioni ambientali e demografiche e altro. Sono usati in quasi tutti i settori, dall’intrattenimento alla finanza.
Piattaforme come Spotify, Netflix e Amazon sono esempi evidenti, ma esistono in ogni settore, specialmente man mano che sempre più aziende adottano politiche di AI.
Questi sistemi apprendono le caratteristiche, le decisioni passate e le preferenze degli utenti a partire da molteplici interazioni, come clic, like e visualizzazioni. Conosciamo tutti i suggerimenti di nuovi prodotti, film o canzoni basati sul passato, ma come fa un algoritmo a sapere cosa potrebbe piacerci? Grazie agli embedding vettoriali!
A livello alto, i sistemi di raccomandazione confrontano vari elementi con le preferenze note di un utente. Per rendere queste raccomandazioni utili, sia gli utenti sia gli elementi vengono convertiti in embedding vettoriali. Due tecniche comuni sono: raccomandazioni basate sui contenuti e collaborative filtering.
Prendiamo i film come esempio. Con le raccomandazioni basate sui contenuti, i film sono rappresentati in base alle loro caratteristiche e gli utenti in base ai film visti in passato. Il sistema può quindi consigliare nuovi film con vettori più vicini ai vettori di preferenza dell’utente, ossia ai film già visti.
Con il collaborative filtering, si considerano molti utenti: invece di concentrarsi su un singolo utente e un elemento, si trovano utenti con vettori più vicini al tuo e si consigliano elementi o film che loro hanno apprezzato.
Chatbot e retrieval-augmented generation (RAG)
Un altro ottimo uso degli embedding vettoriali è con i chatbot o la RAG.
La retrieval-augmented generation è un modo per sfruttare appieno i modelli linguistici di grandi dimensioni (LLM) integrando informazioni esterne e aggiornate, così che possano generare risposte più accurate. Gli LLM sono infatti addestrati su dati statici: hanno una base di conoscenza limitata e non accedono a dati locali o personalizzati.
Con gli embedding vettoriali, è possibile salvare dati personalizzati in un database vettoriale, creando un database su misura utilizzabile in qualsiasi progetto! Archiviando i dati come embedding, si possono recuperare documenti semanticamente simili direttamente dal database in base alla query dell’utente.
La RAG è perfetta per vari compiti, come rispondere a domande e generare testo. È quindi ideale per costruire chatbot addestrati su dati personalizzati!
Queste sono solo alcune delle possibilità abilitate dagli embedding vettoriali.
Cosa rende diverso un database vettoriale?
Le proprietà fondamentali dei database vettoriali sono la capacità di archiviare e gestire efficientemente i vettori, l’efficacia con dati ad altissima dimensionalità e le interrogazioni velocissime.
Con un database relazionale tradizionale, si lavora con dati strutturati, perché i database relazionali gestiscono colonne e righe nelle tabelle. Inoltre, occorrono pacchetti di terze parti per i processi legati ai vettori, perché i database strutturati non possono archiviare o cercare embedding vettoriali in modo nativo.
I database vettoriali sono progettati proprio per questo: i dati vengono archiviati e processati come vettori, semplificando la creazione di applicazioni più complesse e orientate all’AI. Sono noti anche per prestazioni, scalabilità, flessibilità e affidabilità. Gestiscono dataset enormi, supportano dati non strutturati e semi-strutturati e offrono grande flessibilità agli sviluppatori.
Ecco uno sguardo più approfondito alla differenza tra database vettoriali e database relazionali tradizionali:
Aspetto
Database vettoriali
Database relazionali tradizionali
Modello dati primario
Archivia i dati come vettori ad alta dimensionalità (spesso centinaia–migliaia di dimensioni).
Archivia dati strutturati in tabelle di righe e colonne tipizzate.
Paradigma di query principale
Similarity search (ad es. nearest-neighbor) su embedding vettoriali.
Corrispondenza esatta, range, aggregazioni e join su colonne ben definite.
Supporto nativo per embedding
Archiviazione, indicizzazione (ad es. HNSW, IVF) e recupero veloce di embedding vettoriali.
Nessun tipo vettoriale nativo; richiede estensioni o pipeline esterne per gestire gli embedding.
Prestazioni su larga scala
Ottimizzato per ricerche di similarità sotto il secondo su milioni-miliardi di vettori.
Ottimizzato per transazioni ACID e operazioni relazionali; la ricerca vettoriale è lenta o esternalizzata.
Flessibilità dei dati
Gestisce input non strutturati e semi-strutturati (testo, immagini, audio) una volta convertiti in vettori.
Rende al meglio con schemi rigidamente strutturati; i dati non strutturati vanno trasformati o archiviati a parte (ad es. BLOB).
Modello di scalabilità
Sharding/partizionamento orizzontale degli indici vettoriali; progettato per l’operatività distribuita.
Scalabilità verticale e orizzontale matura per dati tabellari, ma gli indici esplodono con vettori ad alta dimensionalità.
Flusso di lavoro per sviluppatori
Un unico sistema per archiviare embedding e lanciare query AI/semantiche; stack più semplice per app ML/AI.
Richiede store vettoriali o librerie separate, più codice ETL per sincronizzarli col DB relazionale.
Casi d’uso tipici
Ricerca semantica, raccomandazione, retrieval di immagini/audio, RAG per LLM, rilevamento anomalie.
App OLTP/OLAP, registri finanziari, inventario, CRM, analytics BI tradizionali.
Punti di forza
Velocità di ricerca in alta dimensionalità, semplicità per progetti AI, scala, flessibilità.
Forte consistenza (ACID), strumenti maturi, ricche analytics SQL, join complessi.
Trade-off / limiti
Meno adatti a join relazionali complessi e transazioni multi-riga.
Scarso supporto nativo alla similarità vettoriale, meno adatti a carichi forti di AI.
MongoDB e Vector Search = una coppia perfetta
Molti conoscono MongoDB come database NoSQL basato su documenti, ma non tutti sanno che è anche un database vettoriale, grazie a MongoDB Atlas Vector Search!
Dato il suo DNA NoSQL, chi è nuovo a questo tipo di database potrebbe trarre vantaggio da un’introduzione a NoSQL.
La forza di MongoDB come database vettoriale sta in quanto naturalmente gli embedding si inseriscono nel suo modello a documenti flessibile. Atlas Vector Search permette di archiviare e interrogare embedding direttamente in qualsiasi collezione. I tuoi embedding sono quindi salvati accanto ai dati sorgente, per un facile riferimento.
Grazie a questo formato, gli sviluppatori possono effettuare ricerca ibrida, che combina full-text e ricerca semantica per garantire non solo risultati contestualmente simili, ma anche sinonimi. Possiamo pensarla come un bibliotecario super in gamba che non solo trova i libri con il titolo esatto che hai chiesto, ma ti suggerisce anche storie simili!
Esempio di archiviazione di un embedding vettoriale accanto ai dati sorgente in MongoDB Atlas. Fonte immagine.
Un altro vantaggio è che gli sviluppatori possono sfruttare l’intera piattaforma MongoDB nelle loro applicazioni AI complesse e ad alte prestazioni. Funzionalità come stream processing, analytics in tempo reale, query geospaziali e altro possono essere integrate facilmente in un’unica applicazione.
La recente acquisizione di Voyage AI da parte di MongoDB consente di semplificare ulteriormente il processo. I modelli di embedding e i reranker di livello mondiale permettono di trasformare i dati in vettori con altissima accuratezza, competitivi sul mercato, con inferenza rapida e supporto multilingue.
Vediamo come iniziare con MongoDB Atlas Vector Search.
Il setup: vector search in MongoDB
Per iniziare con MongoDB Atlas Vector Search, segui la guida quickstart che ti porterà attraverso un setup di 15 minuti.
Vedrai come:
Conclusione
I database vettoriali si sono rivelati indispensabili per costruire applicazioni AI complesse. Semplificano lo sviluppo quando si lavora con embedding vettoriali, necessari per queste applicazioni avanzate, e la bellezza di MongoDB è che non serve reinventare l’intero stack per iniziare a beneficiarne.
Sfruttando la potenza del modello a documenti, MongoDB mette in mano agli sviluppatori un database vettoriale: è possibile combinare campi strutturati, dati non strutturati e embedding ad alta dimensionalità in un unico posto!
Punti chiave:
Per capire davvero l’impatto di un database vettoriale nella tua applicazione di AI, avvia un cluster gratuito tramite la piattaforma di MongoDB e provalo in prima persona.