Nu kunstmatige intelligentie elke sector binnendringt en verandert, ligt de nadruk vaak op nieuwe features en functionaliteiten, maar wat gebeurt er achter de schermen? Achter elke AI-toepassing zit iets minder glamoureus maar ontzettend cruciaal: de infrastructuur die alles aandrijft. Welke tools maken het mogelijk dat machine learning floreert?
In een datagedreven wereld begint het echt allemaal bij hoe data wordt opgeslagen en, nog belangrijker, hoe data wordt doorzocht. Dáár komen vectordatabases om de hoek kijken.
Vectordatabases ontrafeld
Wat is een vectordatabase precies? Een vectordatabase is een database die speciaal is ontworpen om vector-embeddings op te slaan en te doorzoeken, zodat ontwikkelaars verschillende AI-functionaliteiten kunnen inzetten zoals semantisch zoeken, beeldherkenning, chatbots en nog veel meer.
Maar wat betekent dat nou echt? Om te begrijpen wat een vectordatabase is, zetten we een paar stappen terug. We halen de mystiek rond deze essentiële databases weg door bij het begin te beginnen, met de hoofdrolspeler in dit proces: de vector-embedding.
Wat is een vector-embedding?
Een vector (in de context van kunstmatige intelligentie) is simpelweg een lijst getallen die de semantische betekenis weergeeft van een afbeelding, een zin, audio of zelfs video. Deze reeks getallen helpt computers te begrijpen hoe elk datapunt op elkaar lijkt: ze plaatsen data (zoals woorden of afbeeldingen) als punten op een “wiskundekaart” waar vergelijkbare concepten dichter bij elkaar liggen.
Je kunt vector-embeddings zien als het omzetten van een datapunt naar GPS-coördinaten—data met een vergelijkbare betekenis (zoals “dog” en “puppy”) belanden in dezelfde buurt!
Waarom moeten we onze data omzetten naar vectoren? Stel je voor dat je een machine het verschil wilt uitleggen tussen een kat en een hond. Wij mensen snappen dat, maar een machine begrijpt alleen getallen: het is onmogelijk om je laptop het verschil tussen Toto en Garfield uit te leggen.
Door je data om te zetten naar specifieke vectorstructuren waarbij elk getal uniek is geordend op basis van die brondata, kan je machine relaties tussen verschillende datapunten begrijpen!
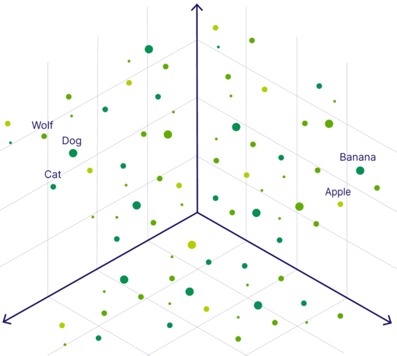
Een vector-embedding in een multidimensionale ruimte. Beeldbron.
Laten we bekijken hoe dit kan door similarity search te bespreken.
Similarity search
Similarity search is de techniek om de documenten te vinden die het meest lijken op de oorspronkelijke zoekopdracht van een gebruiker. Zoeken met vectoren is alsof je vraagt: “Welke van deze foto’s lijkt het meest op een kat?” in plaats van alleen het woord “kat” exact te matchen.
Omdat we met vectoren in een multidimensionale ruimte werken, komt er wat wiskunde bij kijken om te bepalen welke embeddings het meest op elkaar lijken.
Er zijn talloze similarity search-algoritmen, maar de drie meest gebruikte zijn:
Cosine similarity
Cosine similarity meet de hoek tussen twee vectoren (de grootte van de vector maakt niet uit) en wordt het meest gebruikt voor tekstembeddings, semantische gelijkenis en aanbevelingssystemen. Het helpt ontwikkelaars de algehele richting van vectoren te vergelijken, wat weer helpt om de algehele inhoud van documenten te bepalen—daarom is het zo belangrijk voor de genoemde onderwerpen.
Euclidische afstand
De Euclidische afstand meet de rechte-lijn afstand tussen twee vectoren in de ruimte. Je kunt het zien als het meten van het kortste pad tussen twee punten op een kaart!
Deze afstand is het meest rechttoe-rechtaan: als de berekende afstand heel klein is, liggen de vectorcoördinaten heel dicht bij elkaar, ofwel lijken ze sterk op elkaar.
Omdat deze maat erg gevoelig is voor grootte, is ze het nuttigst wanneer embeddings met numerieke waarden te maken hebben. Dit is met name handig voor aanbevelingsengines die gebruikers laten zien wat ze mogelijk als volgende bestellen op basis van hoe vaak ze een item in het verleden hebben gekocht.
Dotproduct-gelijkenis
Dotproduct-gelijkenis meet niet alleen het product van vectorgroottes, maar ook de cosinus van de hoek ertussen. Het dotproduct houdt dus rekening met zowel de lengte (grootte) als de richting van vectoren!
Wanneer vectoren worden genormaliseerd (de grootte is één maar de richting blijft gelijk), valt dotproduct-gelijkenis samen met cosine similarity omdat de grootte niet langer meetelt.
Dotproduct-gelijkenis wordt het meest gebruikt in domeinen zoals natural language processing (NLP) en computervisie.
Waarom zijn vectoren nuttig in AI-toepassingen?
Je ruwe data is nu weergegeven als vector-embeddings. Laten we kijken naar alle geweldige mogelijkheden die hierdoor ontstaan.
Semantisch zoeken
Semantisch zoeken is een manier om data te doorzoeken op basis van de daadwerkelijke betekenis van de zoekopdracht, niet alleen op exacte overeenkomsten. Dit betekent dat in plaats van te zoeken op specifieke zoekwoorden, resultaten ook verschijnen als een woord verkeerd is gespeld, en dat resultaten worden getoond op basis van synoniemen van de oorspronkelijke query.
Zoek je bijvoorbeeld “best cafes near me”, dan komen bij exact zoeken alleen locaties naar voren die specifiek als “cafes” zijn gelabeld, terwijl een semantische zoekmachine plaatsen toont met “tea”, “coffee”, “pastries”, of andere resultaten die voortkomen uit een diepere contextuele interpretatie.
Hoe is dit zoeken mogelijk? Met vector-embeddings! Stel dat we de query van een gebruiker en de data (zoals locatiebeschrijvingen) embedden. Dan kunnen we ze met elkaar vergelijken in een multidimensionale ruimte en zoeken naar vectoren die het dichtst bij elkaar liggen via methoden zoals similarity search.
Als de gebruiker bijvoorbeeld zoekt op “best cafes near me” en je hebt een database vol ge-embedde, van Google Maps gescrapete locatiebeschrijvingen, dan toont semantisch zoeken de plaatsen waarvan de embeddings het meest lijken op de oorspronkelijke query—ook als het woord “cafe” nergens voorkomt in die beschrijvingen!
Aanbevelingssystemen
Aanbevelingssystemen gebruiken data om mensen te helpen vinden wat ze statistisch gezien waarschijnlijk het leukst vinden, op basis van eerdere aankopen, zoekgeschiedenis, omgevings- en demografische informatie, en meer. Ze worden in vrijwel elke sector gebruikt, van entertainment tot finance.
De meest voor de hand liggende platforms die aanbevelingssystemen gebruiken zijn Spotify, Netflix en Amazon, maar ze zitten in elke industrie—zeker nu steeds meer bedrijven AI omarmen.
Ze zijn getraind om verschillende kenmerken, eerdere beslissingen en voorkeuren van gebruikers te begrijpen op basis van talloze interacties, waaronder clicks, likes en weergaven. Iedereen kent het: nieuwe producten, films of nummers aanbevolen krijgen op basis van je verleden—maar hoe weet een algoritme wat we leuk vinden? Dankzij vector-embeddings!
Op hoog niveau vergelijken aanbevelingssystemen verschillende items met de bekende voorkeuren van een gebruiker. Om die aanbevelingen zinvol te maken, worden zowel de gebruikers als de items omgezet in vector-embeddings. Er zijn twee veelgebruikte technieken: content-based aanbevelingen en collaborative filtering.
Neem films als voorbeeld. Bij content-based aanbevelingen worden films ge-embed op basis van hun kenmerken, en gebruikers op basis van de films die ze eerder hebben gekeken. Het systeem kan vervolgens nieuwe films aanbevelen met vectoren die het dichtst bij de voorkeuren van de gebruiker liggen, of bij de films die ze eerder zagen.
Bij collaborative filtering worden veel gebruikers meegenomen. In plaats van te focussen op één gebruiker en één item, zoekt collaborative filtering naar gebruikers met vectoren die het dichtst bij die van jou liggen en beveelt items of films aan die zij goed vonden.
Chatbots en retrieval-augmented generation (RAG)
Een andere sterke toepassing van vector-embeddings is bij chatbots of RAG.
Retrieval-augmented generation is een manier om de mogelijkheden van large language models (LLM’s) optimaal te benutten door externe, actuele informatie te integreren, zodat LLM’s nauwkeurigere antwoorden kunnen genereren. LLM’s zijn normaal gesproken getraind op statische data, hebben dus een beperkte kennisbasis en kunnen geen lokale of gepersonaliseerde data benaderen.
Met vector-embeddings kun je aangepaste data opslaan in een vectordatabase, zodat je een volledig aanpasbare database met gepersonaliseerde data kunt maken die je in elk project kunt gebruiken! Omdat de data als vector-embeddings is opgeslagen, kun je semantisch vergelijkbare documenten rechtstreeks uit de database ophalen op basis van de query van de gebruiker.
Het mooie aan RAG is dat het perfect is voor verschillende taken, zoals vragen beantwoorden en tekst genereren. Het is dus ideaal om chatbots te bouwen die op gepersonaliseerde data zijn getraind!
Dit zijn slechts enkele van de mogelijkheden met vector-embeddings.
Wat maakt een vectordatabase anders?
De basiskenmerken van vectordatabases zijn natuurlijk dat ze vectoren kunnen opslaan en efficiënt verwerken, uitstekend overweg kunnen met zeer hoge dimensionaliteit, en razendsnel kunnen query’en.
Bij een traditionele relationele database werk je met gestructureerde data: rijen en kolommen in tabellen. Voor vectorgerelateerde processen moet je dan met externe pakketten werken, omdat zulke databases vector-embeddings niet native kunnen opslaan of doorzoeken.
Vectordatabases zijn juist voor dit werk gemaakt: data wordt opgeslagen en verwerkt als vectoren, waardoor complexe, AI-gerichte applicaties eenvoudiger te bouwen zijn. Ze staan bekend om performance, schaalbaarheid, flexibiliteit en betrouwbaarheid. Ze zijn ontworpen om enorme datasets aan te kunnen, ondersteunen ongestructureerde en semi-gestructureerde data en geven ontwikkelaars flexibiliteit over hun projecten.
Hier is een nadere blik op het verschil tussen vectordatabases en traditionele relationele databases:
|
Aspect
|
Vectordatabases
|
Traditionele relationele databases
|
|
Primair datamodel
|
Slaat data op als hoog-dimensionale vectoren (vaak honderden–duizenden dimensies).
|
Slaat gestructureerde data op in tabellen met rijen & getypeerde kolommen.
|
|
Kernquery-paradigma
|
Similarity search (bijv. nearest neighbor) over vector-embeddings.
|
Exacte match-, bereik-, aggregatie- en join-queries op goed gedefinieerde kolommen.
|
|
Native ondersteuning voor embeddings
|
Ingebouwde opslag, indexering (bijv. HNSW, IVF) en snelle retrieval van vector-embeddings.
|
Geen native vectortype; vereist externe extensies of pipelines voor embeddings.
|
|
Prestaties op schaal
|
Geoptimaliseerd voor sub-seconde similarity search over miljoenen tot miljarden vectoren.
|
Geoptimaliseerd voor ACID-transacties en relationele operaties; vector search is traag of ausgelagerd.
|
|
Dataflexibiliteit
|
Kan ongestructureerde & semi-gestructureerde input (tekst, beelden, audio) aan zodra deze zijn omgezet naar vectoren.
|
Werkt het best met strikt gestructureerde schema’s; ongestructureerde data moet worden getransformeerd of apart opgeslagen (bijv. BLOB’s).
|
|
Schaalbaarheidsmodel
|
Horizontaal sharden/partitioneren van vectorindexen; ontworpen voor gedistribueerde operatie.
|
Volwassen verticale & horizontale schaalbaarheid voor tabeldata, maar indexen lopen op bij hoog-dimensionale vectoren.
|
|
Workflow voor ontwikkelaars
|
Eén systeem voor opslag van embeddings + AI/semantische queries; eenvoudigere stack voor ML/AI-apps.
|
Vereist aparte vectorstores of libraries, plus ETL-gluecode om te syncen met de relationele DB.
|
|
Typische use-cases
|
Semantisch zoeken, aanbevelingen, beeld-/audioretrieval, RAG voor LLM’s, anomaliedetectie.
|
OLTP/OLAP-apps, financiële grootboeken, voorraad, CRM, traditionele BI-analytics.
|
|
Sterke punten
|
Snelheid bij hoog-dimensionaal zoeken, eenvoud voor AI-projecten, schaal, flexibiliteit.
|
Sterke consistentie (ACID), volwassen tooling, rijke SQL-analytics, complexe joins.
|
|
Trade-offs / grenzen
|
Zwakker bij complexe relationele joins & multi-row-transacties.
|
Matige native ondersteuning voor vectorgelijkenis, minder geschikt voor AI-zware workloads.
|
MongoDB en vector search = een perfecte match
Veel mensen kennen MongoDB als een documentgebaseerde NoSQL-database, maar weinigen weten dat het dankzij MongoDB Atlas Vector Search eigenlijk ook een vectordatabase is!
Gezien MongoDB’s roots als NoSQL-database kan voor nieuwkomers in dit type database een Introduction to NoSQL nuttig zijn.
Het sterke aan MongoDB als vectordatabase is hoe natuurlijk vector-embeddings passen in het flexibele documentmodel. Met MongoDB Atlas Vector Search kunnen ontwikkelaars vector-embeddings direct in elke collectie opslaan en bevragen. Je vector-embeddings staan dus direct naast je brondata voor eenvoudige referentie.
Dankzij dit format kunnen ontwikkelaars hybrid search uitvoeren, een combinatie van full-text en semantisch zoeken. Zo krijg je niet alleen contextueel vergelijkbare resultaten, maar ook synonieme resultaten. Zie hybrid search als een superslimme bibliothecaris die niet alleen boeken vindt met exact de titel die je noemde, maar ook boeken met vergelijkbare verhalen aanbeveelt!
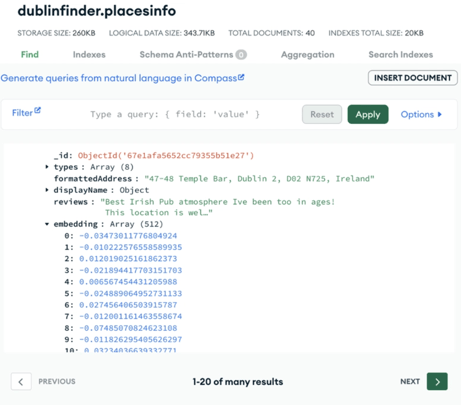
Een voorbeeld van het opslaan van je vector-embedding naast je brondata in MongoDB Atlas. Beeldbron.
Een extra voordeel is dat ontwikkelaars het volledige MongoDB-platform kunnen benutten in hun zeer performante en complexe AI-toepassingen. Features zoals stream processing, realtime analytics, georuimtelijke queries en meer zijn eenvoudig in één applicatie te integreren.
MongoDB’s recente overname van Voyage AI maakt dit proces nog eenvoudiger. De eersteklas embeddingmodellen en rerankers zorgen ervoor dat ontwikkelaars hun data kunnen omzetten in vectoren met zeer hoge nauwkeurigheid, concurrerend in het veld, en met snelle inferentie en meertalige ondersteuning.
Laten we bespreken hoe je aan de slag gaat met MongoDB Atlas Vector Search.
Het installatieproces: vector search in MongoDB
Om te starten met MongoDB Atlas Vector Search, volg je de quickstartgids die je in 15 minuten door het setup-proces leidt.
Je leert onder meer:
- Een Atlas-cluster maken.
- Voorbeelddocumenten laden die al vector-embeddings bevatten.
- Een MongoDB Atlas Vector Search-index boven op die embeddings maken.
- En tot slot een semantische zoekactie uitvoeren om documenten terug te geven die het dichtst bij de initiële query liggen.
Conclusie
Vectordatabases zijn onmisbaar gebleken voor het bouwen van complexe AI-toepassingen. Ze maken het ontwikkelproces soepeler bij het werken met vector-embeddings die voor deze geavanceerde toepassingen nodig zijn, en het mooie aan MongoDB is dat ontwikkelaars hun stack niet hoeven te heruitvinden om hiervan te profiteren.
Door de kracht van het documentmodel te benutten, geeft MongoDB ontwikkelaars een vectordatabase in handen. Je kunt gestructureerde velden, ongestructureerde data en hoog-dimensionale embeddings op één plek combineren!
Belangrijke punten om mee te nemen:
- Vectordatabases slaan data op als lijsten met getallen (vectoren) om snel vergelijkbare data te vinden.
- Embeddings zetten allerlei data om in getallen zodat AI ze beter begrijpt.
- Similarity search helpt “bijna-overeenkomende” resultaten te vinden (zoals vergelijkbare films aanbevelen).
- MongoDB maakt het supermakkelijk door vectoren naast je reguliere data op te slaan!
Om echt te begrijpen welke kracht een vectordatabase in jouw AI-toepassing kan hebben, start een gratis cluster via het platform van MongoDB en probeer het zelf.




Nu kunstmatige intelligentie elke sector binnendringt en verandert, ligt de nadruk vaak op nieuwe features en functionaliteiten, maar wat gebeurt er achter de schermen? Achter elke AI-toepassing zit iets minder glamoureus maar ontzettend cruciaal: de infrastructuur die alles aandrijft. Welke tools maken het mogelijk dat machine learning floreert?
In een datagedreven wereld begint het echt allemaal bij hoe data wordt opgeslagen en, nog belangrijker, hoe data wordt doorzocht. Dáár komen vectordatabases om de hoek kijken.
Vectordatabases ontrafeld
Wat is een vectordatabase precies? Een vectordatabase is een database die speciaal is ontworpen om vector-embeddings op te slaan en te doorzoeken, zodat ontwikkelaars verschillende AI-functionaliteiten kunnen inzetten zoals semantisch zoeken, beeldherkenning, chatbots en nog veel meer.
Maar wat betekent dat nou echt? Om te begrijpen wat een vectordatabase is, zetten we een paar stappen terug. We halen de mystiek rond deze essentiële databases weg door bij het begin te beginnen, met de hoofdrolspeler in dit proces: de vector-embedding.
Wat is een vector-embedding?
Een vector (in de context van kunstmatige intelligentie) is simpelweg een lijst getallen die de semantische betekenis weergeeft van een afbeelding, een zin, audio of zelfs video. Deze reeks getallen helpt computers te begrijpen hoe elk datapunt op elkaar lijkt: ze plaatsen data (zoals woorden of afbeeldingen) als punten op een “wiskundekaart” waar vergelijkbare concepten dichter bij elkaar liggen.
Je kunt vector-embeddings zien als het omzetten van een datapunt naar GPS-coördinaten—data met een vergelijkbare betekenis (zoals “dog” en “puppy”) belanden in dezelfde buurt!
Waarom moeten we onze data omzetten naar vectoren? Stel je voor dat je een machine het verschil wilt uitleggen tussen een kat en een hond. Wij mensen snappen dat, maar een machine begrijpt alleen getallen: het is onmogelijk om je laptop het verschil tussen Toto en Garfield uit te leggen.
Door je data om te zetten naar specifieke vectorstructuren waarbij elk getal uniek is geordend op basis van die brondata, kan je machine relaties tussen verschillende datapunten begrijpen!
Een vector-embedding in een multidimensionale ruimte. Beeldbron.
Laten we bekijken hoe dit kan door similarity search te bespreken.
Similarity search
Similarity search is de techniek om de documenten te vinden die het meest lijken op de oorspronkelijke zoekopdracht van een gebruiker. Zoeken met vectoren is alsof je vraagt: “Welke van deze foto’s lijkt het meest op een kat?” in plaats van alleen het woord “kat” exact te matchen.
Omdat we met vectoren in een multidimensionale ruimte werken, komt er wat wiskunde bij kijken om te bepalen welke embeddings het meest op elkaar lijken.
Er zijn talloze similarity search-algoritmen, maar de drie meest gebruikte zijn:
Cosine similarity
Cosine similarity meet de hoek tussen twee vectoren (de grootte van de vector maakt niet uit) en wordt het meest gebruikt voor tekstembeddings, semantische gelijkenis en aanbevelingssystemen. Het helpt ontwikkelaars de algehele richting van vectoren te vergelijken, wat weer helpt om de algehele inhoud van documenten te bepalen—daarom is het zo belangrijk voor de genoemde onderwerpen.
Euclidische afstand
De Euclidische afstand meet de rechte-lijn afstand tussen twee vectoren in de ruimte. Je kunt het zien als het meten van het kortste pad tussen twee punten op een kaart!
Deze afstand is het meest rechttoe-rechtaan: als de berekende afstand heel klein is, liggen de vectorcoördinaten heel dicht bij elkaar, ofwel lijken ze sterk op elkaar.
Omdat deze maat erg gevoelig is voor grootte, is ze het nuttigst wanneer embeddings met numerieke waarden te maken hebben. Dit is met name handig voor aanbevelingsengines die gebruikers laten zien wat ze mogelijk als volgende bestellen op basis van hoe vaak ze een item in het verleden hebben gekocht.
Dotproduct-gelijkenis
Dotproduct-gelijkenis meet niet alleen het product van vectorgroottes, maar ook de cosinus van de hoek ertussen. Het dotproduct houdt dus rekening met zowel de lengte (grootte) als de richting van vectoren!
Wanneer vectoren worden genormaliseerd (de grootte is één maar de richting blijft gelijk), valt dotproduct-gelijkenis samen met cosine similarity omdat de grootte niet langer meetelt.
Dotproduct-gelijkenis wordt het meest gebruikt in domeinen zoals natural language processing (NLP) en computervisie.
Waarom zijn vectoren nuttig in AI-toepassingen?
Je ruwe data is nu weergegeven als vector-embeddings. Laten we kijken naar alle geweldige mogelijkheden die hierdoor ontstaan.
Semantisch zoeken
Semantisch zoeken is een manier om data te doorzoeken op basis van de daadwerkelijke betekenis van de zoekopdracht, niet alleen op exacte overeenkomsten. Dit betekent dat in plaats van te zoeken op specifieke zoekwoorden, resultaten ook verschijnen als een woord verkeerd is gespeld, en dat resultaten worden getoond op basis van synoniemen van de oorspronkelijke query.
Zoek je bijvoorbeeld “best cafes near me”, dan komen bij exact zoeken alleen locaties naar voren die specifiek als “cafes” zijn gelabeld, terwijl een semantische zoekmachine plaatsen toont met “tea”, “coffee”, “pastries”, of andere resultaten die voortkomen uit een diepere contextuele interpretatie.
Hoe is dit zoeken mogelijk? Met vector-embeddings! Stel dat we de query van een gebruiker en de data (zoals locatiebeschrijvingen) embedden. Dan kunnen we ze met elkaar vergelijken in een multidimensionale ruimte en zoeken naar vectoren die het dichtst bij elkaar liggen via methoden zoals similarity search.
Als de gebruiker bijvoorbeeld zoekt op “best cafes near me” en je hebt een database vol ge-embedde, van Google Maps gescrapete locatiebeschrijvingen, dan toont semantisch zoeken de plaatsen waarvan de embeddings het meest lijken op de oorspronkelijke query—ook als het woord “cafe” nergens voorkomt in die beschrijvingen!
Aanbevelingssystemen
Aanbevelingssystemen gebruiken data om mensen te helpen vinden wat ze statistisch gezien waarschijnlijk het leukst vinden, op basis van eerdere aankopen, zoekgeschiedenis, omgevings- en demografische informatie, en meer. Ze worden in vrijwel elke sector gebruikt, van entertainment tot finance.
De meest voor de hand liggende platforms die aanbevelingssystemen gebruiken zijn Spotify, Netflix en Amazon, maar ze zitten in elke industrie—zeker nu steeds meer bedrijven AI omarmen.
Ze zijn getraind om verschillende kenmerken, eerdere beslissingen en voorkeuren van gebruikers te begrijpen op basis van talloze interacties, waaronder clicks, likes en weergaven. Iedereen kent het: nieuwe producten, films of nummers aanbevolen krijgen op basis van je verleden—maar hoe weet een algoritme wat we leuk vinden? Dankzij vector-embeddings!
Op hoog niveau vergelijken aanbevelingssystemen verschillende items met de bekende voorkeuren van een gebruiker. Om die aanbevelingen zinvol te maken, worden zowel de gebruikers als de items omgezet in vector-embeddings. Er zijn twee veelgebruikte technieken: content-based aanbevelingen en collaborative filtering.
Neem films als voorbeeld. Bij content-based aanbevelingen worden films ge-embed op basis van hun kenmerken, en gebruikers op basis van de films die ze eerder hebben gekeken. Het systeem kan vervolgens nieuwe films aanbevelen met vectoren die het dichtst bij de voorkeuren van de gebruiker liggen, of bij de films die ze eerder zagen.
Bij collaborative filtering worden veel gebruikers meegenomen. In plaats van te focussen op één gebruiker en één item, zoekt collaborative filtering naar gebruikers met vectoren die het dichtst bij die van jou liggen en beveelt items of films aan die zij goed vonden.
Chatbots en retrieval-augmented generation (RAG)
Een andere sterke toepassing van vector-embeddings is bij chatbots of RAG.
Retrieval-augmented generation is een manier om de mogelijkheden van large language models (LLM’s) optimaal te benutten door externe, actuele informatie te integreren, zodat LLM’s nauwkeurigere antwoorden kunnen genereren. LLM’s zijn normaal gesproken getraind op statische data, hebben dus een beperkte kennisbasis en kunnen geen lokale of gepersonaliseerde data benaderen.
Met vector-embeddings kun je aangepaste data opslaan in een vectordatabase, zodat je een volledig aanpasbare database met gepersonaliseerde data kunt maken die je in elk project kunt gebruiken! Omdat de data als vector-embeddings is opgeslagen, kun je semantisch vergelijkbare documenten rechtstreeks uit de database ophalen op basis van de query van de gebruiker.
Het mooie aan RAG is dat het perfect is voor verschillende taken, zoals vragen beantwoorden en tekst genereren. Het is dus ideaal om chatbots te bouwen die op gepersonaliseerde data zijn getraind!
Dit zijn slechts enkele van de mogelijkheden met vector-embeddings.
Wat maakt een vectordatabase anders?
De basiskenmerken van vectordatabases zijn natuurlijk dat ze vectoren kunnen opslaan en efficiënt verwerken, uitstekend overweg kunnen met zeer hoge dimensionaliteit, en razendsnel kunnen query’en.
Bij een traditionele relationele database werk je met gestructureerde data: rijen en kolommen in tabellen. Voor vectorgerelateerde processen moet je dan met externe pakketten werken, omdat zulke databases vector-embeddings niet native kunnen opslaan of doorzoeken.
Vectordatabases zijn juist voor dit werk gemaakt: data wordt opgeslagen en verwerkt als vectoren, waardoor complexe, AI-gerichte applicaties eenvoudiger te bouwen zijn. Ze staan bekend om performance, schaalbaarheid, flexibiliteit en betrouwbaarheid. Ze zijn ontworpen om enorme datasets aan te kunnen, ondersteunen ongestructureerde en semi-gestructureerde data en geven ontwikkelaars flexibiliteit over hun projecten.
Hier is een nadere blik op het verschil tussen vectordatabases en traditionele relationele databases:
Aspect
Vectordatabases
Traditionele relationele databases
Primair datamodel
Slaat data op als hoog-dimensionale vectoren (vaak honderden–duizenden dimensies).
Slaat gestructureerde data op in tabellen met rijen & getypeerde kolommen.
Kernquery-paradigma
Similarity search (bijv. nearest neighbor) over vector-embeddings.
Exacte match-, bereik-, aggregatie- en join-queries op goed gedefinieerde kolommen.
Native ondersteuning voor embeddings
Ingebouwde opslag, indexering (bijv. HNSW, IVF) en snelle retrieval van vector-embeddings.
Geen native vectortype; vereist externe extensies of pipelines voor embeddings.
Prestaties op schaal
Geoptimaliseerd voor sub-seconde similarity search over miljoenen tot miljarden vectoren.
Geoptimaliseerd voor ACID-transacties en relationele operaties; vector search is traag of ausgelagerd.
Dataflexibiliteit
Kan ongestructureerde & semi-gestructureerde input (tekst, beelden, audio) aan zodra deze zijn omgezet naar vectoren.
Werkt het best met strikt gestructureerde schema’s; ongestructureerde data moet worden getransformeerd of apart opgeslagen (bijv. BLOB’s).
Schaalbaarheidsmodel
Horizontaal sharden/partitioneren van vectorindexen; ontworpen voor gedistribueerde operatie.
Volwassen verticale & horizontale schaalbaarheid voor tabeldata, maar indexen lopen op bij hoog-dimensionale vectoren.
Workflow voor ontwikkelaars
Eén systeem voor opslag van embeddings + AI/semantische queries; eenvoudigere stack voor ML/AI-apps.
Vereist aparte vectorstores of libraries, plus ETL-gluecode om te syncen met de relationele DB.
Typische use-cases
Semantisch zoeken, aanbevelingen, beeld-/audioretrieval, RAG voor LLM’s, anomaliedetectie.
OLTP/OLAP-apps, financiële grootboeken, voorraad, CRM, traditionele BI-analytics.
Sterke punten
Snelheid bij hoog-dimensionaal zoeken, eenvoud voor AI-projecten, schaal, flexibiliteit.
Sterke consistentie (ACID), volwassen tooling, rijke SQL-analytics, complexe joins.
Trade-offs / grenzen
Zwakker bij complexe relationele joins & multi-row-transacties.
Matige native ondersteuning voor vectorgelijkenis, minder geschikt voor AI-zware workloads.
MongoDB en vector search = een perfecte match
Veel mensen kennen MongoDB als een documentgebaseerde NoSQL-database, maar weinigen weten dat het dankzij MongoDB Atlas Vector Search eigenlijk ook een vectordatabase is!
Gezien MongoDB’s roots als NoSQL-database kan voor nieuwkomers in dit type database een Introduction to NoSQL nuttig zijn.
Het sterke aan MongoDB als vectordatabase is hoe natuurlijk vector-embeddings passen in het flexibele documentmodel. Met MongoDB Atlas Vector Search kunnen ontwikkelaars vector-embeddings direct in elke collectie opslaan en bevragen. Je vector-embeddings staan dus direct naast je brondata voor eenvoudige referentie.
Dankzij dit format kunnen ontwikkelaars hybrid search uitvoeren, een combinatie van full-text en semantisch zoeken. Zo krijg je niet alleen contextueel vergelijkbare resultaten, maar ook synonieme resultaten. Zie hybrid search als een superslimme bibliothecaris die niet alleen boeken vindt met exact de titel die je noemde, maar ook boeken met vergelijkbare verhalen aanbeveelt!
Een voorbeeld van het opslaan van je vector-embedding naast je brondata in MongoDB Atlas. Beeldbron.
Een extra voordeel is dat ontwikkelaars het volledige MongoDB-platform kunnen benutten in hun zeer performante en complexe AI-toepassingen. Features zoals stream processing, realtime analytics, georuimtelijke queries en meer zijn eenvoudig in één applicatie te integreren.
MongoDB’s recente overname van Voyage AI maakt dit proces nog eenvoudiger. De eersteklas embeddingmodellen en rerankers zorgen ervoor dat ontwikkelaars hun data kunnen omzetten in vectoren met zeer hoge nauwkeurigheid, concurrerend in het veld, en met snelle inferentie en meertalige ondersteuning.
Laten we bespreken hoe je aan de slag gaat met MongoDB Atlas Vector Search.
Het installatieproces: vector search in MongoDB
Om te starten met MongoDB Atlas Vector Search, volg je de quickstartgids die je in 15 minuten door het setup-proces leidt.
Je leert onder meer:
Conclusie
Vectordatabases zijn onmisbaar gebleken voor het bouwen van complexe AI-toepassingen. Ze maken het ontwikkelproces soepeler bij het werken met vector-embeddings die voor deze geavanceerde toepassingen nodig zijn, en het mooie aan MongoDB is dat ontwikkelaars hun stack niet hoeven te heruitvinden om hiervan te profiteren.
Door de kracht van het documentmodel te benutten, geeft MongoDB ontwikkelaars een vectordatabase in handen. Je kunt gestructureerde velden, ongestructureerde data en hoog-dimensionale embeddings op één plek combineren!
Belangrijke punten om mee te nemen:
Om echt te begrijpen welke kracht een vectordatabase in jouw AI-toepassing kan hebben, start een gratis cluster via het platform van MongoDB en probeer het zelf.