कृत्रिम बुद्धिमत्ता हर उद्योग में प्रवेश कर उसे नया आकार दे रही है। ध्यान आम तौर पर नई विशेषताओं और कार्यात्मकताओं पर जाता है, पर परदे के पीछे क्या होता है? हर AI अनुप्रयोग के पीछे कुछ कम चमकदार, लेकिन बेहद महत्वपूर्ण चीज़ होती है: वह अवसंरचना जो उसे शक्ति देती है। तो, ऐसे कौन से टूल हैं जो मशीन लर्निंग को फलने-फूलने देते हैं?
डेटा-प्रधान दुनिया में बात की शुरुआत वास्तव में इस बात से होती है कि डेटा कैसे संग्रहीत किया जाता है—और सबसे महत्वपूर्ण, उसे कैसे खोजा जाता है। यहीं वेक्टर डेटाबेस काम आते हैं।
वेक्टर डेटाबेस का रहस्योद्घाटन
आखिर वेक्टर डेटाबेस है क्या? वेक्टर डेटाबेस विशेष रूप से वेक्टर एम्बेडिंग्स को संग्रहीत करने और उन पर खोज करने के लिए डिज़ाइन किया जाता है, जिससे डेवलपर्स सेमान्टिक सर्च, इमेज रिकग्निशन, चैटबॉट्स, और बहुत कुछ जैसे विभिन्न AI कार्यों का उपयोग कर सकें।
लेकिन इसका मतलब वास्तव में क्या है? इसे पूरी तरह समझने के लिए, दो कदम पीछे चलते हैं। चलिए शुरुआत से बुनियादी बातों को कवर करके इन अहम डेटाबेस का रहस्य खोलते हैं—और शुरुआत करते हैं इस प्रक्रिया के प्रमुख किरदार से: वेक्टर एम्बेडिंग से।
वेक्टर एम्बेडिंग क्या है?
कृत्रिम बुद्धिमत्ता के संदर्भ में, एक वेक्टर संख्याओं की एक सूची होता है जो किसी छवि, वाक्य, ऑडियो, यहाँ तक कि वीडियो के अर्थ को दर्शाता है। यह संख्यात्मक अनुक्रम कंप्यूटरों को यह समझने में मदद करता है कि डेटा के टुकड़े आपस में कैसे समान हैं: वे डेटा (जैसे शब्द या छवियाँ) को एक “गणितीय नक्शे” पर बिंदुओं की तरह रखते हैं, जहाँ मिलते-जुलते विचार एक-दूसरे के पास होते हैं।
वेक्टर एम्बेडिंग्स को आप ऐसे समझ सकते हैं जैसे किसी डेटा को GPS निर्देशांक में बदलना—जिनका अर्थ मिलता-जुलता है (जैसे “dog” और “puppy”), वे एक ही “मोहल्ले” में आ जाते हैं!
हमें अपने डेटा को वेक्टर में क्यों बदलना पड़ता है? मान लीजिए किसी मशीन को बिल्ली और कुत्ते का फर्क समझाना है। इंसान तो यह फर्क सहज रूप से समझ लेते हैं, पर मशीन केवल संख्याएँ समझती है: अपने लैपटॉप को Toto और Garfield में अंतर समझाना नामुमकिन है।
जब आप अपने डेटा को विशिष्ट वेक्टर संरचनाओं में बदलते हैं, जहाँ हर संख्या स्रोत डेटा के अनुसार अद्वितीय क्रम में होती है, तो मशीन विभिन्न डेटा बिंदुओं के बीच संबंध समझने में सक्षम हो जाती है!
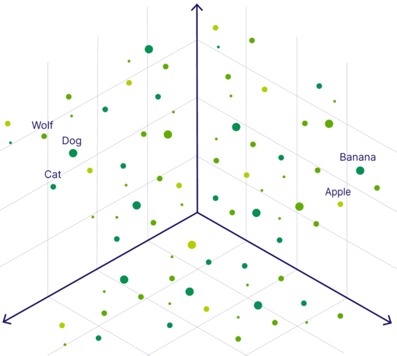
बहुविमीय स्थान में एक वेक्टर एम्बेडिंग का प्रदर्शन. छवि स्रोत.
आइए समझते हैं कि यह कैसे संभव होता है—सिमिलैरिटी सर्च पर चर्चा करके।
सिमिलैरिटी सर्च
सिमिलैरिटी सर्च वह तकनीक है जो किसी उपयोगकर्ता की मूल क्वेरी से सबसे अधिक मिलते-जुलते दस्तावेज़ ढूँढने में मदद करती है। वेक्टर के साथ खोज करना ऐसा है मानो आप पूछ रहे हों, “इन तस्वीरों में से कौन-सी बिल्ली जैसी सबसे ज्यादा दिखती है?”—सिर्फ “cat” शब्द का सटीक मिलान करने के बजाय।
क्योंकि हम बहुविमीय स्थान में वेक्टर से काम कर रहे हैं, तो यह पता लगाने के लिए कि कौन-सी एम्बेडिंग्स सबसे अधिक समान हैं, गणितीय विधियाँ काम में आती हैं।
सिमिलैरिटी सर्च के कई एल्गोरिदम हैं, पर सबसे आम तीन ये हैं:
कोसाइन सिमिलैरिटी
कोसाइन सिमिलैरिटी दो वेक्टरों के बीच का कोण मापती है (वेक्टर के आकार से मतलब नहीं रखती) और आमतौर पर टेक्स्ट एम्बेडिंग्स, सेमान्टिक सिमिलैरिटी, और रिकमेंडेशन सिस्टम्स में उपयोग होती है। यह डेवलपर्स को वेक्टरों की समग्र दिशा की तुलना करने में मदद करती है, जो बदले में दस्तावेज़ों की समग्र सामग्री का आकलन करने में सहायक होती है—इसीलिए यह इन विषयों के लिए इतनी महत्वपूर्ण है।
यूकलिडियन दूरी
यह यूकलिडियन दूरी अंतरिक्ष में दो वेक्टरों के बीच की सीधी-रेखा दूरी मापती है। इसे ऐसे समझें जैसे नक्शे पर दो बिंदुओं के बीच सबसे छोटा रास्ता नापना!
यह दूरी सबसे सीधी-सादी है—यदि गणना की गई दूरी बहुत छोटी है, तो वेक्टर निर्देशांक बहुत पास, यानी एक-दूसरे के बहुत समान हैं।
क्योंकि यह मीट्रिक परिमाण के प्रति संवेदनशील है, यह तब सबसे अधिक उपयोगी है जब एम्बेडिंग्स में संख्यात्मक मानों का महत्व हो। यह विशेषकर रिकमेंडेशन इंजनों में उपयोगी है—जैसे किसी उपयोगकर्ता ने अतीत में कितनी बार कोई वस्तु खरीदी है, उसके आधार पर अगला ऑर्डर क्या हो सकता है बताने में।
डॉट प्रोडक्ट सिमिलैरिटी
डॉट प्रोडक्ट सिमिलैरिटी न केवल वेक्टरों के परिमाणों के गुणनफल को मापती है, बल्कि उनके बीच के कोण के कोसाइन को भी। यानी डॉट प्रोडक्ट वेक्टर की लंबाई (परिमाण) और दिशा—दोनों का ध्यान रखता है!
जब वेक्टर सामान्यीकृत होते हैं (वेक्टर का परिमाण एक कर दिया जाता है, दिशा वही रहती है), तो डॉट प्रोडक्ट सिमिलैरिटी कोसाइन सिमिलैरिटी के बराबर हो जाती है, क्योंकि परिमाण का हिसाब नहीं लिया जाता।
डॉट प्रोडक्ट सिमिलैरिटी का उपयोग प्रायः नेचुरल लैंग्वेज प्रोसेसिंग (NLP) और कंप्यूटर विज़न जैसे क्षेत्रों में होता है।
AI अनुप्रयोगों में वेक्टर क्यों उपयोगी हैं?
अब आपका कच्चा डेटा वेक्टर एम्बेडिंग्स के रूप में प्रस्तुत है। आइए देखें कि इस रूपांतरण से कौन-कौन-सी अद्भुत संभावनाएँ खुलती हैं।
सेमान्टिक सर्च
सेमान्टिक सर्च वह तरीका है जिसमें उपयोगकर्ता की क्वेरी के वास्तविक अर्थ के आधार पर खोज की जाती है—सिर्फ सटीक मिलान पर नहीं। यानी विशेष कीवर्ड न होने पर भी, गलत वर्तनी होने पर भी, और मूल क्वेरी के पर्यायवाची शब्दों के आधार पर भी परिणाम दिखेंगे।
उदाहरण के तौर पर, यदि कोई उपयोगकर्ता “best cafes near me” खोजता है, तो सटीक खोज में केवल “cafes” के लेबल वाले परिणाम आएँगे, जबकि सेमान्टिक सर्च इंजन “tea”, “coffee”, “pastries” जैसे शब्दों को समझकर वे स्थान दिखा देगा जो संदर्भतः प्रासंगिक हों।
यह खोज कैसे संभव होती है? वेक्टर एम्बेडिंग्स से! मान लीजिए हमने उपयोगकर्ता की क्वेरी और डेटा (जैसे लोकेशन विवरण)—दोनों को एम्बेड कर लिया। तब इन्हें बहुविमीय स्थान में एक-दूसरे से तुलना करना संभव हो जाता है, और सिमिलैरिटी सर्च जैसी विधियों से सबसे पास के वेक्टर ढूँढे जा सकते हैं।
उदाहरण के लिए, यदि उपयोगकर्ता ने “best cafes near me” खोजा और हमारे पास Google Maps से स्क्रैप किए गए लोकेशन विवरणों का एम्बेड किया हुआ डेटाबेस है, तो सेमान्टिक सर्च वे स्थान दिखाएगा जिनकी एम्बेडिंग्स मूल क्वेरी से सबसे अधिक मिलती-जुलती हैं—भले ही उन विवरणों में “cafe” शब्द कभी आया ही न हो!
रिकमेंडेशन सिस्टम्स
रिकमेंडेशन सिस्टम्स पिछले खरीद, खोज इतिहास, परिवेशीय और जनसांख्यिकीय जानकारी आदि के आधार पर लोगों को वह चीजें खोजने में मदद करते हैं जो उन्हें सांख्यिकीय रूप से सबसे अधिक पसंद आ सकती हैं। इनका उपयोग लगभग हर उद्योग में होता है—मनोरंजन से लेकर वित्त तक।
Spotify, Netflix और Amazon जैसी कंपनियाँ तो ऐसे स्पष्ट उदाहरण हैं जो रिकमेंडेशन सिस्टम्स का उपयोग करती हैं, पर AI अपनाने के साथ यह लगभग हर उद्योग में प्रचलित हैं।
ये सिस्टम क्लिक्स, लाइक्स, व्यूज़ समेत असंख्य इंटरैक्शनों के आधार पर उपयोगकर्ताओं की विशेषताओं, पूर्व निर्णयों और पसंद-नापसंद को समझने के लिए प्रशिक्षित होते हैं। हमें अतीत की खरीद के आधार पर नए उत्पाद, फ़िल्में, या गाने सुझाए जाते हैं—पर एल्गोरिदम कैसे जानता है कि हमें क्या अच्छा लगेगा? वेक्टर एम्बेडिंग्स की बदौलत!
ऊँचे स्तर पर देखें तो रिकमेंडेशन सिस्टम्स विभिन्न वस्तुओं की तुलना उपयोगकर्ता की जानी-पहचानी पसंद से करते हैं। इन सिफारिशों को सार्थक बनाने के लिए उपयोगकर्ताओं और वस्तुओं—दोनों को वेक्टर एम्बेडिंग्स में बदला जाता है। इसके दो सामान्य तरीके हैं: कंटेंट-आधारित सिफारिशें और कोलेबोरेटिव फिल्टरिंग।
उदाहरण के लिए फ़िल्में लें। कंटेंट-आधारित सिफारिशों में फ़िल्मों को उनकी विशेषताओं के आधार पर एम्बेड किया जाता है, और उपयोगकर्ताओं को उनकी देखी हुई फ़िल्मों के आधार पर एम्बेड किया जाता है। फिर यह सिस्टम उपयोगकर्ता की पसंद के वेक्टरों के सबसे पास वाली फ़िल्मों की सिफारिश कर सकता है—या उन फ़िल्मों जैसी जिनको उन्होंने पहले देखा है।
कोलेबोरेटिव फिल्टरिंग में कई उपयोगकर्ताओं को साथ लेकर चला जाता है। किसी एक उपयोगकर्ता और आइटम पर फोकस करने के बजाय, यह आपके वेक्टर के सबसे पास वाले अन्य उपयोगकर्ताओं को खोजता है और उन्हें पसंद आई वस्तुएँ या फ़िल्में आपको सुझाता है।
चैटबॉट्स और रिट्रीवल-ऑगमेंटेड जनरेशन (RAG)
वेक्टर एम्बेडिंग्स का एक और बढ़िया उपयोग चैटबॉट्स या RAG में होता है।
रिट्रीवल-ऑगमेंटेड जनरेशन बड़े भाषा मॉडलों (LLMs) की क्षमताओं का पूरा लाभ उठाने का तरीका है—इनमें बाहरी, अद्यतित जानकारी जोड़कर ताकि LLM अधिक सटीक उत्तर दे सकें। ऐसा इसलिए क्योंकि LLM प्रायः स्थैतिक डेटा पर प्रशिक्षित होते हैं, उनका ज्ञान-आधार सीमित होता है और वे किसी स्थानीय या वैयक्तिकृत डेटा तक पहुँच नहीं रखते।
वेक्टर एम्बेडिंग्स के साथ, कस्टम डेटा को वेक्टर डेटाबेस में सहेजना संभव है, जिससे आप किसी भी प्रोजेक्ट के लिए उपयोगी पूरी तरह से अनुकूलन योग्य व्यक्तिगत डेटा का डेटाबेस बना सकते हैं! डेटा वेक्टर एम्बेडिंग्स के रूप में संग्रहीत होने से उपयोगकर्ता की क्वेरी के आधार पर सीधे डेटाबेस से सेमान्टिक रूप से मिलते-जुलते दस्तावेज़ प्राप्त करना संभव हो जाता है।
RAG की खूबी यह है कि यह प्रश्नों के उत्तर देने और टेक्स्ट जेनरेट करने जैसे कई कार्यों के लिए उपयुक्त है। यानी यह वैयक्तिकृत डेटा पर प्रशिक्षित चैटबॉट्स बनाने के लिए बेहतरीन है!
वेक्टर एम्बेडिंग्स से संभव क्षमताओं के ये कुछ ही उदाहरण हैं।
वेक्टर डेटाबेस अलग कैसे हैं?
वेक्टर डेटाबेस की बुनियादी विशेषताएँ हैं: वे वेक्टरों को संग्रहीत और कुशलतापूर्वक संसाधित कर सकते हैं, बहुत उच्च-विमीय डेटा के साथ बेहतरीन काम करते हैं, और बेहद तेज़ क्वेरीइंग सक्षम करते हैं।
परंपरागत रिलेशनल डेटाबेस में उपयोगकर्ता को संरचित डेटा से ही काम चलाना पड़ता है, क्योंकि वे तालिकाओं में कॉलम और पंक्ति के रूप में डेटा संभालते हैं। साथ ही, वेक्टर-संबंधी प्रक्रियाओं के लिए थर्ड-पार्टी पैकेजों का सहारा लेना पड़ता है, क्योंकि ऐसे डेटाबेस स्वाभाविक रूप से वेक्टर एम्बेडिंग्स को न तो संग्रहीत कर पाते हैं और न ही उन पर खोज कर पाते हैं।
वेक्टर डेटाबेस इसी तरह के काम के लिए बनाए गए हैं: डेटा वेक्टर के रूप में संग्रहीत और संसाधित होता है, जिससे जटिल, AI-केंद्रित अनुप्रयोग सरलता से बनाए जा सकते हैं। वे अपनी परफ़ॉर्मेंस, स्केलेबिलिटी, लचीलापन और विश्वसनीयता के लिए जाने जाते हैं। ये विशाल डेटासेट्स संभालने के लिए डिज़ाइन किए गए हैं, असंरचित और अर्ध-संरचित डेटा को सपोर्ट कर सकते हैं, और डेवलपर्स को अपने प्रोजेक्ट्स पर पर्याप्त लचीलापन देते हैं।
यहाँ वेक्टर डेटाबेस और पारंपरिक रिलेशनल डेटाबेस के बीच का गहन अंतर देखें:
|
पहलू
|
वेक्टर डेटाबेस
|
पारंपरिक रिलेशनल डेटाबेस
|
|
प्राथमिक डेटा मॉडल
|
डेटा को उच्च-विमीय वेक्टरों के रूप में संग्रहीत करता है (अक्सर सैकड़ों–हज़ारों विमाएँ)।
|
संरचित डेटा को पंक्तियों और टाइप किए गए कॉलम वाली तालिकाओं में रखता है।
|
|
मुख्य क्वेरी प्रतिमान
|
वेक्टर एम्बेडिंग्स पर सिमिलैरिटी सर्च (जैसे, नज़दीकी-पड़ोसी)।
|
सटीक मिलान, रेंज, एग्रीगेशन, और जोइन क्वेरी—अच्छी तरह परिभाषित कॉलमों पर।
|
|
एम्बेडिंग्स के लिए नैटिव सपोर्ट
|
इनबिल्ट स्टोरेज, इंडेक्सिंग (जैसे, HNSW, IVF), और वेक्टर एम्बेडिंग्स की तेज़ रिट्रीवल।
|
कोई नैटिव वेक्टर प्रकार नहीं; एम्बेडिंग्स संभालने के लिए बाहरी एक्सटेंशन या पाइपलाइनों की ज़रूरत।
|
|
स्केल पर प्रदर्शन
|
लाखों–अरबों वेक्टरों पर सब-सेकंड सिमिलैरिटी सर्च के लिए अनुकूलित।
|
ACID ट्रांज़ैक्शंस और रिलेशनल ऑपरेशंस के लिए अनुकूलित; वेक्टर सर्च धीमा या ऑफ-लोडेड।
|
|
डेटा लचीलापन
|
असंरचित और अर्ध-संरचित इनपुट (टेक्स्ट, इमेज, ऑडियो) को वेक्टर में बदलने के बाद संभालता है।
|
कड़े संरचित स्कीमाओं के साथ सर्वश्रेष्ठ; असंरचित डेटा को बदलना या अलग रखना पड़ता है (जैसे, BLOBs)।
|
|
स्केलेबिलिटी मॉडल
|
वेक्टर इंडेक्सों का क्षैतिज शार्डिंग/पार्टिशनिंग; वितरित संचालन के लिए डिज़ाइन।
|
टैब्युलर डेटा के लिए परिपक्व वर्टिकल और हॉरिज़ॉन्टल स्केलिंग, पर उच्च-विमीय वेक्टरों के साथ इंडेक्स बहुत बड़े हो जाते हैं।
|
|
डेवलपर वर्कफ़्लो
|
एम्बेडिंग्स स्टोरेज + AI/सेमान्टिक क्वेरी चलाने के लिए एक ही सिस्टम; ML/AI ऐप्स के लिए सरल स्टैक।
|
अलग वेक्टर स्टोर्स या लाइब्रेरीज़ की ज़रूरत, और रिलेशनल DB के साथ सिंक करने को ETL ग्लू कोड।
|
|
सामान्य उपयोग-परिदृश्य
|
सेमान्टिक सर्च, सिफारिश, इमेज/ऑडियो रिट्रीवल, LLMs के लिए RAG, विसंगति जाँच।
|
OLTP/OLAP ऐप्स, वित्तीय लेज़र, इन्वेंटरी, CRM, पारंपरिक BI एनालिटिक्स।
|
|
ताकत
|
उच्च-विमीय सर्च स्पीड, AI प्रोजेक्ट्स के लिए सादगी, स्केल, लचीलापन।
|
मज़बूत स्थिरता (ACID), परिपक्व टूलिंग, समृद्ध SQL एनालिटिक्स, जटिल जोइन।
|
|
ट्रेड-ऑफ़ / सीमाएँ
|
जटिल रिलेशनल जोइन और मल्टी-रो ट्रांज़ैक्शंस में अपेक्षाकृत कमज़ोर।
|
वेक्टर सिमिलैरिटी के लिए कमज़ोर नैटिव सपोर्ट, AI-प्रधान वर्कलोड्स के लिए कम उपयुक्त।
|
MongoDB और वेक्टर सर्च = एक परफ़ेक्ट जोड़ी
बहुत से लोग MongoDB को एक डॉक्यूमेंट-आधारित NoSQL डेटाबेस के रूप में जानते हैं, पर बहुतों को यह नहीं पता कि MongoDB Atlas Vector Search की बदौलत यह वास्तव में एक वेक्टर डेटाबेस भी है!
MongoDB की जड़ें NoSQL डेटाबेस में होने के कारण, जो लोग इस प्रकार के डेटाबेस में नए हैं वे इस Introduction to NoSQL से लाभ उठा सकते हैं।
एक वेक्टर डेटाबेस के रूप में MongoDB की सबसे बड़ी ताकत यह है कि वेक्टर एम्बेडिंग्स उसके लचीले डॉक्यूमेंट मॉडल में स्वाभाविक रूप से फिट हो जाती हैं। MongoDB Atlas Vector Search डेवलपर्स को किसी भी कलेक्शन के भीतर सीधे वेक्टर एम्बेडिंग्स को स्टोर और क्वेरी करने देता है। यानी आपकी वेक्टर एम्बेडिंग्स आपके स्रोत डेटा के ठीक बगल में संग्रहीत रहती हैं—संदर्भ के लिए आसान।
इस फ़ॉर्मैट की वजह से डेवलपर्स हाइब्रिड सर्च कर सकते हैं, जो फुल-टेक्स्ट और सेमान्टिक सर्च का संयोजन है—ताकि संदर्भतः समान परिणामों के साथ-साथ समानार्थी परिणाम भी सुनिश्चित हों। हाइब्रिड सर्च को आप ऐसे समझें जैसे एक सुपर-स्मार्ट लाइब्रेरियन, जो न सिर्फ वही किताब ढूंढता है जिसका शीर्षक आपने पूछा, बल्कि वैसी ही कहानियों वाली किताबें भी सुझा देता है!
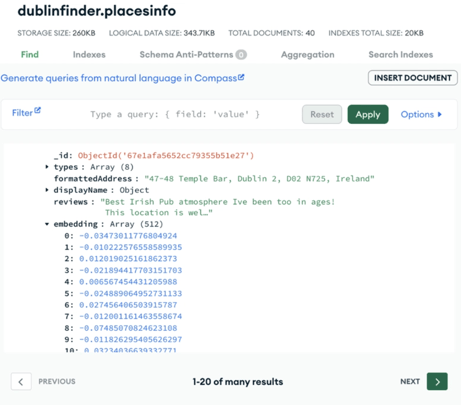
MongoDB Atlas में अपने स्रोत डेटा के बगल में वेक्टर एम्बेडिंग स्टोर करने का उदाहरण। छवि स्रोत.
इस फ़ॉर्मैट का एक और लाभ यह है कि डेवलपर्स अपनी उच्च-प्रदर्शन और जटिल AI एप्लिकेशनों में MongoDB के पूरे प्लेटफ़ॉर्म का पूरा उपयोग कर सकते हैं। स्ट्रीम प्रोसेसिंग, रियल-टाइम एनालिटिक्स, जियोस्पेशियल क्वेरीज़ और बहुत कुछ—सब एक ही एप्लिकेशन में आसानी से जोड़ा जा सकता है।
MongoDB द्वारा हाल ही में Voyage AI का अधिग््रहण इस प्रक्रिया को और भी सरल बनाता है। विश्व-स्तरीय एम्बेडिंग मॉडल और री-रैंकर्स डेटा को अत्यधिक सटीक वेक्टरों में बदलने में मदद करते हैं—जो प्रतिस्पर्धी हैं, तेज़ इन्फ़रेंस देते हैं और बहुभाषी सपोर्ट प्रदान करते हैं।
आइए देखें कि MongoDB Atlas Vector Search के साथ शुरुआत कैसे करें।
सेटअप प्रक्रिया: MongoDB में वेक्टर सर्च
MongoDB Atlas Vector Search के साथ शुरुआत करने के लिए, कृपया क्विकस्टार्ट गाइड का पालन करें—यह आपको 15 मिनट की सेटअप प्रक्रिया से गुज़ारेगा।
इसमें आप सीखेंगे कि कैसे:
- एक Atlas क्लस्टर बनाएँ।
- ऐसे सैंपल दस्तावेज़ लोड करें जिनमें पहले से वेक्टर एम्बेडिंग्स मौजूद हों।
- उन एम्बेडिंग्स पर MongoDB Atlas Vector Search इंडेक्स बनाएँ।
- और अंत में, सेमान्टिक सर्च चलाएँ ताकि शुरुआती क्वेरी के सबसे निकट दस्तावेज़ मिल सकें।
निष्कर्ष
जटिल AI अनुप्रयोगों के निर्माण के लिए वेक्टर डेटाबेस एक आवश्यकता साबित हुए हैं। वे उन वेक्टर एम्बेडिंग्स के साथ काम करते समय विकास प्रक्रिया को सुगम बनाते हैं, जो उन्नत अनुप्रयोगों के लिए ज़रूरी हैं—और MongoDB की खूबी यह है कि डेवलपर्स को इसका लाभ उठाने के लिए अपना पूरा स्टैक फिर से नहीं बनाना पड़ता।
डॉक्यूमेंट मॉडल की शक्ति का उपयोग करके MongoDB डेवलपर्स को एक वेक्टर डेटाबेस प्रदान करता है—जहाँ संरचित फ़ील्ड्स, असंरचित डेटा और उच्च-विमीय एम्बेडिंग्स—सब एक ही जगह पर जोड़े जा सकते हैं!
कुछ मुख्य बातें:
- वेक्टर डेटाबेस डेटा को संख्याओं की सूची (वेक्टर) के रूप में संग्रहीत करते हैं ताकि मिलते-जुलते डेटा को जल्दी ढूँढा जा सके।
- एम्बेडिंग्स किसी भी डेटा को संख्याओं में बदल देती हैं ताकि AI उन्हें बेहतर समझ सके।
- सिमिलैरिटी सर्च “क़रीबी मेल” ढूँढने में मदद करती है (जैसे मिलती-जुलती फ़िल्में सुझाना)।
- MongoDB यह सब आसान बनाता है—क्योंकि वह आपके नियमित डेटा के साथ-साथ वेक्टर भी स्टोर करता है!
यह समझने के लिए कि आपका AI अनुप्रयोग वेक्टर डेटाबेस से कितनी शक्ति पाएगा, MongoDB के प्लेटफ़ॉर्म पर एक मुफ़्त क्लस्टर स्पिन करें और खुद आज़माएँ।


कृत्रिम बुद्धिमत्ता हर उद्योग में प्रवेश कर उसे नया आकार दे रही है। ध्यान आम तौर पर नई विशेषताओं और कार्यात्मकताओं पर जाता है, पर परदे के पीछे क्या होता है? हर AI अनुप्रयोग के पीछे कुछ कम चमकदार, लेकिन बेहद महत्वपूर्ण चीज़ होती है: वह अवसंरचना जो उसे शक्ति देती है। तो, ऐसे कौन से टूल हैं जो मशीन लर्निंग को फलने-फूलने देते हैं?
डेटा-प्रधान दुनिया में बात की शुरुआत वास्तव में इस बात से होती है कि डेटा कैसे संग्रहीत किया जाता है—और सबसे महत्वपूर्ण, उसे कैसे खोजा जाता है। यहीं वेक्टर डेटाबेस काम आते हैं।
वेक्टर डेटाबेस का रहस्योद्घाटन
आखिर वेक्टर डेटाबेस है क्या? वेक्टर डेटाबेस विशेष रूप से वेक्टर एम्बेडिंग्स को संग्रहीत करने और उन पर खोज करने के लिए डिज़ाइन किया जाता है, जिससे डेवलपर्स सेमान्टिक सर्च, इमेज रिकग्निशन, चैटबॉट्स, और बहुत कुछ जैसे विभिन्न AI कार्यों का उपयोग कर सकें।
लेकिन इसका मतलब वास्तव में क्या है? इसे पूरी तरह समझने के लिए, दो कदम पीछे चलते हैं। चलिए शुरुआत से बुनियादी बातों को कवर करके इन अहम डेटाबेस का रहस्य खोलते हैं—और शुरुआत करते हैं इस प्रक्रिया के प्रमुख किरदार से: वेक्टर एम्बेडिंग से।
वेक्टर एम्बेडिंग क्या है?
कृत्रिम बुद्धिमत्ता के संदर्भ में, एक वेक्टर संख्याओं की एक सूची होता है जो किसी छवि, वाक्य, ऑडियो, यहाँ तक कि वीडियो के अर्थ को दर्शाता है। यह संख्यात्मक अनुक्रम कंप्यूटरों को यह समझने में मदद करता है कि डेटा के टुकड़े आपस में कैसे समान हैं: वे डेटा (जैसे शब्द या छवियाँ) को एक “गणितीय नक्शे” पर बिंदुओं की तरह रखते हैं, जहाँ मिलते-जुलते विचार एक-दूसरे के पास होते हैं।
वेक्टर एम्बेडिंग्स को आप ऐसे समझ सकते हैं जैसे किसी डेटा को GPS निर्देशांक में बदलना—जिनका अर्थ मिलता-जुलता है (जैसे “dog” और “puppy”), वे एक ही “मोहल्ले” में आ जाते हैं!
हमें अपने डेटा को वेक्टर में क्यों बदलना पड़ता है? मान लीजिए किसी मशीन को बिल्ली और कुत्ते का फर्क समझाना है। इंसान तो यह फर्क सहज रूप से समझ लेते हैं, पर मशीन केवल संख्याएँ समझती है: अपने लैपटॉप को Toto और Garfield में अंतर समझाना नामुमकिन है।
जब आप अपने डेटा को विशिष्ट वेक्टर संरचनाओं में बदलते हैं, जहाँ हर संख्या स्रोत डेटा के अनुसार अद्वितीय क्रम में होती है, तो मशीन विभिन्न डेटा बिंदुओं के बीच संबंध समझने में सक्षम हो जाती है!
बहुविमीय स्थान में एक वेक्टर एम्बेडिंग का प्रदर्शन. छवि स्रोत.
आइए समझते हैं कि यह कैसे संभव होता है—सिमिलैरिटी सर्च पर चर्चा करके।
सिमिलैरिटी सर्च
सिमिलैरिटी सर्च वह तकनीक है जो किसी उपयोगकर्ता की मूल क्वेरी से सबसे अधिक मिलते-जुलते दस्तावेज़ ढूँढने में मदद करती है। वेक्टर के साथ खोज करना ऐसा है मानो आप पूछ रहे हों, “इन तस्वीरों में से कौन-सी बिल्ली जैसी सबसे ज्यादा दिखती है?”—सिर्फ “cat” शब्द का सटीक मिलान करने के बजाय।
क्योंकि हम बहुविमीय स्थान में वेक्टर से काम कर रहे हैं, तो यह पता लगाने के लिए कि कौन-सी एम्बेडिंग्स सबसे अधिक समान हैं, गणितीय विधियाँ काम में आती हैं।
सिमिलैरिटी सर्च के कई एल्गोरिदम हैं, पर सबसे आम तीन ये हैं:
कोसाइन सिमिलैरिटी
कोसाइन सिमिलैरिटी दो वेक्टरों के बीच का कोण मापती है (वेक्टर के आकार से मतलब नहीं रखती) और आमतौर पर टेक्स्ट एम्बेडिंग्स, सेमान्टिक सिमिलैरिटी, और रिकमेंडेशन सिस्टम्स में उपयोग होती है। यह डेवलपर्स को वेक्टरों की समग्र दिशा की तुलना करने में मदद करती है, जो बदले में दस्तावेज़ों की समग्र सामग्री का आकलन करने में सहायक होती है—इसीलिए यह इन विषयों के लिए इतनी महत्वपूर्ण है।
यूकलिडियन दूरी
यह यूकलिडियन दूरी अंतरिक्ष में दो वेक्टरों के बीच की सीधी-रेखा दूरी मापती है। इसे ऐसे समझें जैसे नक्शे पर दो बिंदुओं के बीच सबसे छोटा रास्ता नापना!
यह दूरी सबसे सीधी-सादी है—यदि गणना की गई दूरी बहुत छोटी है, तो वेक्टर निर्देशांक बहुत पास, यानी एक-दूसरे के बहुत समान हैं।
क्योंकि यह मीट्रिक परिमाण के प्रति संवेदनशील है, यह तब सबसे अधिक उपयोगी है जब एम्बेडिंग्स में संख्यात्मक मानों का महत्व हो। यह विशेषकर रिकमेंडेशन इंजनों में उपयोगी है—जैसे किसी उपयोगकर्ता ने अतीत में कितनी बार कोई वस्तु खरीदी है, उसके आधार पर अगला ऑर्डर क्या हो सकता है बताने में।
डॉट प्रोडक्ट सिमिलैरिटी
डॉट प्रोडक्ट सिमिलैरिटी न केवल वेक्टरों के परिमाणों के गुणनफल को मापती है, बल्कि उनके बीच के कोण के कोसाइन को भी। यानी डॉट प्रोडक्ट वेक्टर की लंबाई (परिमाण) और दिशा—दोनों का ध्यान रखता है!
जब वेक्टर सामान्यीकृत होते हैं (वेक्टर का परिमाण एक कर दिया जाता है, दिशा वही रहती है), तो डॉट प्रोडक्ट सिमिलैरिटी कोसाइन सिमिलैरिटी के बराबर हो जाती है, क्योंकि परिमाण का हिसाब नहीं लिया जाता।
डॉट प्रोडक्ट सिमिलैरिटी का उपयोग प्रायः नेचुरल लैंग्वेज प्रोसेसिंग (NLP) और कंप्यूटर विज़न जैसे क्षेत्रों में होता है।
AI अनुप्रयोगों में वेक्टर क्यों उपयोगी हैं?
अब आपका कच्चा डेटा वेक्टर एम्बेडिंग्स के रूप में प्रस्तुत है। आइए देखें कि इस रूपांतरण से कौन-कौन-सी अद्भुत संभावनाएँ खुलती हैं।
सेमान्टिक सर्च
सेमान्टिक सर्च वह तरीका है जिसमें उपयोगकर्ता की क्वेरी के वास्तविक अर्थ के आधार पर खोज की जाती है—सिर्फ सटीक मिलान पर नहीं। यानी विशेष कीवर्ड न होने पर भी, गलत वर्तनी होने पर भी, और मूल क्वेरी के पर्यायवाची शब्दों के आधार पर भी परिणाम दिखेंगे।
उदाहरण के तौर पर, यदि कोई उपयोगकर्ता “best cafes near me” खोजता है, तो सटीक खोज में केवल “cafes” के लेबल वाले परिणाम आएँगे, जबकि सेमान्टिक सर्च इंजन “tea”, “coffee”, “pastries” जैसे शब्दों को समझकर वे स्थान दिखा देगा जो संदर्भतः प्रासंगिक हों।
यह खोज कैसे संभव होती है? वेक्टर एम्बेडिंग्स से! मान लीजिए हमने उपयोगकर्ता की क्वेरी और डेटा (जैसे लोकेशन विवरण)—दोनों को एम्बेड कर लिया। तब इन्हें बहुविमीय स्थान में एक-दूसरे से तुलना करना संभव हो जाता है, और सिमिलैरिटी सर्च जैसी विधियों से सबसे पास के वेक्टर ढूँढे जा सकते हैं।
उदाहरण के लिए, यदि उपयोगकर्ता ने “best cafes near me” खोजा और हमारे पास Google Maps से स्क्रैप किए गए लोकेशन विवरणों का एम्बेड किया हुआ डेटाबेस है, तो सेमान्टिक सर्च वे स्थान दिखाएगा जिनकी एम्बेडिंग्स मूल क्वेरी से सबसे अधिक मिलती-जुलती हैं—भले ही उन विवरणों में “cafe” शब्द कभी आया ही न हो!
रिकमेंडेशन सिस्टम्स
रिकमेंडेशन सिस्टम्स पिछले खरीद, खोज इतिहास, परिवेशीय और जनसांख्यिकीय जानकारी आदि के आधार पर लोगों को वह चीजें खोजने में मदद करते हैं जो उन्हें सांख्यिकीय रूप से सबसे अधिक पसंद आ सकती हैं। इनका उपयोग लगभग हर उद्योग में होता है—मनोरंजन से लेकर वित्त तक।
Spotify, Netflix और Amazon जैसी कंपनियाँ तो ऐसे स्पष्ट उदाहरण हैं जो रिकमेंडेशन सिस्टम्स का उपयोग करती हैं, पर AI अपनाने के साथ यह लगभग हर उद्योग में प्रचलित हैं।
ये सिस्टम क्लिक्स, लाइक्स, व्यूज़ समेत असंख्य इंटरैक्शनों के आधार पर उपयोगकर्ताओं की विशेषताओं, पूर्व निर्णयों और पसंद-नापसंद को समझने के लिए प्रशिक्षित होते हैं। हमें अतीत की खरीद के आधार पर नए उत्पाद, फ़िल्में, या गाने सुझाए जाते हैं—पर एल्गोरिदम कैसे जानता है कि हमें क्या अच्छा लगेगा? वेक्टर एम्बेडिंग्स की बदौलत!
ऊँचे स्तर पर देखें तो रिकमेंडेशन सिस्टम्स विभिन्न वस्तुओं की तुलना उपयोगकर्ता की जानी-पहचानी पसंद से करते हैं। इन सिफारिशों को सार्थक बनाने के लिए उपयोगकर्ताओं और वस्तुओं—दोनों को वेक्टर एम्बेडिंग्स में बदला जाता है। इसके दो सामान्य तरीके हैं: कंटेंट-आधारित सिफारिशें और कोलेबोरेटिव फिल्टरिंग।
उदाहरण के लिए फ़िल्में लें। कंटेंट-आधारित सिफारिशों में फ़िल्मों को उनकी विशेषताओं के आधार पर एम्बेड किया जाता है, और उपयोगकर्ताओं को उनकी देखी हुई फ़िल्मों के आधार पर एम्बेड किया जाता है। फिर यह सिस्टम उपयोगकर्ता की पसंद के वेक्टरों के सबसे पास वाली फ़िल्मों की सिफारिश कर सकता है—या उन फ़िल्मों जैसी जिनको उन्होंने पहले देखा है।
कोलेबोरेटिव फिल्टरिंग में कई उपयोगकर्ताओं को साथ लेकर चला जाता है। किसी एक उपयोगकर्ता और आइटम पर फोकस करने के बजाय, यह आपके वेक्टर के सबसे पास वाले अन्य उपयोगकर्ताओं को खोजता है और उन्हें पसंद आई वस्तुएँ या फ़िल्में आपको सुझाता है।
चैटबॉट्स और रिट्रीवल-ऑगमेंटेड जनरेशन (RAG)
वेक्टर एम्बेडिंग्स का एक और बढ़िया उपयोग चैटबॉट्स या RAG में होता है।
रिट्रीवल-ऑगमेंटेड जनरेशन बड़े भाषा मॉडलों (LLMs) की क्षमताओं का पूरा लाभ उठाने का तरीका है—इनमें बाहरी, अद्यतित जानकारी जोड़कर ताकि LLM अधिक सटीक उत्तर दे सकें। ऐसा इसलिए क्योंकि LLM प्रायः स्थैतिक डेटा पर प्रशिक्षित होते हैं, उनका ज्ञान-आधार सीमित होता है और वे किसी स्थानीय या वैयक्तिकृत डेटा तक पहुँच नहीं रखते।
वेक्टर एम्बेडिंग्स के साथ, कस्टम डेटा को वेक्टर डेटाबेस में सहेजना संभव है, जिससे आप किसी भी प्रोजेक्ट के लिए उपयोगी पूरी तरह से अनुकूलन योग्य व्यक्तिगत डेटा का डेटाबेस बना सकते हैं! डेटा वेक्टर एम्बेडिंग्स के रूप में संग्रहीत होने से उपयोगकर्ता की क्वेरी के आधार पर सीधे डेटाबेस से सेमान्टिक रूप से मिलते-जुलते दस्तावेज़ प्राप्त करना संभव हो जाता है।
RAG की खूबी यह है कि यह प्रश्नों के उत्तर देने और टेक्स्ट जेनरेट करने जैसे कई कार्यों के लिए उपयुक्त है। यानी यह वैयक्तिकृत डेटा पर प्रशिक्षित चैटबॉट्स बनाने के लिए बेहतरीन है!
वेक्टर एम्बेडिंग्स से संभव क्षमताओं के ये कुछ ही उदाहरण हैं।
वेक्टर डेटाबेस अलग कैसे हैं?
वेक्टर डेटाबेस की बुनियादी विशेषताएँ हैं: वे वेक्टरों को संग्रहीत और कुशलतापूर्वक संसाधित कर सकते हैं, बहुत उच्च-विमीय डेटा के साथ बेहतरीन काम करते हैं, और बेहद तेज़ क्वेरीइंग सक्षम करते हैं।
परंपरागत रिलेशनल डेटाबेस में उपयोगकर्ता को संरचित डेटा से ही काम चलाना पड़ता है, क्योंकि वे तालिकाओं में कॉलम और पंक्ति के रूप में डेटा संभालते हैं। साथ ही, वेक्टर-संबंधी प्रक्रियाओं के लिए थर्ड-पार्टी पैकेजों का सहारा लेना पड़ता है, क्योंकि ऐसे डेटाबेस स्वाभाविक रूप से वेक्टर एम्बेडिंग्स को न तो संग्रहीत कर पाते हैं और न ही उन पर खोज कर पाते हैं।
वेक्टर डेटाबेस इसी तरह के काम के लिए बनाए गए हैं: डेटा वेक्टर के रूप में संग्रहीत और संसाधित होता है, जिससे जटिल, AI-केंद्रित अनुप्रयोग सरलता से बनाए जा सकते हैं। वे अपनी परफ़ॉर्मेंस, स्केलेबिलिटी, लचीलापन और विश्वसनीयता के लिए जाने जाते हैं। ये विशाल डेटासेट्स संभालने के लिए डिज़ाइन किए गए हैं, असंरचित और अर्ध-संरचित डेटा को सपोर्ट कर सकते हैं, और डेवलपर्स को अपने प्रोजेक्ट्स पर पर्याप्त लचीलापन देते हैं।
यहाँ वेक्टर डेटाबेस और पारंपरिक रिलेशनल डेटाबेस के बीच का गहन अंतर देखें:
पहलू
वेक्टर डेटाबेस
पारंपरिक रिलेशनल डेटाबेस
प्राथमिक डेटा मॉडल
डेटा को उच्च-विमीय वेक्टरों के रूप में संग्रहीत करता है (अक्सर सैकड़ों–हज़ारों विमाएँ)।
संरचित डेटा को पंक्तियों और टाइप किए गए कॉलम वाली तालिकाओं में रखता है।
मुख्य क्वेरी प्रतिमान
वेक्टर एम्बेडिंग्स पर सिमिलैरिटी सर्च (जैसे, नज़दीकी-पड़ोसी)।
सटीक मिलान, रेंज, एग्रीगेशन, और जोइन क्वेरी—अच्छी तरह परिभाषित कॉलमों पर।
एम्बेडिंग्स के लिए नैटिव सपोर्ट
इनबिल्ट स्टोरेज, इंडेक्सिंग (जैसे, HNSW, IVF), और वेक्टर एम्बेडिंग्स की तेज़ रिट्रीवल।
कोई नैटिव वेक्टर प्रकार नहीं; एम्बेडिंग्स संभालने के लिए बाहरी एक्सटेंशन या पाइपलाइनों की ज़रूरत।
स्केल पर प्रदर्शन
लाखों–अरबों वेक्टरों पर सब-सेकंड सिमिलैरिटी सर्च के लिए अनुकूलित।
ACID ट्रांज़ैक्शंस और रिलेशनल ऑपरेशंस के लिए अनुकूलित; वेक्टर सर्च धीमा या ऑफ-लोडेड।
डेटा लचीलापन
असंरचित और अर्ध-संरचित इनपुट (टेक्स्ट, इमेज, ऑडियो) को वेक्टर में बदलने के बाद संभालता है।
कड़े संरचित स्कीमाओं के साथ सर्वश्रेष्ठ; असंरचित डेटा को बदलना या अलग रखना पड़ता है (जैसे, BLOBs)।
स्केलेबिलिटी मॉडल
वेक्टर इंडेक्सों का क्षैतिज शार्डिंग/पार्टिशनिंग; वितरित संचालन के लिए डिज़ाइन।
टैब्युलर डेटा के लिए परिपक्व वर्टिकल और हॉरिज़ॉन्टल स्केलिंग, पर उच्च-विमीय वेक्टरों के साथ इंडेक्स बहुत बड़े हो जाते हैं।
डेवलपर वर्कफ़्लो
एम्बेडिंग्स स्टोरेज + AI/सेमान्टिक क्वेरी चलाने के लिए एक ही सिस्टम; ML/AI ऐप्स के लिए सरल स्टैक।
अलग वेक्टर स्टोर्स या लाइब्रेरीज़ की ज़रूरत, और रिलेशनल DB के साथ सिंक करने को ETL ग्लू कोड।
सामान्य उपयोग-परिदृश्य
सेमान्टिक सर्च, सिफारिश, इमेज/ऑडियो रिट्रीवल, LLMs के लिए RAG, विसंगति जाँच।
OLTP/OLAP ऐप्स, वित्तीय लेज़र, इन्वेंटरी, CRM, पारंपरिक BI एनालिटिक्स।
ताकत
उच्च-विमीय सर्च स्पीड, AI प्रोजेक्ट्स के लिए सादगी, स्केल, लचीलापन।
मज़बूत स्थिरता (ACID), परिपक्व टूलिंग, समृद्ध SQL एनालिटिक्स, जटिल जोइन।
ट्रेड-ऑफ़ / सीमाएँ
जटिल रिलेशनल जोइन और मल्टी-रो ट्रांज़ैक्शंस में अपेक्षाकृत कमज़ोर।
वेक्टर सिमिलैरिटी के लिए कमज़ोर नैटिव सपोर्ट, AI-प्रधान वर्कलोड्स के लिए कम उपयुक्त।
MongoDB और वेक्टर सर्च = एक परफ़ेक्ट जोड़ी
बहुत से लोग MongoDB को एक डॉक्यूमेंट-आधारित NoSQL डेटाबेस के रूप में जानते हैं, पर बहुतों को यह नहीं पता कि MongoDB Atlas Vector Search की बदौलत यह वास्तव में एक वेक्टर डेटाबेस भी है!
MongoDB की जड़ें NoSQL डेटाबेस में होने के कारण, जो लोग इस प्रकार के डेटाबेस में नए हैं वे इस Introduction to NoSQL से लाभ उठा सकते हैं।
एक वेक्टर डेटाबेस के रूप में MongoDB की सबसे बड़ी ताकत यह है कि वेक्टर एम्बेडिंग्स उसके लचीले डॉक्यूमेंट मॉडल में स्वाभाविक रूप से फिट हो जाती हैं। MongoDB Atlas Vector Search डेवलपर्स को किसी भी कलेक्शन के भीतर सीधे वेक्टर एम्बेडिंग्स को स्टोर और क्वेरी करने देता है। यानी आपकी वेक्टर एम्बेडिंग्स आपके स्रोत डेटा के ठीक बगल में संग्रहीत रहती हैं—संदर्भ के लिए आसान।
इस फ़ॉर्मैट की वजह से डेवलपर्स हाइब्रिड सर्च कर सकते हैं, जो फुल-टेक्स्ट और सेमान्टिक सर्च का संयोजन है—ताकि संदर्भतः समान परिणामों के साथ-साथ समानार्थी परिणाम भी सुनिश्चित हों। हाइब्रिड सर्च को आप ऐसे समझें जैसे एक सुपर-स्मार्ट लाइब्रेरियन, जो न सिर्फ वही किताब ढूंढता है जिसका शीर्षक आपने पूछा, बल्कि वैसी ही कहानियों वाली किताबें भी सुझा देता है!
MongoDB Atlas में अपने स्रोत डेटा के बगल में वेक्टर एम्बेडिंग स्टोर करने का उदाहरण। छवि स्रोत.
इस फ़ॉर्मैट का एक और लाभ यह है कि डेवलपर्स अपनी उच्च-प्रदर्शन और जटिल AI एप्लिकेशनों में MongoDB के पूरे प्लेटफ़ॉर्म का पूरा उपयोग कर सकते हैं। स्ट्रीम प्रोसेसिंग, रियल-टाइम एनालिटिक्स, जियोस्पेशियल क्वेरीज़ और बहुत कुछ—सब एक ही एप्लिकेशन में आसानी से जोड़ा जा सकता है।
MongoDB द्वारा हाल ही में Voyage AI का अधिग््रहण इस प्रक्रिया को और भी सरल बनाता है। विश्व-स्तरीय एम्बेडिंग मॉडल और री-रैंकर्स डेटा को अत्यधिक सटीक वेक्टरों में बदलने में मदद करते हैं—जो प्रतिस्पर्धी हैं, तेज़ इन्फ़रेंस देते हैं और बहुभाषी सपोर्ट प्रदान करते हैं।
आइए देखें कि MongoDB Atlas Vector Search के साथ शुरुआत कैसे करें।
सेटअप प्रक्रिया: MongoDB में वेक्टर सर्च
MongoDB Atlas Vector Search के साथ शुरुआत करने के लिए, कृपया क्विकस्टार्ट गाइड का पालन करें—यह आपको 15 मिनट की सेटअप प्रक्रिया से गुज़ारेगा।
इसमें आप सीखेंगे कि कैसे:
निष्कर्ष
जटिल AI अनुप्रयोगों के निर्माण के लिए वेक्टर डेटाबेस एक आवश्यकता साबित हुए हैं। वे उन वेक्टर एम्बेडिंग्स के साथ काम करते समय विकास प्रक्रिया को सुगम बनाते हैं, जो उन्नत अनुप्रयोगों के लिए ज़रूरी हैं—और MongoDB की खूबी यह है कि डेवलपर्स को इसका लाभ उठाने के लिए अपना पूरा स्टैक फिर से नहीं बनाना पड़ता।
डॉक्यूमेंट मॉडल की शक्ति का उपयोग करके MongoDB डेवलपर्स को एक वेक्टर डेटाबेस प्रदान करता है—जहाँ संरचित फ़ील्ड्स, असंरचित डेटा और उच्च-विमीय एम्बेडिंग्स—सब एक ही जगह पर जोड़े जा सकते हैं!
कुछ मुख्य बातें:
यह समझने के लिए कि आपका AI अनुप्रयोग वेक्टर डेटाबेस से कितनी शक्ति पाएगा, MongoDB के प्लेटफ़ॉर्म पर एक मुफ़्त क्लस्टर स्पिन करें और खुद आज़माएँ।