Yapay zekânın her sektöre nüfuz edip onları dönüştürdüğü günümüzde, odağımız çoğunlukla yeni özellikler ve işlevlerde. Peki, perde arkasında neler oluyor? Her yapay zeka uygulamasının arkasında, göz alıcı olmaktan uzak ama son derece kritik bir unsur var: onu çalıştıran altyapı. Peki makine öğreniminin gelişmesini mümkün kılan araçlar neler?
Veri odaklı bir dünyada her şey verinin nasıl saklandığıyla, daha da önemlisi nasıl arandığıyla başlar. İşte vektör veritabanları burada devreye girer.
Vektör Veritabanlarına Kısa Bir Bakış
Peki vektör veritabanı tam olarak nedir? Vektör veritabanı, vektör gömülerini saklamak ve bunlar üzerinde arama yapmak için özel olarak tasarlanmış bir veritabanıdır; geliştiricilerin anlamsal arama, görsel tanıma, sohbet botları ve çok daha fazlası gibi çeşitli yapay zeka işlevlerini kullanmasına olanak tanır.
Peki bunun anlamı tam olarak ne? Bir vektör veritabanının ne olduğunu tam olarak kavramak için birkaç adım geri gidelim. Bu kritik veritabanlarını en baştan temel kavramları ele alarak, sürecin kilit oyuncusu olan vektör gömüsünden başlayarak açıklığa kavuşturalım.
Vektör Gömüsü Nedir?
Vektör (yapay zekâ bağlamında), bir görselin, bir cümlenin, sesin ve hatta videonun anlamsal anlamını temsil eden bir sayı listesidir. Bu sayı dizisi, bilgisayarların her bir veri parçasının birbirine ne kadar benzediğini anlamasına yardımcı olur: Verileri (örneğin kelimeler veya görseller) benzer kavramların birbirine daha yakın olduğu bir “matematik haritasında” noktalar olarak yerleştirirler.
Vektör gömülerini, bir veri parçasını GPS koordinatına dönüştürmek gibi düşünebiliriz—benzer anlamlara sahip veriler (“dog” ve “puppy” gibi) aynı mahallede buluşur!
Peki verilerimizi neden vektörlere dönüştürmemiz gerekiyor? Bir makineye kediyle köpek arasındaki farkı anlatmaya çalıştığınızı hayal edin. İnsanlar bu farkı anlayabilir, ancak bir makine yalnızca sayıları kavrayabilir: Bilgisayarınıza Toto ile Garfield arasındaki farkı açıklamak imkânsızdır.
Verinizi, her bir sayının kaynak veriye göre benzersiz biçimde sıralandığı belirli vektör yapılara dönüştürerek, makinenizin çeşitli veri noktaları arasındaki ilişkileri anlamasını sağlarsınız!
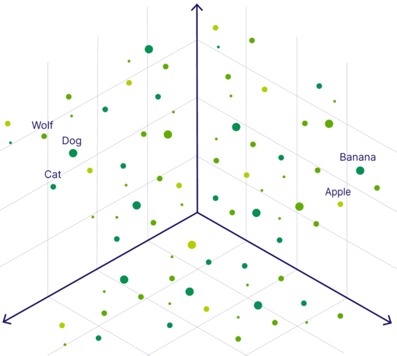
Çok boyutlu uzayda bir vektör gömüsünün gösterimi. Görsel kaynağı.
Bunun nasıl mümkün olduğunu benzerlik aramasını tartışarak inceleyelim.
Benzerlik araması
Benzerlik araması, kullanıcının ilk sorgusuna en çok benzeyen dokümanları bulmak için kullanılan tekniktir. Vektörlerle arama yapmak, yalnızca “kedi” kelimesini tam eşleştirmek yerine “Bu resimlerden hangisi en çok kediye benziyor?” diye sormaya benzer.
Çok boyutlu uzaydaki vektörlerle uğraştığımız için, hangi gömülerin birbirine en çok benzediğini bulmamıza yardımcı olacak bazı matematiksel işlemler devreye girer.
Birçok benzerlik arama algoritması vardır, ancak en yaygın üçü şunlardır:
Kosinüs benzerliği
Kosinüs benzerliği iki vektör arasındaki açıyı ölçer (vektörün büyüklüğüyle ilgilenmez) ve en çok metin gömüleri, anlamsal benzerlik ve öneri sistemlerinde kullanılır. Geliştiricilerin vektörlerin genel yönünü karşılaştırmasına yardımcı olur; bu da dokümanların genel içeriğini anlamayı sağlar ve listelenen konular için neden bu kadar önemli olduğunu açıklar.
Öklidyen mesafe
Öklidyen mesafe uzaydaki iki vektör arasındaki düz çizgi mesafesini ölçer. Bunu düşünmenin harika bir yolu, haritadaki iki nokta arasındaki en kısa yolu ölçmektir!
Bu mesafe en anlaşılır olanıdır; zira hesaplanan mesafe çok küçükse vektör koordinatları birbirine çok yakındır, yani birbirine çok benzer.
Bu ölçüt büyüklüklere karşı çok hassas olduğundan, sayısal değerlerle ilgili gömülerde en kullanışlı olandır. Bu, özellikle kullanıcıların geçmişte bir ürünü kaç kez satın aldığına göre bir sonraki sipariş için öneriler sunan öneri motorları için faydalıdır.
Noktasal çarpım benzerliği
Noktasal çarpım benzerliği yalnızca vektör büyüklüklerinin çarpımını değil, aralarındaki açının kosinüsünü de ölçer. Yani noktasal çarpım hem vektörlerin uzunluğuyla (büyüklük) hem de yönüyle ilgilenir!
Vektörler normalize edildiğinde (vektörün büyüklüğü bire eşitlenir, yönü aynı kalır), noktasal çarpım benzerliği, büyüklük artık hesaba katılmadığından kosinüs benzerliğiyle aynı olur.
Noktasal çarpım benzerliği en yaygın olarak doğal dil işleme (NLP) ve bilgisayarlı görü gibi alanlarda kullanılır.
Vektörler Yapay Zeka Uygulamalarında Neden Faydalıdır?
Artık ham verileriniz vektör gömüleri olarak temsil ediliyor. Bu gömüler sayesinde açılan muazzam olanaklara bakalım.
Anlamsal arama
Anlamsal arama, yalnızca tam eşleşme yerine kullanıcının sorgusunun gerçek anlamına göre arama yapmanın bir yoludur. Bu, belirli anahtar kelimelere göre aramak yerine, bir kelime yanlış yazılsa bile sonuçların gösterileceği ve orijinal sorgudaki eş anlamlılara göre sonuçların sunulacağı anlamına gelir.
Örneğin bir kullanıcı “yakınımdaki en iyi kafeler” diye arama yapıyorsa, tam eşleşmede yalnızca özellikle “kafe” etiketi olan yerler çıkar; oysa anlamsal arama motoru “çay”, “kahve”, “hamur işi” gibi daha derin bağlamın sunduğu sonuçları da anlar ve gösterir.
Peki bu arama nasıl mümkün oluyor? Vektör gömüleri sayesinde! Diyelim ki bir kullanıcının sorgusunu ve verileri (örneğin konum açıklamalarını) gömdük. Bu sayede bunları çok boyutlu uzayda birbirleriyle karşılaştırmak, benzerlik araması gibi yöntemlerle birbirine en yakın vektörleri bulmak mümkün olur.
Örneğin, kullanıcı “yakınımdaki en iyi kafeler” diye sorgu gönderdi ve gömülmüş Google Haritalar konum açıklamalarıyla dolu bir veritabanımız var. Anlamsal arama, bu açıklamalarda “kafe” kelimesi hiç geçmese bile, gömüleri orijinal sorguya en çok benzeyen yerleri gösterecektir!
Öneri sistemleri
Öneri sistemleri; önceki satın alımlar, arama geçmişi, çevresel ve demografik bilgiler ve daha fazlasına dayanarak insanların istatistiksel olarak en çok hoşlanacağı şeyleri bulmalarına yardımcı olmak için verileri kullanır. Eğlenceden finansa kadar hemen her sektörde kullanılırlar.
Öneri sistemlerini kullanan bariz platformlar arasında Spotify, Netflix ve Amazon yer alır; ancak özellikle daha fazla şirket yapay zeka stratejileri benimsedikçe her sektörde karşımıza çıkarlar.
Tıklamalar, beğeniler ve görüntülemeler dahil çok sayıda etkileşime göre kullanıcıların çeşitli özelliklerini, önceki kararlarını ve tercihlerini anlamak üzere tamamen eğitilmiştirler. Hepimiz, geçmiş satın alımlarımıza göre yeni ürün, film veya şarkı önerilmesine aşinayız; peki bir algoritma neyi sevebileceğimizi nasıl bilir? Vektör gömüleri sayesinde!
Yüksek düzeyde, öneri sistemleri çeşitli öğeleri kullanıcının bilinen tercihlerine göre karşılaştırır. Bu önerileri anlamlı kılmak için hem kullanıcılar hem de öğeler vektör gömülerine dönüştürülür. Bunun için iki yaygın teknik vardır: içerik tabanlı öneriler ve işbirlikçi filtreleme.
Örneğimiz film olsun. İçerik tabanlı önerilerde, filmler çeşitli özelliklerine göre gömülür; kullanıcılar ise geçmişte izledikleri filmlere göre gömülür. Sistem, kullanıcının tercih vektörlerine ya da geçmişte izlediği filmlere en yakın vektörlere sahip yeni filmleri önerebilir.
İşbirlikçi filtrelemede ise çok sayıda kullanıcı dikkate alınır. Yalnızca tek bir kullanıcı ve bir öğeye odaklanmak yerine, işbirlikçi filtreleme sizin vektörlerinize en yakın vektörlere sahip çeşitli kullanıcıları bulur ve onların beğendiği öğeleri veya filmleri önerir.
Sohbet botları ve alma ile zenginleştirilmiş üretim (RAG)
Vektör gömülerinin bir diğer harika kullanım alanı sohbet botları veya RAG’dir.
Alma ile zenginleştirilmiş üretim (RAG), büyük dil modellerinin (LLM) yeteneklerini, haricî ve güncel bilgileri entegre ederek tam anlamıyla kullanmanın bir yoludur; böylece LLM’ler daha doğru yanıtlar üretebilir. Bunun nedeni, LLM’lerin genellikle statik verilerle eğitilmesidir; bu yüzden sınırlı bir bilgi tabanına sahiptirler ve yerel veya kişiselleştirilmiş herhangi bir veriye erişemezler.
Vektör gömüleriyle özel verileri bir vektör veritabanında saklamak mümkündür; bu da herhangi bir projede kullanılabilecek, tamamen özelleştirilebilir, kişiselleştirilmiş bir veri tabanı oluşturmayı sağlar! Veriler vektör gömüleri olarak saklandığından, kullanıcının sorgusuna göre doğrudan veritabanından anlamsal olarak benzer dokümanları almak mümkündür.
RAG’in güzel yanı, soru yanıtlama ve metin üretme gibi çeşitli görevler için mükemmel olmasıdır. Yani kişiselleştirilmiş verilerle eğitilmiş sohbet botları geliştirmek için idealdir!
Bunlar vektör gömülerinin sunduğu olanaklardan yalnızca birkaçıdır.
Bir Vektör Veritabanını Farklı Kılan Nedir?
Vektör veritabanlarının temel özellikleri; vektörleri saklayıp verimli şekilde işleyebilmeleri, çok yüksek boyutlu verilerle mükemmel çalışmaları ve son derece hızlı sorgulama imkânı sunmalarıdır.
Geleneksel ilişkisel bir veritabanında kullanıcılar, tablolar içindeki sütun ve satırlardan oluşan yapılandırılmış verilerle çalışmak zorundadır. Ayrıca yapılandırılmış veritabanları vektör gömülerini yerel olarak depolayıp arayamadığından, ilişkisel veritabanları ve vektörle ilgili süreçlerle başa çıkmak için üçüncü taraf paketler kullanmak gerekir.
Vektör veritabanları bu iş için tasarlanmıştır: Veriler vektör olarak saklanır ve işlenir; bu da daha karmaşık, yapay zeka odaklı uygulamaların kolayca inşa edilebileceği anlamına gelir. Vektör veritabanları performansları, ölçeklenebilirlikleri, esneklikleri ve güvenilirlikleriyle de bilinir. Devasa veri kümelerini işlemek üzere tasarlanmışlardır; yapılandırılmamış ve yarı yapılandırılmış verileri destekleyebilir ve geliştiricilere projeleri üzerinde esneklik tanır.
İşte vektör veritabanları ile geleneksel ilişkisel veritabanları arasındaki farklara daha derin bir bakış:
|
Boyut
|
Vektör Veritabanları
|
Geleneksel İlişkisel Veritabanları
|
|
Birincil veri modeli
|
Verileri yüksek boyutlu vektörler olarak saklar (genellikle yüzlerce–binlerce boyut).
|
Verileri satır ve türlendirilmiş sütunlardan oluşan tablolarda yapılandırılmış şekilde saklar.
|
|
Çekirdek sorgu paradigması
|
Vektör gömüleri üzerinde benzerlik araması (örn. en yakın komşu).
|
İyi tanımlanmış sütunlarda tam eşleşme, aralık, toplama ve birleştirme sorguları.
|
|
Gömüler için yerel destek
|
Yerleşik depolama, indeksleme (örn. HNSW, IVF) ve vektör gömülerinin hızlı getirimi.
|
Yerel vektör türü yok; gömüler için haricî eklentiler veya boru hatları gerekir.
|
|
Ölçekte performans
|
Milyonlardan milyarlara vektör üzerinde saniyenin altında benzerlik araması için optimize edilmiştir.
|
ACID işlemler ve ilişkisel operasyonlar için optimize edilmiştir; vektör araması yavaştır veya dışa aktarılır.
|
|
Veri esnekliği
|
Vektöre dönüştürüldükten sonra yapılandırılmamış ve yarı yapılandırılmış girdileri (metin, görsel, ses) işler.
|
En iyi, katı şemalara sahip yapılarda çalışır; yapılandırılmamış veri dönüştürülmeli veya ayrı saklanmalıdır (örn. BLOB’lar).
|
|
Ölçeklenebilirlik modeli
|
Vektör indekslerinin yatay parçalanması/bölümlenmesi; dağıtık çalışmaya uygun tasarım.
|
Tablolu veriler için olgun dikey ve yatay ölçekleme, ancak yüksek boyutlu vektörlerde indeksler şişer.
|
|
Geliştirici iş akışı
|
Gömüleri depolamak + yapay zeka/anlamsal sorgular çalıştırmak için tek bir sistem; ML/AI uygulamaları için daha basit yığın.
|
İlişkisel veritabanıyla senkron için ayrı vektör depoları veya kütüphaneler ve ETL yapıştırıcı kod gerekir.
|
|
Tipik kullanım alanları
|
Anlamsal arama, öneri, görsel/ses alma, LLM’ler için RAG, anomali tespiti.
|
OLTP/OLAP uygulamaları, finansal defterler, envanter, CRM, geleneksel BI analitiği.
|
|
Güçlü yönler
|
Yüksek boyutlu arama hızı, yapay zeka projelerinde sadelik, ölçek, esneklik.
|
Güçlü tutarlılık (ACID), olgun araç seti, zengin SQL analitiği, karmaşık birleştirmeler.
|
|
Takaslar / sınırlar
|
Karmaşık ilişkisel birleştirmeler ve çok satırlı işlemlerde daha zayıf.
|
Vektör benzerliği için zayıf yerel destek, yapay zeka ağırlıklı iş yüklerine daha az uygun.
|
MongoDB ve Vektör Arama = Mükemmel Uyum
Pek çok kişi MongoDB’yi belge tabanlı bir NoSQL veritabanı olarak bilse de, MongoDB Atlas Vector Search sayesinde aslında bir vektör veritabanıdır!
MongoDB’nin NoSQL kökleri göz önüne alındığında, bu veritabanı türüne yeni olanlar Introduction to NoSQL’dan fayda görebilir.
MongoDB’nin bir vektör veritabanı olarak güçlü yanı, vektör gömülerinin esnek belge modeline son derece doğal şekilde uyum sağlamasıdır. MongoDB Atlas Vector Search, geliştiricilerin vektör gömülerini doğrudan herhangi bir koleksiyon içinde saklayıp sorgulamasına olanak tanır. Bu, vektör gömülerinizin kolay başvuru için kaynak verinizin hemen yanında saklandığı anlamına gelir.
Bu format sayesinde geliştiriciler, hibrit arama yapabilir; bu da yalnızca bağlamsal olarak benzer sonuçların değil, eşanlamlı sonuçların da gösterilmesini sağlayan tam metin ve anlamsal aramanın bir kombinasyonudur. Hibrit aramayı, yalnızca istediğiniz başlıktaki kitapları bulmakla kalmayıp benzer hikâyeleri de öneren süper zeki bir kütüphaneci gibi düşünebiliriz!
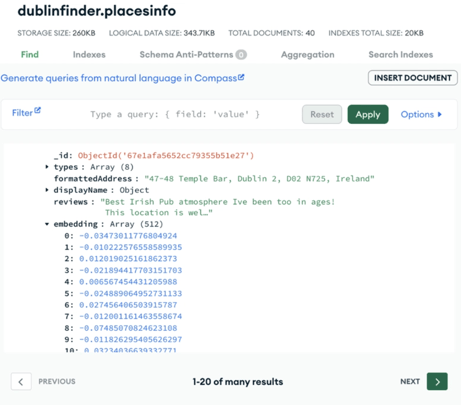
MongoDB Atlas’ta vektör gömünüzü kaynak verinizin yanında saklamaya bir örnek. Görsel kaynağı.
Bu formatın bir diğer faydası, geliştiricilerin yüksek performanslı ve karmaşık yapay zeka uygulamalarında MongoDB’nin tüm platformundan tam anlamıyla yararlanabilmesidir. Akış işleme, gerçek zamanlı analitik, coğrafi sorgular ve daha fazlası gibi özellikler tek bir uygulamaya kolayca entegre edilebilir.
MongoDB’nin Voyage AI satın alımı, bu sürecin daha da basitleştirilmesine yardımcı olur. Sunulan dünya standartlarındaki gömme modelleri ve yeniden sıralayıcılar, geliştiricilerin verilerini son derece yüksek doğrulukla vektörlere dönüştürmesini, rekabetçi performans elde etmesini ve hızlı çıkarım ile çok dilli desteğe ulaşmasını sağlar.
MongoDB Atlas Vector Search ile nasıl başlayacağımızı inceleyelim.
Kurulum süreci: MongoDB’de vektör arama
MongoDB Atlas Vector Search ile başlamanız için, sizi 15 dakikalık bir kurulumdan geçirecek hızlı başlangıç rehberini takip edin.
Aşağıdakileri nasıl yapacağınızı gösterecek:
- Bir Atlas kümesi oluşturun.
- Vektör gömülerini zaten içeren örnek dokümanları yükleyin.
- Bu gömüler üzerinde bir MongoDB Atlas Vector Search indeksi oluşturun.
- Ve son olarak, başlangıç sorgusuna en yakın dokümanları döndürmek için bir anlamsal arama gerçekleştirin.
Sonuç
Vektör veritabanları, karmaşık yapay zeka uygulamaları geliştirmek için bir gereklilik olduğunu kanıtladı. Bu gelişmiş uygulamalar için gereken vektör gömüleriyle çalışırken geliştirme sürecini kolaylaştırırlar ve MongoDB’nin güzelliği, geliştiricilerin bunlardan faydalanmaya başlamak için tüm yığınlarını yeniden icat etmek zorunda olmamasıdır.
Belge modelinin gücünden yararlanarak MongoDB, geliştiricileri vektör veritabanıyla güçlendirir. Yapılandırılmış alanları, yapılandırılmamış verileri ve yüksek boyutlu gömüleri tek bir yerde birleştirmek mümkündür!
Bazı kilit noktalar:
- Vektör veritabanları, kullanıcıların benzer verileri hızla bulmasına yardımcı olmak için verileri sayı listeleri (vektörler) olarak saklar.
- Gömüler, yapay zekânın daha iyi anlayabilmesi için her türlü veriyi sayılara dönüştürür.
- Benzerlik araması, “yakın eşleşmeleri” bulmaya yardımcı olur (benzer filmleri önermek gibi).
- MongoDB, vektörleri normal verilerinizin yanında saklayarak işi son derece kolaylaştırır!
Bir vektör veritabanının yapay zeka uygulamanıza katacağı gücü gerçekten anlamak için, MongoDB’nin platformu üzerinden bir ücretsiz küme başlatın ve kendiniz deneyin.





Yapay zekânın her sektöre nüfuz edip onları dönüştürdüğü günümüzde, odağımız çoğunlukla yeni özellikler ve işlevlerde. Peki, perde arkasında neler oluyor? Her yapay zeka uygulamasının arkasında, göz alıcı olmaktan uzak ama son derece kritik bir unsur var: onu çalıştıran altyapı. Peki makine öğreniminin gelişmesini mümkün kılan araçlar neler?
Veri odaklı bir dünyada her şey verinin nasıl saklandığıyla, daha da önemlisi nasıl arandığıyla başlar. İşte vektör veritabanları burada devreye girer.
Vektör Veritabanlarına Kısa Bir Bakış
Peki vektör veritabanı tam olarak nedir? Vektör veritabanı, vektör gömülerini saklamak ve bunlar üzerinde arama yapmak için özel olarak tasarlanmış bir veritabanıdır; geliştiricilerin anlamsal arama, görsel tanıma, sohbet botları ve çok daha fazlası gibi çeşitli yapay zeka işlevlerini kullanmasına olanak tanır.
Peki bunun anlamı tam olarak ne? Bir vektör veritabanının ne olduğunu tam olarak kavramak için birkaç adım geri gidelim. Bu kritik veritabanlarını en baştan temel kavramları ele alarak, sürecin kilit oyuncusu olan vektör gömüsünden başlayarak açıklığa kavuşturalım.
Vektör Gömüsü Nedir?
Vektör (yapay zekâ bağlamında), bir görselin, bir cümlenin, sesin ve hatta videonun anlamsal anlamını temsil eden bir sayı listesidir. Bu sayı dizisi, bilgisayarların her bir veri parçasının birbirine ne kadar benzediğini anlamasına yardımcı olur: Verileri (örneğin kelimeler veya görseller) benzer kavramların birbirine daha yakın olduğu bir “matematik haritasında” noktalar olarak yerleştirirler.
Vektör gömülerini, bir veri parçasını GPS koordinatına dönüştürmek gibi düşünebiliriz—benzer anlamlara sahip veriler (“dog” ve “puppy” gibi) aynı mahallede buluşur!
Peki verilerimizi neden vektörlere dönüştürmemiz gerekiyor? Bir makineye kediyle köpek arasındaki farkı anlatmaya çalıştığınızı hayal edin. İnsanlar bu farkı anlayabilir, ancak bir makine yalnızca sayıları kavrayabilir: Bilgisayarınıza Toto ile Garfield arasındaki farkı açıklamak imkânsızdır.
Verinizi, her bir sayının kaynak veriye göre benzersiz biçimde sıralandığı belirli vektör yapılara dönüştürerek, makinenizin çeşitli veri noktaları arasındaki ilişkileri anlamasını sağlarsınız!
Çok boyutlu uzayda bir vektör gömüsünün gösterimi. Görsel kaynağı.
Bunun nasıl mümkün olduğunu benzerlik aramasını tartışarak inceleyelim.
Benzerlik araması
Benzerlik araması, kullanıcının ilk sorgusuna en çok benzeyen dokümanları bulmak için kullanılan tekniktir. Vektörlerle arama yapmak, yalnızca “kedi” kelimesini tam eşleştirmek yerine “Bu resimlerden hangisi en çok kediye benziyor?” diye sormaya benzer.
Çok boyutlu uzaydaki vektörlerle uğraştığımız için, hangi gömülerin birbirine en çok benzediğini bulmamıza yardımcı olacak bazı matematiksel işlemler devreye girer.
Birçok benzerlik arama algoritması vardır, ancak en yaygın üçü şunlardır:
Kosinüs benzerliği
Kosinüs benzerliği iki vektör arasındaki açıyı ölçer (vektörün büyüklüğüyle ilgilenmez) ve en çok metin gömüleri, anlamsal benzerlik ve öneri sistemlerinde kullanılır. Geliştiricilerin vektörlerin genel yönünü karşılaştırmasına yardımcı olur; bu da dokümanların genel içeriğini anlamayı sağlar ve listelenen konular için neden bu kadar önemli olduğunu açıklar.
Öklidyen mesafe
Öklidyen mesafe uzaydaki iki vektör arasındaki düz çizgi mesafesini ölçer. Bunu düşünmenin harika bir yolu, haritadaki iki nokta arasındaki en kısa yolu ölçmektir!
Bu mesafe en anlaşılır olanıdır; zira hesaplanan mesafe çok küçükse vektör koordinatları birbirine çok yakındır, yani birbirine çok benzer.
Bu ölçüt büyüklüklere karşı çok hassas olduğundan, sayısal değerlerle ilgili gömülerde en kullanışlı olandır. Bu, özellikle kullanıcıların geçmişte bir ürünü kaç kez satın aldığına göre bir sonraki sipariş için öneriler sunan öneri motorları için faydalıdır.
Noktasal çarpım benzerliği
Noktasal çarpım benzerliği yalnızca vektör büyüklüklerinin çarpımını değil, aralarındaki açının kosinüsünü de ölçer. Yani noktasal çarpım hem vektörlerin uzunluğuyla (büyüklük) hem de yönüyle ilgilenir!
Vektörler normalize edildiğinde (vektörün büyüklüğü bire eşitlenir, yönü aynı kalır), noktasal çarpım benzerliği, büyüklük artık hesaba katılmadığından kosinüs benzerliğiyle aynı olur.
Noktasal çarpım benzerliği en yaygın olarak doğal dil işleme (NLP) ve bilgisayarlı görü gibi alanlarda kullanılır.
Vektörler Yapay Zeka Uygulamalarında Neden Faydalıdır?
Artık ham verileriniz vektör gömüleri olarak temsil ediliyor. Bu gömüler sayesinde açılan muazzam olanaklara bakalım.
Anlamsal arama
Anlamsal arama, yalnızca tam eşleşme yerine kullanıcının sorgusunun gerçek anlamına göre arama yapmanın bir yoludur. Bu, belirli anahtar kelimelere göre aramak yerine, bir kelime yanlış yazılsa bile sonuçların gösterileceği ve orijinal sorgudaki eş anlamlılara göre sonuçların sunulacağı anlamına gelir.
Örneğin bir kullanıcı “yakınımdaki en iyi kafeler” diye arama yapıyorsa, tam eşleşmede yalnızca özellikle “kafe” etiketi olan yerler çıkar; oysa anlamsal arama motoru “çay”, “kahve”, “hamur işi” gibi daha derin bağlamın sunduğu sonuçları da anlar ve gösterir.
Peki bu arama nasıl mümkün oluyor? Vektör gömüleri sayesinde! Diyelim ki bir kullanıcının sorgusunu ve verileri (örneğin konum açıklamalarını) gömdük. Bu sayede bunları çok boyutlu uzayda birbirleriyle karşılaştırmak, benzerlik araması gibi yöntemlerle birbirine en yakın vektörleri bulmak mümkün olur.
Örneğin, kullanıcı “yakınımdaki en iyi kafeler” diye sorgu gönderdi ve gömülmüş Google Haritalar konum açıklamalarıyla dolu bir veritabanımız var. Anlamsal arama, bu açıklamalarda “kafe” kelimesi hiç geçmese bile, gömüleri orijinal sorguya en çok benzeyen yerleri gösterecektir!
Öneri sistemleri
Öneri sistemleri; önceki satın alımlar, arama geçmişi, çevresel ve demografik bilgiler ve daha fazlasına dayanarak insanların istatistiksel olarak en çok hoşlanacağı şeyleri bulmalarına yardımcı olmak için verileri kullanır. Eğlenceden finansa kadar hemen her sektörde kullanılırlar.
Öneri sistemlerini kullanan bariz platformlar arasında Spotify, Netflix ve Amazon yer alır; ancak özellikle daha fazla şirket yapay zeka stratejileri benimsedikçe her sektörde karşımıza çıkarlar.
Tıklamalar, beğeniler ve görüntülemeler dahil çok sayıda etkileşime göre kullanıcıların çeşitli özelliklerini, önceki kararlarını ve tercihlerini anlamak üzere tamamen eğitilmiştirler. Hepimiz, geçmiş satın alımlarımıza göre yeni ürün, film veya şarkı önerilmesine aşinayız; peki bir algoritma neyi sevebileceğimizi nasıl bilir? Vektör gömüleri sayesinde!
Yüksek düzeyde, öneri sistemleri çeşitli öğeleri kullanıcının bilinen tercihlerine göre karşılaştırır. Bu önerileri anlamlı kılmak için hem kullanıcılar hem de öğeler vektör gömülerine dönüştürülür. Bunun için iki yaygın teknik vardır: içerik tabanlı öneriler ve işbirlikçi filtreleme.
Örneğimiz film olsun. İçerik tabanlı önerilerde, filmler çeşitli özelliklerine göre gömülür; kullanıcılar ise geçmişte izledikleri filmlere göre gömülür. Sistem, kullanıcının tercih vektörlerine ya da geçmişte izlediği filmlere en yakın vektörlere sahip yeni filmleri önerebilir.
İşbirlikçi filtrelemede ise çok sayıda kullanıcı dikkate alınır. Yalnızca tek bir kullanıcı ve bir öğeye odaklanmak yerine, işbirlikçi filtreleme sizin vektörlerinize en yakın vektörlere sahip çeşitli kullanıcıları bulur ve onların beğendiği öğeleri veya filmleri önerir.
Sohbet botları ve alma ile zenginleştirilmiş üretim (RAG)
Vektör gömülerinin bir diğer harika kullanım alanı sohbet botları veya RAG’dir.
Alma ile zenginleştirilmiş üretim (RAG), büyük dil modellerinin (LLM) yeteneklerini, haricî ve güncel bilgileri entegre ederek tam anlamıyla kullanmanın bir yoludur; böylece LLM’ler daha doğru yanıtlar üretebilir. Bunun nedeni, LLM’lerin genellikle statik verilerle eğitilmesidir; bu yüzden sınırlı bir bilgi tabanına sahiptirler ve yerel veya kişiselleştirilmiş herhangi bir veriye erişemezler.
Vektör gömüleriyle özel verileri bir vektör veritabanında saklamak mümkündür; bu da herhangi bir projede kullanılabilecek, tamamen özelleştirilebilir, kişiselleştirilmiş bir veri tabanı oluşturmayı sağlar! Veriler vektör gömüleri olarak saklandığından, kullanıcının sorgusuna göre doğrudan veritabanından anlamsal olarak benzer dokümanları almak mümkündür.
RAG’in güzel yanı, soru yanıtlama ve metin üretme gibi çeşitli görevler için mükemmel olmasıdır. Yani kişiselleştirilmiş verilerle eğitilmiş sohbet botları geliştirmek için idealdir!
Bunlar vektör gömülerinin sunduğu olanaklardan yalnızca birkaçıdır.
Bir Vektör Veritabanını Farklı Kılan Nedir?
Vektör veritabanlarının temel özellikleri; vektörleri saklayıp verimli şekilde işleyebilmeleri, çok yüksek boyutlu verilerle mükemmel çalışmaları ve son derece hızlı sorgulama imkânı sunmalarıdır.
Geleneksel ilişkisel bir veritabanında kullanıcılar, tablolar içindeki sütun ve satırlardan oluşan yapılandırılmış verilerle çalışmak zorundadır. Ayrıca yapılandırılmış veritabanları vektör gömülerini yerel olarak depolayıp arayamadığından, ilişkisel veritabanları ve vektörle ilgili süreçlerle başa çıkmak için üçüncü taraf paketler kullanmak gerekir.
Vektör veritabanları bu iş için tasarlanmıştır: Veriler vektör olarak saklanır ve işlenir; bu da daha karmaşık, yapay zeka odaklı uygulamaların kolayca inşa edilebileceği anlamına gelir. Vektör veritabanları performansları, ölçeklenebilirlikleri, esneklikleri ve güvenilirlikleriyle de bilinir. Devasa veri kümelerini işlemek üzere tasarlanmışlardır; yapılandırılmamış ve yarı yapılandırılmış verileri destekleyebilir ve geliştiricilere projeleri üzerinde esneklik tanır.
İşte vektör veritabanları ile geleneksel ilişkisel veritabanları arasındaki farklara daha derin bir bakış:
Boyut
Vektör Veritabanları
Geleneksel İlişkisel Veritabanları
Birincil veri modeli
Verileri yüksek boyutlu vektörler olarak saklar (genellikle yüzlerce–binlerce boyut).
Verileri satır ve türlendirilmiş sütunlardan oluşan tablolarda yapılandırılmış şekilde saklar.
Çekirdek sorgu paradigması
Vektör gömüleri üzerinde benzerlik araması (örn. en yakın komşu).
İyi tanımlanmış sütunlarda tam eşleşme, aralık, toplama ve birleştirme sorguları.
Gömüler için yerel destek
Yerleşik depolama, indeksleme (örn. HNSW, IVF) ve vektör gömülerinin hızlı getirimi.
Yerel vektör türü yok; gömüler için haricî eklentiler veya boru hatları gerekir.
Ölçekte performans
Milyonlardan milyarlara vektör üzerinde saniyenin altında benzerlik araması için optimize edilmiştir.
ACID işlemler ve ilişkisel operasyonlar için optimize edilmiştir; vektör araması yavaştır veya dışa aktarılır.
Veri esnekliği
Vektöre dönüştürüldükten sonra yapılandırılmamış ve yarı yapılandırılmış girdileri (metin, görsel, ses) işler.
En iyi, katı şemalara sahip yapılarda çalışır; yapılandırılmamış veri dönüştürülmeli veya ayrı saklanmalıdır (örn. BLOB’lar).
Ölçeklenebilirlik modeli
Vektör indekslerinin yatay parçalanması/bölümlenmesi; dağıtık çalışmaya uygun tasarım.
Tablolu veriler için olgun dikey ve yatay ölçekleme, ancak yüksek boyutlu vektörlerde indeksler şişer.
Geliştirici iş akışı
Gömüleri depolamak + yapay zeka/anlamsal sorgular çalıştırmak için tek bir sistem; ML/AI uygulamaları için daha basit yığın.
İlişkisel veritabanıyla senkron için ayrı vektör depoları veya kütüphaneler ve ETL yapıştırıcı kod gerekir.
Tipik kullanım alanları
Anlamsal arama, öneri, görsel/ses alma, LLM’ler için RAG, anomali tespiti.
OLTP/OLAP uygulamaları, finansal defterler, envanter, CRM, geleneksel BI analitiği.
Güçlü yönler
Yüksek boyutlu arama hızı, yapay zeka projelerinde sadelik, ölçek, esneklik.
Güçlü tutarlılık (ACID), olgun araç seti, zengin SQL analitiği, karmaşık birleştirmeler.
Takaslar / sınırlar
Karmaşık ilişkisel birleştirmeler ve çok satırlı işlemlerde daha zayıf.
Vektör benzerliği için zayıf yerel destek, yapay zeka ağırlıklı iş yüklerine daha az uygun.
MongoDB ve Vektör Arama = Mükemmel Uyum
Pek çok kişi MongoDB’yi belge tabanlı bir NoSQL veritabanı olarak bilse de, MongoDB Atlas Vector Search sayesinde aslında bir vektör veritabanıdır!
MongoDB’nin NoSQL kökleri göz önüne alındığında, bu veritabanı türüne yeni olanlar Introduction to NoSQL’dan fayda görebilir.
MongoDB’nin bir vektör veritabanı olarak güçlü yanı, vektör gömülerinin esnek belge modeline son derece doğal şekilde uyum sağlamasıdır. MongoDB Atlas Vector Search, geliştiricilerin vektör gömülerini doğrudan herhangi bir koleksiyon içinde saklayıp sorgulamasına olanak tanır. Bu, vektör gömülerinizin kolay başvuru için kaynak verinizin hemen yanında saklandığı anlamına gelir.
Bu format sayesinde geliştiriciler, hibrit arama yapabilir; bu da yalnızca bağlamsal olarak benzer sonuçların değil, eşanlamlı sonuçların da gösterilmesini sağlayan tam metin ve anlamsal aramanın bir kombinasyonudur. Hibrit aramayı, yalnızca istediğiniz başlıktaki kitapları bulmakla kalmayıp benzer hikâyeleri de öneren süper zeki bir kütüphaneci gibi düşünebiliriz!
MongoDB Atlas’ta vektör gömünüzü kaynak verinizin yanında saklamaya bir örnek. Görsel kaynağı.
Bu formatın bir diğer faydası, geliştiricilerin yüksek performanslı ve karmaşık yapay zeka uygulamalarında MongoDB’nin tüm platformundan tam anlamıyla yararlanabilmesidir. Akış işleme, gerçek zamanlı analitik, coğrafi sorgular ve daha fazlası gibi özellikler tek bir uygulamaya kolayca entegre edilebilir.
MongoDB’nin Voyage AI satın alımı, bu sürecin daha da basitleştirilmesine yardımcı olur. Sunulan dünya standartlarındaki gömme modelleri ve yeniden sıralayıcılar, geliştiricilerin verilerini son derece yüksek doğrulukla vektörlere dönüştürmesini, rekabetçi performans elde etmesini ve hızlı çıkarım ile çok dilli desteğe ulaşmasını sağlar.
MongoDB Atlas Vector Search ile nasıl başlayacağımızı inceleyelim.
Kurulum süreci: MongoDB’de vektör arama
MongoDB Atlas Vector Search ile başlamanız için, sizi 15 dakikalık bir kurulumdan geçirecek hızlı başlangıç rehberini takip edin.
Aşağıdakileri nasıl yapacağınızı gösterecek:
Sonuç
Vektör veritabanları, karmaşık yapay zeka uygulamaları geliştirmek için bir gereklilik olduğunu kanıtladı. Bu gelişmiş uygulamalar için gereken vektör gömüleriyle çalışırken geliştirme sürecini kolaylaştırırlar ve MongoDB’nin güzelliği, geliştiricilerin bunlardan faydalanmaya başlamak için tüm yığınlarını yeniden icat etmek zorunda olmamasıdır.
Belge modelinin gücünden yararlanarak MongoDB, geliştiricileri vektör veritabanıyla güçlendirir. Yapılandırılmış alanları, yapılandırılmamış verileri ve yüksek boyutlu gömüleri tek bir yerde birleştirmek mümkündür!
Bazı kilit noktalar:
Bir vektör veritabanının yapay zeka uygulamanıza katacağı gücü gerçekten anlamak için, MongoDB’nin platformu üzerinden bir ücretsiz küme başlatın ve kendiniz deneyin.