Khi trí tuệ nhân tạo len lỏi và tái định hình mọi ngành nghề, sự chú ý thường dồn vào các tính năng và chức năng mới, nhưng phía sau hậu trường là gì? Đằng sau mỗi ứng dụng AI là thứ ít hào nhoáng hơn nhưng vô cùng quan trọng: hạ tầng vận hành nó. Vậy những công cụ nào giúp máy học phát huy hiệu quả?
Trong thế giới vận hành bằng dữ liệu, mọi thứ thực sự bắt đầu từ cách dữ liệu được lưu trữ và quan trọng nhất là cách dữ liệu được tìm kiếm. Đây chính là lúc cơ sở dữ liệu vector phát huy tác dụng.
Giải mã Cơ Sở Dữ Liệu Vector
Vậy chính xác cơ sở dữ liệu vector là gì? Đó là một cơ sở dữ liệu được thiết kế riêng để lưu trữ và tìm kiếm trên các vector embedding, cho phép nhà phát triển tận dụng nhiều chức năng AI như tìm kiếm ngữ nghĩa, nhận diện hình ảnh, chatbot và còn nhiều hơn thế.
Nhưng điều đó có nghĩa là gì? Để hiểu đầy đủ cơ sở dữ liệu vector, hãy lùi lại vài bước. Ta sẽ “giải ảo” những cơ sở dữ liệu cốt lõi này bằng cách bắt đầu từ nền tảng, với nhân vật chính của quy trình: vector embedding.
Vector Embedding là gì?
Vector (trong ngữ cảnh trí tuệ nhân tạo) đơn giản là một danh sách số biểu diễn ý nghĩa ngữ nghĩa của một hình ảnh, câu văn, âm thanh, thậm chí cả video. Dãy số này giúp máy tính hiểu mức độ tương đồng giữa các phần dữ liệu: Chúng “đặt” dữ liệu (như từ ngữ hoặc hình ảnh) thành các điểm trong một “bản đồ toán học” nơi những khái niệm tương tự nằm gần nhau.
Hãy hình dung vector embedding như việc biến một mẩu dữ liệu thành toạ độ GPS — dữ liệu có ý nghĩa tương đồng (như “dog” và “puppy”) sẽ nằm trong cùng “khu phố”!
Vì sao cần biến dữ liệu thành vector? Hãy thử giải thích cho máy sự khác nhau giữa mèo và chó. Con người hiểu điều đó, nhưng máy chỉ hiểu được các con số: không thể giải thích cho máy tính xách tay của bạn sự khác biệt giữa Toto và Garfield.
Bằng cách chuyển dữ liệu thành cấu trúc vector cụ thể, trong đó mỗi con số được sắp xếp độc nhất theo dữ liệu gốc, máy có thể hiểu các mối quan hệ giữa nhiều điểm dữ liệu!
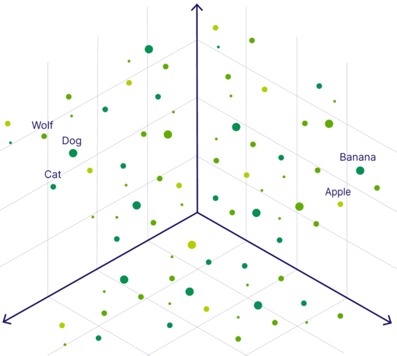
Minh hoạ một vector embedding trong không gian đa chiều. Nguồn ảnh.
Hãy cùng xem điều này khả thi như thế nào qua khái niệm tìm kiếm tương đồng.
Tìm kiếm tương đồng
Tìm kiếm tương đồng là kỹ thuật giúp tìm ra các tài liệu giống nhất với truy vấn gốc của người dùng. Tìm kiếm bằng vector giống như hỏi: “Trong số những bức ảnh này, bức nào trông giống mèo nhất?” thay vì chỉ khớp chính xác từ “mèo”.
Vì làm việc với các vector trong không gian đa chiều, quá trình này có sử dụng một số phép toán để xác định embedding nào giống nhau nhất.
Có rất nhiều thuật toán tìm kiếm tương đồng, nhưng ba loại phổ biến nhất là:
Độ tương đồng cosine
Độ tương đồng cosine đo góc giữa hai vector (không xét đến độ lớn của vector) và thường dùng nhất cho embedding văn bản, tương đồng ngữ nghĩa và hệ thống gợi ý. Nó giúp nhà phát triển so sánh hướng tổng thể của vector, từ đó suy ra nội dung tổng thể của tài liệu — lý do quan trọng với các chủ đề kể trên.
Khoảng cách Euclid
Khoảng cách Euclid đo khoảng cách đường thẳng giữa hai vector trong không gian. Hình dung đơn giản là đo đường đi ngắn nhất giữa hai điểm trên bản đồ!
Đây là khoảng cách trực quan nhất: nếu khoảng cách rất nhỏ, nghĩa là toạ độ của các vector rất gần nhau, hay rất giống nhau.
Vì thước đo này rất nhạy với độ lớn, nó hữu ích nhất khi embedding liên quan đến giá trị số. Đặc biệt phù hợp cho công cụ gợi ý, giúp người dùng biết nên đặt gì tiếp theo dựa trên số lần mua hàng trước đó.
Độ tương đồng tích vô hướng (dot product)
Độ tương đồng tích vô hướng đo không chỉ tích độ lớn vector mà còn cả cosine của góc giữa chúng. Nghĩa là dot product quan tâm cả độ dài (độ lớn) lẫn hướng của vector!
Khi các vector được chuẩn hoá (độ lớn bằng 1 nhưng hướng giữ nguyên), độ tương đồng dot product trở nên tương đương độ tương đồng cosine do không còn xét độ lớn nữa.
Độ tương đồng dot product thường được dùng trong các lĩnh vực như xử lý ngôn ngữ tự nhiên (NLP) và thị giác máy tính.
Vì Sao Vector Hữu Ích Trong Ứng Dụng AI?
Giờ bạn đã có dữ liệu thô được biểu diễn dưới dạng vector embedding. Hãy cùng khám phá những khả năng tuyệt vời mở ra khi dữ liệu được biểu diễn bằng các embedding này.
Tìm kiếm ngữ nghĩa
Tìm kiếm ngữ nghĩa là cách tìm kiếm dựa trên ý nghĩa thực sự của truy vấn người dùng, không chỉ khớp chính xác. Nghĩa là thay vì dựa trên từ khóa cụ thể, kết quả vẫn hiện ra dù từ bị viết sai, và dựa trên các từ đồng nghĩa với truy vấn gốc.
Ví dụ, nếu người dùng tìm “best cafes near me”, với tìm kiếm chính xác chỉ những nơi gắn nhãn “cafes” mới xuất hiện, trong khi công cụ tìm kiếm ngữ nghĩa sẽ hiểu và hiển thị những nơi có “tea”, “coffee”, “pastries” hoặc các kết quả gợi ra từ hiểu biết ngữ cảnh sâu hơn.
Vậy tìm kiếm này khả thi nhờ đâu? Vector embedding! Giả sử chúng ta embed truy vấn của người dùng và dữ liệu (như mô tả địa điểm). Khi đó có thể so sánh chúng trong không gian đa chiều, tìm các vector gần nhau nhất bằng các phương pháp như tìm kiếm tương đồng.
Chẳng hạn, với truy vấn “best cafes near me” và cơ sở dữ liệu gồm mô tả địa điểm lấy từ Google Maps đã được embed, tìm kiếm ngữ nghĩa sẽ trả về những nơi có embedding giống truy vấn ban đầu nhất — ngay cả khi từ “cafe” không hề xuất hiện trong các mô tả đó!
Hệ thống gợi ý
Hệ thống gợi ý sử dụng dữ liệu để giúp mọi người tìm ra thứ họ có khả năng thích nhất về mặt thống kê, dựa trên mua hàng trước đó, lịch sử tìm kiếm, thông tin môi trường và nhân khẩu học, v.v. Chúng được dùng trong hầu hết các ngành, từ giải trí đến tài chính.
Những nền tảng rõ ràng sử dụng hệ thống gợi ý là Spotify, Netflix và Amazon, nhưng chúng xuất hiện ở mọi ngành, nhất là khi ngày càng nhiều công ty áp dụng chính sách AI.
Các hệ thống này được huấn luyện để hiểu đặc điểm, quyết định trước đây và sở thích của người dùng dựa trên hàng loạt tương tác, gồm nhấp chuột, thích và lượt xem. Chúng ta đều quen với việc được gợi ý sản phẩm, phim hoặc bài hát mới dựa trên các lựa chọn trước đó — vậy thuật toán biết ta có thể thích gì bằng cách nào? Nhờ vector embedding!
Ở mức độ khái quát, hệ thống gợi ý so sánh các mục với sở thích đã biết của người dùng. Để gợi ý có ý nghĩa, cả người dùng và các mục đều được chuyển thành vector embedding. Có hai kỹ thuật phổ biến: gợi ý dựa trên nội dung và lọc cộng tác.
Lấy phim làm ví dụ. Với gợi ý dựa trên nội dung, phim được embed dựa trên các đặc trưng; người dùng được embed dựa trên các phim đã xem trước đây. Hệ thống có thể gợi ý các phim mới có vector gần với vector sở thích của người dùng, hoặc các phim họ đã xem.
Với lọc cộng tác, nhiều người dùng được xét đến. Thay vì chỉ tập trung vào một người dùng và một mục, lọc cộng tác tìm những người dùng có vector gần với bạn và gợi ý các mục hoặc phim họ đã thích.
Chatbot và RAG (retrieval-augmented generation)
Một ứng dụng tuyệt vời khác của vector embedding là với chatbot hoặc RAG.
Retrieval-augmented generation là một cách để tận dụng trọn vẹn khả năng của các mô hình ngôn ngữ lớn (LLM) bằng cách tích hợp thông tin bên ngoài, cập nhật, giúp LLM tạo câu trả lời chính xác hơn. Do LLM thường được huấn luyện trên dữ liệu tĩnh nên có phạm vi kiến thức hạn chế và không thể truy cập dữ liệu cục bộ hay cá nhân hoá.
Với vector embedding, có thể lưu dữ liệu tuỳ chỉnh trong cơ sở dữ liệu vector, cho phép tạo một cơ sở dữ liệu cá nhân hoá, tuỳ biến hoàn toàn để dùng trong bất kỳ dự án nào! Vì dữ liệu được lưu dưới dạng embedding, có thể truy xuất các tài liệu tương đồng ngữ nghĩa trực tiếp từ cơ sở dữ liệu dựa trên truy vấn của người dùng.
Điểm hay của RAG là phù hợp với nhiều tác vụ như trả lời câu hỏi và tạo văn bản. Tức là rất lý tưởng để xây dựng chatbot được huấn luyện trên dữ liệu cá nhân hoá!
Đó chỉ là vài khả năng tiêu biểu nhờ vector embedding.
Điều Gì Khiến Cơ Sở Dữ Liệu Vector Khác Biệt?
Thuộc tính cốt lõi của cơ sở dữ liệu vector dĩ nhiên là khả năng lưu trữ và xử lý hiệu quả vector, làm việc xuất sắc với dữ liệu có số chiều rất lớn và cho phép truy vấn cực nhanh.
Với cơ sở dữ liệu quan hệ truyền thống, người dùng buộc phải xử lý dữ liệu có cấu trúc, vì cơ sở dữ liệu quan hệ quản lý cột và hàng trong bảng. Người dùng cũng phải dùng gói bên thứ ba để xử lý các quy trình liên quan tới vector, do cơ sở dữ liệu có cấu trúc không thể lưu trữ hay tìm kiếm embedding một cách nguyên bản.
Cơ sở dữ liệu vector được thiết kế cho kiểu công việc này: Dữ liệu được lưu và xử lý dưới dạng vector, nghĩa là các ứng dụng phức tạp, tập trung vào AI có thể được xây dựng một cách đơn giản. Chúng cũng nổi tiếng về hiệu năng, khả năng mở rộng, linh hoạt và độ tin cậy. Chúng được thiết kế để xử lý bộ dữ liệu khổng lồ, hỗ trợ dữ liệu phi cấu trúc và bán cấu trúc, và cho phép nhà phát triển linh hoạt trong dự án.
Dưới đây là cái nhìn sâu hơn về sự khác biệt giữa cơ sở dữ liệu vector và cơ sở dữ liệu quan hệ truyền thống:
|
Khía cạnh
|
Cơ sở dữ liệu vector
|
Cơ sở dữ liệu quan hệ truyền thống
|
|
Mô hình dữ liệu chính
|
Lưu dữ liệu dưới dạng các vector có số chiều lớn (thường hàng trăm–hàng nghìn chiều).
|
Lưu dữ liệu có cấu trúc trong các bảng gồm hàng & cột kiểu hoá.
|
|
Mô hình truy vấn lõi
|
Tìm kiếm tương đồng (ví dụ: láng giềng gần nhất) trên các embedding.
|
Khớp chính xác, khoảng, tổng hợp và join trên các cột được xác định rõ.
|
|
Hỗ trợ embedding nguyên bản
|
Tích hợp lưu trữ, lập chỉ mục (ví dụ: HNSW, IVF) và truy xuất embedding nhanh.
|
Không có kiểu vector nguyên bản; cần tiện ích mở rộng hoặc pipeline bên ngoài để xử lý embedding.
|
|
Hiệu năng ở quy mô lớn
|
Tối ưu cho tìm kiếm tương đồng dưới 1 giây trên hàng triệu đến hàng tỷ vector.
|
Tối ưu cho giao dịch ACID và thao tác quan hệ; tìm kiếm vector chậm hoặc phải tách riêng.
|
|
Tính linh hoạt dữ liệu
|
Xử lý dữ liệu phi cấu trúc & bán cấu trúc (văn bản, hình ảnh, âm thanh) sau khi chuyển thành vector.
|
Phù hợp nhất với schema chặt chẽ; dữ liệu phi cấu trúc phải được chuyển đổi hoặc lưu riêng (ví dụ: BLOB).
|
|
Mô hình mở rộng
|
Phân mảnh/phân vùng ngang các chỉ mục vector; thiết kế cho vận hành phân tán.
|
Mô hình mở rộng dọc & ngang trưởng thành cho dữ liệu dạng bảng, nhưng chỉ mục phình to với vector nhiều chiều.
|
|
Quy trình làm việc của nhà phát triển
|
Một hệ thống để lưu embedding + chạy truy vấn AI/ngữ nghĩa; đơn giản hoá stack cho ứng dụng ML/AI.
|
Cần kho vector hoặc thư viện riêng, cùng mã ETL để đồng bộ với CSDL quan hệ.
|
|
Trường hợp sử dụng điển hình
|
Tìm kiếm ngữ nghĩa, gợi ý, truy xuất hình/âm thanh, RAG cho LLM, phát hiện bất thường.
|
Ứng dụng OLTP/OLAP, sổ cái tài chính, tồn kho, CRM, phân tích BI truyền thống.
|
|
Thế mạnh
|
Tốc độ tìm kiếm nhiều chiều, đơn giản hoá dự án AI, khả năng mở rộng, linh hoạt.
|
Tính nhất quán mạnh (ACID), công cụ trưởng thành, phân tích SQL phong phú, join phức tạp.
|
|
Đánh đổi / giới hạn
|
Yếu hơn ở join quan hệ phức tạp & giao dịch nhiều hàng.
|
Hỗ trợ nguyên bản kém cho tương đồng vector, ít phù hợp với tải AI nặng.
|
MongoDB và Tìm Kiếm Vector = Cặp Đôi Hoàn Hảo
Nhiều người biết MongoDB là cơ sở dữ liệu NoSQL dạng tài liệu, nhưng không nhiều người biết rằng thực ra nó là một cơ sở dữ liệu vector nhờ MongoDB Atlas Vector Search!
Xét đến nguồn gốc NoSQL của MongoDB, những ai mới với loại cơ sở dữ liệu này có thể hưởng lợi từ Introduction to NoSQL.
Điểm mạnh của MongoDB với vai trò cơ sở dữ liệu vector là embedding phù hợp một cách tự nhiên với mô hình tài liệu linh hoạt của nó. MongoDB Atlas Vector Search cho phép nhà phát triển lưu trữ và truy vấn embedding trực tiếp trong bất kỳ collection nào. Tức là embedding của bạn được lưu ngay cạnh dữ liệu nguồn để tiện tham chiếu.
Nhờ định dạng này, nhà phát triển có thể thực hiện tìm kiếm lai, kết hợp giữa tìm kiếm toàn văn và ngữ nghĩa để bảo đảm hiển thị không chỉ kết quả tương đồng theo ngữ cảnh mà cả các kết quả đồng nghĩa. Hãy hình dung tìm kiếm lai như một thủ thư siêu thông minh: không chỉ tìm đúng cuốn bạn yêu cầu mà còn gợi ý những cuốn có câu chuyện tương tự!
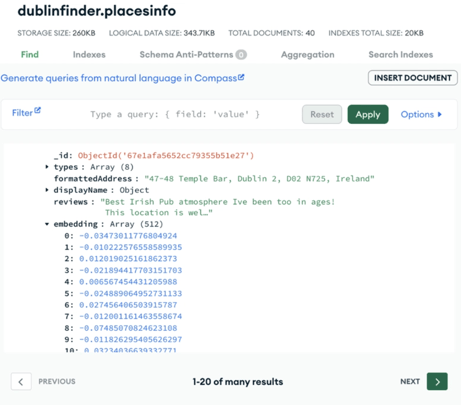
Ví dụ lưu trữ vector embedding cạnh dữ liệu nguồn trong MongoDB Atlas. Nguồn ảnh.
Một lợi ích khác của định dạng này là nhà phát triển có thể tận dụng toàn bộ nền tảng MongoDB trong các ứng dụng AI phức tạp, hiệu năng cao. Các tính năng như xử lý dòng dữ liệu, phân tích thời gian thực, truy vấn không gian địa lý, v.v. đều có thể tích hợp dễ dàng vào một ứng dụng duy nhất.
Thương vụ MongoDB mới thâu tóm Voyage AI giúp quy trình này còn đơn giản hơn. Các mô hình embedding và reranker đẳng cấp thế giới cho phép dữ liệu được chuyển thành vector có độ chính xác cực cao, cạnh tranh trên thị trường, cho suy luận nhanh và hỗ trợ đa ngôn ngữ.
Hãy cùng điểm qua cách bắt đầu với MongoDB Atlas Vector Search.
Quy trình thiết lập: tìm kiếm vector trong MongoDB
Để bắt đầu với MongoDB Atlas Vector Search, vui lòng làm theo hướng dẫn nhanh sẽ đưa bạn qua quy trình thiết lập trong 15 phút.
Hướng dẫn sẽ chỉ bạn cách:
- Tạo một cụm (cluster) Atlas.
- Nạp các tài liệu mẫu đã có sẵn embedding.
- Tạo chỉ mục MongoDB Atlas Vector Search trên các embedding đó.
- Và cuối cùng, thực hiện tìm kiếm ngữ nghĩa để trả về các tài liệu gần nhất với truy vấn ban đầu.
Kết luận
Cơ sở dữ liệu vector đã chứng tỏ là cần thiết để xây dựng ứng dụng AI phức tạp. Chúng giúp đơn giản hoá quá trình phát triển khi làm việc với embedding vốn là yêu cầu cho các ứng dụng tiên tiến này, và điểm tuyệt vời với MongoDB là nhà phát triển không cần “xây lại” toàn bộ stack để bắt đầu hưởng lợi.
Bằng cách tận dụng sức mạnh của mô hình tài liệu, MongoDB trao quyền cho nhà phát triển với cơ sở dữ liệu vector của mình. Có thể kết hợp trường dữ liệu có cấu trúc, dữ liệu phi cấu trúc và embedding nhiều chiều trong một nơi duy nhất!
Một số điểm chính:
- Cơ sở dữ liệu vector lưu dữ liệu dưới dạng danh sách số (vector) để giúp tìm dữ liệu tương tự một cách nhanh chóng.
- Embedding biến mọi loại dữ liệu thành con số để AI hiểu tốt hơn.
- Tìm kiếm tương đồng giúp tìm “kết quả gần nhất” (như gợi ý phim tương tự).
- MongoDB giúp mọi thứ trở nên cực kỳ dễ dàng bằng cách lưu vector ngay cạnh dữ liệu thông thường của bạn!
Để thực sự hiểu sức mạnh mà cơ sở dữ liệu vector mang lại cho ứng dụng AI của bạn, khởi tạo một cụm miễn phí trên nền tảng của MongoDB và tự mình trải nghiệm.


Khi trí tuệ nhân tạo len lỏi và tái định hình mọi ngành nghề, sự chú ý thường dồn vào các tính năng và chức năng mới, nhưng phía sau hậu trường là gì? Đằng sau mỗi ứng dụng AI là thứ ít hào nhoáng hơn nhưng vô cùng quan trọng: hạ tầng vận hành nó. Vậy những công cụ nào giúp máy học phát huy hiệu quả?
Trong thế giới vận hành bằng dữ liệu, mọi thứ thực sự bắt đầu từ cách dữ liệu được lưu trữ và quan trọng nhất là cách dữ liệu được tìm kiếm. Đây chính là lúc cơ sở dữ liệu vector phát huy tác dụng.
Giải mã Cơ Sở Dữ Liệu Vector
Vậy chính xác cơ sở dữ liệu vector là gì? Đó là một cơ sở dữ liệu được thiết kế riêng để lưu trữ và tìm kiếm trên các vector embedding, cho phép nhà phát triển tận dụng nhiều chức năng AI như tìm kiếm ngữ nghĩa, nhận diện hình ảnh, chatbot và còn nhiều hơn thế.
Nhưng điều đó có nghĩa là gì? Để hiểu đầy đủ cơ sở dữ liệu vector, hãy lùi lại vài bước. Ta sẽ “giải ảo” những cơ sở dữ liệu cốt lõi này bằng cách bắt đầu từ nền tảng, với nhân vật chính của quy trình: vector embedding.
Vector Embedding là gì?
Vector (trong ngữ cảnh trí tuệ nhân tạo) đơn giản là một danh sách số biểu diễn ý nghĩa ngữ nghĩa của một hình ảnh, câu văn, âm thanh, thậm chí cả video. Dãy số này giúp máy tính hiểu mức độ tương đồng giữa các phần dữ liệu: Chúng “đặt” dữ liệu (như từ ngữ hoặc hình ảnh) thành các điểm trong một “bản đồ toán học” nơi những khái niệm tương tự nằm gần nhau.
Hãy hình dung vector embedding như việc biến một mẩu dữ liệu thành toạ độ GPS — dữ liệu có ý nghĩa tương đồng (như “dog” và “puppy”) sẽ nằm trong cùng “khu phố”!
Vì sao cần biến dữ liệu thành vector? Hãy thử giải thích cho máy sự khác nhau giữa mèo và chó. Con người hiểu điều đó, nhưng máy chỉ hiểu được các con số: không thể giải thích cho máy tính xách tay của bạn sự khác biệt giữa Toto và Garfield.
Bằng cách chuyển dữ liệu thành cấu trúc vector cụ thể, trong đó mỗi con số được sắp xếp độc nhất theo dữ liệu gốc, máy có thể hiểu các mối quan hệ giữa nhiều điểm dữ liệu!
Minh hoạ một vector embedding trong không gian đa chiều. Nguồn ảnh.
Hãy cùng xem điều này khả thi như thế nào qua khái niệm tìm kiếm tương đồng.
Tìm kiếm tương đồng
Tìm kiếm tương đồng là kỹ thuật giúp tìm ra các tài liệu giống nhất với truy vấn gốc của người dùng. Tìm kiếm bằng vector giống như hỏi: “Trong số những bức ảnh này, bức nào trông giống mèo nhất?” thay vì chỉ khớp chính xác từ “mèo”.
Vì làm việc với các vector trong không gian đa chiều, quá trình này có sử dụng một số phép toán để xác định embedding nào giống nhau nhất.
Có rất nhiều thuật toán tìm kiếm tương đồng, nhưng ba loại phổ biến nhất là:
Độ tương đồng cosine
Độ tương đồng cosine đo góc giữa hai vector (không xét đến độ lớn của vector) và thường dùng nhất cho embedding văn bản, tương đồng ngữ nghĩa và hệ thống gợi ý. Nó giúp nhà phát triển so sánh hướng tổng thể của vector, từ đó suy ra nội dung tổng thể của tài liệu — lý do quan trọng với các chủ đề kể trên.
Khoảng cách Euclid
Khoảng cách Euclid đo khoảng cách đường thẳng giữa hai vector trong không gian. Hình dung đơn giản là đo đường đi ngắn nhất giữa hai điểm trên bản đồ!
Đây là khoảng cách trực quan nhất: nếu khoảng cách rất nhỏ, nghĩa là toạ độ của các vector rất gần nhau, hay rất giống nhau.
Vì thước đo này rất nhạy với độ lớn, nó hữu ích nhất khi embedding liên quan đến giá trị số. Đặc biệt phù hợp cho công cụ gợi ý, giúp người dùng biết nên đặt gì tiếp theo dựa trên số lần mua hàng trước đó.
Độ tương đồng tích vô hướng (dot product)
Độ tương đồng tích vô hướng đo không chỉ tích độ lớn vector mà còn cả cosine của góc giữa chúng. Nghĩa là dot product quan tâm cả độ dài (độ lớn) lẫn hướng của vector!
Khi các vector được chuẩn hoá (độ lớn bằng 1 nhưng hướng giữ nguyên), độ tương đồng dot product trở nên tương đương độ tương đồng cosine do không còn xét độ lớn nữa.
Độ tương đồng dot product thường được dùng trong các lĩnh vực như xử lý ngôn ngữ tự nhiên (NLP) và thị giác máy tính.
Vì Sao Vector Hữu Ích Trong Ứng Dụng AI?
Giờ bạn đã có dữ liệu thô được biểu diễn dưới dạng vector embedding. Hãy cùng khám phá những khả năng tuyệt vời mở ra khi dữ liệu được biểu diễn bằng các embedding này.
Tìm kiếm ngữ nghĩa
Tìm kiếm ngữ nghĩa là cách tìm kiếm dựa trên ý nghĩa thực sự của truy vấn người dùng, không chỉ khớp chính xác. Nghĩa là thay vì dựa trên từ khóa cụ thể, kết quả vẫn hiện ra dù từ bị viết sai, và dựa trên các từ đồng nghĩa với truy vấn gốc.
Ví dụ, nếu người dùng tìm “best cafes near me”, với tìm kiếm chính xác chỉ những nơi gắn nhãn “cafes” mới xuất hiện, trong khi công cụ tìm kiếm ngữ nghĩa sẽ hiểu và hiển thị những nơi có “tea”, “coffee”, “pastries” hoặc các kết quả gợi ra từ hiểu biết ngữ cảnh sâu hơn.
Vậy tìm kiếm này khả thi nhờ đâu? Vector embedding! Giả sử chúng ta embed truy vấn của người dùng và dữ liệu (như mô tả địa điểm). Khi đó có thể so sánh chúng trong không gian đa chiều, tìm các vector gần nhau nhất bằng các phương pháp như tìm kiếm tương đồng.
Chẳng hạn, với truy vấn “best cafes near me” và cơ sở dữ liệu gồm mô tả địa điểm lấy từ Google Maps đã được embed, tìm kiếm ngữ nghĩa sẽ trả về những nơi có embedding giống truy vấn ban đầu nhất — ngay cả khi từ “cafe” không hề xuất hiện trong các mô tả đó!
Hệ thống gợi ý
Hệ thống gợi ý sử dụng dữ liệu để giúp mọi người tìm ra thứ họ có khả năng thích nhất về mặt thống kê, dựa trên mua hàng trước đó, lịch sử tìm kiếm, thông tin môi trường và nhân khẩu học, v.v. Chúng được dùng trong hầu hết các ngành, từ giải trí đến tài chính.
Những nền tảng rõ ràng sử dụng hệ thống gợi ý là Spotify, Netflix và Amazon, nhưng chúng xuất hiện ở mọi ngành, nhất là khi ngày càng nhiều công ty áp dụng chính sách AI.
Các hệ thống này được huấn luyện để hiểu đặc điểm, quyết định trước đây và sở thích của người dùng dựa trên hàng loạt tương tác, gồm nhấp chuột, thích và lượt xem. Chúng ta đều quen với việc được gợi ý sản phẩm, phim hoặc bài hát mới dựa trên các lựa chọn trước đó — vậy thuật toán biết ta có thể thích gì bằng cách nào? Nhờ vector embedding!
Ở mức độ khái quát, hệ thống gợi ý so sánh các mục với sở thích đã biết của người dùng. Để gợi ý có ý nghĩa, cả người dùng và các mục đều được chuyển thành vector embedding. Có hai kỹ thuật phổ biến: gợi ý dựa trên nội dung và lọc cộng tác.
Lấy phim làm ví dụ. Với gợi ý dựa trên nội dung, phim được embed dựa trên các đặc trưng; người dùng được embed dựa trên các phim đã xem trước đây. Hệ thống có thể gợi ý các phim mới có vector gần với vector sở thích của người dùng, hoặc các phim họ đã xem.
Với lọc cộng tác, nhiều người dùng được xét đến. Thay vì chỉ tập trung vào một người dùng và một mục, lọc cộng tác tìm những người dùng có vector gần với bạn và gợi ý các mục hoặc phim họ đã thích.
Chatbot và RAG (retrieval-augmented generation)
Một ứng dụng tuyệt vời khác của vector embedding là với chatbot hoặc RAG.
Retrieval-augmented generation là một cách để tận dụng trọn vẹn khả năng của các mô hình ngôn ngữ lớn (LLM) bằng cách tích hợp thông tin bên ngoài, cập nhật, giúp LLM tạo câu trả lời chính xác hơn. Do LLM thường được huấn luyện trên dữ liệu tĩnh nên có phạm vi kiến thức hạn chế và không thể truy cập dữ liệu cục bộ hay cá nhân hoá.
Với vector embedding, có thể lưu dữ liệu tuỳ chỉnh trong cơ sở dữ liệu vector, cho phép tạo một cơ sở dữ liệu cá nhân hoá, tuỳ biến hoàn toàn để dùng trong bất kỳ dự án nào! Vì dữ liệu được lưu dưới dạng embedding, có thể truy xuất các tài liệu tương đồng ngữ nghĩa trực tiếp từ cơ sở dữ liệu dựa trên truy vấn của người dùng.
Điểm hay của RAG là phù hợp với nhiều tác vụ như trả lời câu hỏi và tạo văn bản. Tức là rất lý tưởng để xây dựng chatbot được huấn luyện trên dữ liệu cá nhân hoá!
Đó chỉ là vài khả năng tiêu biểu nhờ vector embedding.
Điều Gì Khiến Cơ Sở Dữ Liệu Vector Khác Biệt?
Thuộc tính cốt lõi của cơ sở dữ liệu vector dĩ nhiên là khả năng lưu trữ và xử lý hiệu quả vector, làm việc xuất sắc với dữ liệu có số chiều rất lớn và cho phép truy vấn cực nhanh.
Với cơ sở dữ liệu quan hệ truyền thống, người dùng buộc phải xử lý dữ liệu có cấu trúc, vì cơ sở dữ liệu quan hệ quản lý cột và hàng trong bảng. Người dùng cũng phải dùng gói bên thứ ba để xử lý các quy trình liên quan tới vector, do cơ sở dữ liệu có cấu trúc không thể lưu trữ hay tìm kiếm embedding một cách nguyên bản.
Cơ sở dữ liệu vector được thiết kế cho kiểu công việc này: Dữ liệu được lưu và xử lý dưới dạng vector, nghĩa là các ứng dụng phức tạp, tập trung vào AI có thể được xây dựng một cách đơn giản. Chúng cũng nổi tiếng về hiệu năng, khả năng mở rộng, linh hoạt và độ tin cậy. Chúng được thiết kế để xử lý bộ dữ liệu khổng lồ, hỗ trợ dữ liệu phi cấu trúc và bán cấu trúc, và cho phép nhà phát triển linh hoạt trong dự án.
Dưới đây là cái nhìn sâu hơn về sự khác biệt giữa cơ sở dữ liệu vector và cơ sở dữ liệu quan hệ truyền thống:
Khía cạnh
Cơ sở dữ liệu vector
Cơ sở dữ liệu quan hệ truyền thống
Mô hình dữ liệu chính
Lưu dữ liệu dưới dạng các vector có số chiều lớn (thường hàng trăm–hàng nghìn chiều).
Lưu dữ liệu có cấu trúc trong các bảng gồm hàng & cột kiểu hoá.
Mô hình truy vấn lõi
Tìm kiếm tương đồng (ví dụ: láng giềng gần nhất) trên các embedding.
Khớp chính xác, khoảng, tổng hợp và join trên các cột được xác định rõ.
Hỗ trợ embedding nguyên bản
Tích hợp lưu trữ, lập chỉ mục (ví dụ: HNSW, IVF) và truy xuất embedding nhanh.
Không có kiểu vector nguyên bản; cần tiện ích mở rộng hoặc pipeline bên ngoài để xử lý embedding.
Hiệu năng ở quy mô lớn
Tối ưu cho tìm kiếm tương đồng dưới 1 giây trên hàng triệu đến hàng tỷ vector.
Tối ưu cho giao dịch ACID và thao tác quan hệ; tìm kiếm vector chậm hoặc phải tách riêng.
Tính linh hoạt dữ liệu
Xử lý dữ liệu phi cấu trúc & bán cấu trúc (văn bản, hình ảnh, âm thanh) sau khi chuyển thành vector.
Phù hợp nhất với schema chặt chẽ; dữ liệu phi cấu trúc phải được chuyển đổi hoặc lưu riêng (ví dụ: BLOB).
Mô hình mở rộng
Phân mảnh/phân vùng ngang các chỉ mục vector; thiết kế cho vận hành phân tán.
Mô hình mở rộng dọc & ngang trưởng thành cho dữ liệu dạng bảng, nhưng chỉ mục phình to với vector nhiều chiều.
Quy trình làm việc của nhà phát triển
Một hệ thống để lưu embedding + chạy truy vấn AI/ngữ nghĩa; đơn giản hoá stack cho ứng dụng ML/AI.
Cần kho vector hoặc thư viện riêng, cùng mã ETL để đồng bộ với CSDL quan hệ.
Trường hợp sử dụng điển hình
Tìm kiếm ngữ nghĩa, gợi ý, truy xuất hình/âm thanh, RAG cho LLM, phát hiện bất thường.
Ứng dụng OLTP/OLAP, sổ cái tài chính, tồn kho, CRM, phân tích BI truyền thống.
Thế mạnh
Tốc độ tìm kiếm nhiều chiều, đơn giản hoá dự án AI, khả năng mở rộng, linh hoạt.
Tính nhất quán mạnh (ACID), công cụ trưởng thành, phân tích SQL phong phú, join phức tạp.
Đánh đổi / giới hạn
Yếu hơn ở join quan hệ phức tạp & giao dịch nhiều hàng.
Hỗ trợ nguyên bản kém cho tương đồng vector, ít phù hợp với tải AI nặng.
MongoDB và Tìm Kiếm Vector = Cặp Đôi Hoàn Hảo
Nhiều người biết MongoDB là cơ sở dữ liệu NoSQL dạng tài liệu, nhưng không nhiều người biết rằng thực ra nó là một cơ sở dữ liệu vector nhờ MongoDB Atlas Vector Search!
Xét đến nguồn gốc NoSQL của MongoDB, những ai mới với loại cơ sở dữ liệu này có thể hưởng lợi từ Introduction to NoSQL.
Điểm mạnh của MongoDB với vai trò cơ sở dữ liệu vector là embedding phù hợp một cách tự nhiên với mô hình tài liệu linh hoạt của nó. MongoDB Atlas Vector Search cho phép nhà phát triển lưu trữ và truy vấn embedding trực tiếp trong bất kỳ collection nào. Tức là embedding của bạn được lưu ngay cạnh dữ liệu nguồn để tiện tham chiếu.
Nhờ định dạng này, nhà phát triển có thể thực hiện tìm kiếm lai, kết hợp giữa tìm kiếm toàn văn và ngữ nghĩa để bảo đảm hiển thị không chỉ kết quả tương đồng theo ngữ cảnh mà cả các kết quả đồng nghĩa. Hãy hình dung tìm kiếm lai như một thủ thư siêu thông minh: không chỉ tìm đúng cuốn bạn yêu cầu mà còn gợi ý những cuốn có câu chuyện tương tự!
Ví dụ lưu trữ vector embedding cạnh dữ liệu nguồn trong MongoDB Atlas. Nguồn ảnh.
Một lợi ích khác của định dạng này là nhà phát triển có thể tận dụng toàn bộ nền tảng MongoDB trong các ứng dụng AI phức tạp, hiệu năng cao. Các tính năng như xử lý dòng dữ liệu, phân tích thời gian thực, truy vấn không gian địa lý, v.v. đều có thể tích hợp dễ dàng vào một ứng dụng duy nhất.
Thương vụ MongoDB mới thâu tóm Voyage AI giúp quy trình này còn đơn giản hơn. Các mô hình embedding và reranker đẳng cấp thế giới cho phép dữ liệu được chuyển thành vector có độ chính xác cực cao, cạnh tranh trên thị trường, cho suy luận nhanh và hỗ trợ đa ngôn ngữ.
Hãy cùng điểm qua cách bắt đầu với MongoDB Atlas Vector Search.
Quy trình thiết lập: tìm kiếm vector trong MongoDB
Để bắt đầu với MongoDB Atlas Vector Search, vui lòng làm theo hướng dẫn nhanh sẽ đưa bạn qua quy trình thiết lập trong 15 phút.
Hướng dẫn sẽ chỉ bạn cách:
Kết luận
Cơ sở dữ liệu vector đã chứng tỏ là cần thiết để xây dựng ứng dụng AI phức tạp. Chúng giúp đơn giản hoá quá trình phát triển khi làm việc với embedding vốn là yêu cầu cho các ứng dụng tiên tiến này, và điểm tuyệt vời với MongoDB là nhà phát triển không cần “xây lại” toàn bộ stack để bắt đầu hưởng lợi.
Bằng cách tận dụng sức mạnh của mô hình tài liệu, MongoDB trao quyền cho nhà phát triển với cơ sở dữ liệu vector của mình. Có thể kết hợp trường dữ liệu có cấu trúc, dữ liệu phi cấu trúc và embedding nhiều chiều trong một nơi duy nhất!
Một số điểm chính:
Để thực sự hiểu sức mạnh mà cơ sở dữ liệu vector mang lại cho ứng dụng AI của bạn, khởi tạo một cụm miễn phí trên nền tảng của MongoDB và tự mình trải nghiệm.