课程
面向开发者的 AI 辅助编码
1 小时 30 分钟
11.5K
实践并学习路径你的进步。
使用 Google 继续到 2026 年末,前沿模型之争更多是在价格层面的“军备竞赛”,而非纯粹能力。仅在 9 月,我们就看到 OpenAI 的 GPT-6 Astra 和 Anthropic 的 Claude Fable 5.1 均定价为每百万输入标记 $10、每百万输出标记 $50,且都没有免费层可用。
DeepSeek 的应对策略则完全反其道而行。
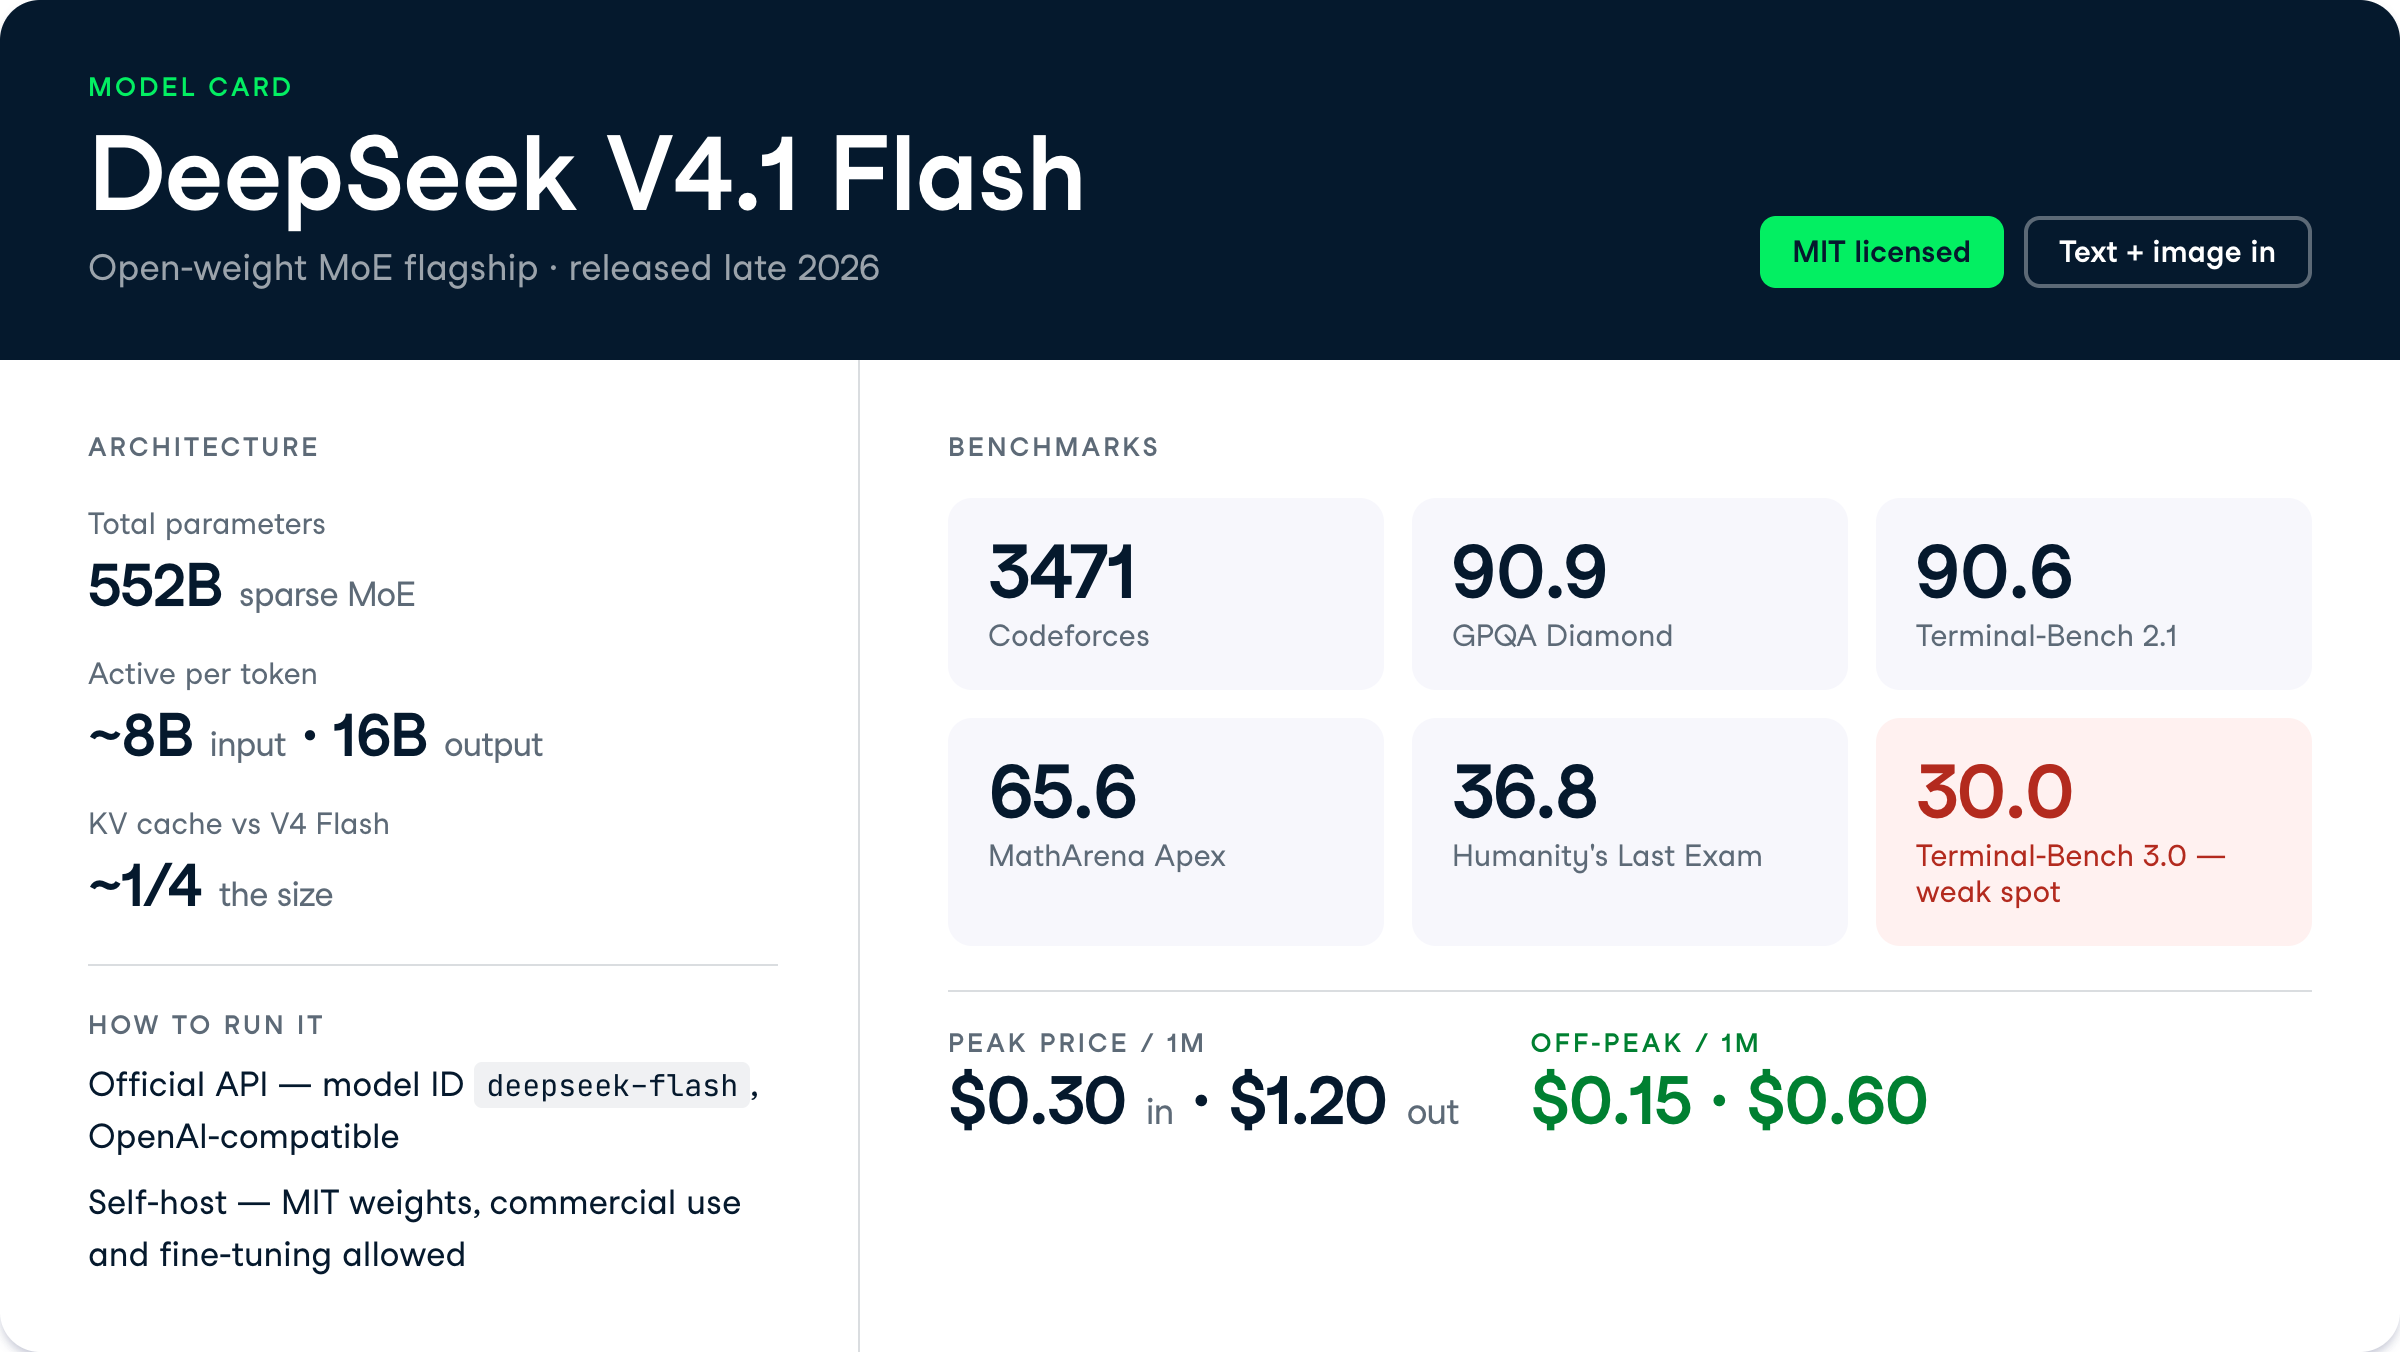
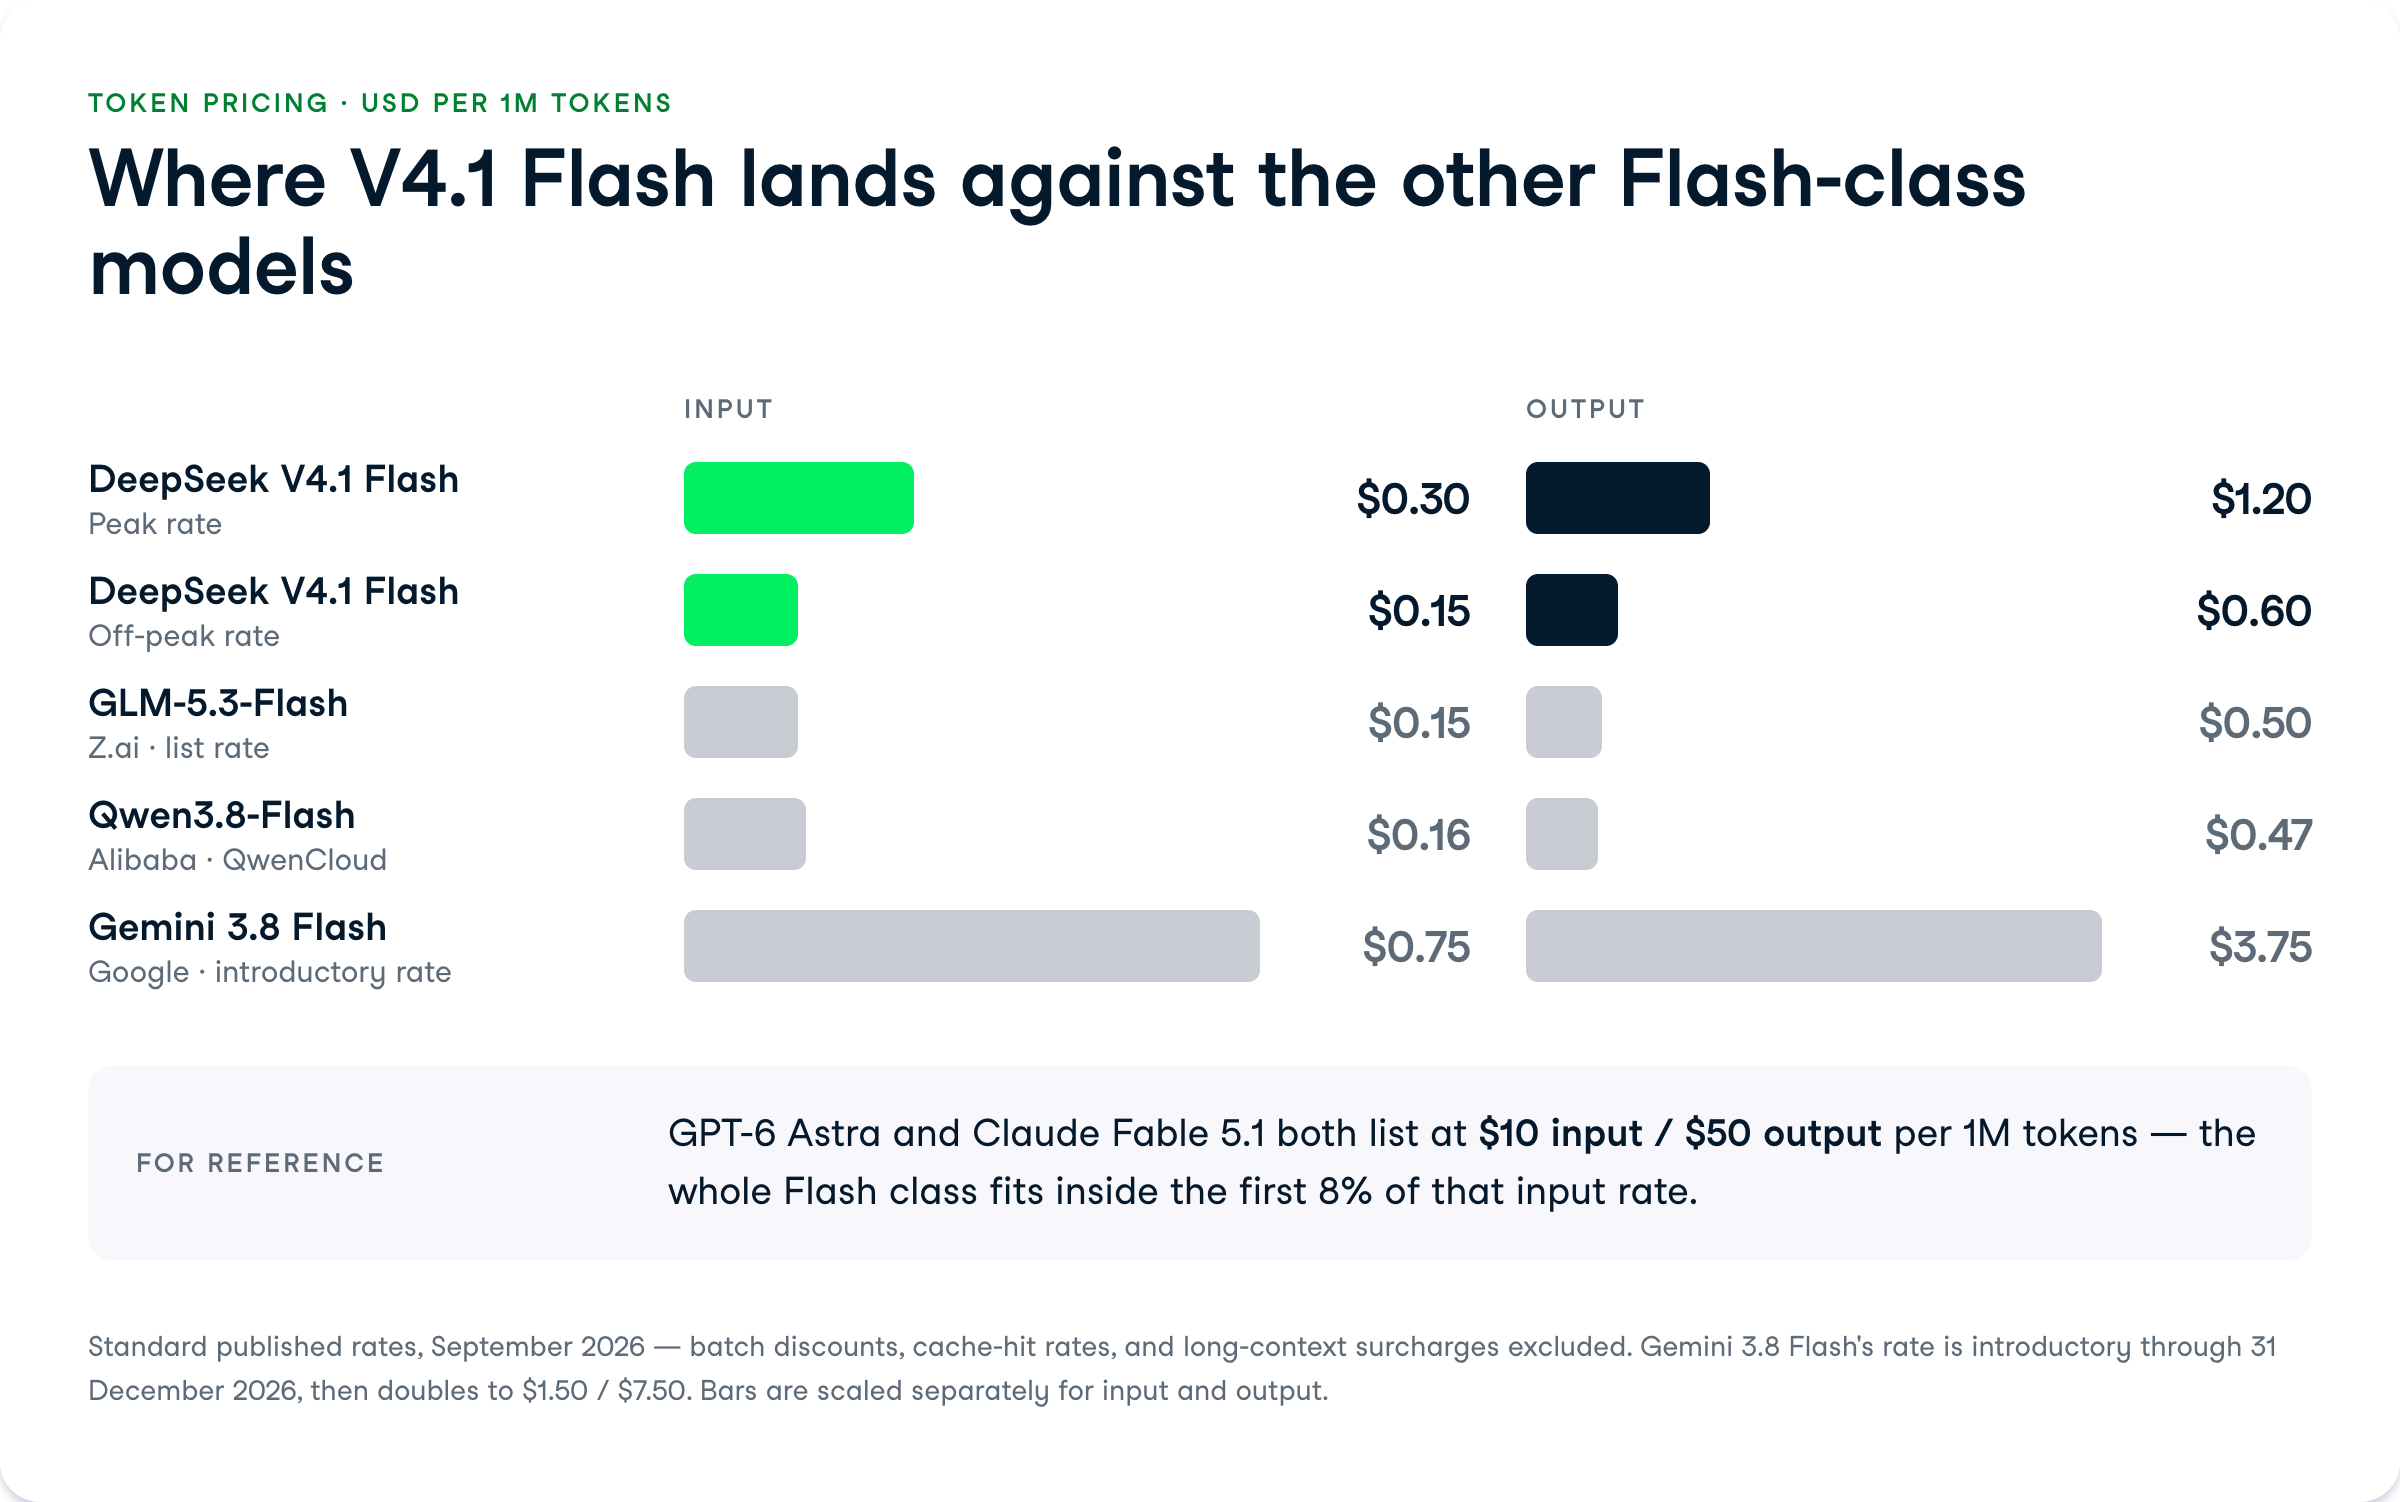
DeepSeek V4.1 Flash 是一款 5520 亿参数的专家混合(MoE)模型,输入激活约 80 亿参数、输出激活约 160 亿参数,提供 MIT 许可的开源权重,峰值价为每百万标记 $0.30/$1.20,离峰价为 $0.15/$0.60,价格上压过其他同类 Flash 模型,如 Gemini 3.8 Flash 和 GLM-5.3-Flash。
本文将全面介绍 DeepSeek V4.1 Flash 的新变化,涵盖功能亮点与基准测试。如果您想直接看模型实操,请阅读我们的 DeepSeek V4.1 API 教程。
如需进一步了解 DeepSeek 系列,请参阅我们的指南:在 Unsloth Studio 和 OpenCode 上运行 DeepSeek-V4-Flash-0731,以及对比文章 DeepSeek v4.1 Flash vs Gemini 3.8 Flash。
DeepSeek V4.1 Flash 是 DeepSeek Flash 系列中最新的模型,定位为高效高吞吐,而非研究级重型模型。
它采用稀疏专家混合(MoE)架构,总参数量为 5520 亿,但每个标记在输入侧仅激活约 80 亿参数、在输出侧激活约 160 亿参数。稀疏激活既保持了服务成本的低位,又能在多项基准上达到前沿水平。
相较上一代,最大变化是效率。
DeepSeek 将 KV 缓存缩小到上一代 V4 Flash 的约四分之一,从而降低了内存占用,并以更低成本支持更长上下文。官方还表示,V4.1 Flash 在性能、成本、速度与总用时上全面超越旧版 V4 Pro 0813,因此后者将被逐步淘汰。
在基准方面,最亮眼的是 Terminal-Bench 2.1 的 90.6 分。我们此前测试的 DeepSeek-V4-Flash-0731 在同一基准上得分 82.7,说明 V4.1 Flash 在同系模型中对终端代理任务有了实质性提升。
V4.1 Flash 的功能围绕两大理念:成本低、对外开放。以下是对数据科学家或 ML 工程师最有用的能力点。
V4.1 Flash 提供 MIT 许可的权重,这是最宽松的常见许可,允许商用、再分发和微调,且无营收门槛。
对有数据隐私要求的团队而言,这意味着您可以完全在自有硬件上运行模型,而无需将请求发送至 DeepSeek API。
权衡在于,MIT 许可会把安全、微调和推理优化的责任转移给您。
我们在本地运行早期版本 V4-Flash-0731 时,在 Q8 量化下需要三张 NVIDIA A100 80GB GPU,因此仅当您有充足的 GPU 显存时,自托管才切实可行。
V4.1 Flash 可直接接收图像作为输入,无需额外的视觉适配器或预处理步骤。您可以在同一请求中与文本一并传入截图、图表或文档扫描件,这对文档密集型流水线和 UI 代理工作流很实用。
在这一价位提供原生多模态输入并不常见。在带工具的 ZeroBench-main 评测中,V4.1 Flash 得分为 49.0,可作为其处理视觉推理能力的粗略参考。
V4.1 Flash 的 KV 缓存约为前代 V4 Flash 的四分之一,降低了服务会话中维持长上下文的内存成本。
对持续在线推理而言,更小的 KV 缓存意味着每块 GPU 可承载更多并发会话,或单请求更低的内存开销。
叠加峰值时缓存命中输入每百万标记 $0.006 的定价,使上下文复用极为便宜。如果您在请求间反复发送相同的系统提示或文档,被缓存的部分几乎不花钱。
DeepSeek 采用双层定价:离峰价为峰值价的一半,意在将批处理和计划任务推入离峰时段。若能把握时机,$0.30/$1.20 可降至每百万标记 $0.15/$0.60。
但运营层面需注意:持续在线的工作负载会更难以成本预测,而要拿到折扣,您需要自建并维护作业调度逻辑。
V4.1 Flash 在代理与推理类基准上的表现最强,以极低的标记成本触及前沿附近的分数。
在最难的代理评测上分数会明显下滑,这一点在投向长周期任务前需要知悉。
V4.1 Flash 在 Terminal-Bench 2.1 上得分 90.6,衡量的是模型在终端环境中完成多步任务的能力。
作对比,我们测试的 DeepSeek-V4-Flash-0731 在同一基准上得分 82.7,而 GPT-5.6 Terra 在我们的 Terra vs. Sonnet 5 对比中达到了 87.4。
在更难的代理评测上,情况有所变化。
V4.1 Flash 在 Terminal-Bench 3.0 上降至 30.0 分,说明它能很好地处理标准终端任务,但在更严苛的代理评测套件上会吃力。其 3471 的 Codeforces 评级则表明具备较强的竞技编程能力。
在 GPQA Diamond 上(这是一组研究生水平的科学问题,旨在难以仅凭记忆作答),V4.1 Flash 得分 90.9。
对该价位段的模型而言,这是一个强势结果,使其有资格与价格高得多的前沿模型同台讨论。
在 Humanity's Last Exam(HLE,这是一项刻意严苛的专家级基准)上,V4.1 Flash 得分 36.8,带星配置为 39.1。
作比较,在面向科学代理的评测如 Terminal-Bench-Science 0.1 中,Claude Fable 5.1 面对更强对手拿到 52.6% 的成绩。因此,V4.1 Flash 并非最难专家评测的领跑者,但表现也不失体面。
V4.1 Flash 在 MathArena Apex(奖励多步符号推理的竞赛数学基准)上得分 65.6。
这是该模型的强项之一,表明其适合定量分析和偏数学的工作负载。
在这里拿到 60 多分对需要可靠算术与代数推理的工具尤为重要,因为许多更便宜的模型正是倒在这些任务上。
这里的抉择与其说是模型变体,不如说是 V4.1 Flash 的部署方式,因为同一权重有三种运行路径。您的选择取决于成本可预测性、数据隐私,以及是否能够安排作业调度。
DeepSeek 也在推进迁移期:自 2026 年 9 月 14 日北京时间 12:00 起,直至 V4.1 Pro 发布前,旧版端点的请求会被重定向,推动现有用户转向 V4.1 系列。如果您仍在使用 V4 Pro 0813,该模型将被逐步下线,请尽快规划迁移至 V4.1 Flash。
| 使用场景 | 推荐路径 | 原因 |
|---|---|---|
| 高吞吐、持续在线的编码代理 | 官方 API,峰值计价 | 每百万标记 $0.30/$1.20 已远低于前沿对手;无需调度开销 |
| 大批量推理或数学作业 | 官方 API,离峰 | 离峰可将费率减半至每百万 $0.15/$0.60,前提是能调度运行 |
| 敏感或专有数据 | 自托管 MIT 权重 | 推理留在自有硬件;需充足 GPU 显存 |
| 大量上下文复用 | 支持提示缓存的 API | 缓存命中输入每百万 $0.006,让重复上下文几乎免费 |
V4.1 Flash 是当前能力与价格兼顾最好的模型之一,尤其在离峰时段。以下是标记计费的拆分。
| 费率 | 峰值 | 离峰 |
|---|---|---|
| 每百万标记的输入 | $0.30 | $0.15 |
| 每百万标记的输出 | $1.20 | $0.60 |
| 每百万标记的缓存命中输入 | $0.006 | 未公布 |
离峰价设为峰值的一半,旨在将批量与计划作业引导至离峰窗口。
以峰值价为参照,GPT-6 Astra 与 Claude Fable 5.1 的定价均为每百万输入 $10、输出 $50,V4.1 Flash 在峰值下输入约便宜 30 倍、输出约便宜 40 倍。
正被淘汰的 V4 Pro 0813,在 100 万标记上下文下,定价为每百万输入 $0.435、输出 $0.87。
鉴于 DeepSeek 声称 V4.1 Flash 在性能、成本与速度上均超越 V4 Pro,继续停留在旧模型已无太大意义。
V4.1 Flash 可通过官方 DeepSeek API 使用,其 MIT 许可权重也已发布,便于自托管。
自 2026 年 9 月 14 日起,旧端点请求将被重定向至 V4.1 系列,直至 V4.1 Pro 上线。
V4.1 Flash 同时提供 API 模型与开源权重两种方式,您可以通过两条路径使用。
在 API 侧,模型 ID 通常标注为 deepseek-flash,端点与 OpenAI 兼容,这意味着多数现有 OpenAI 客户端代码只需更改 base URL 即可复用。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_KEY",
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices.message.content)
若要自托管,MIT 许可权重允许商用、再分发与微调,且无营收门槛。
我们此前在本地结合 Unsloth Studio 运行 V4-Flash-0731,于 Q8 量化下需要三张 NVIDIA A100 80GB GPU;如用全精度,请预估相近级别的硬件预算。
完整的本地指南请参阅教程:使用 Unsloth Studio 和 OpenCode 运行 DeepSeek-V4-Flash,涵盖 GPU 分布与推理配置等细节。
当其他前沿模型的价格攀升至每百万标记 $10/$50,且把访问锁在付费层后,V4.1 Flash 则在价格与开放性上给出了明确立场。
一款 5520 亿参数的 MoE 模型,配备 MIT 权重、原生图像输入、GPQA Diamond 90.9 分,且峰值价较 GPT-6 Astra 低 30 倍,对高吞吐工作负载而言是颇具诚意的选择。
如果做编码代理与批量推理任务,尤其能安排离峰调度,我会选择切换。
不足之处在于其在 Terminal-Bench 3.0 上仅 30.0 分,显示在最难的代理任务上不够稳定;而峰/离峰计费也会引入您需要承担的调度工作。
如您希望围绕此类模型构建代理工作流,可从我们的 AI Agent Fundamentals 技能路径开始。
热门 DataCamp 课程
课程
课程
实践并学习路径你的进步。
使用 Google 继续