
课程
面向开发者的 AI 辅助编码
1 小时 30 分钟
10.7K
在GLM-5.3 Flash发布的同一天,阿里巴巴 Qwen 团队开放了 Qwen3.8-Flash-Next 的权重。这是一款多模态专家混合(MoE)模型,同时也是即将到来的 Qwen4 家族背后架构的早期预览。
这与 Qwen3-Next 对 Qwen3.5 所做的类似:先行发布架构变更,让社区在完整产品线推出前先行研究。
重点在成本。得益于高效的新架构,Qwen3.8-Flash-Next 的训练成本大约只有其前代 Qwen3.7-Plus 的九分之一。但性能并未因此打折;在 SWE-bench 等重要编码测试上,它实际上击败了诸如 Claude Opus 4.6 Max 这样的重量级对手。
本文将全面介绍 Qwen3.8-Flash-Next 的最新内容,涵盖其架构与特性,并探讨其基准表现。若想深入了解如何本地下载与运行该模型,请阅读我们的Qwen3.8-Flash-Next 教程。如需了解其他中文模型的背景,请参阅我们的 Qwen3.8-Max 指南以及关于本地运行 DeepSeek-V4-Flash-0731的教程。我也推荐您关注全新的 Qwen3.8-Omni-Flash 发布。
Qwen3.8-Flash-Next 是阿里巴巴 Qwen 团队于 2026 年 8 月 26 日发布的多模态 MoE 模型,定位为注重成本效率的“干活型”模型,而非顶级旗舰。
它在智能水平上低于 Max 级别,但在价格上几乎全面压制对手——这正是“Flash”产品线的核心诉求。
该模型原生支持 262,144-token 的上下文窗口,可通过 YaRN([Yet another RoPE extensioN] 方法,一种扩展模型上下文窗口的位置编码技术,使其在保持原有性能的同时处理海量文本输入)扩展至 1,000,000 tokens。
它可通过同一个 API 处理文本、图像与视频,这也是为什么在 2026 年 8 月的发布盘点中,有评论称其为“一夜之间的社区宠儿”。
这次发布对从业者的重要意义在于“每美元基准分”。
Qwen3.8-Flash-Next 在已发布的所有基准上都优于自家 27B 同门,并在多数实用的编码与智能体评测上跑赢 Claude Opus 4.6 Max,同时每个 token 仅激活 6B 参数。作为 Qwen4 架构的预览,这些设计选择也在预示阿里巴巴下一步的方向。
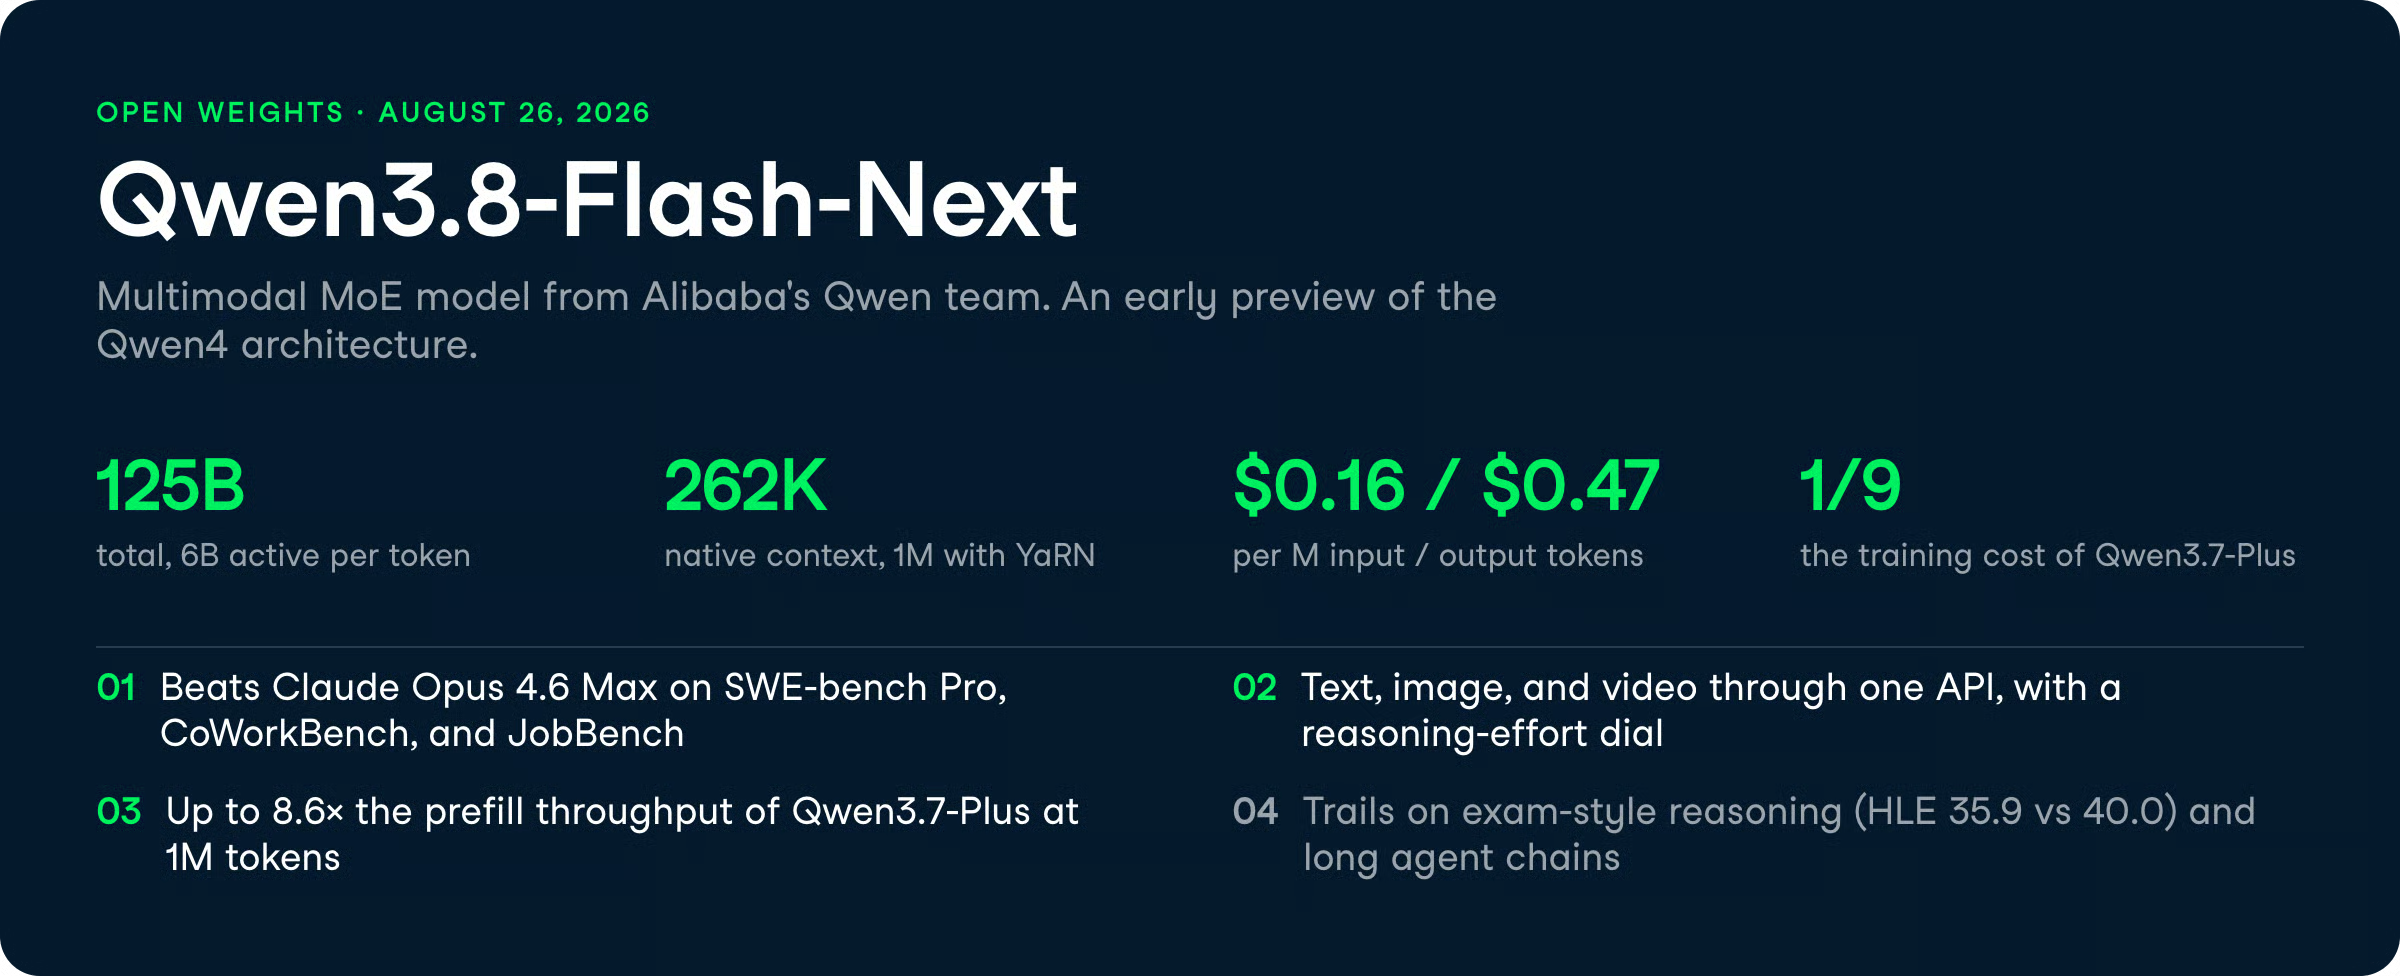
Qwen3.8-Flash-Next 在注意力、残差、嵌入和优化四个维度进行了升级。
下面我将不只描述这些变化是什么,而是拆解它们对用户的实际价值。
最显著的实用收益,是长输入场景下的速度。
Qwen3.8-Flash-Next 采用混合型注意力设计:它会压缩大部分上下文历史以节省空间,并通过定向的“稀疏注意力”工具在需要时检索最相关的细节。
在 100 万 tokens 时,提速幅度巨大:提示处理(prefill)最高快 7.6 倍,生成(decode)最高快 4.9 倍。在典型的前缀缓存服务场景下,相较 Qwen3.7-Plus,整体吞吐量提升达 8.6 倍。
对于需要高频检索或代码库级别编码智能体的用户而言,这个吞吐差异本身就是核心特性。
计算是要花钱的,而这套设计正好大幅降低了曾经最昂贵的长序列开销。
Qwen 使用了一个巧妙的 N-gram 嵌入技巧,基本“零成本”地增加了 510 亿参数。模型不再只看当前 token,而是结合其近邻 token,从而形成强大的“局部模式记忆”。
由于模型可提前知道要查什么,这额外的 510 亿参数放在标准系统内存(RAM)中,而非 GPU。它们在后台按需拉取,不会长期占用 GPU 显存,也不会拖慢单 token 的计算。
您等于获得了“大模型的头脑”,却无需支付通常的显存成本。
Qwen3.8-Flash-Next 通过统一接口处理文本、图像与视频,其视觉能力显著超出其价格档位。
在移动端使用测试中表现优于 Claude Opus 4.6 Max(AndroidWorld 84.5 vs 62.0),在真实世界视觉理解上亦然(RealWorldQA 88.5 vs 73.9)。
在视觉数学方面也非常强势:MathVision 最高达到 95.7(显著领先于 Opus 的 65.5)。
如果您的工作流涉及解析屏幕截图、图表或应用界面,Qwen 在这个价位段相较 Claude 具有实打实的优势。
API 提供 reasoning effort(推理力度)调节,含高/中/低三档,允许您在深度思考与低时延、低成本之间做权衡。
模型还内置多 token 预测模块,简单说就是“预测多步”,以加速实际工作负载中的生成。
实际意义在于“可控”。
面对高并发、成本敏感流量可降低推理强度;处理复杂的智能体任务则可调高,同一模型 ID 即可满足不同需求。
从已公布的数据来看,Qwen3.8-Flash-Next 在多数编码与智能体基准上领先,而在少数考试型推理评测上落后。
它全面优于自家 27B 同门,尤其在智能体工作场景中的差距最大。
除特别说明外,下述对比均来自 Qwen 官方发布表。
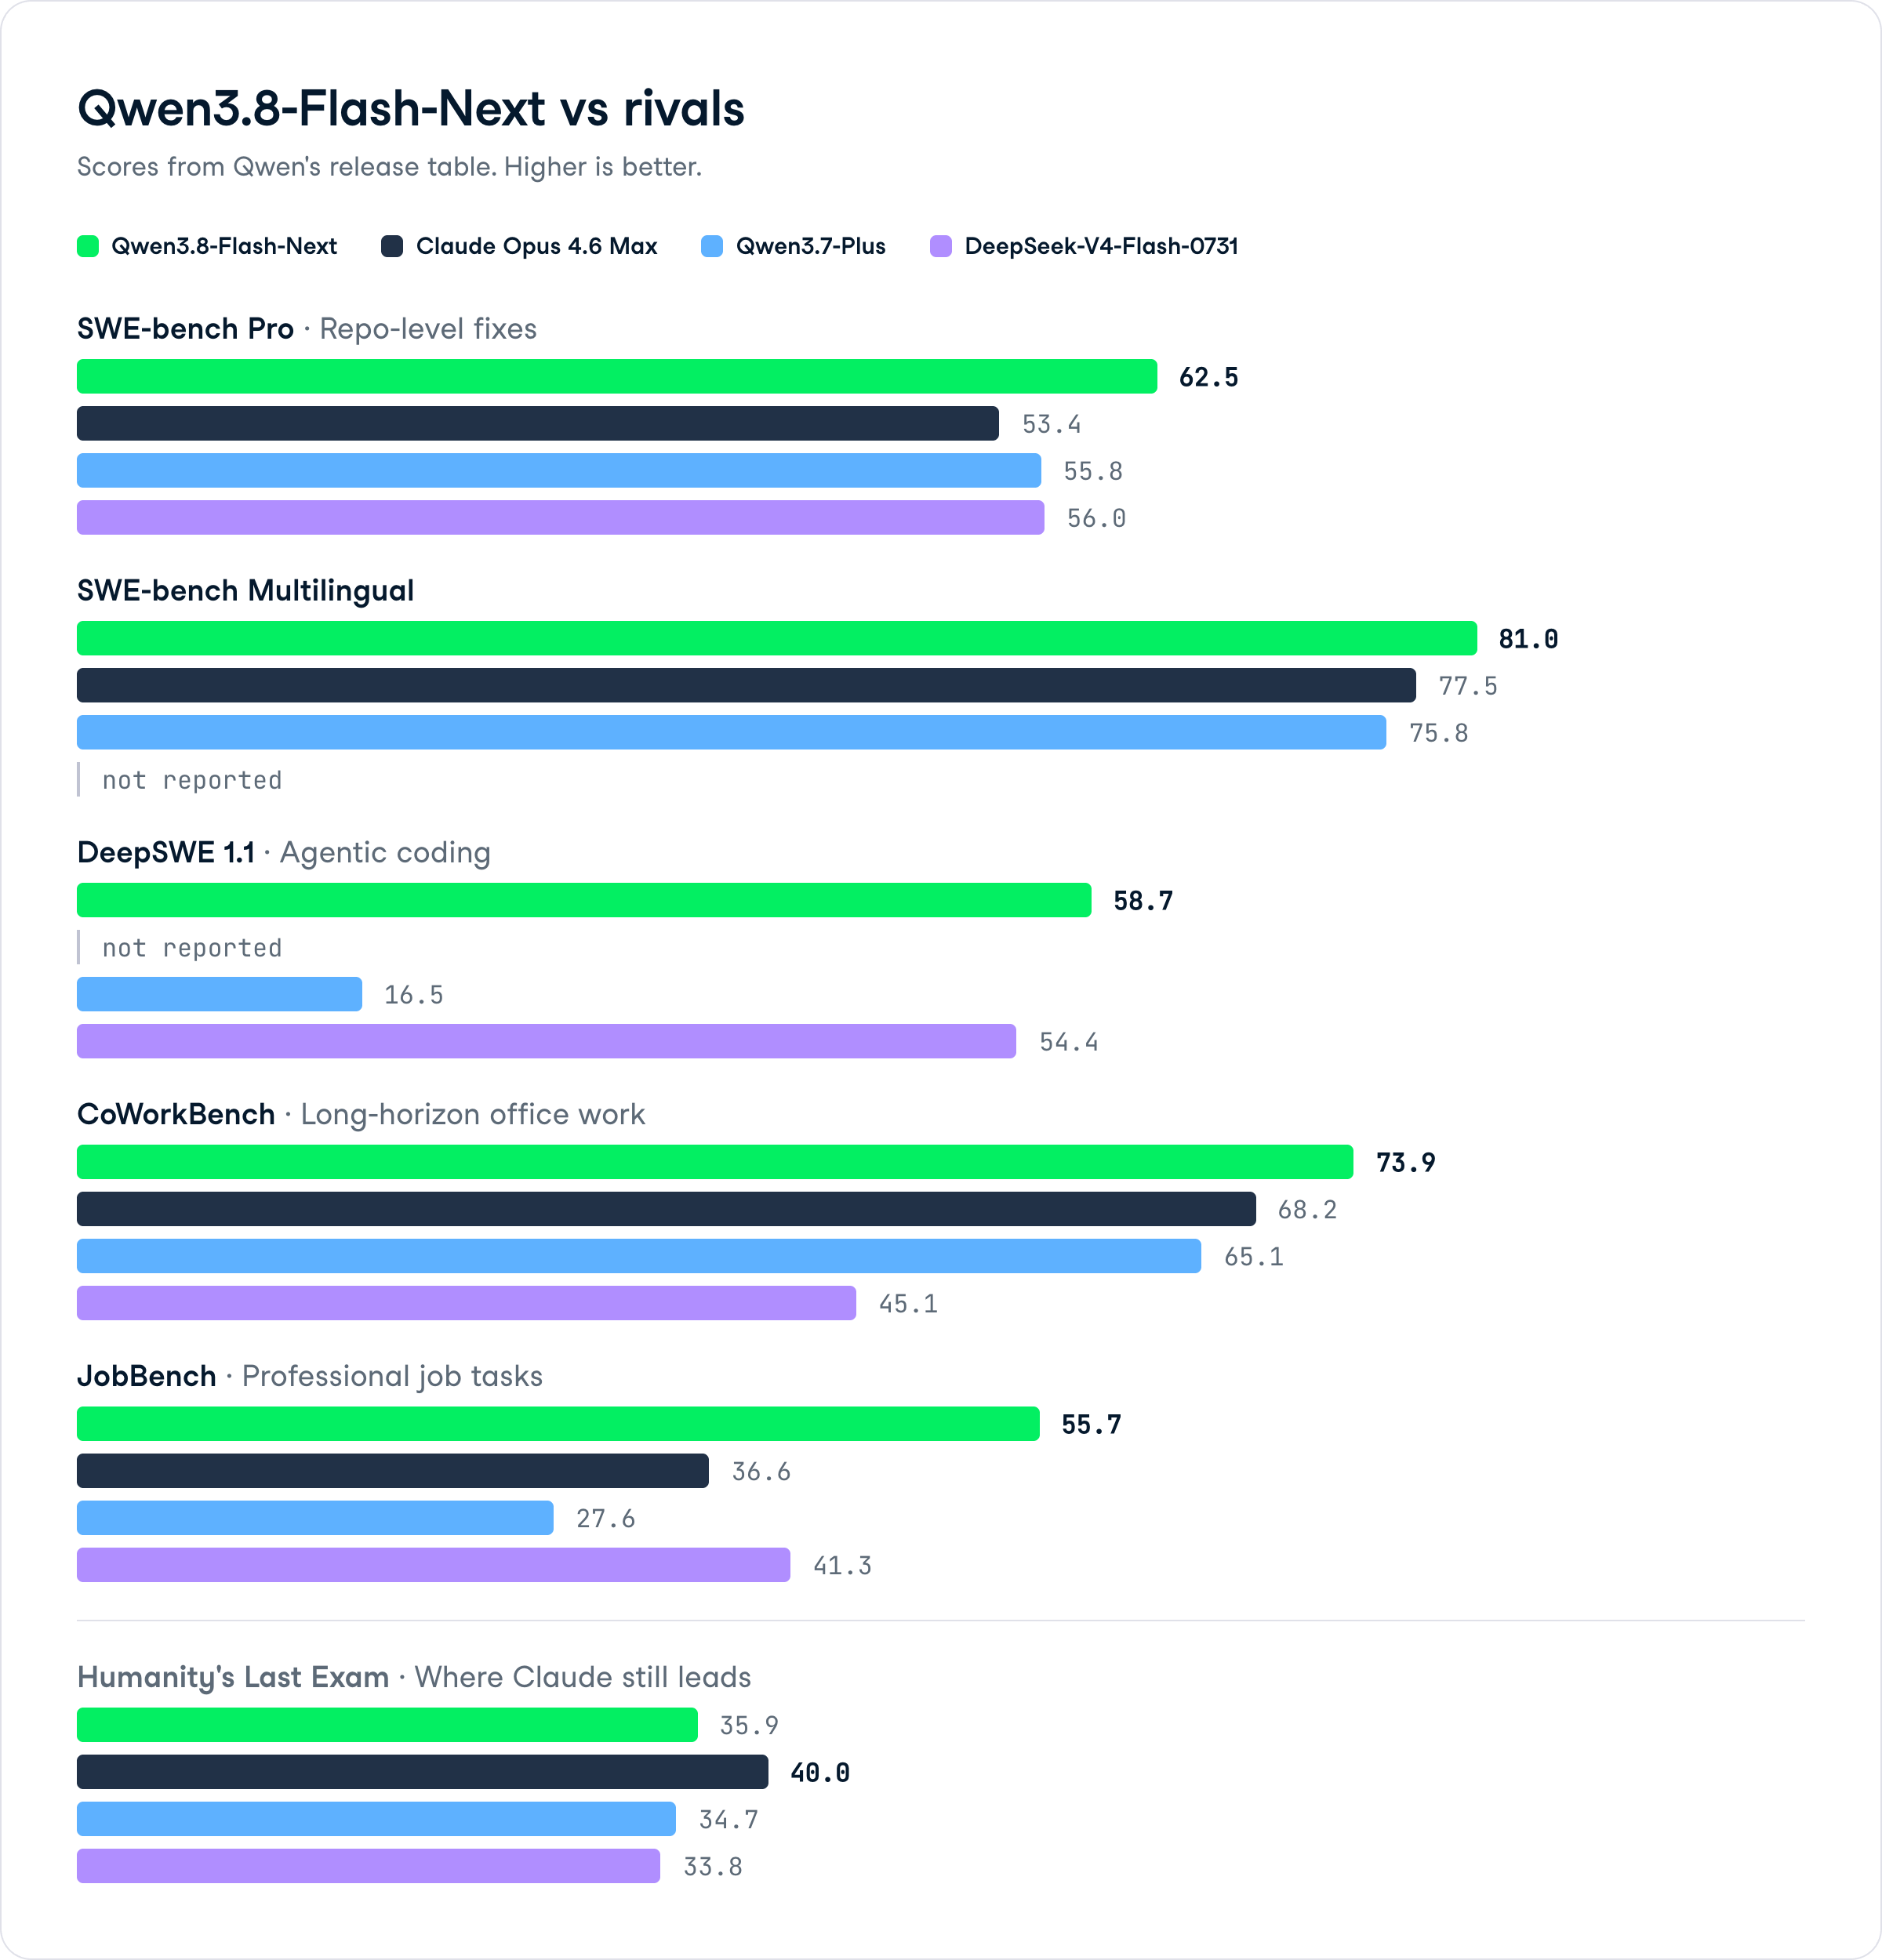
SWE-bench Pro 衡量真实代码库层面的软件修复,Qwen3.8-Flash-Next 得分 62.5,领先于 Claude Opus 4.6 Max 的 53.4 和 Qwen3.7-Plus 的 55.8。
在跨语言修复测试 SWE-bench Multilingual 上,它得分 81.0,对比 Opus 4.6 Max 的 77.5。
这些成绩是本次发布的核心驱动力。
一个每 token 激活 6B 的模型能在代码库级工程任务上击败 Max 级的 Claude,这也是它备受关注的原因。
DeepSWE 1.1 通过如 Claude Code、mini-SWE-agent 等工具衡量智能体编码,Qwen3.8-Flash-Next 得分 58.7,自家 27B 同门为 42.2,Qwen3.7-Plus 为 16.5。
DeepSeek-V4-Flash-0731 在此项的得分为 54.4。
在我们的教程中,将 DeepSeek-V4-Flash-0731 作为编码智能体运行时,它从单个提示构建了一个完整的股票分析网站,用时约 20 分钟,聊天生成速度约每秒 33 tokens。
两款模型在 DeepSWE 上的差距表明,Qwen3.8-Flash-Next 在类似的智能体编码循环中也应有不错的表现。
在智能体侧,该模型在多项评测中给出了强劲数据:
JobBench 上的差距尤其醒目。
在专业工作流任务上,Qwen3.8-Flash-Next 比 Max 级 Claude 高出近 20 分,这种结果很值得在企业自动化中进行试用。
在通用推理方面,Qwen3.8-Flash-Next 的 GPQA Diamond(科学推理)达到 91.7,略高于 Claude Opus 4.6 Max 的 91.3;在 LiveCodeBench v6(竞赛编程)为 91.9,对比 Opus 4.6 Max 的 88.8。
但它并非处处取胜。
在多学科推理的 Humanity's Last Exam(HLE)上,它的得分 35.9 低于 Claude Opus 4.6 Max 的 40.0。在 Agents' Last Exam Pass@1 上,DeepSeek-V4-Flash-0731 也以 25.2 比 24.3 小幅领先。
在独立追踪器上的模式也类似:Qwen3.8-Flash-Next 在实用编码与智能体工作上领先,而 Claude 在部分考试型推理基准上仍占优。
Qwen3.8-Flash-Next-Base 在与 Qwen3.8-27B 基座模型和更大的 Qwen3.7-Plus 基座模型对比中,赢下了 14 项预训练基准中的 8 项。
其在 MMLU-Pro(73.23)、SuperGPQA(51.36)、BBH(90.87)、GSM8K(93.29)、EvalPlus(78.76)、SWEBench-Pretrain(50.99)、MGSM(89.33)与 MMMLU(84.86)上领先。
更值得注意的是,它以 6B 激活参数对阵 Qwen3.7-Plus 的 17B 激活与 397B 总参数,并在 MMLU、MMLU-Redux、GPQA、MATH、MultiPL-E 上将差距控制在 1 分以内。
那 510 亿 N-gram 嵌入参数是按确定性地址访问的,且从不进入单 token 的矩阵乘计算预算,因此这是真正的效率提升,而非“参数数量游戏”。
下面是它在重点评测上与 Claude Opus 4.6 Max、其前代 Qwen3.7-Plus、以及 DeepSeek-V4-Flash-0731 的横向对比。
| Benchmark | Qwen3.8-Flash-Next | Claude Opus 4.6 Max | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 53.4 | 55.8 | 56.0 |
| SWE-bench Multilingual | 81.0 | 77.5 | 75.8 | -- |
| DeepSWE 1.1 | 58.7 | -- | 16.5 | 54.4 |
| CoWorkBench | 73.9 | 68.2 | 65.1 | 45.1 |
| JobBench | 55.7 | 36.6 | 27.6 | 41.3 |
| GPQA Diamond | 91.7 | 91.3 | 90.3 | 90.8 |
| LiveCodeBench v6 | 91.9 | 88.8 | 89.6 | 90.6 |
| HLE | 35.9 | 40.0 | 34.7 | 33.8 |
Qwen3.8-Flash-Next 的权重现已在 Hugging Face 与 ModelScope 以开源权重形式提供。
其生产版本(默认 100 万上下文并内置工具)在 QwenCloud 以 Qwen3.8-Flash 的形式提供,模型 ID 为 qwen3.8-flash。
定价是这款模型竞争力最强的地方:
对比来看,我们的 Qwen3.8-Max 报道中,该型号的定价为输入 2.00 美元、输出 6.00 美元每百万 tokens,因此 Flash-Next 在输入端比自家 Max 机型便宜 10 倍以上。
QwenCloud 支持与 OpenAI 兼容的 Chat Completions 与 Responses API,以及与 Anthropic 兼容的接口,因此几乎无需配置改动即可接入 Claude Code、Codex 和 Qwen Code。
需注意的是,发布时 API 标注为“即将上线”,请在 QwenCloud 查看实时可用性。
GLM-5.3-Flash 是同日发布的另一款预算型模型,也是最值得并列对比的直接竞品。
| Qwen3.8-Flash-Next | GLM-5.3-Flash | |
|---|---|---|
| 架构 | 总参 125B / 激活 6B | 总参 320B / 激活 18B |
| 原生上下文 | 262K(配合 YaRN 可到 1M) | 原生 1M tokens |
| DeepSWE v1.1 | 58.7 | 63.4 |
| SWE-bench Pro | 62.5 | 未公布 |
| 输入价格 | $0.16/1M | ~$0.075/1M(促销) |
| 多模态 | 支持 | 支持 |
GLM-5.3-Flash 在 DeepSWE v1.1 上领先(63.4 vs 58.7),并在 Terminal-Bench 2.1 上得分 84.3(Qwen 未公布该项数据)。
它在促销期内的输入价格更低,且原生即支持 100 万 token 上下文,无需 YaRN。
Qwen3.8-Flash-Next 在 SWE-bench Pro(62.5)、CoWorkBench(73.9)与 JobBench(55.7)上领先,而 GLM 未公布对应数据。Qwen 每 token 激活的参数也明显更少(6B vs 18B),这使得自托管成本更低、规模化服务更快。
总的来说,在双方直接共享的基准上,GLM 的已公布成绩更强;而 Qwen 在办公与专业工作流评测上占优,且如果您自建基础设施,Qwen 是更合适的选择。关于 GLM-5.3-Flash 的完整解析,请参阅我们的详尽指南。
Qwen3.8-Flash-Next 明确传达了阿里巴巴将成本效率作为竞争主战场的信号。
以每 token 激活 6B 参数、每百万输入 tokens 0.16 美元的价格,在 SWE-bench Pro、CoWorkBench、JobBench 上击败 Claude Opus 4.6 Max,这对任何运行大规模编码或智能体工作负载的团队,都是一个强有力的方案。
我会将其视为工具驱动与重编码流水线的强默认选项,但有两点需要注意。
社区反馈指出,在非常长的智能体链上偶有不稳定,且当工具返回非标准 JSON 时较为脆弱;同时,相比 Claude 系列,该模型在安全性上更不保守,边界内容需要更谨慎的提示设计。
HLE 与 Agents' Last Exam 的结果也表明,它并非应对最难的考试型推理题时的首选。
作为 Qwen4 架构的早期预览,GDN + QSA 混合方案与 N-gram 嵌入的设计值得持续关注,因为完整的 Qwen4 家族将以此为基础构建。
如果阿里巴巴能在旗舰级别维持这种“每美元基准分”比率,前沿模型的定价讨论将被改写。
如果您想围绕这类模型搭建智能体与编码工作流,建议从我们的AI Agent Fundamentals 技能路径入手,快速掌握核心概念。
热门 DataCamp 课程
课程
课程
课程