2017 年,Google 以其开创性的论文 "Attention is All You Need" 震撼了 AI 社区。该论文提出了 Transformer 架构,通过自注意力机制彻底改变了序列建模。
最近,Google 发布了题为 "Titans: Learning to Memorize at Test Time" 的新论文,提出了一种新颖的记忆架构,旨在提升 AI 系统存储和利用信息的方式。
这项研究从人类记忆的精妙机制中汲取灵感,旨在克服现有 AI 模型记忆系统的局限,尤其是 Transformer 受限的上下文窗口。
Titans 架构 引入了一种复杂的方法,将短期、长期和持久性等不同类型的记忆整合进 AI 模型,使其能够在测试时动态学习与记忆。
其中的核心是“惊讶”(surprise)机制,源自人脑更容易记住意外事件的倾向。该架构通过融入当下与过往的“惊讶”,让模型高效管理记忆,确保数据被有效记忆与检索。
在本文中,我将简化 Titans 论文中的概念和机制,并探讨这一新架构可能对 AI 未来产生的影响。
Transformer 是当今大多数大语言模型(LLM)所采用的架构。它以处理数据序列(如句中的词语)的能力而著称,并借助所谓的“注意力”机制有效聚焦于数据的相关部分。然而,它们面临一个关键挑战:上下文窗口的大小。
上下文窗口本质上是 Transformer 一次能考虑的信息量。可以把它想象成沿着句子移动的一扇“窗口”,捕捉一段词语以便在上下文中理解其含义。
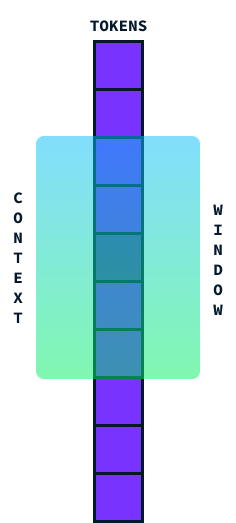
理想情况下,我们希望这扇窗口尽可能大,以便一次处理更长的文本。但问题在于:随着上下文窗口变大,计算量会急剧增加,这是因为 Transformer 架构具有时间与空间复杂度的二次方增长。
这意味着如果我们将上下文窗口尺寸加倍,计算量不只是翻倍——而是会增加到四倍!这是因为窗口中的每个词都需要与其他每个词进行比较,计算量呈快速增长。
当今最先进(SOTA)的模型拥有 200 万 token 的上下文窗口。然而,处理成本非常高,而且某些应用(如视频理解)需要更大的上下文窗口。如果能在不显著增加计算成本的情况下延长上下文窗口,LLM 就能更有效地处理更长的序列,从而提升在需要一次性理解大段数据任务上的表现。这也是为何解决二次方成本问题是推动这些模型进步的重点。
什么是 Titans 架构?
Titans 是一种新架构,借鉴人类记忆的复杂性,增强 AI 模型在处理海量且复杂数据时高效存储与检索信息的能力。
来自人类记忆的启发
记忆在人类学习与行为中至关重要。它帮助我们保留过往经验的信息,用以决策、适应新情境并解决问题。人类记忆大致可分为三类:
- 短期记忆: 用于处理当前信息。就像一个心理工作台,临时存放并管理眼下需要的数据,例如把电话号码记住到拨号完成为止。
- 长期记忆: 长期存储信息。包括我们的知识、技能和个人记忆,使我们即便在多年后仍能回忆并从中学习。
- 元记忆: 即“对自己所知的认知”。它帮助我们评估能记住或完成任务的程度,从而影响我们的决策与判断。
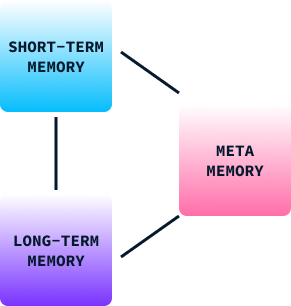
在人类行为中,这些记忆类型协同工作,使我们能从环境中学习、调整策略,并随时间改善行为。没有记忆,我们将被限制在基本反射与刻板行为中。
Titans 的记忆结构
与人类记忆模型相似,Titan 的记忆结构由三部分构成:
- 短期记忆(核心): 专注于处理当前任务,使 AI 能以高精度处理即时数据。类似于大脑的短期记忆,该组件让相关信息便于快速处理,但不会长期保留。
- 长期记忆: 用作长期信息存储库。该模块类似人类的长期记忆,保留非即时所需但未来可能重要的经验、知识与记忆。它使 AI 模型能有效记住并访问过往信息,对需跨时间理解上下文的任务至关重要。
- 持久性记忆: 类似大脑的元记忆,在模型内部嵌入与任务相关的知识。这类记忆涉及不依赖当前输入却对理解与执行特定任务至关重要的参数。持久性记忆确保已学得的模式与框架成为模型的一部分,增强其将过往学习迁移到新情境的能力。
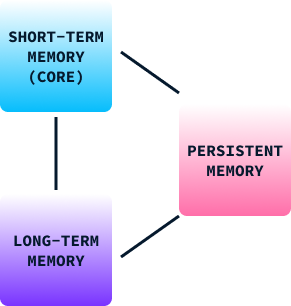
通过整合这三类记忆,Titans 架构使 AI 模型能够像人脑一样动态管理信息,将即时处理与过往经验和知识的保留相结合。
“惊讶”机制
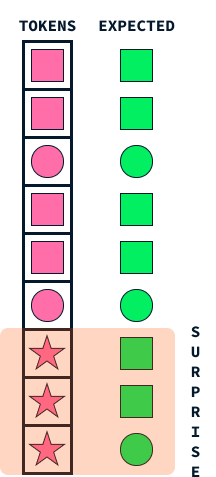
Titans 的“惊讶”机制模仿了人类记忆的一个基本特征:我们更容易鲜明地记住令人意外的事件。这一方法帮助 AI 模型通过识别偏离模型预期的数据,来决定哪些信息值得存储。
想象您走在街上,一切都很普通和日常。几周后,您也许不会记得这段散步。但如果发生了意想不到的事情,比如一场色彩缤纷的游行经过,或接到一个令人振奋的电话,这些出乎意料的元素会抓住您的注意力,让它们更令人难忘。
类似地,Titans 运用“惊讶”来优先选择要记忆的信息。当模型遇到与其预期明显不同的数据(就像那场多彩的游行),它会将该信息标记为“惊讶”。Titans 的记忆系统随后优先存储这些意外事件,确保重要但不寻常的数据不会被忽略。
这一机制让 Titans 能通过聚焦于重要的离群信息来高效管理记忆资源,而不是试图保留所有细节。正如人类更可能记住出人意料之事,Titans 采用这一自然策略来有效处理与保留关键信息,从而在需要筛选海量数据的复杂任务中表现更佳。
形式化地说,“惊讶”被定义为损失函数对输入的梯度。这本质上衡量了为最小化损失,模型参数需要针对新输入发生多大改变。
将梯度作为“惊讶”度量的直觉在于:较大的梯度意味着模型需要作出显著调整以适应新输入,表明该输入与模型过往所见差异较大,或是出乎预料,因此“令人惊讶”。
遗忘机制
Titans 架构中的遗忘机制是为有效管理长期神经记忆而设计的关键组件,确保模型在保留相关信息的同时丢弃不再需要的内容。
在处理海量数据时,这一机制尤为重要,否则记忆可能会被过时或无关信息占据。在实践中,遗忘机制通过调整记忆更新规则来有选择地擦除信息,依据推理过程中动态评估的“惊讶”程度与相关性来决定。
具体而言,一个自适应门控参数决定应保留多少先前的记忆状态,使模型能够自适应地清理或保留记忆内容。此类机制可防止记忆溢出并促进高效的记忆空间利用,最终提升模型聚焦关键且新颖输入的能力,而不会被不必要的数据积累所拖累。
这种方法与人类的认知过程高度相似:不重要或过时的记忆会随时间淡化,从而提升认知处理与信息检索的效率。
在推理时学习
在传统机器学习 模型中,学习发生在训练阶段。模型训练完毕后会被部署用于推理——基于新的、未见过的数据进行预测——而不会进一步修改其已学得的参数。
Titans 架构通过使模型在推理(也称测试)阶段动态学习,带来了范式上的重大转变。该能力允许 Titans 在处理数据的同时,基于输入数据的“惊讶”程度与重要性,更新其记忆与参数。
在推理时学习带来多项显著优势:
- 对新数据的动态适应: 传统模型受限于静态学习,其参数基于历史训练数据而固定。Titans 通过在推理时学习,能实时适应变化的模式与新奇输入,在面对不断变化的环境或意外数据时更具相关性与准确性。
- 更优的数据相关性与记忆管理: 通过在测试时持续更新记忆,Titans 能优先从被判定为“令人惊讶”或与既有知识不同的数据中学习。这种动态记忆管理类似人脑更关注和记住新颖或重要信息、同时舍弃平常之事,从而避免信息过载。
- 增强的泛化能力: 由于 Titans 能基于实时数据不断完善理解,它对分布外数据(不在原始训练集中的输入)具有更好的泛化能力。这对于输入与训练数据存在显著差异的真实应用而言非常重要。
- 更强的长期依赖建模能力: 在推理时学习使 Titans 更有效地识别并存储数据中的长期依赖。对于处理长文本或视频等需要处理长序列的任务尤为有益。
- 贴近真实世界的适用性: 推理时学习机制让 Titans 能持续进化,随新模式与新知识的出现不断学习。这一特性与真实世界中数据环境动态复杂、模型需保持时效性的需求高度契合。
Titans 的记忆模式
Titans 架构采用三种不同方式融入记忆,分别受人类认知不同方面的启发。我们用简单的类比来逐一说明。
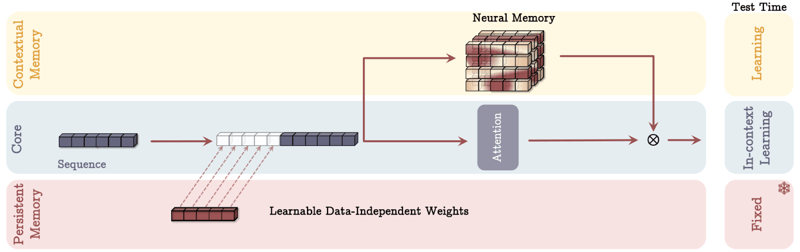
来源:Behrouz 等,2024
作为上下文的记忆(MAC)
想象您在开会时有一位私人助理。助理会做好以往对话的详尽笔记(长期记忆),并在需要时在您耳边低语相关信息(检索)。
在 MAC 模式下,AI 模型的工作方式与此类似。它保留过去数据的详细历史,并将其与当前输入整合以做出明智决策。正如助理将过往知识与当下讨论相结合以提升您的决策,MAC 利用长期记忆为正在处理的即时信息提供上下文。
作为门控的记忆(MAG)
设想您的脑海中有两位顾问。一位只关注当下,针对即时任务给出见解(短期注意力);另一位则汲取多年积累的经验与智慧(长期记忆)。
MAG 模式就像门卫,决定给每位顾问多少关注度,并根据当前需求与过往学习动态调整焦点。这样确保了平衡,使 AI 无论需要即时精度还是过往经验洞见,都能自如适应。
作为层的记忆(MAL)
可将此模式视为多层次的理解,每一层都以独特方式处理信息:
- 第一层像历史滤镜,聚焦长期模式与记忆。
- 第二层关注即时情境,如短期观察。
- 信息在各层之间逐层传递、被不断提炼与变换,确保模型在做出决策前既把握宏观上下文,又洞悉细节。
这种分层处理方式与我们消化复杂信息的阶段性过程相呼应,循序渐进地建立与完善理解。每种模式各有所长,使 Titans 能通过模拟人类处理与保留信息的不同方面,高效应对多样任务。
现实意义与实验成果
实验结果显示,Titans 架构在多项任务上优于传统 Transformer 与现代模型。以下为关键发现:
- 语言建模与常识推理: Titans,尤其是“作为上下文的记忆”(MAC)变体,在语言建模与常识推理任务上表现稳健。
- 大海捞针任务: 在从长序列中检索特定信息的任务(即“大海捞针”)中,Titans 表现尤为出色。
- 处理更大上下文: Titans 能将上下文窗口扩展到超过 200 万个 token 而不牺牲准确性,这相比当前最先进模型是重大提升。
- 时间序列预测: Titans 的神经记忆模块在预测任务中优于多种基线模型,包括基于 Transformer 的与线性模型。
- DNA 建模: Titans 架构在 DNA 建模任务上也展现出有竞争力的表现,证明其在传统自然语言任务之外的多面性。
总体而言,Titans 采用新颖的记忆管理方法,使其能够更有效地处理复杂的长上下文任务,在可扩展性与准确性方面为 AI 模型树立了新标杆。
结语
当前的 Transformer 架构虽强大,但因扩展性问题在处理极长上下文时捉襟见肘。受人类记忆启发的 Titans 创新架构,通过动态管理短期、长期与持久性记忆,克服了这些限制。
我认为,Titans 在推理时学习、适应新数据,并基于“惊讶”机制进行记忆优先级排序的能力,具有让 AI 系统在信息处理方面更趋于“类人”的潜力。这将有望提升 AI 在复杂与动态环境中的表现,或将成为 OpenAI 的 Operator 等 AI 代理的变革力量。


2017 年,Google 以其开创性的论文 "Attention is All You Need" 震撼了 AI 社区。该论文提出了 Transformer 架构,通过自注意力机制彻底改变了序列建模。
最近,Google 发布了题为 "Titans: Learning to Memorize at Test Time" 的新论文,提出了一种新颖的记忆架构,旨在提升 AI 系统存储和利用信息的方式。
这项研究从人类记忆的精妙机制中汲取灵感,旨在克服现有 AI 模型记忆系统的局限,尤其是 Transformer 受限的上下文窗口。
Titans 架构 引入了一种复杂的方法,将短期、长期和持久性等不同类型的记忆整合进 AI 模型,使其能够在测试时动态学习与记忆。
其中的核心是“惊讶”(surprise)机制,源自人脑更容易记住意外事件的倾向。该架构通过融入当下与过往的“惊讶”,让模型高效管理记忆,确保数据被有效记忆与检索。
在本文中,我将简化 Titans 论文中的概念和机制,并探讨这一新架构可能对 AI 未来产生的影响。
当前 Transformer 架构的问题
Transformer 是当今大多数大语言模型(LLM)所采用的架构。它以处理数据序列(如句中的词语)的能力而著称,并借助所谓的“注意力”机制有效聚焦于数据的相关部分。然而,它们面临一个关键挑战:上下文窗口的大小。
上下文窗口本质上是 Transformer 一次能考虑的信息量。可以把它想象成沿着句子移动的一扇“窗口”,捕捉一段词语以便在上下文中理解其含义。
理想情况下,我们希望这扇窗口尽可能大,以便一次处理更长的文本。但问题在于:随着上下文窗口变大,计算量会急剧增加,这是因为 Transformer 架构具有时间与空间复杂度的二次方增长。
这意味着如果我们将上下文窗口尺寸加倍,计算量不只是翻倍——而是会增加到四倍!这是因为窗口中的每个词都需要与其他每个词进行比较,计算量呈快速增长。
当今最先进(SOTA)的模型拥有 200 万 token 的上下文窗口。然而,处理成本非常高,而且某些应用(如视频理解)需要更大的上下文窗口。如果能在不显著增加计算成本的情况下延长上下文窗口,LLM 就能更有效地处理更长的序列,从而提升在需要一次性理解大段数据任务上的表现。这也是为何解决二次方成本问题是推动这些模型进步的重点。
什么是 Titans 架构?
Titans 是一种新架构,借鉴人类记忆的复杂性,增强 AI 模型在处理海量且复杂数据时高效存储与检索信息的能力。
来自人类记忆的启发
记忆在人类学习与行为中至关重要。它帮助我们保留过往经验的信息,用以决策、适应新情境并解决问题。人类记忆大致可分为三类:
在人类行为中,这些记忆类型协同工作,使我们能从环境中学习、调整策略,并随时间改善行为。没有记忆,我们将被限制在基本反射与刻板行为中。
Titans 的记忆结构
与人类记忆模型相似,Titan 的记忆结构由三部分构成:
通过整合这三类记忆,Titans 架构使 AI 模型能够像人脑一样动态管理信息,将即时处理与过往经验和知识的保留相结合。
“惊讶”机制
Titans 的“惊讶”机制模仿了人类记忆的一个基本特征:我们更容易鲜明地记住令人意外的事件。这一方法帮助 AI 模型通过识别偏离模型预期的数据,来决定哪些信息值得存储。
想象您走在街上,一切都很普通和日常。几周后,您也许不会记得这段散步。但如果发生了意想不到的事情,比如一场色彩缤纷的游行经过,或接到一个令人振奋的电话,这些出乎意料的元素会抓住您的注意力,让它们更令人难忘。
类似地,Titans 运用“惊讶”来优先选择要记忆的信息。当模型遇到与其预期明显不同的数据(就像那场多彩的游行),它会将该信息标记为“惊讶”。Titans 的记忆系统随后优先存储这些意外事件,确保重要但不寻常的数据不会被忽略。
这一机制让 Titans 能通过聚焦于重要的离群信息来高效管理记忆资源,而不是试图保留所有细节。正如人类更可能记住出人意料之事,Titans 采用这一自然策略来有效处理与保留关键信息,从而在需要筛选海量数据的复杂任务中表现更佳。
形式化地说,“惊讶”被定义为损失函数对输入的梯度。这本质上衡量了为最小化损失,模型参数需要针对新输入发生多大改变。
将梯度作为“惊讶”度量的直觉在于:较大的梯度意味着模型需要作出显著调整以适应新输入,表明该输入与模型过往所见差异较大,或是出乎预料,因此“令人惊讶”。
遗忘机制
Titans 架构中的遗忘机制是为有效管理长期神经记忆而设计的关键组件,确保模型在保留相关信息的同时丢弃不再需要的内容。
在处理海量数据时,这一机制尤为重要,否则记忆可能会被过时或无关信息占据。在实践中,遗忘机制通过调整记忆更新规则来有选择地擦除信息,依据推理过程中动态评估的“惊讶”程度与相关性来决定。
具体而言,一个自适应门控参数决定应保留多少先前的记忆状态,使模型能够自适应地清理或保留记忆内容。此类机制可防止记忆溢出并促进高效的记忆空间利用,最终提升模型聚焦关键且新颖输入的能力,而不会被不必要的数据积累所拖累。
这种方法与人类的认知过程高度相似:不重要或过时的记忆会随时间淡化,从而提升认知处理与信息检索的效率。
在推理时学习
在传统机器学习 模型中,学习发生在训练阶段。模型训练完毕后会被部署用于推理——基于新的、未见过的数据进行预测——而不会进一步修改其已学得的参数。
Titans 架构通过使模型在推理(也称测试)阶段动态学习,带来了范式上的重大转变。该能力允许 Titans 在处理数据的同时,基于输入数据的“惊讶”程度与重要性,更新其记忆与参数。
在推理时学习带来多项显著优势:
Titans 的记忆模式
Titans 架构采用三种不同方式融入记忆,分别受人类认知不同方面的启发。我们用简单的类比来逐一说明。
来源:Behrouz 等,2024
作为上下文的记忆(MAC)
想象您在开会时有一位私人助理。助理会做好以往对话的详尽笔记(长期记忆),并在需要时在您耳边低语相关信息(检索)。
在 MAC 模式下,AI 模型的工作方式与此类似。它保留过去数据的详细历史,并将其与当前输入整合以做出明智决策。正如助理将过往知识与当下讨论相结合以提升您的决策,MAC 利用长期记忆为正在处理的即时信息提供上下文。
作为门控的记忆(MAG)
设想您的脑海中有两位顾问。一位只关注当下,针对即时任务给出见解(短期注意力);另一位则汲取多年积累的经验与智慧(长期记忆)。
MAG 模式就像门卫,决定给每位顾问多少关注度,并根据当前需求与过往学习动态调整焦点。这样确保了平衡,使 AI 无论需要即时精度还是过往经验洞见,都能自如适应。
作为层的记忆(MAL)
可将此模式视为多层次的理解,每一层都以独特方式处理信息:
这种分层处理方式与我们消化复杂信息的阶段性过程相呼应,循序渐进地建立与完善理解。每种模式各有所长,使 Titans 能通过模拟人类处理与保留信息的不同方面,高效应对多样任务。
现实意义与实验成果
实验结果显示,Titans 架构在多项任务上优于传统 Transformer 与现代模型。以下为关键发现:
总体而言,Titans 采用新颖的记忆管理方法,使其能够更有效地处理复杂的长上下文任务,在可扩展性与准确性方面为 AI 模型树立了新标杆。
结语
当前的 Transformer 架构虽强大,但因扩展性问题在处理极长上下文时捉襟见肘。受人类记忆启发的 Titans 创新架构,通过动态管理短期、长期与持久性记忆,克服了这些限制。
我认为,Titans 在推理时学习、适应新数据,并基于“惊讶”机制进行记忆优先级排序的能力,具有让 AI 系统在信息处理方面更趋于“类人”的潜力。这将有望提升 AI 在复杂与动态环境中的表现,或将成为 OpenAI 的 Operator 等 AI 代理的变革力量。