In 2017 schudde Google de AI-gemeenschap op met de baanbrekende paper "Attention is All You Need." Deze paper introduceerde de Transformer-architectuur, die sequentiemodellering revolutioneerde met zelf-attentionmechanismen.
Onlangs publiceerde Google een nieuwe paper getiteld "Titans: Learning to Memorize at Test Time," waarin ze een nieuwe geheugenarchitectuur voorstellen die is ontworpen om te verbeteren hoe AI-systemen informatie opslaan en gebruiken.
Geïnspireerd door de fijnmazigheid van het menselijk geheugen wil dit onderzoek de beperkingen van bestaande geheugensystemen in AI-modellen overwinnen, met name het beperkte contextvenster van Transformers.
De Titans-architectuur introduceert een geraffineerde aanpak om verschillende soorten geheugen—kortetermijn, langetermijn en persistent—te integreren in AI-modellen, zodat ze tijdens testtijd dynamisch kunnen leren en memoriseren.
Het "verrassings"-mechanisme staat hierin centraal en is ontleend aan de neiging van het menselijk brein om onverwachte gebeurtenissen beter te onthouden. Deze architectuur laat modellen geheugen efficiënt beheren door momentane en eerdere verrassingen te benutten, zodat gegevens effectief worden opgeslagen en opgehaald.
In dit artikel vereenvoudig ik de concepten en mechanismen uit de Titans-paper en verken ik de mogelijke impact die deze nieuwe architectuur kan hebben op de toekomst van AI.
Transformers zijn de architectuur die in de meeste LLM's van vandaag wordt gebruikt. Ze staan bekend om hun vermogen om sequenties van data te verwerken, zoals woorden in een zin. Ze werken zeer effectief dankzij iets dat "attention" heet, waarmee ze zich kunnen richten op relevante delen van de data. Toch is er een belangrijk knelpunt: de grootte van hun contextvenster.
Het contextvenster is in wezen hoeveel informatie een Transformer in één keer kan overwegen. Zie het als een venster dat over een zin schuift en een segment woorden vastlegt om hun betekenis in context te begrijpen.
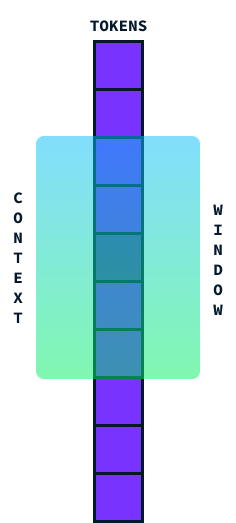
Idealiter willen we dit venster zo groot mogelijk maken om grote stukken tekst in één keer te verwerken, maar er is een addertje onder het gras. Als we het contextvenster groter maken, nemen de benodigde berekeningen sterk toe door de kwadratische tijd- en ruimtecomplexiteit van de transformerarchitectuur.
Dit betekent dat als we de grootte van het contextvenster verdubbelen, de rekentijd niet alleen verdubbelt—het wordt vier keer zo zwaar! Dit komt doordat elk woord in het venster met elk ander woord vergeleken moet worden, waardoor het aantal berekeningen snel groeit.
De huidige state-of-the-art (SOTA)-modellen hebben contextvensters van 2 miljoen tokens. Het verwerken daarvan is echter behoorlijk kostbaar, en sommige toepassingen, zoals videoverwerking, vereisen nog grotere contextvensters. Een langer contextvenster zonder enorme stijging in rekencapaciteit zou LLM's in staat stellen langere sequenties effectiever aan te pakken, wat de prestaties verbetert bij taken die vragen om het gelijktijdig begrijpen van grotere brokken data. Daarom is het oplossen van het kwadratische-kostenprobleem een hoofdprioriteit bij de verdere ontwikkeling van deze modellen.
Wat is de Titans-architectuur?
Titans is een nieuwe architectuur die het vermogen van AI-modellen om informatie effectief op te slaan en op te halen verbetert, vooral bij grote en complexe data, en is geïnspireerd op de complexiteit van het menselijk geheugen.
De inspiratie uit het menselijk geheugen
Geheugen speelt een cruciale rol in menselijk leren en gedrag. Het helpt ons informatie uit eerdere ervaringen te behouden, die we gebruiken om beslissingen te nemen, ons aan te passen aan nieuwe situaties en problemen op te lossen. Menselijk geheugen valt grofweg uiteen in drie typen:
- Kortetermijngeheugen: Dit is voor het verwerken van actuele informatie. Het is als een mentale werkplek waar we data die we nu nodig hebben tijdelijk opslaan en beheren, zoals een telefoonnummer net lang genoeg onthouden om het te bellen.
- Langetermijngeheugen: Dit slaat informatie voor langere perioden op. Het omvat onze kennis, vaardigheden en persoonlijke herinneringen, waardoor we ervaringen kunnen terughalen en ervan kunnen leren, zelfs jaren later.
- Metageheugen: Dit gaat over weten wat we weten. Het helpt ons in te schatten hoe goed we iets kunnen onthouden of uitvoeren, wat onze beslissingen en oordelen beïnvloedt.
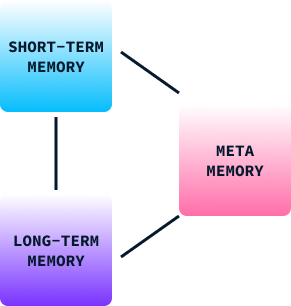
In menselijk gedrag werken deze geheugentypen samen zodat we van onze omgeving kunnen leren, strategieën kunnen aanpassen en ons gedrag in de tijd kunnen verbeteren. Zonder geheugen zouden we beperkt zijn tot basale reflexen en stereotiepe gedragingen.
De geheugenstructuur van Titans
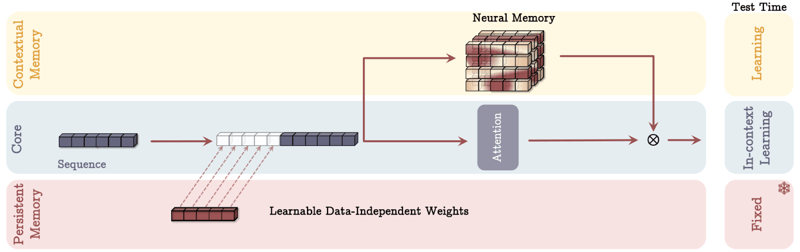
Net als het menselijk geheugenmodel bestaat de geheugenstructuur van Titans uit drie delen:
- Kortetermijngeheugen (core): Deze module richt zich op het verwerken van huidige taken, zodat de AI directe data nauwkeurig kan afhandelen. Net als het kortetermijngeheugen van het brein houdt deze component relevante informatie direct beschikbaar voor snelle verwerking, maar bewaart die niet voor onbepaalde tijd.
- Langetermijngeheugen: Dient als opslagplaats voor informatie over langere tijd. Deze module lijkt op het langetermijngeheugen bij mensen, dat ervaringen, kennis en herinneringen bewaart die niet meteen nodig zijn maar later belangrijk kunnen worden. Het stelt AI-modellen in staat om eerdere informatie effectief te onthouden en te raadplegen, wat cruciaal is voor taken die begrip van context over tijd vereisen.
- Persistent geheugen: Werkt als het metageheugen van het brein en embedt taakgerelateerde kennis in het model. Dit type geheugen omvat parameters die niet afhangen van de huidige input maar wel cruciaal zijn voor het begrijpen en uitvoeren van specifieke taken. Persistent geheugen zorgt ervoor dat geleerde patronen en raamwerken onderdeel van het model blijven, waardoor het beter eerdere leerervaringen kan toepassen op nieuwe situaties.
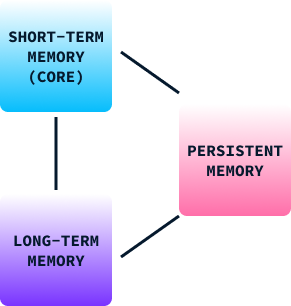
Door deze drie geheugentypen te integreren stelt de Titans-architectuur AI-modellen in staat om informatie dynamisch te beheren, vergelijkbaar met ons brein, waarbij directe verwerking wordt gecombineerd met het vasthouden van eerdere ervaringen en kennis.
Het "verrassings"-mechanisme
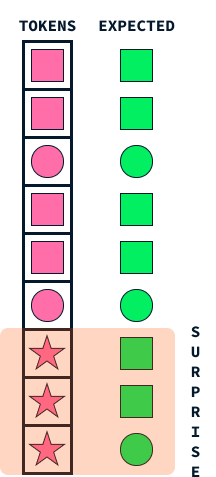
Het "verrassings"-mechanisme in Titans bootst een fundamenteel aspect van het menselijk geheugen na: onze neiging om verrassende of onverwachte gebeurtenissen levendiger te onthouden. Deze aanpak helpt AI-modellen bepalen welke informatie ze moeten opslaan door data te identificeren die afwijkt van wat het model verwacht.
Stel, je loopt over straat en alles is gewoon en routinematig. Grote kans dat je deze alledaagse wandeling een paar weken later niet meer herinnert. Maar als er iets onverwachts gebeurt, zoals een kleurrijke parade die voorbijtrekt of een telefoontje met spannend nieuws, trekken die verrassende elementen je aandacht en blijven ze beter hangen.
Op vergelijkbare wijze gebruikt Titans dit idee van verrassing om te prioriteren welke informatie onthouden wordt. Wanneer het model data tegenkomt die sterk afwijkt van wat het verwachtte (net als onze kleurrijke parade), markeert het die informatie als verrassend. Het geheugensysteem in Titans geeft vervolgens prioriteit aan het opslaan van deze onverwachte gebeurtenissen, zodat belangrijke maar ongewone data niet over het hoofd wordt gezien.
Dankzij dit mechanisme kan Titans zijn geheugenbronnen efficiënt beheren door zich te richten op significante uitschieters in plaats van te proberen elk detail te bewaren. Net zoals mensen het onverwachte eerder onthouden, past Titans deze natuurlijke strategie toe om essentiële informatie effectief te verwerken en te bewaren, waardoor het beter presteert op complexe taken waarbij enorme hoeveelheden data moeten worden doorgespit.
Formeel wordt het verrassingconcept gedefinieerd als de gradiënt van de verliesfunctie ten opzichte van de input. Dit meet in feite hoeveel de parameters van het model moeten veranderen als reactie op de nieuwe input om het verlies te minimaliseren.
De intuïtie achter het gebruik van de gradiënt als maat voor verrassing is dat een grote gradiënt impliceert dat er aanzienlijke aanpassingen in het model nodig zijn om de nieuwe input te accommoderen, wat aangeeft dat de input sterk verschilt van wat het model eerder heeft gezien of onverwacht is en dus verrassend.
Het vergeetmechanisme
Het vergeetmechanisme in de Titans-architectuur is een cruciaal onderdeel om langetermijn-neuraal geheugen effectief te beheren, zodat het model relevante informatie behoudt en overbodige informatie loslaat.
Dit mechanisme is van vitaal belang bij enorme hoeveelheden data, waar het geheugen mogelijk overspoeld raakt met verouderde of irrelevante informatie. In de praktijk werkt het vergeetmechanisme door de geheugen-update-regel aan te passen om selectief informatie te wissen op basis van de verrassingsfactor en relevantie, die tijdens inferentie dynamisch wordt beoordeeld.
Concreet bepaalt een adaptieve gating-parameter hoeveel van de vorige geheugentoestand behouden moet blijven, zodat het model geheugeninhoud adaptief kan wissen of bewaren. Zo'n mechanisme voorkomt geheugenoverloop en bevordert efficiënt gebruik van de geheugenruimte, wat het vermogen van het model vergroot om zich te richten op cruciale en nieuwe input zonder te verdrinken in een opstapeling van onnodige data.
Deze aanpak weerspiegelt nauw de menselijke cognitie, waarin onbelangrijke of verouderde herinneringen na verloop van tijd vervagen, wat efficiëntere verwerking en informatieopvraag mogelijk maakt.
Leren tijdens inferentie
In traditionele machine learning-modellen vindt leren plaats tijdens de trainingsfase. Zodra het model is getraind, wordt het ingezet voor inferentie—voorspellingen doen op basis van nieuwe, onzichtbare data—zonder verdere aanpassing van de geleerde parameters.
De Titans-architectuur introduceert een baanbrekende verschuiving in dit paradigma door modellen in staat te stellen dynamisch te leren tijdens inferentie, ook wel testtijd genoemd. Deze mogelijkheid laat Titans hun geheugen en parameters bijwerken op basis van de verrassing en het belang van binnenkomende data terwijl die verwerkt wordt.
Het vermogen om tijdens inferentie te leren biedt verschillende belangrijke voordelen:
- Dynamische aanpassing aan nieuwe data: Traditionele modellen zijn beperkt door het statische karakter van hun leren, omdat ze vertrouwen op vooraf vastgezette parameters op basis van historische trainingsdata. Titans kunnen zich in realtime aanpassen aan verschuivende patronen en nieuwe input door tijdens inferentie te leren, wat hun relevantie en nauwkeurigheid vergroot in veranderende omgevingen of bij onverwachte data.
- Verbeterde datarelevantie en geheugenbeheer: Door hun geheugen continu bij te werken tijdens testtijd, kunnen Titans prioriteit geven aan leren van data die als verrassend of afwijkend van de bestaande kennis wordt gezien. Dit dynamische geheugenbeheer weerspiegelt het vermogen van het menselijk brein om zich te concentreren op en nieuwe of belangrijke informatie te onthouden, terwijl het alledaagse wordt losgelaten, waardoor informatie-overload wordt voorkomen.
- Verbeterde generalisatie: Omdat Titans zijn begrip kan verfijnen op basis van live data, kan het beter generaliseren naar out-of-distribution data—inputs die niet in de oorspronkelijke trainingsset zaten. Deze capaciteit is belangrijk in realistische toepassingen waar inputs sterk afwijken van de trainingsdata.
- Grotere capaciteit voor langetermijnafhankelijkheden: Leren tijdens inferentie stelt Titans in staat langetermijnafhankelijkheden in data effectiever te herkennen en op te slaan. Dit is vooral waardevol voor taken met lange sequenties, zoals het begrijpen van lange teksten of video's.
- Toepasbaarheid in de echte wereld: Het leermechanisme tijdens inferentie laat Titans continu evolueren en nieuwe patronen en kennis opnemen zodra die opduiken. Deze eigenschap sluit nauw aan bij de eisen van realistische toepassingen, waar modellen relevant moeten blijven in dynamische en complexe dataomgevingen.
Geheugenmodi in Titans
De Titans-architectuur gebruikt drie verschillende manieren om geheugen te integreren, elk geïnspireerd op verschillende aspecten van menselijke cognitie. Laten we elke geheugenmodus eenvoudig doornemen.
Bron: Behrouz et. al, 2024
Geheugen als context (MAC)
Stel je voor dat je tijdens een vergadering een persoonlijke assistent hebt. Deze assistent maakt uitgebreide aantekeningen van eerdere gesprekken (langetermijngeheugen) en fluistert relevante informatie in je oor wanneer dat nodig is (ophalen).
In de MAC-modus werkt het AI-model vergelijkbaar. Het bewaart een gedetailleerde geschiedenis van eerdere data en integreert die met de huidige input om weloverwogen beslissingen te nemen. Net zoals je assistent eerdere kennis met het huidige gesprek verweeft om je besluitvorming te versterken, gebruikt MAC langetermijngeheugen om context te bieden aan de directe informatie die wordt verwerkt.
Geheugen als poort (MAG)
Stel je twee adviseurs in je hoofd voor. De een richt zich uitsluitend op wat er nu gebeurt en geeft inzichten voor directe taken (kortetermijnaandacht). De ander put uit jaren aan ervaring en wijsheid (langetermijngeheugen).
De MAG-modus fungeert als poortwachter die beslist hoeveel aandacht elke adviseur krijgt en past de focus dynamisch aan op basis van actuele behoeften versus eerdere kennis. Dit zorgt voor een gebalanceerde aanpak, zodat de AI zich kan aanpassen of de taak nu om directe precisie vraagt of om inzichten uit het verleden.
Geheugen als laag (MAL)
Zie deze modus als meerdere lagen van begrip, waarbij elke laag informatie op een unieke manier verwerkt:
- De eerste laag kan fungeren als een historisch filter dat zich richt op langetermijnpatronen en -herinneringen.
- De tweede laag adresseert directe contexten, zoals kortetermijnobservaties.
- Terwijl informatie door elke laag gaat, wordt die verfijnd en getransformeerd, zodat het model zowel de brede context als de details volledig begrijpt voordat het een beslissing neemt.
Deze gelaagde verwerking weerspiegelt hoe wij vaak complexe informatie in stappen verteren, waarbij we ons begrip stap voor stap opbouwen en aanscherpen. Elke modus biedt eigen sterke punten, waardoor Titans uiteenlopende taken effectief aankan door verschillende aspecten van hoe mensen informatie verwerken en onthouden na te bootsen.
Implicaties in de praktijk en experimenteel succes
De experimentele resultaten benadrukken de superioriteit van de Titans-architectuur ten opzichte van traditionele Transformers en moderne modellen op diverse taken. Hier zijn de belangrijkste bevindingen:
- Taalmodellering en gezond verstand-redeneren: Vooral de variant memory-as-context (MAC) laat sterke prestaties zien bij taalmodellering en taken rond gezond verstand.
- Naald-in-een-hooiberg-taken: Bij taken waarbij specifieke informatie uit lange sequenties moet worden opgehaald, excelleert Titans aanzienlijk.
- Grotere contexten afhandelen: Titans kan opschalen naar contextvensters groter dan 2 miljoen tokens zonder in te leveren op nauwkeurigheid, een substantiële verbetering ten opzichte van de huidige state-of-the-art.
- Tijdreeksvoorspelling: De neurale geheugenmodule binnen Titans presteert beter dan diverse baselines, waaronder Transformer-gebaseerde en lineaire modellen, bij forecasting-taken.
- DNA-modellering: De architectuur van Titans laat ook competitieve prestaties zien bij DNA-modelleringstaken, wat de veelzijdigheid buiten traditionele NLP-taken aantoont.
Kortom, Titans benut een nieuw geheugenbeheer waarmee complexe taken met lange context effectiever worden aangepakt en zet daarmee een nieuwe standaard voor AI-modellen op het gebied van schaalbaarheid en nauwkeurigheid.
Conclusie
De huidige Transformer-architectuur is krachtig, maar heeft moeite met extreem lange contexten door schaalbaarheidsproblemen. De innovatieve, door het menselijk geheugen geïnspireerde Titans-architectuur overwint deze beperkingen door kortetermijn-, langetermijn- en persistent geheugen dynamisch te beheren.
Ik denk dat Titans' vermogen om tijdens inferentie te leren, zich aan nieuwe data aan te passen en geheugen te prioriteren op basis van een "verrassings"-mechanisme, kan leiden tot AI-systemen die menselijker met informatie omgaan. Dit kan de prestaties van AI-systemen in complexe en dynamische omgevingen verbeteren en een gamechanger zijn voor AI-agenten zoals OpenAI’s Operator.




In 2017 schudde Google de AI-gemeenschap op met de baanbrekende paper "Attention is All You Need." Deze paper introduceerde de Transformer-architectuur, die sequentiemodellering revolutioneerde met zelf-attentionmechanismen.
Onlangs publiceerde Google een nieuwe paper getiteld "Titans: Learning to Memorize at Test Time," waarin ze een nieuwe geheugenarchitectuur voorstellen die is ontworpen om te verbeteren hoe AI-systemen informatie opslaan en gebruiken.
Geïnspireerd door de fijnmazigheid van het menselijk geheugen wil dit onderzoek de beperkingen van bestaande geheugensystemen in AI-modellen overwinnen, met name het beperkte contextvenster van Transformers.
De Titans-architectuur introduceert een geraffineerde aanpak om verschillende soorten geheugen—kortetermijn, langetermijn en persistent—te integreren in AI-modellen, zodat ze tijdens testtijd dynamisch kunnen leren en memoriseren.
Het "verrassings"-mechanisme staat hierin centraal en is ontleend aan de neiging van het menselijk brein om onverwachte gebeurtenissen beter te onthouden. Deze architectuur laat modellen geheugen efficiënt beheren door momentane en eerdere verrassingen te benutten, zodat gegevens effectief worden opgeslagen en opgehaald.
In dit artikel vereenvoudig ik de concepten en mechanismen uit de Titans-paper en verken ik de mogelijke impact die deze nieuwe architectuur kan hebben op de toekomst van AI.
Het probleem met de huidige Transformer-architectuur
Transformers zijn de architectuur die in de meeste LLM's van vandaag wordt gebruikt. Ze staan bekend om hun vermogen om sequenties van data te verwerken, zoals woorden in een zin. Ze werken zeer effectief dankzij iets dat "attention" heet, waarmee ze zich kunnen richten op relevante delen van de data. Toch is er een belangrijk knelpunt: de grootte van hun contextvenster.
Het contextvenster is in wezen hoeveel informatie een Transformer in één keer kan overwegen. Zie het als een venster dat over een zin schuift en een segment woorden vastlegt om hun betekenis in context te begrijpen.
Idealiter willen we dit venster zo groot mogelijk maken om grote stukken tekst in één keer te verwerken, maar er is een addertje onder het gras. Als we het contextvenster groter maken, nemen de benodigde berekeningen sterk toe door de kwadratische tijd- en ruimtecomplexiteit van de transformerarchitectuur.
Dit betekent dat als we de grootte van het contextvenster verdubbelen, de rekentijd niet alleen verdubbelt—het wordt vier keer zo zwaar! Dit komt doordat elk woord in het venster met elk ander woord vergeleken moet worden, waardoor het aantal berekeningen snel groeit.
De huidige state-of-the-art (SOTA)-modellen hebben contextvensters van 2 miljoen tokens. Het verwerken daarvan is echter behoorlijk kostbaar, en sommige toepassingen, zoals videoverwerking, vereisen nog grotere contextvensters. Een langer contextvenster zonder enorme stijging in rekencapaciteit zou LLM's in staat stellen langere sequenties effectiever aan te pakken, wat de prestaties verbetert bij taken die vragen om het gelijktijdig begrijpen van grotere brokken data. Daarom is het oplossen van het kwadratische-kostenprobleem een hoofdprioriteit bij de verdere ontwikkeling van deze modellen.
Wat is de Titans-architectuur?
Titans is een nieuwe architectuur die het vermogen van AI-modellen om informatie effectief op te slaan en op te halen verbetert, vooral bij grote en complexe data, en is geïnspireerd op de complexiteit van het menselijk geheugen.
De inspiratie uit het menselijk geheugen
Geheugen speelt een cruciale rol in menselijk leren en gedrag. Het helpt ons informatie uit eerdere ervaringen te behouden, die we gebruiken om beslissingen te nemen, ons aan te passen aan nieuwe situaties en problemen op te lossen. Menselijk geheugen valt grofweg uiteen in drie typen:
In menselijk gedrag werken deze geheugentypen samen zodat we van onze omgeving kunnen leren, strategieën kunnen aanpassen en ons gedrag in de tijd kunnen verbeteren. Zonder geheugen zouden we beperkt zijn tot basale reflexen en stereotiepe gedragingen.
De geheugenstructuur van Titans
Net als het menselijk geheugenmodel bestaat de geheugenstructuur van Titans uit drie delen:
Door deze drie geheugentypen te integreren stelt de Titans-architectuur AI-modellen in staat om informatie dynamisch te beheren, vergelijkbaar met ons brein, waarbij directe verwerking wordt gecombineerd met het vasthouden van eerdere ervaringen en kennis.
Het "verrassings"-mechanisme
Het "verrassings"-mechanisme in Titans bootst een fundamenteel aspect van het menselijk geheugen na: onze neiging om verrassende of onverwachte gebeurtenissen levendiger te onthouden. Deze aanpak helpt AI-modellen bepalen welke informatie ze moeten opslaan door data te identificeren die afwijkt van wat het model verwacht.
Stel, je loopt over straat en alles is gewoon en routinematig. Grote kans dat je deze alledaagse wandeling een paar weken later niet meer herinnert. Maar als er iets onverwachts gebeurt, zoals een kleurrijke parade die voorbijtrekt of een telefoontje met spannend nieuws, trekken die verrassende elementen je aandacht en blijven ze beter hangen.
Op vergelijkbare wijze gebruikt Titans dit idee van verrassing om te prioriteren welke informatie onthouden wordt. Wanneer het model data tegenkomt die sterk afwijkt van wat het verwachtte (net als onze kleurrijke parade), markeert het die informatie als verrassend. Het geheugensysteem in Titans geeft vervolgens prioriteit aan het opslaan van deze onverwachte gebeurtenissen, zodat belangrijke maar ongewone data niet over het hoofd wordt gezien.
Dankzij dit mechanisme kan Titans zijn geheugenbronnen efficiënt beheren door zich te richten op significante uitschieters in plaats van te proberen elk detail te bewaren. Net zoals mensen het onverwachte eerder onthouden, past Titans deze natuurlijke strategie toe om essentiële informatie effectief te verwerken en te bewaren, waardoor het beter presteert op complexe taken waarbij enorme hoeveelheden data moeten worden doorgespit.
Formeel wordt het verrassingconcept gedefinieerd als de gradiënt van de verliesfunctie ten opzichte van de input. Dit meet in feite hoeveel de parameters van het model moeten veranderen als reactie op de nieuwe input om het verlies te minimaliseren.
De intuïtie achter het gebruik van de gradiënt als maat voor verrassing is dat een grote gradiënt impliceert dat er aanzienlijke aanpassingen in het model nodig zijn om de nieuwe input te accommoderen, wat aangeeft dat de input sterk verschilt van wat het model eerder heeft gezien of onverwacht is en dus verrassend.
Het vergeetmechanisme
Het vergeetmechanisme in de Titans-architectuur is een cruciaal onderdeel om langetermijn-neuraal geheugen effectief te beheren, zodat het model relevante informatie behoudt en overbodige informatie loslaat.
Dit mechanisme is van vitaal belang bij enorme hoeveelheden data, waar het geheugen mogelijk overspoeld raakt met verouderde of irrelevante informatie. In de praktijk werkt het vergeetmechanisme door de geheugen-update-regel aan te passen om selectief informatie te wissen op basis van de verrassingsfactor en relevantie, die tijdens inferentie dynamisch wordt beoordeeld.
Concreet bepaalt een adaptieve gating-parameter hoeveel van de vorige geheugentoestand behouden moet blijven, zodat het model geheugeninhoud adaptief kan wissen of bewaren. Zo'n mechanisme voorkomt geheugenoverloop en bevordert efficiënt gebruik van de geheugenruimte, wat het vermogen van het model vergroot om zich te richten op cruciale en nieuwe input zonder te verdrinken in een opstapeling van onnodige data.
Deze aanpak weerspiegelt nauw de menselijke cognitie, waarin onbelangrijke of verouderde herinneringen na verloop van tijd vervagen, wat efficiëntere verwerking en informatieopvraag mogelijk maakt.
Leren tijdens inferentie
In traditionele machine learning-modellen vindt leren plaats tijdens de trainingsfase. Zodra het model is getraind, wordt het ingezet voor inferentie—voorspellingen doen op basis van nieuwe, onzichtbare data—zonder verdere aanpassing van de geleerde parameters.
De Titans-architectuur introduceert een baanbrekende verschuiving in dit paradigma door modellen in staat te stellen dynamisch te leren tijdens inferentie, ook wel testtijd genoemd. Deze mogelijkheid laat Titans hun geheugen en parameters bijwerken op basis van de verrassing en het belang van binnenkomende data terwijl die verwerkt wordt.
Het vermogen om tijdens inferentie te leren biedt verschillende belangrijke voordelen:
Geheugenmodi in Titans
De Titans-architectuur gebruikt drie verschillende manieren om geheugen te integreren, elk geïnspireerd op verschillende aspecten van menselijke cognitie. Laten we elke geheugenmodus eenvoudig doornemen.
Bron: Behrouz et. al, 2024
Geheugen als context (MAC)
Stel je voor dat je tijdens een vergadering een persoonlijke assistent hebt. Deze assistent maakt uitgebreide aantekeningen van eerdere gesprekken (langetermijngeheugen) en fluistert relevante informatie in je oor wanneer dat nodig is (ophalen).
In de MAC-modus werkt het AI-model vergelijkbaar. Het bewaart een gedetailleerde geschiedenis van eerdere data en integreert die met de huidige input om weloverwogen beslissingen te nemen. Net zoals je assistent eerdere kennis met het huidige gesprek verweeft om je besluitvorming te versterken, gebruikt MAC langetermijngeheugen om context te bieden aan de directe informatie die wordt verwerkt.
Geheugen als poort (MAG)
Stel je twee adviseurs in je hoofd voor. De een richt zich uitsluitend op wat er nu gebeurt en geeft inzichten voor directe taken (kortetermijnaandacht). De ander put uit jaren aan ervaring en wijsheid (langetermijngeheugen).
De MAG-modus fungeert als poortwachter die beslist hoeveel aandacht elke adviseur krijgt en past de focus dynamisch aan op basis van actuele behoeften versus eerdere kennis. Dit zorgt voor een gebalanceerde aanpak, zodat de AI zich kan aanpassen of de taak nu om directe precisie vraagt of om inzichten uit het verleden.
Geheugen als laag (MAL)
Zie deze modus als meerdere lagen van begrip, waarbij elke laag informatie op een unieke manier verwerkt:
Deze gelaagde verwerking weerspiegelt hoe wij vaak complexe informatie in stappen verteren, waarbij we ons begrip stap voor stap opbouwen en aanscherpen. Elke modus biedt eigen sterke punten, waardoor Titans uiteenlopende taken effectief aankan door verschillende aspecten van hoe mensen informatie verwerken en onthouden na te bootsen.
Implicaties in de praktijk en experimenteel succes
De experimentele resultaten benadrukken de superioriteit van de Titans-architectuur ten opzichte van traditionele Transformers en moderne modellen op diverse taken. Hier zijn de belangrijkste bevindingen:
Kortom, Titans benut een nieuw geheugenbeheer waarmee complexe taken met lange context effectiever worden aangepakt en zet daarmee een nieuwe standaard voor AI-modellen op het gebied van schaalbaarheid en nauwkeurigheid.
Conclusie
De huidige Transformer-architectuur is krachtig, maar heeft moeite met extreem lange contexten door schaalbaarheidsproblemen. De innovatieve, door het menselijk geheugen geïnspireerde Titans-architectuur overwint deze beperkingen door kortetermijn-, langetermijn- en persistent geheugen dynamisch te beheren.
Ik denk dat Titans' vermogen om tijdens inferentie te leren, zich aan nieuwe data aan te passen en geheugen te prioriteren op basis van een "verrassings"-mechanisme, kan leiden tot AI-systemen die menselijker met informatie omgaan. Dit kan de prestaties van AI-systemen in complexe en dynamische omgevingen verbeteren en een gamechanger zijn voor AI-agenten zoals OpenAI’s Operator.