Pada 2017, Google mengguncang komunitas AI dengan makalah terobosannya "Attention is All You Need." Makalah ini memperkenalkan arsitektur Transformer, yang merevolusi pemodelan sekuens dengan menggunakan mekanisme self-attention.
Baru-baru ini, Google merilis makalah baru berjudul "Titans: Learning to Memorize at Test Time," yang mengusulkan arsitektur memori baru untuk meningkatkan cara sistem AI menyimpan dan memanfaatkan informasi.
Terinspirasi dari kompleksitas memori manusia, riset ini bertujuan mengatasi keterbatasan sistem memori yang ada pada model AI, khususnya jendela konteks Transformer yang terbatas.
Arsitektur Titans memperkenalkan pendekatan canggih untuk mengintegrasikan berbagai jenis memori—jangka pendek, jangka panjang, dan persisten—ke dalam model AI, sehingga memungkinkan pembelajaran dan penghafalan secara dinamis saat waktu pengujian.
Mekanisme "kejutan" menjadi pusat pendekatan ini, yang diambil dari kecenderungan otak manusia untuk mengingat peristiwa yang tak terduga. Arsitektur ini memungkinkan model mengelola memori secara efisien dengan memasukkan kejutan sesaat dan masa lalu, memastikan penyimpanan dan pengambilan data yang efektif.
Dalam artikel ini, saya akan menyederhanakan konsep dan mekanisme yang diperkenalkan dalam makalah Titans dan meninjau potensi dampaknya terhadap masa depan AI.
Transformer adalah arsitektur yang digunakan di sebagian besar LLM saat ini. Transformer dikenal karena kemampuannya memproses sekuens data, seperti kata dalam sebuah kalimat. Transformer bekerja sangat efektif dengan menggunakan sesuatu yang disebut "attention", yang membantu memfokuskan perhatian pada bagian data yang relevan. Namun, ada tantangan utama: ukuran jendela konteksnya.
Jendela konteks pada dasarnya adalah seberapa banyak informasi yang dapat dipertimbangkan Transformer sekaligus. Bayangkan jendela yang bergerak sepanjang sebuah kalimat, menangkap segmen kata untuk memahami maknanya dalam konteks.
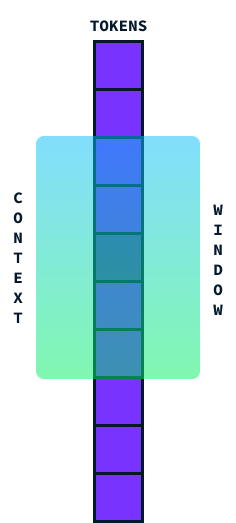
Idealnya, kita ingin jendela ini sebesar mungkin agar dapat memproses bagian teks yang besar sekaligus, tetapi ada kendala. Saat kita mencoba memperbesar jendela konteks, kebutuhan komputasi meningkat secara signifikan karena kompleksitas waktu dan ruang kuadratik dari arsitektur Transformer.
Artinya, jika kita menggandakan ukuran jendela konteks, komputasi yang dibutuhkan tidak hanya menjadi dua kali lipat—tetapi menjadi empat kali lebih berat! Ini terjadi karena setiap kata dalam jendela perlu dibandingkan dengan setiap kata lainnya, sehingga jumlah perhitungan meningkat dengan cepat.
Model mutakhir (SOTA) saat ini memiliki jendela konteks 2 juta token. Namun, pemrosesannya sangat mahal, dan beberapa aplikasi, seperti pemahaman video, membutuhkan jendela konteks yang lebih besar. Memiliki jendela konteks yang lebih panjang tanpa lonjakan biaya komputasi besar akan memungkinkan LLM menangani sekuens yang lebih panjang dengan lebih efektif, meningkatkan kinerja pada tugas yang memerlukan pemahaman bagian data yang lebih besar sekaligus. Inilah sebabnya mengapa mengatasi biaya kuadratik menjadi fokus utama dalam pengembangan model-model ini.
Apa Itu Arsitektur Titans?
Titans adalah arsitektur baru yang meningkatkan kemampuan model AI untuk menyimpan dan mengambil informasi secara efektif, terutama saat menangani data yang besar dan kompleks, dengan meniru kompleksitas memori manusia.
Inspirasi dari memori manusia
Memori berperan penting dalam pembelajaran dan perilaku manusia. Memori membantu kita mempertahankan informasi dari pengalaman masa lalu, yang kita gunakan untuk membuat keputusan, beradaptasi dengan situasi baru, dan memecahkan masalah. Secara garis besar, memori manusia dapat dikategorikan menjadi tiga jenis:
- Memori jangka pendek: Untuk memproses informasi saat ini. Ini seperti ruang kerja mental tempat kita menyimpan dan mengelola data yang dibutuhkan sekarang, misalnya mengingat nomor telepon cukup lama untuk menekannya.
- Memori jangka panjang: Menyimpan informasi dalam jangka waktu yang lama. Ini mencakup pengetahuan, keterampilan, dan memori personal, memungkinkan kita mengingat pengalaman dan belajar darinya bahkan bertahun-tahun kemudian.
- Meta-memori: Kesadaran tentang apa yang kita ketahui. Ini membantu kita menilai seberapa baik kita dapat mengingat atau melakukan sebuah tugas, yang memengaruhi keputusan dan penilaian.
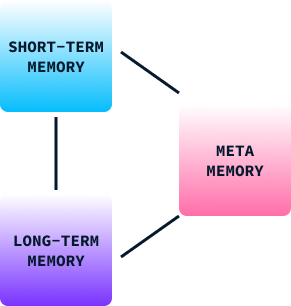
Dalam perilaku manusia, ketiga jenis memori ini bekerja bersama agar kita dapat belajar dari lingkungan, menyesuaikan strategi, dan meningkatkan perilaku seiring waktu. Tanpanya, kita akan terbatas pada refleks dasar dan perilaku yang stereotip.
Struktur memori pada Titans
Sama seperti model memori manusia, struktur memori Titans terdiri dari tiga bagian:
- Memori jangka pendek (inti): Modul ini berfokus pada pemrosesan tugas saat ini, memungkinkan AI menangani data langsung dengan presisi. Mirip dengan memori jangka pendek di otak, komponen ini menjaga informasi relevan tetap mudah diakses untuk pemrosesan cepat, tetapi tidak menyimpannya secara permanen.
- Memori jangka panjang: Berfungsi sebagai repositori untuk menyimpan informasi dalam jangka panjang. Modul ini mirip dengan memori jangka panjang pada manusia, yang menyimpan pengalaman, pengetahuan, dan memori yang tidak segera dibutuhkan tetapi dapat menjadi penting di masa depan. Ini memungkinkan model AI mengingat dan mengakses informasi masa lalu secara efektif, yang krusial untuk tugas yang memerlukan pemahaman konteks dari waktu ke waktu.
- Memori persisten: Bertindak seperti meta-memori otak, menanamkan pengetahuan terkait tugas di dalam model. Jenis memori ini melibatkan parameter yang tidak bergantung pada masukan saat ini tetapi penting untuk memahami dan menjalankan tugas tertentu. Memori persisten memastikan pola dan kerangka kerja yang telah dipelajari tetap menjadi bagian dari model, meningkatkan kemampuannya menerapkan pembelajaran masa lalu pada situasi baru.
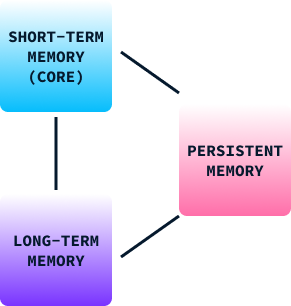
Dengan mengintegrasikan ketiga jenis memori ini, arsitektur Titans memungkinkan model AI mengelola informasi secara dinamis seperti halnya otak kita, memadukan pemrosesan langsung dengan retensi pengalaman dan pengetahuan masa lalu.
Mekanisme "Kejutan"
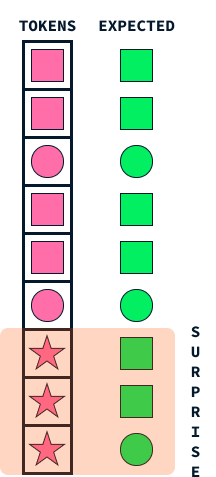
Mekanisme "kejutan" pada Titans meniru aspek mendasar memori manusia: kecenderungan kita untuk mengingat peristiwa yang mengejutkan atau tak terduga dengan lebih jelas. Pendekatan ini membantu model AI memutuskan informasi apa yang perlu disimpan dengan mengidentifikasi data yang menyimpang dari apa yang diharapkan model.
Bayangkan Anda berjalan di jalan dan semuanya tampak biasa dan rutin. Anda mungkin tidak mengingat jalan-jalan biasa ini beberapa minggu kemudian. Namun, jika terjadi sesuatu yang tak terduga, seperti pawai berwarna-warni lewat atau menerima panggilan telepon dengan kabar menggembirakan, unsur kejutan ini menarik perhatian Anda, membuatnya lebih mudah diingat.
Demikian pula, Titans menggunakan gagasan kejutan ini untuk memprioritaskan informasi mana yang akan diingat. Ketika model menemui data yang sangat berbeda dari yang diantisipasi (seperti pawai berwarna-warni kita), model menandai informasi ini sebagai mengejutkan. Sistem memori di Titans kemudian memprioritaskan penyimpanan peristiwa tak terduga tersebut, memastikan data penting yang tidak biasa tidak terlewat.
Mekanisme ini memungkinkan Titans mengelola sumber daya memorinya secara efisien dengan berfokus pada informasi penting yang menyimpang, alih-alih mencoba mempertahankan setiap detail. Sama seperti manusia yang lebih mudah mengingat hal yang tak terduga, Titans menerapkan strategi alami ini untuk memproses dan menyimpan informasi penting secara efektif, sehingga berperforma lebih baik pada tugas kompleks yang melibatkan penyaringan data dalam jumlah besar.
Secara formal, konsep kejutan didefinisikan sebagai gradien dari fungsi loss terhadap input. Ini pada dasarnya mengukur sejauh mana parameter model perlu diubah sebagai respons terhadap input baru untuk meminimalkan loss.
Intuisi di balik penggunaan gradien sebagai ukuran kejutan adalah bahwa gradien yang besar menunjukkan perlunya perubahan signifikan pada model untuk mengakomodasi input baru, menandakan bahwa input tersebut cukup berbeda dari yang pernah dilihat model sebelumnya atau tidak terduga dan karena itu mengejutkan.
Mekanisme Pelupaan
Mekanisme pelupaan dalam arsitektur Titans adalah komponen kritis yang dirancang untuk mengelola memori saraf jangka panjang secara efektif, memastikan model mempertahankan informasi relevan sambil membuang yang tidak lagi dibutuhkan.
Mekanisme ini vital saat menangani data dalam jumlah besar, ketika memori berpotensi kewalahan oleh informasi usang atau tidak relevan. Dalam praktiknya, mekanisme pelupaan bekerja dengan menyesuaikan aturan pembaruan memori untuk menghapus informasi secara selektif berdasarkan faktor kejutan dan relevansinya, yang dinilai secara dinamis selama inferensi.
Secara khusus, parameter gating adaptif menentukan seberapa banyak keadaan memori sebelumnya harus dipertahankan, memungkinkan model mengosongkan atau menjaga konten memori secara adaptif. Mekanisme seperti ini mencegah memori meluap dan mendorong pemanfaatan ruang memori yang efisien, pada akhirnya meningkatkan kemampuan model untuk fokus pada masukan yang penting dan baru tanpa terbebani akumulasi data yang tidak perlu.
Pendekatan ini sangat mirip dengan proses kognitif manusia, di mana memori yang tidak penting atau usang memudar seiring waktu, sehingga pemrosesan kognitif dan pengambilan informasi menjadi lebih efisien.
Belajar pada Waktu Inferensi
Dalam pembelajaran mesin tradisional, pembelajaran terjadi pada fase pelatihan. Setelah model dilatih, model digunakan untuk melakukan inferensi—membuat prediksi berdasarkan data baru yang belum pernah dilihat—tanpa modifikasi lebih lanjut pada parameter yang telah dipelajari.
Arsitektur Titans memperkenalkan pergeseran paradigma yang penting dengan memungkinkan model belajar secara dinamis selama inferensi, juga dikenal sebagai waktu pengujian. Kemampuan ini memungkinkan Titans memperbarui memori dan parameternya berdasarkan tingkat kejutan dan signifikansi data yang masuk saat data tersebut diproses.
Kemampuan untuk belajar saat inferensi memberikan beberapa keuntungan penting:
- Adaptasi dinamis terhadap data baru: Model tradisional dibatasi oleh sifat pembelajarannya yang statis, karena bergantung pada parameter yang dipatok berdasarkan data pelatihan historis. Dengan belajar saat inferensi, Titans dapat beradaptasi dengan pola yang berubah dan masukan baru secara real time, meningkatkan relevansi dan akurasi saat menghadapi lingkungan yang berubah atau data yang tak terduga.
- Peningkatan relevansi data dan pengelolaan memori: Dengan terus memperbarui memorinya saat waktu pengujian, Titans dapat memprioritaskan pembelajaran dari data yang dianggap mengejutkan atau berbeda dari pengetahuan yang ada. Manajemen memori dinamis ini meniru kemampuan otak untuk memfokuskan dan mengingat informasi baru atau penting sambil mengabaikan hal yang biasa, sehingga mencegah kelebihan informasi.
- Generalisasi yang lebih baik: Karena Titans dapat menyempurnakan pemahamannya berdasarkan data langsung, Titans dapat melakukan generalisasi lebih baik pada data di luar distribusi—masukan yang tidak termasuk dalam set pelatihan awal. Kemampuan ini penting dalam aplikasi dunia nyata di mana masukan dapat sangat berbeda dari data pelatihan.
- Kapasitas lebih tinggi untuk ketergantungan jangka panjang: Pembelajaran saat inferensi memungkinkan Titans mengenali dan menyimpan ketergantungan jangka panjang dalam data dengan lebih efektif. Hal ini sangat bermanfaat untuk tugas yang memerlukan pemrosesan sekuens panjang, seperti memahami teks atau video yang panjang.
- Keterterapan di dunia nyata: Mekanisme pembelajaran saat inferensi memungkinkan Titans terus berkembang, mempelajari pola dan pengetahuan baru seiring kemunculannya. Fitur ini selaras dengan tuntutan aplikasi dunia nyata di mana model harus tetap relevan dalam lingkungan data yang dinamis dan kompleks.
Mode Memori di Titans
Arsitektur Titans menggunakan tiga cara berbeda untuk memasukkan memori, masing-masing terinspirasi dari aspek kognisi manusia. Mari uraikan setiap mode memori dengan analogi sederhana.
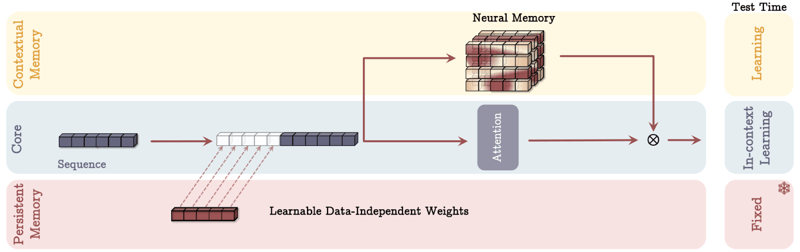
Sumber: Behrouz et. al, 2024
Memori sebagai konteks (MAC)
Bayangkan Anda memiliki asisten pribadi selama rapat. Asisten ini mencatat secara lengkap percakapan sebelumnya (memori jangka panjang) dan membisikkan potongan informasi yang relevan ke telinga Anda sesuai kebutuhan (retrieval).
Dalam mode MAC, model AI berfungsi serupa. Model mempertahankan riwayat data masa lalu yang terperinci dan mengintegrasikannya dengan masukan saat ini untuk membuat keputusan yang tepat. Seperti asisten Anda yang membantu memadukan pengetahuan masa lalu dengan diskusi saat ini untuk meningkatkan pengambilan keputusan, MAC menggunakan memori jangka panjang untuk memberikan konteks pada informasi langsung yang sedang diproses.
Memori sebagai gerbang (MAG)
Bayangkan ada dua penasihat dalam benak Anda. Satu berfokus hanya pada apa yang terjadi sekarang, memberikan wawasan tentang tugas langsung (perhatian jangka pendek). Yang lain menarik dari pengalaman dan kebijaksanaan yang terakumulasi selama bertahun-tahun (memori jangka panjang).
Mode MAG bertindak seperti penjaga gerbang yang memutuskan seberapa banyak perhatian yang diberikan kepada masing-masing penasihat, menyesuaikan fokus secara dinamis berdasarkan kebutuhan saat ini versus pembelajaran masa lalu. Ini memastikan pendekatan yang seimbang, memungkinkan AI beradaptasi apakah tugas yang dihadapi memerlukan presisi langsung atau wawasan dari pengalaman masa lalu.
Memori sebagai lapisan (MAL)
Anggap mode ini sebagai beberapa lapisan pemahaman, di mana setiap lapisan memproses informasi secara unik:
- Lapisan pertama dapat bertindak sebagai penyaring historis, berfokus pada pola dan memori jangka panjang.
- Lapisan kedua menangani konteks langsung, seperti pengamatan jangka pendek.
- Saat informasi melewati setiap lapisan, informasi tersebut disaring dan diubah, memastikan model memahami secara menyeluruh baik konteks luas maupun detail halus sebelum membuat keputusan.
Pemrosesan berlapis ini mencerminkan cara kita sering mencerna informasi kompleks secara bertahap, membangun dan menyempurnakan pemahaman selangkah demi selangkah. Setiap mode menawarkan kekuatan unik, memungkinkan Titans menangani berbagai tugas secara efektif dengan meniru berbagai aspek cara manusia memproses dan mempertahankan informasi.
Implikasi Dunia Nyata dan Keberhasilan Eksperimental
Hasil eksperimen menyoroti keunggulan arsitektur Titans dibanding Transformer tradisional dan model modern dalam berbagai tugas. Berikut ringkasan temuan utamanya:
- Pemodelan bahasa dan penalaran common-sense: Titans, khususnya varian memory-as-context (MAC), menunjukkan kinerja kuat dalam tugas pemodelan bahasa dan penalaran common-sense.
- Tugas needle in a haystack: Dalam tugas yang melibatkan pengambilan potongan informasi spesifik dari sekuens panjang, yang dikenal sebagai needle-in-a-haystack, Titans unggul secara signifikan.
- Menangani konteks yang lebih besar: Titans mampu menskalakan ke ukuran jendela konteks lebih dari 2 juta token tanpa mengorbankan akurasi, yang merupakan peningkatan substansial dibanding model mutakhir saat ini.
- Peramalan deret waktu: Modul memori saraf dalam Titans melampaui berbagai baseline, termasuk model berbasis Transformer dan model linear, dalam tugas peramalan.
- Pemodelan DNA: Arsitektur Titans juga menunjukkan kinerja kompetitif dalam tugas pemodelan DNA, membuktikan versatilitasnya di luar tugas pemrosesan bahasa alami tradisional.
Secara keseluruhan, Titans memanfaatkan pendekatan manajemen memori baru yang memungkinkan penanganan tugas kompleks dengan konteks panjang secara lebih efektif, menetapkan standar baru bagi model AI dalam hal skalabilitas dan akurasi.
Kesimpulan
Arsitektur Transformer saat ini, meski kuat, kesulitan menangani konteks yang sangat panjang karena masalah penskalaan. Arsitektur inovatif Titans, yang terinspirasi dari memori manusia, mengatasi keterbatasan ini dengan mengelola memori jangka pendek, jangka panjang, dan persisten secara dinamis.
Saya percaya kemampuan Titans untuk belajar pada waktu inferensi, beradaptasi dengan data baru, dan memprioritaskan memori berdasarkan mekanisme "kejutan" berpotensi menciptakan sistem AI yang lebih mirip manusia dalam memproses informasi. Ini dapat meningkatkan kinerja sistem AI di lingkungan yang kompleks dan dinamis, yang bisa menjadi pengubah permainan bagi agen AI seperti Operator OpenAI.





Pada 2017, Google mengguncang komunitas AI dengan makalah terobosannya "Attention is All You Need." Makalah ini memperkenalkan arsitektur Transformer, yang merevolusi pemodelan sekuens dengan menggunakan mekanisme self-attention.
Baru-baru ini, Google merilis makalah baru berjudul "Titans: Learning to Memorize at Test Time," yang mengusulkan arsitektur memori baru untuk meningkatkan cara sistem AI menyimpan dan memanfaatkan informasi.
Terinspirasi dari kompleksitas memori manusia, riset ini bertujuan mengatasi keterbatasan sistem memori yang ada pada model AI, khususnya jendela konteks Transformer yang terbatas.
Arsitektur Titans memperkenalkan pendekatan canggih untuk mengintegrasikan berbagai jenis memori—jangka pendek, jangka panjang, dan persisten—ke dalam model AI, sehingga memungkinkan pembelajaran dan penghafalan secara dinamis saat waktu pengujian.
Mekanisme "kejutan" menjadi pusat pendekatan ini, yang diambil dari kecenderungan otak manusia untuk mengingat peristiwa yang tak terduga. Arsitektur ini memungkinkan model mengelola memori secara efisien dengan memasukkan kejutan sesaat dan masa lalu, memastikan penyimpanan dan pengambilan data yang efektif.
Dalam artikel ini, saya akan menyederhanakan konsep dan mekanisme yang diperkenalkan dalam makalah Titans dan meninjau potensi dampaknya terhadap masa depan AI.
Masalah pada Arsitektur Transformer Saat Ini
Transformer adalah arsitektur yang digunakan di sebagian besar LLM saat ini. Transformer dikenal karena kemampuannya memproses sekuens data, seperti kata dalam sebuah kalimat. Transformer bekerja sangat efektif dengan menggunakan sesuatu yang disebut "attention", yang membantu memfokuskan perhatian pada bagian data yang relevan. Namun, ada tantangan utama: ukuran jendela konteksnya.
Jendela konteks pada dasarnya adalah seberapa banyak informasi yang dapat dipertimbangkan Transformer sekaligus. Bayangkan jendela yang bergerak sepanjang sebuah kalimat, menangkap segmen kata untuk memahami maknanya dalam konteks.
Idealnya, kita ingin jendela ini sebesar mungkin agar dapat memproses bagian teks yang besar sekaligus, tetapi ada kendala. Saat kita mencoba memperbesar jendela konteks, kebutuhan komputasi meningkat secara signifikan karena kompleksitas waktu dan ruang kuadratik dari arsitektur Transformer.
Artinya, jika kita menggandakan ukuran jendela konteks, komputasi yang dibutuhkan tidak hanya menjadi dua kali lipat—tetapi menjadi empat kali lebih berat! Ini terjadi karena setiap kata dalam jendela perlu dibandingkan dengan setiap kata lainnya, sehingga jumlah perhitungan meningkat dengan cepat.
Model mutakhir (SOTA) saat ini memiliki jendela konteks 2 juta token. Namun, pemrosesannya sangat mahal, dan beberapa aplikasi, seperti pemahaman video, membutuhkan jendela konteks yang lebih besar. Memiliki jendela konteks yang lebih panjang tanpa lonjakan biaya komputasi besar akan memungkinkan LLM menangani sekuens yang lebih panjang dengan lebih efektif, meningkatkan kinerja pada tugas yang memerlukan pemahaman bagian data yang lebih besar sekaligus. Inilah sebabnya mengapa mengatasi biaya kuadratik menjadi fokus utama dalam pengembangan model-model ini.
Apa Itu Arsitektur Titans?
Titans adalah arsitektur baru yang meningkatkan kemampuan model AI untuk menyimpan dan mengambil informasi secara efektif, terutama saat menangani data yang besar dan kompleks, dengan meniru kompleksitas memori manusia.
Inspirasi dari memori manusia
Memori berperan penting dalam pembelajaran dan perilaku manusia. Memori membantu kita mempertahankan informasi dari pengalaman masa lalu, yang kita gunakan untuk membuat keputusan, beradaptasi dengan situasi baru, dan memecahkan masalah. Secara garis besar, memori manusia dapat dikategorikan menjadi tiga jenis:
Dalam perilaku manusia, ketiga jenis memori ini bekerja bersama agar kita dapat belajar dari lingkungan, menyesuaikan strategi, dan meningkatkan perilaku seiring waktu. Tanpanya, kita akan terbatas pada refleks dasar dan perilaku yang stereotip.
Struktur memori pada Titans
Sama seperti model memori manusia, struktur memori Titans terdiri dari tiga bagian:
Dengan mengintegrasikan ketiga jenis memori ini, arsitektur Titans memungkinkan model AI mengelola informasi secara dinamis seperti halnya otak kita, memadukan pemrosesan langsung dengan retensi pengalaman dan pengetahuan masa lalu.
Mekanisme "Kejutan"
Mekanisme "kejutan" pada Titans meniru aspek mendasar memori manusia: kecenderungan kita untuk mengingat peristiwa yang mengejutkan atau tak terduga dengan lebih jelas. Pendekatan ini membantu model AI memutuskan informasi apa yang perlu disimpan dengan mengidentifikasi data yang menyimpang dari apa yang diharapkan model.
Bayangkan Anda berjalan di jalan dan semuanya tampak biasa dan rutin. Anda mungkin tidak mengingat jalan-jalan biasa ini beberapa minggu kemudian. Namun, jika terjadi sesuatu yang tak terduga, seperti pawai berwarna-warni lewat atau menerima panggilan telepon dengan kabar menggembirakan, unsur kejutan ini menarik perhatian Anda, membuatnya lebih mudah diingat.
Demikian pula, Titans menggunakan gagasan kejutan ini untuk memprioritaskan informasi mana yang akan diingat. Ketika model menemui data yang sangat berbeda dari yang diantisipasi (seperti pawai berwarna-warni kita), model menandai informasi ini sebagai mengejutkan. Sistem memori di Titans kemudian memprioritaskan penyimpanan peristiwa tak terduga tersebut, memastikan data penting yang tidak biasa tidak terlewat.
Mekanisme ini memungkinkan Titans mengelola sumber daya memorinya secara efisien dengan berfokus pada informasi penting yang menyimpang, alih-alih mencoba mempertahankan setiap detail. Sama seperti manusia yang lebih mudah mengingat hal yang tak terduga, Titans menerapkan strategi alami ini untuk memproses dan menyimpan informasi penting secara efektif, sehingga berperforma lebih baik pada tugas kompleks yang melibatkan penyaringan data dalam jumlah besar.
Secara formal, konsep kejutan didefinisikan sebagai gradien dari fungsi loss terhadap input. Ini pada dasarnya mengukur sejauh mana parameter model perlu diubah sebagai respons terhadap input baru untuk meminimalkan loss.
Intuisi di balik penggunaan gradien sebagai ukuran kejutan adalah bahwa gradien yang besar menunjukkan perlunya perubahan signifikan pada model untuk mengakomodasi input baru, menandakan bahwa input tersebut cukup berbeda dari yang pernah dilihat model sebelumnya atau tidak terduga dan karena itu mengejutkan.
Mekanisme Pelupaan
Mekanisme pelupaan dalam arsitektur Titans adalah komponen kritis yang dirancang untuk mengelola memori saraf jangka panjang secara efektif, memastikan model mempertahankan informasi relevan sambil membuang yang tidak lagi dibutuhkan.
Mekanisme ini vital saat menangani data dalam jumlah besar, ketika memori berpotensi kewalahan oleh informasi usang atau tidak relevan. Dalam praktiknya, mekanisme pelupaan bekerja dengan menyesuaikan aturan pembaruan memori untuk menghapus informasi secara selektif berdasarkan faktor kejutan dan relevansinya, yang dinilai secara dinamis selama inferensi.
Secara khusus, parameter gating adaptif menentukan seberapa banyak keadaan memori sebelumnya harus dipertahankan, memungkinkan model mengosongkan atau menjaga konten memori secara adaptif. Mekanisme seperti ini mencegah memori meluap dan mendorong pemanfaatan ruang memori yang efisien, pada akhirnya meningkatkan kemampuan model untuk fokus pada masukan yang penting dan baru tanpa terbebani akumulasi data yang tidak perlu.
Pendekatan ini sangat mirip dengan proses kognitif manusia, di mana memori yang tidak penting atau usang memudar seiring waktu, sehingga pemrosesan kognitif dan pengambilan informasi menjadi lebih efisien.
Belajar pada Waktu Inferensi
Dalam pembelajaran mesin tradisional, pembelajaran terjadi pada fase pelatihan. Setelah model dilatih, model digunakan untuk melakukan inferensi—membuat prediksi berdasarkan data baru yang belum pernah dilihat—tanpa modifikasi lebih lanjut pada parameter yang telah dipelajari.
Arsitektur Titans memperkenalkan pergeseran paradigma yang penting dengan memungkinkan model belajar secara dinamis selama inferensi, juga dikenal sebagai waktu pengujian. Kemampuan ini memungkinkan Titans memperbarui memori dan parameternya berdasarkan tingkat kejutan dan signifikansi data yang masuk saat data tersebut diproses.
Kemampuan untuk belajar saat inferensi memberikan beberapa keuntungan penting:
Mode Memori di Titans
Arsitektur Titans menggunakan tiga cara berbeda untuk memasukkan memori, masing-masing terinspirasi dari aspek kognisi manusia. Mari uraikan setiap mode memori dengan analogi sederhana.
Sumber: Behrouz et. al, 2024
Memori sebagai konteks (MAC)
Bayangkan Anda memiliki asisten pribadi selama rapat. Asisten ini mencatat secara lengkap percakapan sebelumnya (memori jangka panjang) dan membisikkan potongan informasi yang relevan ke telinga Anda sesuai kebutuhan (retrieval).
Dalam mode MAC, model AI berfungsi serupa. Model mempertahankan riwayat data masa lalu yang terperinci dan mengintegrasikannya dengan masukan saat ini untuk membuat keputusan yang tepat. Seperti asisten Anda yang membantu memadukan pengetahuan masa lalu dengan diskusi saat ini untuk meningkatkan pengambilan keputusan, MAC menggunakan memori jangka panjang untuk memberikan konteks pada informasi langsung yang sedang diproses.
Memori sebagai gerbang (MAG)
Bayangkan ada dua penasihat dalam benak Anda. Satu berfokus hanya pada apa yang terjadi sekarang, memberikan wawasan tentang tugas langsung (perhatian jangka pendek). Yang lain menarik dari pengalaman dan kebijaksanaan yang terakumulasi selama bertahun-tahun (memori jangka panjang).
Mode MAG bertindak seperti penjaga gerbang yang memutuskan seberapa banyak perhatian yang diberikan kepada masing-masing penasihat, menyesuaikan fokus secara dinamis berdasarkan kebutuhan saat ini versus pembelajaran masa lalu. Ini memastikan pendekatan yang seimbang, memungkinkan AI beradaptasi apakah tugas yang dihadapi memerlukan presisi langsung atau wawasan dari pengalaman masa lalu.
Memori sebagai lapisan (MAL)
Anggap mode ini sebagai beberapa lapisan pemahaman, di mana setiap lapisan memproses informasi secara unik:
Pemrosesan berlapis ini mencerminkan cara kita sering mencerna informasi kompleks secara bertahap, membangun dan menyempurnakan pemahaman selangkah demi selangkah. Setiap mode menawarkan kekuatan unik, memungkinkan Titans menangani berbagai tugas secara efektif dengan meniru berbagai aspek cara manusia memproses dan mempertahankan informasi.
Implikasi Dunia Nyata dan Keberhasilan Eksperimental
Hasil eksperimen menyoroti keunggulan arsitektur Titans dibanding Transformer tradisional dan model modern dalam berbagai tugas. Berikut ringkasan temuan utamanya:
Secara keseluruhan, Titans memanfaatkan pendekatan manajemen memori baru yang memungkinkan penanganan tugas kompleks dengan konteks panjang secara lebih efektif, menetapkan standar baru bagi model AI dalam hal skalabilitas dan akurasi.
Kesimpulan
Arsitektur Transformer saat ini, meski kuat, kesulitan menangani konteks yang sangat panjang karena masalah penskalaan. Arsitektur inovatif Titans, yang terinspirasi dari memori manusia, mengatasi keterbatasan ini dengan mengelola memori jangka pendek, jangka panjang, dan persisten secara dinamis.
Saya percaya kemampuan Titans untuk belajar pada waktu inferensi, beradaptasi dengan data baru, dan memprioritaskan memori berdasarkan mekanisme "kejutan" berpotensi menciptakan sistem AI yang lebih mirip manusia dalam memproses informasi. Ini dapat meningkatkan kinerja sistem AI di lingkungan yang kompleks dan dinamis, yang bisa menjadi pengubah permainan bagi agen AI seperti Operator OpenAI.