2017 में, Google ने अपने क्रांतिकारी शोध-पत्र "Attention is All You Need" से AI समुदाय को हिला दिया। इस पेपर ने Transformer आर्किटेक्चर पेश किया, जिसने सेल्फ-अटेंशन मैकेनिज़्म का उपयोग करके सीक्वेंस मॉडलिंग में क्रांति ला दी।
हाल ही में, Google ने "Titans: Learning to Memorize at Test Time" शीर्षक से नया पेपर जारी किया, जिसमें वे AI सिस्टम्स के लिए सूचना को संग्रहीत और उपयोग करने के तरीके को बेहतर बनाने हेतु एक नई मेमोरी आर्किटेक्चर प्रस्तावित करते हैं।
मानव स्मृति की जटिलताओं से प्रेरणा लेते हुए, यह शोध विशेषकर Transformers की सीमित संदर्भ विंडो जैसी वर्तमान मेमोरी प्रणालियों की सीमाओं को दूर करने का लक्ष्य रखता है।
Titans आर्किटेक्चर AI मॉडलों में अल्पकालिक, दीर्घकालिक और स्थायी—विभिन्न प्रकार की मेमोरी को एकीकृत करने का एक परिष्कृत तरीका प्रस्तुत करता है, जिससे वे टेस्ट समय के दौरान गतिशील रूप से सीख और याद रख सकें।
"आश्चर्य" मैकेनिज़्म इसका केंद्र है, जो मानव मस्तिष्क की अप्रत्याशित घटनाओं को अधिक याद रखने की प्रवृत्ति से प्रेरित है। यह आर्किटेक्चर क्षणिक और पूर्ववर्ती आश्चर्यों को शामिल करके मेमोरी का कुशल प्रबंधन संभव बनाता है, जिससे डेटा का प्रभावी स्मरण और पुनर्प्राप्ति सुनिश्चित होती है।
इस लेख में, मैं Titans पेपर में प्रस्तुत सिद्धांतों और तंत्रों को सरल करूँगा और यह तलाशूँगा कि यह नया आर्किटेक्चर भविष्य के AI पर कैसा प्रभाव डाल सकता है।
Transformers आज अधिकांश LLMs में प्रयुक्त आर्किटेक्चर हैं। ये वाक्य के शब्दों जैसी डेटा की श्रेणियों को संसाधित करने की क्षमता के लिए जाने जाते हैं। वे "अटेंशन" नामक विधि से बहुत प्रभावी ढंग से काम करते हैं, जो उन्हें प्रासंगिक हिस्सों पर ध्यान केंद्रित करने में मदद करता है। फिर भी, वे एक बड़ी चुनौती का सामना करते हैं: उनकी संदर्भ विंडो का आकार।
संदर्भ विंडो मूलतः वह मात्रा है जितनी जानकारी को एक Transformer एक बार में देख सकता है। इसे एक ऐसी खिड़की की तरह समझें जो वाक्य के साथ चलती है और शब्दों के एक हिस्से को पकड़कर उनके अर्थ को संदर्भ में समझती है।
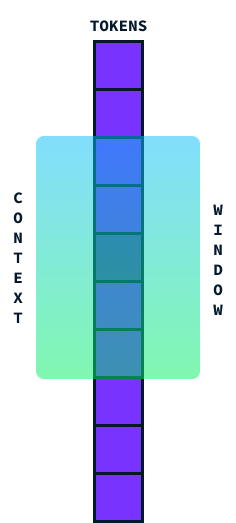
आदर्श रूप से, हम चाहते हैं कि यह विंडो जितनी बड़ी हो सके उतनी हो, ताकि एक बार में बड़े टेक्स्ट खंड संसाधित किए जा सकें, लेकिन इसमें एक पेच है। जैसे-जैसे हम इस संदर्भ विंडो को बड़ा करने की कोशिश करते हैं, क्वाड्रेटिक समय और स्पेस जटिलता के कारण आवश्यक गणना बहुत बढ़ जाती है।
इसका अर्थ है कि यदि हम संदर्भ विंडो का आकार दोगुना करते हैं, तो गणना केवल दोगुनी नहीं होती—यह चार गुना अधिक हो जाती है! ऐसा इसलिए होता है क्योंकि विंडो में प्रत्येक शब्द की तुलना हर अन्य शब्द से करनी पड़ती है, जिससे गणनाएँ तेजी से बढ़ती हैं।
आज के अत्याधुनिक (SOTA) मॉडलों में 2 मिलियन टोकन की संदर्भ विंडो है। हालांकि, उन्हें संसाधित करना काफी महंगा है, और कुछ अनुप्रयोगों—जैसे वीडियो समझ—को इससे भी बड़ी संदर्भ विंडो चाहिए। ऐसी लंबी संदर्भ विंडो, बिना गणनात्मक लागत में भारी वृद्धि के, LLMs को लंबी श्रेणियों को अधिक प्रभावी ढंग से संभालने देगी, जिससे वे उन कार्यों में बेहतर प्रदर्शन करेंगे जिनमें एक साथ बड़े डेटा खंडों की समझ आवश्यक है। यही कारण है कि क्वाड्रेटिक लागत की समस्या को दूर करना इन मॉडलों की प्रगति में एक बड़ा फोकस है।
Titans आर्किटेक्चर क्या है?
Titans एक नया आर्किटेक्चर है जो मानव स्मृति की जटिलताओं से प्रेरणा लेकर, विशेषकर बड़े और जटिल डेटा से निपटते समय, AI मॉडलों की जानकारी संग्रहीत करने और पुनर्प्राप्त करने की क्षमता को प्रभावी ढंग से बढ़ाता है।
मानव स्मृति से प्रेरणा
सीखने और व्यवहार में स्मृति की अहम भूमिका है। यह हमें पिछले अनुभवों से जानकारी बनाए रखने में मदद करती है, जिसे हम निर्णय लेने, नई परिस्थितियों में ढलने और समस्याएँ सुलझाने में काम में लेते हैं। मानव स्मृति को व्यापक रूप से तीन प्रकारों में बाँटा जा सकता है:
- अल्पकालिक स्मृति: यह वर्तमान जानकारी के प्रसंस्करण के लिए होती है। यह एक मानसिक कार्यस्थल की तरह है जहाँ हम अभी की जरूरत का डेटा अस्थायी रूप से रखते और प्रबंधित करते हैं, जैसे नंबर डायल करने तक के लिए फ़ोन नंबर याद रखना।
- दीर्घकालिक स्मृति: यह लम्बी अवधि तक जानकारी संग्रहीत करती है। इसमें हमारा ज्ञान, कौशल और निजी यादें शामिल होती हैं, जो हमें वर्षों बाद भी अनुभवों को याद करने और उनसे सीखने देती हैं।
- मेटा-स्मृति: यह इस बारे में है कि हम क्या जानते हैं। यह हमें आकलन करने में मदद करती है कि हम किसी बात को कितना याद रख सकते हैं या कोई कार्य कितना अच्छे से कर सकते हैं, जो हमारे निर्णयों और आकलनों को प्रभावित करता है।
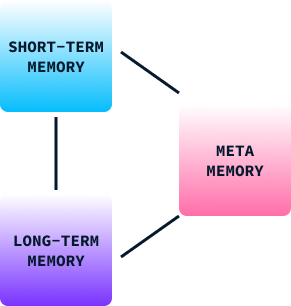
मानव व्यवहार में, ये स्मृति प्रकार एक साथ काम करते हैं ताकि हम अपने परिवेश से सीख सकें, रणनीतियाँ अपना सकें और समय के साथ अपने व्यवहार में सुधार कर सकें। इसके बिना, हम बुनियादी रिफ्लेक्स और तयशुदा व्यवहार तक सीमित रह जाते।
Titans की मेमोरी संरचना
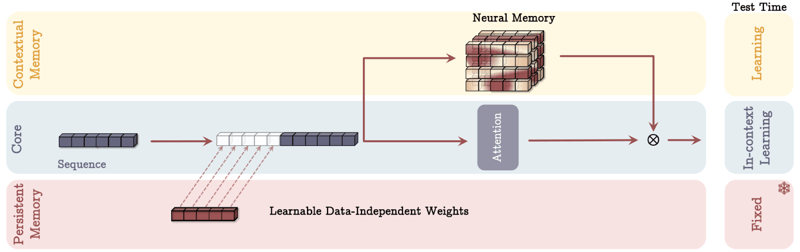
ठीक मानव स्मृति मॉडल की तरह, Titan की मेमोरी संरचना तीन भागों से बनी है:
- अल्पकालिक स्मृति (कोर): यह मॉड्यूल वर्तमान कार्यों के प्रसंस्करण पर केंद्रित है, जिससे AI तात्कालिक डेटा को सटीकता से संभाल सके। मस्तिष्क की अल्पकालिक स्मृति की तरह, यह घटक प्रासंगिक जानकारी को त्वरित प्रसंस्करण के लिए सुलभ रखता है, पर इसे अनिश्चितकाल तक नहीं सँजोता।
- दीर्घकालिक स्मृति: यह विस्तारित अवधियों तक जानकारी संग्रहीत करने का भंडार है। यह मनुष्यों की दीर्घकालिक स्मृति के समान है, जो उन अनुभवों, ज्ञान और यादों को बनाए रखती है जो तुरंत जरूरी नहीं होते, पर भविष्य में महत्वपूर्ण हो सकते हैं। यह AI मॉडलों को बीती जानकारी को प्रभावी ढंग से याद करने और उपयोग करने देती है, जो समय के साथ संदर्भ समझने वाले कार्यों के लिए अहम है।
- स्थायी स्मृति: यह मस्तिष्क की मेटा-स्मृति की तरह काम करती है, कार्य-संबंधी ज्ञान को मॉडल में अंतर्निहित करती है। इस प्रकार की स्मृति में ऐसे पैरामीटर शामिल होते हैं जो वर्तमान इनपुट पर निर्भर नहीं होते, पर विशिष्ट कार्यों को समझने और निष्पादित करने के लिए आवश्यक होते हैं। स्थायी स्मृति यह सुनिश्चित करती है कि सीखे हुए पैटर्न और ढाँचे मॉडल का हिस्सा बने रहें, जिससे वह पिछले सीख को नई परिस्थितियों में लागू कर सके।
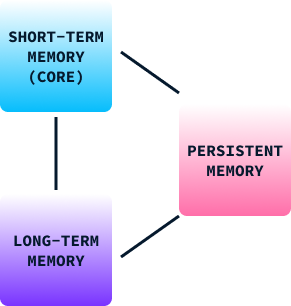
इन तीनों प्रकार की स्मृति को एकीकृत करके, Titans आर्किटेक्चर AI मॉडलों को हमारे मस्तिष्क की तरह गतिशील रूप से जानकारी प्रबंधित करने में सक्षम बनाता है, जहाँ तात्कालिक प्रसंस्करण बीते अनुभवों और ज्ञान के संरक्षण के साथ मिश्रित होता है।
"आश्चर्य" मैकेनिज़्म
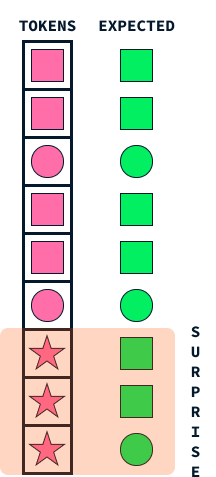
Titans में "आश्चर्य" मैकेनिज़्म मानव स्मृति के एक बुनियादी पहलू की नकल करता है: अप्रत्याशित घटनाओं को अधिक स्पष्टता से याद रखने की हमारी प्रवृत्ति। यह तरीका मॉडल को यह तय करने में मदद करता है कि किस जानकारी को संग्रहीत किया जाए, यानी जो डेटा उसकी अपेक्षा से अलग दिखता है उसे चिन्हित करके।
मान लीजिए आप सड़क पर चल रहे हैं और सब कुछ सामान्य है। कुछ हफ्तों बाद यह रोज़मर्रा की सैर याद न भी रहे। लेकिन यदि कुछ अप्रत्याशित हो—जैसे रंग-बिरंगी परेड निकल आए या कोई रोमांचक खबर वाला फ़ोन कॉल आ जाए—तो ये चौंकाने वाले तत्व आपका ध्यान खींचते हैं और याद रह जाते हैं।
इसी तरह, Titans आश्चर्य के विचार का उपयोग यह प्राथमिकता तय करने के लिए करते हैं कि क्या याद रखना है। जब मॉडल ऐसे डेटा से टकराता है जो उसकी अपेक्षा से काफी अलग होता है (ठीक हमारी रंगीन परेड की तरह), तो वह उसे आश्चर्यजनक के रूप में फ़्लैग करता है। Titans की मेमोरी प्रणाली तब इन अप्रत्याशित घटनाओं को संग्रहीत करने को प्राथमिकता देती है, ताकि महत्वपूर्ण पर असामान्य डेटा न छूट जाए।
यह तंत्र Titans को हर विवरण को याद रखने की कोशिश करने के बजाय महत्वपूर्ण, अपवादात्मक जानकारी पर ध्यान केंद्रित करके अपनी मेमोरी संसाधनों का कुशल प्रबंधन करने देता है। जैसे मनुष्य अप्रत्याशित बातों को अधिक याद रखते हैं, Titans भी इस स्वाभाविक रणनीति को अपनाकर आवश्यक जानकारी को प्रभावी ढंग से संसाधित और संजोते हैं, जिससे वे विशाल डेटा में छँटाई करने वाले जटिल कार्यों पर बेहतर प्रदर्शन कर सकें।
औपचारिक रूप से, आश्चर्य की अवधारणा को इनपुट के सापेक्ष लॉस फ़ंक्शन के ग्रेडिएंट के रूप में परिभाषित किया जाता है। यह मूलतः मापता है कि लॉस को न्यूनतम करने के लिए नए इनपुट के जवाब में मॉडल के पैरामीटरों में कितनी बदलाहट चाहिए।
ग्रेडिएंट को आश्चर्य के माप के रूप में लेने के पीछे अंतर्दृष्टि यह है कि बड़ा ग्रेडिएंट संकेत देता है कि नए इनपुट को समायोजित करने के लिए मॉडल में बड़े बदलाव चाहिए—यानी इनपुट मॉडल के लिए अनदेखा या अप्रत्याशित है और इसलिए आश्चर्यजनक है।
भूलने का मैकेनिज़्म
Titans आर्किटेक्चर में भूलने का मैकेनिज़्म दीर्घकालिक न्यूरल मेमोरी का प्रभावी प्रबंधन करने हेतु एक अहम घटक है, जो यह सुनिश्चित करता है कि मॉडल प्रासंगिक जानकारी को बनाए रखे और बेमतलब हो चुकी बातों को हटा दे।
यह तंत्र तब अत्यंत महत्वपूर्ण हो जाता है जब डेटा बहुत विशाल हो, जहाँ मेमोरी पुरानी या अप्रासंगिक जानकारी से भर सकती है। व्यवहार में, भूलने का यह तंत्र मेमोरी अपडेट नियम को समायोजित करके काम करता है, ताकि आश्चर्य कारक और प्रासंगिकता के आधार पर जानकारी को चयनात्मक रूप से मिटाया जा सके—जिसे इन्फेरेंस के दौरान गतिशील रूप से आँका जाता है।
विशेष रूप से, एक अनुकूली गेटिंग पैरामीटर यह तय करता है कि पूर्ववर्ती मेमोरी अवस्था का कितना हिस्सा बनाए रखना है, जिससे मॉडल सामग्री को जरूरत अनुसार साफ़ या संरक्षित कर सके। ऐसा तंत्र मेमोरी ओवरफ़्लो को रोकता है और मेमोरी स्पेस का कुशल उपयोग बढ़ाता है, अंततः मॉडल को अनावश्यक डेटा के संचय से बोझिल हुए बिना महत्वपूर्ण और नवीन इनपुट पर ध्यान केंद्रित करने में मदद करता है।
यह तरीका मानव संज्ञानात्मक प्रक्रियाओं से काफ़ी मेल खाता है, जहाँ गैर-जरूरी या पुरानी यादें समय के साथ फीकी पड़ती जाती हैं, जिससे अधिक कुशल संज्ञानात्मक प्रसंस्करण और सूचना पुनर्प्राप्ति संभव होती है।
इन्फेरेंस समय पर सीखना
पारंपरिक मशीन लर्निंग मॉडलों में सीखना प्रशिक्षण चरण के दौरान होता है। एक बार मॉडल प्रशिक्षित हो जाए तो इसे इन्फेरेंस के लिए तैनात किया जाता है—जिसमें नया, अनदेखा डेटा लेकर भविष्यवाणी करना शामिल है—बिना सीखे हुए पैरामीटरों में और बदलाव किए।
Titans आर्किटेक्चर इस प्रतिमान में एक क्रांतिकारी बदलाव लाता है, क्योंकि यह मॉडलों को इन्फेरेंस के दौरान—यानी टेस्ट समय पर—गतिशील रूप से सीखने में सक्षम बनाता है। यह क्षमता Titans को आने वाले डेटा के आश्चर्य और महत्व के आधार पर, उसे संसाधित करते समय, अपनी मेमोरी और पैरामीटर अपडेट करने देती है।
इन्फेरेंस समय पर सीखने की क्षमता कई महत्त्वपूर्ण फायदे देती है:
- नए डेटा के प्रति गतिशील अनुकूलन: पारंपरिक मॉडल स्थिर सीख पर निर्भर होते हैं, क्योंकि उनके पैरामीटर ऐतिहासिक प्रशिक्षण डेटा पर तय होते हैं। Titans इन्फेरेंस के दौरान सीखकर रीयल-टाइम में बदलते पैटर्न और नए इनपुट्स के अनुकूल हो सकते हैं, जिससे बदलते परिवेश या अप्रत्याशित डेटा में उनकी प्रासंगिकता और सटीकता बढ़ती है।
- डेटा प्रासंगिकता और मेमोरी प्रबंधन में सुधार: टेस्ट समय पर मेमोरी को निरंतर अपडेट करके, Titans ऐसे डेटा से सीखने को प्राथमिकता देते हैं जिसे मौजूदा ज्ञान से भिन्न या आश्चर्यजनक माना जाता है। यह गतिशील मेमोरी प्रबंधन मानव मस्तिष्क की तरह साधारण बातों को छोड़कर नवीन या महत्वपूर्ण जानकारी पर ध्यान केंद्रित करता है, जिससे सूचना-अधिभार से बचाव होता है।
- बेहतर जनरलाइज़ेशन: चूँकि Titans लाइव डेटा के आधार पर अपनी समझ परिष्कृत कर सकते हैं, वे आउट-ऑफ़-डिस्ट्रिब्यूशन डेटा—जो मूल प्रशिक्षण सेट का हिस्सा नहीं था—पर बेहतर सामान्यीकरण कर सकते हैं। वास्तविक दुनिया के अनुप्रयोगों में यह क्षमता अहम है, जहाँ इनपुट्स प्रशिक्षण डेटा से काफी अलग हो सकते हैं।
- दीर्घ-निर्भरताओं के लिए बढ़ी क्षमता: इन्फेरेंस समय पर सीखना Titans को डेटा में दीर्घकालिक निर्भरताओं को अधिक प्रभावी ढंग से पहचानने और संजोने देता है। यह विशेष रूप से उन कार्यों में फायदेमंद है जिनमें लंबे अनुक्रमों का प्रसंस्करण शामिल है, जैसे लम्बे पाठ या वीडियो समझना।
- वास्तविक दुनिया में प्रयोज्यता: इन्फेरेंस-टाइम लर्निंग मैकेनिज़्म Titans को निरंतर विकसित होने देता है, जैसे-जैसे नए पैटर्न और ज्ञान उभरते हैं, उन्हें सीखता रहता है। यह विशेषता गतिशील और जटिल डेटा परिवेशों में प्रासंगिक बने रहने की वास्तविक दुनिया की माँगों के साथ निकटता से मेल खाती है।
Titans में मेमोरी मोड्स
Titans आर्किटेक्चर मेमोरी को शामिल करने के तीन भिन्न तरीके अपनाता है, जिनमें से प्रत्येक मानव संज्ञान के अलग पहलुओं से प्रेरित है। आइए सरल उपमाओं से हर मोड को समझें।
स्रोत: Behrouz et. al, 2024
संदर्भ रूप में मेमोरी (MAC)
कल्पना करें कि बैठक के दौरान आपके पास एक निजी सहायक है। यह सहायक पिछली बातों के विस्तृत नोट्स रखता है (दीर्घकालिक स्मृति) और ज़रूरत पड़ने पर आपके कान में प्रासंगिक जानकारी फुसफुसाता है (रिट्रीवल)।
MAC मोड में AI मॉडल इसी तरह काम करता है। यह बीते डेटा का विस्तृत इतिहास संजोता है और उसे वर्तमान इनपुट से जोड़कर सूचित निर्णय लेता है। जैसे आपका सहायक मौजूदा चर्चा के साथ पूर्व ज्ञान को मिलाकर निर्णय लेने में मदद करता है, वैसे ही MAC दीर्घकालिक स्मृति का उपयोग तत्काल जानकारी को संदर्भ देने के लिए करता है।
गेट रूप में मेमोरी (MAG)
सोचिए कि आपके मन में दो सलाहकार हैं। एक सिर्फ अभी जो हो रहा है उसी पर केंद्रित है (शॉर्ट-टर्म अटेंशन) और तात्कालिक कार्यों पर अंतर्दृष्टि देता है। दूसरा वर्षों के संचित अनुभव और समझ से मार्गदर्शन देता है (दीर्घकालिक स्मृति)।
MAG मोड एक द्वारपाल की तरह काम करता है, जो वर्तमान आवश्यकता बनाम पिछले सीख के आधार पर, हर सलाहकार को कितनी तवज्जो देनी है यह गतिशील रूप से तय करता है। यह संतुलित दृष्टिकोण सुनिश्चित करता है, जिससे AI उस स्थिति के अनुरूप ढल सके जहाँ या तो तात्कालिक परिशुद्धता चाहिए या फिर पूर्व अनुभवों से अंतर्दृष्टि।
लेयर रूप में मेमोरी (MAL)
इस मोड को समझिए जैसे समझ के कई स्तर, जहाँ हर लेयर सूचना को अपने अनोखे तरीके से संसाधित करती है:
- पहली लेयर ऐतिहासिक फ़िल्टर की तरह हो सकती है, जो दीर्घकालिक पैटर्न और यादों पर ध्यान देती है।
- दूसरी लेयर तत्काल संदर्भों को देखती है, जैसे अल्पकालिक अवलोकन।
- जैसे-जैसे सूचना हर लेयर से गुजरती है, वह परिष्कृत और रूपांतरित होती जाती है, जिससे निर्णय से पहले मॉडल व्यापक संदर्भ और बारीक विवरण—दोनों—को समग्र रूप से समझ सके।
यह लेयर्ड प्रोसेसिंग वैसी ही है जैसे हम जटिल जानकारी को चरणों में पचाते हैं, कदम-दर-कदम समझ बनाते और निखारते हैं। हर मोड की अपनी खासियत है, जो Titans को मानव सूचना-प्रसंस्करण और स्मृति के विभिन्न पहलुओं की नकल करके भिन्न-भिन्न कार्यों को प्रभावी ढंग से सँभालने देती है।
वास्तविक दुनिया में निहितार्थ और प्रायोगिक सफलताएँ
प्रयोगात्मक परिणाम विभिन्न कार्यों में Titans आर्किटेक्चर की पारंपरिक Transformers और आधुनिक मॉडलों पर श्रेष्ठता को दर्शाते हैं। मुख्य निष्कर्षों का संक्षिप्त सार इस प्रकार है:
- भाषा मॉडलिंग और सामान्य-बुद्धि तर्क: विशेषकर मेमोरी-एज़-कॉन्टेक्स्ट (MAC) वेरिएंट, Titans भाषा मॉडलिंग और कॉमन-सेंस रीजनिंग कार्यों में सशक्त प्रदर्शन दिखाते हैं।
- नीडल-इन-ए-हेस्टैक कार्य: लंबी श्रेणियों में से विशिष्ट जानकारी खोजने वाले कार्यों में, जिन्हें नीडल-इन-ए-हेस्टैक कहा जाता है, Titans उल्लेखनीय रूप से उत्कृष्ट हैं।
- बड़े संदर्भों का प्रबंधन: Titans 2 मिलियन टोकन से बड़ी संदर्भ विंडो पर भी सटीकता से समझौता किए बिना स्केल कर सकते हैं—जो मौजूदा अत्याधुनिक मॉडलों पर एक बड़ा सुधार है।
- टाइम सीरीज़ पूर्वानुमान: Titans का न्यूरल मेमोरी मॉड्यूल पूर्वानुमान कार्यों में Transformer-आधारित और रैखिक मॉडलों सहित विभिन्न बेसलाइनों से बेहतर प्रदर्शन करता है।
- DNA मॉडलिंग: Titans की आर्किटेक्चर DNA मॉडलिंग कार्यों में भी प्रतिस्पर्धी प्रदर्शन दिखाती है, जो पारंपरिक प्राकृतिक भाषा कार्यों से परे इसकी बहुमुखी क्षमता को सिद्ध करती है।
कुल मिलाकर, Titans एक नवीन मेमोरी प्रबंधन दृष्टिकोण अपनाते हैं जो उन्हें जटिल, लंबे-संदर्भ वाले कार्यों को अधिक प्रभावी ढंग से सँभालने देता है, स्केलेबिलिटी और सटीकता—दोनों—में AI मॉडलों के लिए नया मानक स्थापित करता है।
निष्कर्ष
वर्तमान Transformer आर्किटेक्चर, अपनी शक्ति के बावजूद, स्केलिंग समस्याओं के कारण अत्यंत लंबे संदर्भों को सँभालने में जूझता है। मानव स्मृति से प्रेरित Titans का अभिनव आर्किटेक्चर अल्पकालिक, दीर्घकालिक और स्थायी मेमोरी का गतिशील प्रबंधन करके इन सीमाओं को पार करता है।
मेरा मानना है कि इन्फेरेंस समय पर सीखने, नए डेटा के अनुकूल होने और "आश्चर्य" मैकेनिज़्म के आधार पर मेमोरी को प्राथमिकता देने की Titans की क्षमता AI सिस्टम्स को सूचना-प्रसंस्करण में अधिक मानवीय बना सकती है। इससे जटिल और गतिशील परिवेशों में AI प्रणालियों का प्रदर्शन बेहतर हो सकता है, जो OpenAI’s Operator जैसे AI एजेंट्स के लिए गेम चेंजर साबित हो सकता है।


2017 में, Google ने अपने क्रांतिकारी शोध-पत्र "Attention is All You Need" से AI समुदाय को हिला दिया। इस पेपर ने Transformer आर्किटेक्चर पेश किया, जिसने सेल्फ-अटेंशन मैकेनिज़्म का उपयोग करके सीक्वेंस मॉडलिंग में क्रांति ला दी।
हाल ही में, Google ने "Titans: Learning to Memorize at Test Time" शीर्षक से नया पेपर जारी किया, जिसमें वे AI सिस्टम्स के लिए सूचना को संग्रहीत और उपयोग करने के तरीके को बेहतर बनाने हेतु एक नई मेमोरी आर्किटेक्चर प्रस्तावित करते हैं।
मानव स्मृति की जटिलताओं से प्रेरणा लेते हुए, यह शोध विशेषकर Transformers की सीमित संदर्भ विंडो जैसी वर्तमान मेमोरी प्रणालियों की सीमाओं को दूर करने का लक्ष्य रखता है।
Titans आर्किटेक्चर AI मॉडलों में अल्पकालिक, दीर्घकालिक और स्थायी—विभिन्न प्रकार की मेमोरी को एकीकृत करने का एक परिष्कृत तरीका प्रस्तुत करता है, जिससे वे टेस्ट समय के दौरान गतिशील रूप से सीख और याद रख सकें।
"आश्चर्य" मैकेनिज़्म इसका केंद्र है, जो मानव मस्तिष्क की अप्रत्याशित घटनाओं को अधिक याद रखने की प्रवृत्ति से प्रेरित है। यह आर्किटेक्चर क्षणिक और पूर्ववर्ती आश्चर्यों को शामिल करके मेमोरी का कुशल प्रबंधन संभव बनाता है, जिससे डेटा का प्रभावी स्मरण और पुनर्प्राप्ति सुनिश्चित होती है।
इस लेख में, मैं Titans पेपर में प्रस्तुत सिद्धांतों और तंत्रों को सरल करूँगा और यह तलाशूँगा कि यह नया आर्किटेक्चर भविष्य के AI पर कैसा प्रभाव डाल सकता है।
वर्तमान Transformer आर्किटेक्चर की समस्या
Transformers आज अधिकांश LLMs में प्रयुक्त आर्किटेक्चर हैं। ये वाक्य के शब्दों जैसी डेटा की श्रेणियों को संसाधित करने की क्षमता के लिए जाने जाते हैं। वे "अटेंशन" नामक विधि से बहुत प्रभावी ढंग से काम करते हैं, जो उन्हें प्रासंगिक हिस्सों पर ध्यान केंद्रित करने में मदद करता है। फिर भी, वे एक बड़ी चुनौती का सामना करते हैं: उनकी संदर्भ विंडो का आकार।
संदर्भ विंडो मूलतः वह मात्रा है जितनी जानकारी को एक Transformer एक बार में देख सकता है। इसे एक ऐसी खिड़की की तरह समझें जो वाक्य के साथ चलती है और शब्दों के एक हिस्से को पकड़कर उनके अर्थ को संदर्भ में समझती है।
आदर्श रूप से, हम चाहते हैं कि यह विंडो जितनी बड़ी हो सके उतनी हो, ताकि एक बार में बड़े टेक्स्ट खंड संसाधित किए जा सकें, लेकिन इसमें एक पेच है। जैसे-जैसे हम इस संदर्भ विंडो को बड़ा करने की कोशिश करते हैं, क्वाड्रेटिक समय और स्पेस जटिलता के कारण आवश्यक गणना बहुत बढ़ जाती है।
इसका अर्थ है कि यदि हम संदर्भ विंडो का आकार दोगुना करते हैं, तो गणना केवल दोगुनी नहीं होती—यह चार गुना अधिक हो जाती है! ऐसा इसलिए होता है क्योंकि विंडो में प्रत्येक शब्द की तुलना हर अन्य शब्द से करनी पड़ती है, जिससे गणनाएँ तेजी से बढ़ती हैं।
आज के अत्याधुनिक (SOTA) मॉडलों में 2 मिलियन टोकन की संदर्भ विंडो है। हालांकि, उन्हें संसाधित करना काफी महंगा है, और कुछ अनुप्रयोगों—जैसे वीडियो समझ—को इससे भी बड़ी संदर्भ विंडो चाहिए। ऐसी लंबी संदर्भ विंडो, बिना गणनात्मक लागत में भारी वृद्धि के, LLMs को लंबी श्रेणियों को अधिक प्रभावी ढंग से संभालने देगी, जिससे वे उन कार्यों में बेहतर प्रदर्शन करेंगे जिनमें एक साथ बड़े डेटा खंडों की समझ आवश्यक है। यही कारण है कि क्वाड्रेटिक लागत की समस्या को दूर करना इन मॉडलों की प्रगति में एक बड़ा फोकस है।
Titans आर्किटेक्चर क्या है?
Titans एक नया आर्किटेक्चर है जो मानव स्मृति की जटिलताओं से प्रेरणा लेकर, विशेषकर बड़े और जटिल डेटा से निपटते समय, AI मॉडलों की जानकारी संग्रहीत करने और पुनर्प्राप्त करने की क्षमता को प्रभावी ढंग से बढ़ाता है।
मानव स्मृति से प्रेरणा
सीखने और व्यवहार में स्मृति की अहम भूमिका है। यह हमें पिछले अनुभवों से जानकारी बनाए रखने में मदद करती है, जिसे हम निर्णय लेने, नई परिस्थितियों में ढलने और समस्याएँ सुलझाने में काम में लेते हैं। मानव स्मृति को व्यापक रूप से तीन प्रकारों में बाँटा जा सकता है:
मानव व्यवहार में, ये स्मृति प्रकार एक साथ काम करते हैं ताकि हम अपने परिवेश से सीख सकें, रणनीतियाँ अपना सकें और समय के साथ अपने व्यवहार में सुधार कर सकें। इसके बिना, हम बुनियादी रिफ्लेक्स और तयशुदा व्यवहार तक सीमित रह जाते।
Titans की मेमोरी संरचना
ठीक मानव स्मृति मॉडल की तरह, Titan की मेमोरी संरचना तीन भागों से बनी है:
इन तीनों प्रकार की स्मृति को एकीकृत करके, Titans आर्किटेक्चर AI मॉडलों को हमारे मस्तिष्क की तरह गतिशील रूप से जानकारी प्रबंधित करने में सक्षम बनाता है, जहाँ तात्कालिक प्रसंस्करण बीते अनुभवों और ज्ञान के संरक्षण के साथ मिश्रित होता है।
"आश्चर्य" मैकेनिज़्म
Titans में "आश्चर्य" मैकेनिज़्म मानव स्मृति के एक बुनियादी पहलू की नकल करता है: अप्रत्याशित घटनाओं को अधिक स्पष्टता से याद रखने की हमारी प्रवृत्ति। यह तरीका मॉडल को यह तय करने में मदद करता है कि किस जानकारी को संग्रहीत किया जाए, यानी जो डेटा उसकी अपेक्षा से अलग दिखता है उसे चिन्हित करके।
मान लीजिए आप सड़क पर चल रहे हैं और सब कुछ सामान्य है। कुछ हफ्तों बाद यह रोज़मर्रा की सैर याद न भी रहे। लेकिन यदि कुछ अप्रत्याशित हो—जैसे रंग-बिरंगी परेड निकल आए या कोई रोमांचक खबर वाला फ़ोन कॉल आ जाए—तो ये चौंकाने वाले तत्व आपका ध्यान खींचते हैं और याद रह जाते हैं।
इसी तरह, Titans आश्चर्य के विचार का उपयोग यह प्राथमिकता तय करने के लिए करते हैं कि क्या याद रखना है। जब मॉडल ऐसे डेटा से टकराता है जो उसकी अपेक्षा से काफी अलग होता है (ठीक हमारी रंगीन परेड की तरह), तो वह उसे आश्चर्यजनक के रूप में फ़्लैग करता है। Titans की मेमोरी प्रणाली तब इन अप्रत्याशित घटनाओं को संग्रहीत करने को प्राथमिकता देती है, ताकि महत्वपूर्ण पर असामान्य डेटा न छूट जाए।
यह तंत्र Titans को हर विवरण को याद रखने की कोशिश करने के बजाय महत्वपूर्ण, अपवादात्मक जानकारी पर ध्यान केंद्रित करके अपनी मेमोरी संसाधनों का कुशल प्रबंधन करने देता है। जैसे मनुष्य अप्रत्याशित बातों को अधिक याद रखते हैं, Titans भी इस स्वाभाविक रणनीति को अपनाकर आवश्यक जानकारी को प्रभावी ढंग से संसाधित और संजोते हैं, जिससे वे विशाल डेटा में छँटाई करने वाले जटिल कार्यों पर बेहतर प्रदर्शन कर सकें।
औपचारिक रूप से, आश्चर्य की अवधारणा को इनपुट के सापेक्ष लॉस फ़ंक्शन के ग्रेडिएंट के रूप में परिभाषित किया जाता है। यह मूलतः मापता है कि लॉस को न्यूनतम करने के लिए नए इनपुट के जवाब में मॉडल के पैरामीटरों में कितनी बदलाहट चाहिए।
ग्रेडिएंट को आश्चर्य के माप के रूप में लेने के पीछे अंतर्दृष्टि यह है कि बड़ा ग्रेडिएंट संकेत देता है कि नए इनपुट को समायोजित करने के लिए मॉडल में बड़े बदलाव चाहिए—यानी इनपुट मॉडल के लिए अनदेखा या अप्रत्याशित है और इसलिए आश्चर्यजनक है।
भूलने का मैकेनिज़्म
Titans आर्किटेक्चर में भूलने का मैकेनिज़्म दीर्घकालिक न्यूरल मेमोरी का प्रभावी प्रबंधन करने हेतु एक अहम घटक है, जो यह सुनिश्चित करता है कि मॉडल प्रासंगिक जानकारी को बनाए रखे और बेमतलब हो चुकी बातों को हटा दे।
यह तंत्र तब अत्यंत महत्वपूर्ण हो जाता है जब डेटा बहुत विशाल हो, जहाँ मेमोरी पुरानी या अप्रासंगिक जानकारी से भर सकती है। व्यवहार में, भूलने का यह तंत्र मेमोरी अपडेट नियम को समायोजित करके काम करता है, ताकि आश्चर्य कारक और प्रासंगिकता के आधार पर जानकारी को चयनात्मक रूप से मिटाया जा सके—जिसे इन्फेरेंस के दौरान गतिशील रूप से आँका जाता है।
विशेष रूप से, एक अनुकूली गेटिंग पैरामीटर यह तय करता है कि पूर्ववर्ती मेमोरी अवस्था का कितना हिस्सा बनाए रखना है, जिससे मॉडल सामग्री को जरूरत अनुसार साफ़ या संरक्षित कर सके। ऐसा तंत्र मेमोरी ओवरफ़्लो को रोकता है और मेमोरी स्पेस का कुशल उपयोग बढ़ाता है, अंततः मॉडल को अनावश्यक डेटा के संचय से बोझिल हुए बिना महत्वपूर्ण और नवीन इनपुट पर ध्यान केंद्रित करने में मदद करता है।
यह तरीका मानव संज्ञानात्मक प्रक्रियाओं से काफ़ी मेल खाता है, जहाँ गैर-जरूरी या पुरानी यादें समय के साथ फीकी पड़ती जाती हैं, जिससे अधिक कुशल संज्ञानात्मक प्रसंस्करण और सूचना पुनर्प्राप्ति संभव होती है।
इन्फेरेंस समय पर सीखना
पारंपरिक मशीन लर्निंग मॉडलों में सीखना प्रशिक्षण चरण के दौरान होता है। एक बार मॉडल प्रशिक्षित हो जाए तो इसे इन्फेरेंस के लिए तैनात किया जाता है—जिसमें नया, अनदेखा डेटा लेकर भविष्यवाणी करना शामिल है—बिना सीखे हुए पैरामीटरों में और बदलाव किए।
Titans आर्किटेक्चर इस प्रतिमान में एक क्रांतिकारी बदलाव लाता है, क्योंकि यह मॉडलों को इन्फेरेंस के दौरान—यानी टेस्ट समय पर—गतिशील रूप से सीखने में सक्षम बनाता है। यह क्षमता Titans को आने वाले डेटा के आश्चर्य और महत्व के आधार पर, उसे संसाधित करते समय, अपनी मेमोरी और पैरामीटर अपडेट करने देती है।
इन्फेरेंस समय पर सीखने की क्षमता कई महत्त्वपूर्ण फायदे देती है:
Titans में मेमोरी मोड्स
Titans आर्किटेक्चर मेमोरी को शामिल करने के तीन भिन्न तरीके अपनाता है, जिनमें से प्रत्येक मानव संज्ञान के अलग पहलुओं से प्रेरित है। आइए सरल उपमाओं से हर मोड को समझें।
स्रोत: Behrouz et. al, 2024
संदर्भ रूप में मेमोरी (MAC)
कल्पना करें कि बैठक के दौरान आपके पास एक निजी सहायक है। यह सहायक पिछली बातों के विस्तृत नोट्स रखता है (दीर्घकालिक स्मृति) और ज़रूरत पड़ने पर आपके कान में प्रासंगिक जानकारी फुसफुसाता है (रिट्रीवल)।
MAC मोड में AI मॉडल इसी तरह काम करता है। यह बीते डेटा का विस्तृत इतिहास संजोता है और उसे वर्तमान इनपुट से जोड़कर सूचित निर्णय लेता है। जैसे आपका सहायक मौजूदा चर्चा के साथ पूर्व ज्ञान को मिलाकर निर्णय लेने में मदद करता है, वैसे ही MAC दीर्घकालिक स्मृति का उपयोग तत्काल जानकारी को संदर्भ देने के लिए करता है।
गेट रूप में मेमोरी (MAG)
सोचिए कि आपके मन में दो सलाहकार हैं। एक सिर्फ अभी जो हो रहा है उसी पर केंद्रित है (शॉर्ट-टर्म अटेंशन) और तात्कालिक कार्यों पर अंतर्दृष्टि देता है। दूसरा वर्षों के संचित अनुभव और समझ से मार्गदर्शन देता है (दीर्घकालिक स्मृति)।
MAG मोड एक द्वारपाल की तरह काम करता है, जो वर्तमान आवश्यकता बनाम पिछले सीख के आधार पर, हर सलाहकार को कितनी तवज्जो देनी है यह गतिशील रूप से तय करता है। यह संतुलित दृष्टिकोण सुनिश्चित करता है, जिससे AI उस स्थिति के अनुरूप ढल सके जहाँ या तो तात्कालिक परिशुद्धता चाहिए या फिर पूर्व अनुभवों से अंतर्दृष्टि।
लेयर रूप में मेमोरी (MAL)
इस मोड को समझिए जैसे समझ के कई स्तर, जहाँ हर लेयर सूचना को अपने अनोखे तरीके से संसाधित करती है:
यह लेयर्ड प्रोसेसिंग वैसी ही है जैसे हम जटिल जानकारी को चरणों में पचाते हैं, कदम-दर-कदम समझ बनाते और निखारते हैं। हर मोड की अपनी खासियत है, जो Titans को मानव सूचना-प्रसंस्करण और स्मृति के विभिन्न पहलुओं की नकल करके भिन्न-भिन्न कार्यों को प्रभावी ढंग से सँभालने देती है।
वास्तविक दुनिया में निहितार्थ और प्रायोगिक सफलताएँ
प्रयोगात्मक परिणाम विभिन्न कार्यों में Titans आर्किटेक्चर की पारंपरिक Transformers और आधुनिक मॉडलों पर श्रेष्ठता को दर्शाते हैं। मुख्य निष्कर्षों का संक्षिप्त सार इस प्रकार है:
कुल मिलाकर, Titans एक नवीन मेमोरी प्रबंधन दृष्टिकोण अपनाते हैं जो उन्हें जटिल, लंबे-संदर्भ वाले कार्यों को अधिक प्रभावी ढंग से सँभालने देता है, स्केलेबिलिटी और सटीकता—दोनों—में AI मॉडलों के लिए नया मानक स्थापित करता है।
निष्कर्ष
वर्तमान Transformer आर्किटेक्चर, अपनी शक्ति के बावजूद, स्केलिंग समस्याओं के कारण अत्यंत लंबे संदर्भों को सँभालने में जूझता है। मानव स्मृति से प्रेरित Titans का अभिनव आर्किटेक्चर अल्पकालिक, दीर्घकालिक और स्थायी मेमोरी का गतिशील प्रबंधन करके इन सीमाओं को पार करता है।
मेरा मानना है कि इन्फेरेंस समय पर सीखने, नए डेटा के अनुकूल होने और "आश्चर्य" मैकेनिज़्म के आधार पर मेमोरी को प्राथमिकता देने की Titans की क्षमता AI सिस्टम्स को सूचना-प्रसंस्करण में अधिक मानवीय बना सकती है। इससे जटिल और गतिशील परिवेशों में AI प्रणालियों का प्रदर्शन बेहतर हो सकता है, जो OpenAI’s Operator जैसे AI एजेंट्स के लिए गेम चेंजर साबित हो सकता है।