Nel 2017, Google ha scosso la comunità dell'IA con il suo rivoluzionario paper "Attention is All You Need". Questo lavoro ha introdotto l'architettura Transformer, che ha rivoluzionato il modeling delle sequenze grazie ai meccanismi di self-attention.
Di recente, Google ha pubblicato un nuovo paper intitolato "Titans: Learning to Memorize at Test Time", in cui propone una nuova architettura di memoria progettata per migliorare il modo in cui i sistemi di IA archiviano e utilizzano le informazioni.
Ispirandosi alle complessità della memoria umana, questa ricerca mira a superare i limiti dei sistemi di memoria esistenti nei modelli di IA, in particolare la finestra di contesto limitata dei Transformer.
L'architettura Titans introduce un approccio sofisticato per integrare diversi tipi di memoria—a breve termine, a lungo termine e persistente—all'interno dei modelli di IA, consentendo loro di imparare e memorizzare in modo dinamico durante il test.
Il meccanismo della "sorpresa" è centrale e trae spunto dalla tendenza del cervello umano a ricordare gli eventi inattesi. Questa architettura permette ai modelli di gestire la memoria in modo efficiente incorporando sorprese momentanee e passate, garantendo una memorizzazione e un recupero dei dati efficaci.
In questo articolo, semplificherò i concetti e i meccanismi introdotti nel paper su Titans ed esplorerò il potenziale impatto che questa nuova architettura potrebbe avere sul futuro dell'IA.
I Transformer sono l'architettura usata nella maggior parte degli LLM di oggi. Sono noti per la loro capacità di elaborare sequenze di dati, come le parole in una frase. Funzionano in modo molto efficace utilizzando qualcosa chiamato "attenzione", che li aiuta a concentrarsi sulle parti rilevanti dei dati. Tuttavia, devono affrontare una sfida chiave: la dimensione della loro finestra di contesto.
La finestra di contesto è, in sostanza, quante informazioni un Transformer può considerare in una volta. Pensala come una finestra che scorre lungo una frase, catturando un segmento di parole per comprenderne il significato nel contesto.
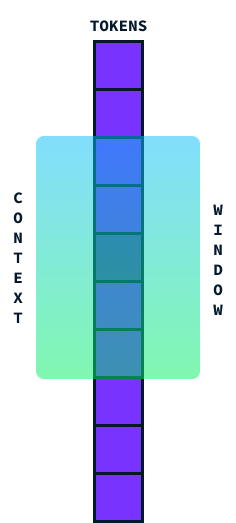
Idealmente, vorremmo che questa finestra fosse il più grande possibile per elaborare ampie sezioni di testo in una volta sola, ma c'è un problema. Man mano che proviamo ad allargare questa finestra di contesto, la quantità di calcolo necessaria aumenta in modo significativo a causa della complessità quadratica in tempo e spazio dell'architettura del Transformer.
Questo significa che se raddoppiamo la dimensione della finestra di contesto, il computo non raddoppia soltanto—diventa quattro volte più oneroso! Questo accade perché ogni parola nella finestra deve essere confrontata con ogni altra parola, quindi i calcoli crescono rapidamente.
I modelli allo stato dell'arte (SOTA) di oggi hanno finestre di contesto da 2 milioni di token. Tuttavia, elaborarli è piuttosto costoso, e alcune applicazioni, come la comprensione video, richiedono finestre di contesto ancora più ampie. Disporre di una finestra di contesto più lunga senza un enorme aumento del costo computazionale permetterebbe agli LLM di gestire sequenze più lunghe in modo più efficace, migliorando le prestazioni nei compiti che richiedono di comprendere grandi porzioni di dati tutte insieme. Ecco perché superare il problema del costo quadratico è un obiettivo fondamentale per far progredire questi modelli.
Che cos'è l'architettura Titans?
Titans è una nuova architettura che migliora la capacità dei modelli di IA di archiviare e recuperare informazioni in modo efficace, soprattutto quando si lavora con dati grandi e complessi, ispirandosi alle complessità della memoria umana.
L'ispirazione dalla memoria umana
La memoria svolge un ruolo cruciale nell'apprendimento e nel comportamento umano. Ci aiuta a trattenere informazioni dalle esperienze passate, che utilizziamo per prendere decisioni, adattarci a nuove situazioni e risolvere problemi. La memoria umana può essere ampiamente suddivisa in tre tipi:
- Memoria a breve termine: serve a elaborare le informazioni attuali. È come uno spazio di lavoro mentale in cui conserviamo e gestiamo temporaneamente i dati di cui abbiamo bisogno in questo momento, ad esempio ricordare un numero di telefono giusto il tempo di comporlo.
- Memoria a lungo termine: conserva le informazioni per periodi prolungati. Include le nostre conoscenze, abilità e ricordi personali, permettendoci di richiamare esperienze e imparare da esse anche a distanza di anni.
- Meta-memoria: riguarda il sapere ciò che sappiamo. Ci aiuta a valutare quanto bene possiamo ricordare o svolgere un compito, influenzando le nostre decisioni e i nostri giudizi.
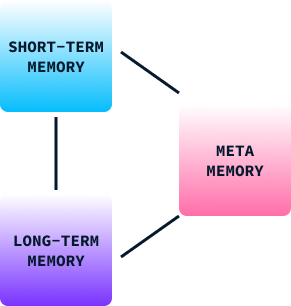
Nel comportamento umano, questi tipi di memoria lavorano insieme per permetterci di apprendere dall'ambiente, adattare strategie e migliorare i comportamenti nel tempo. Senza di essa, saremmo limitati a riflessi di base e comportamenti stereotipati.
La struttura della memoria di Titans
Proprio come il modello di memoria umana, la struttura della memoria di Titans è composta da tre parti:
- Memoria a breve termine (core): questo modulo si concentra sull'elaborazione dei compiti correnti, consentendo all'IA di gestire i dati immediati con precisione. Simile alla memoria a breve termine del cervello, questo componente aiuta a mantenere le informazioni rilevanti prontamente accessibili per un'elaborazione rapida ma non le conserva indefinitamente.
- Memoria a lungo termine: funge da archivio per conservare informazioni per periodi prolungati. Questo modulo è simile alla memoria a lungo termine negli esseri umani, che trattiene esperienze, conoscenze e ricordi non immediatamente necessari ma che potrebbero diventare significativi in futuro. Consente ai modelli di IA di ricordare e accedere efficacemente alle informazioni passate, fondamentale per i compiti che richiedono di comprendere il contesto nel tempo.
- Memoria persistente: agisce come la meta-memoria del cervello, incorporando nel modello la conoscenza legata ai compiti. Questo tipo di memoria coinvolge parametri che non dipendono dall'input corrente ma sono cruciali per comprendere ed eseguire compiti specifici. La memoria persistente garantisce che schemi e strutture appresi rimangano parte del modello, migliorando la capacità di applicare l'apprendimento passato a nuove situazioni.
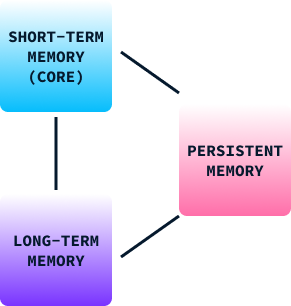
Integrando questi tre tipi di memoria, l'architettura Titans permette ai modelli di IA di gestire le informazioni in modo dinamico, proprio come i nostri cervelli, fondendo l'elaborazione immediata con la conservazione di esperienze e conoscenze passate.
Il meccanismo della "sorpresa"
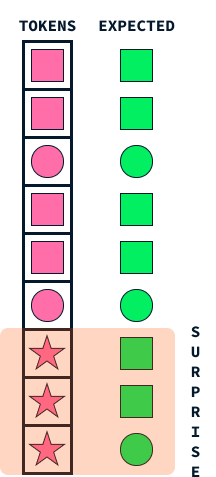
Il meccanismo della "sorpresa" in Titans imita un aspetto fondamentale della memoria umana: la nostra tendenza a ricordare più vividamente eventi sorprendenti o inaspettati. Questo approccio aiuta i modelli di IA a decidere quali informazioni archiviare identificando i dati che si discostano da ciò che il modello si aspetta.
Immagina di camminare per strada e che tutto appaia ordinario e di routine. Potresti non ricordare questa passeggiata quotidiana qualche settimana dopo. Tuttavia, se succede qualcosa di inatteso, come il passaggio di una parata colorata o una telefonata con una notizia entusiasmante, questi elementi sorprendenti catturano la tua attenzione, rendendoli più memorabili.
Allo stesso modo, Titans utilizza questa idea di sorpresa per dare priorità a quali informazioni memorizzare. Quando il modello incontra dati che differiscono significativamente da ciò che aveva previsto (proprio come la nostra parata colorata), contrassegna queste informazioni come sorprendenti. Il sistema di memoria di Titans assegna quindi priorità alla memorizzazione di questi eventi imprevisti, assicurandosi che dati importanti ma insoliti non vengano trascurati.
Questo meccanismo consente a Titans di gestire in modo efficiente le risorse di memoria concentrandosi su informazioni significative e fuori scala, invece di cercare di trattenere ogni singolo dettaglio. Proprio come gli esseri umani sono più propensi a ricordare l'inatteso, Titans applica questa strategia naturale per elaborare e conservare efficacemente le informazioni vitali, consentendo prestazioni migliori in compiti complessi che implicano lo smistamento di grandi quantità di dati.
Formalmente, il concetto di sorpresa è definito come il gradiente della funzione di loss rispetto all'input. In sostanza, misura di quanto i parametri del modello dovrebbero cambiare in risposta al nuovo input per minimizzare la loss.
L'intuizione dietro l'uso del gradiente come misura della sorpresa è che un gradiente elevato implica che sono necessari cambiamenti significativi nel modello per accogliere il nuovo input, indicando che l'input è piuttosto diverso da ciò che il modello ha visto prima o che è inatteso e quindi sorprendente.
Il meccanismo dell'oblio
Il meccanismo dell'oblio nell'architettura Titans è un componente cruciale progettato per gestire in modo efficace la memoria neurale a lungo termine, garantendo che il modello trattenga le informazioni rilevanti eliminando ciò che non serve più.
Questo meccanismo è vitale quando si affrontano enormi quantità di dati, in cui la memoria potrebbe essere potenzialmente saturata da informazioni obsolete o irrilevanti. In pratica, il meccanismo di oblio agisce regolando la regola di aggiornamento della memoria per cancellare selettivamente le informazioni in base al loro fattore di sorpresa e alla rilevanza, valutata dinamicamente durante l'inferenza.
In particolare, un parametro di gating adattivo determina quanto dello stato di memoria precedente deve essere mantenuto, consentendo al modello di cancellare o preservare il contenuto della memoria in modo adattivo. Un tale meccanismo previene il sovraccarico della memoria e promuove un utilizzo efficiente dello spazio, migliorando in definitiva la capacità del modello di concentrarsi su input critici e nuovi senza essere appesantito dall'accumulo di dati non necessari.
Questo approccio rispecchia da vicino i processi cognitivi umani, in cui i ricordi non importanti o datati svaniscono nel tempo, consentendo un'elaborazione e un recupero delle informazioni più efficienti.
Apprendimento in fase di inferenza
Nei modelli di machine learning tradizionali, l'apprendimento avviene durante la fase di training. Una volta addestrato, il modello viene distribuito per eseguire l'inferenza—ossia fare previsioni basate su nuovi dati non visti—senza ulteriori modifiche ai parametri appresi.
L'architettura Titans introduce un cambiamento radicale in questo paradigma consentendo ai modelli di imparare dinamicamente durante l'inferenza, nota anche come test time. Questa capacità permette a Titans di aggiornare la memoria e i parametri in base alla sorpresa e alla rilevanza dei dati in arrivo mentre li elabora.
La capacità di imparare in fase di inferenza offre diversi vantaggi significativi:
- Adattamento dinamico a nuovi dati: i modelli tradizionali sono limitati dalla natura statica del loro apprendimento, poiché si basano su parametri fissati in precedenza sui dati storici di training. Imparando durante l'inferenza, Titans può adattarsi in tempo reale a schemi mutevoli e input nuovi, migliorando rilevanza e accuratezza in ambienti in evoluzione o con dati inattesi.
- Maggiore rilevanza dei dati e gestione della memoria: aggiornando continuamente la memoria durante il test, Titans può dare priorità all'apprendimento dai dati considerati sorprendenti o diversi dalla conoscenza esistente. Questa gestione dinamica della memoria riflette la capacità del cervello umano di concentrarsi e ricordare informazioni nuove o importanti scartando quelle banali, prevenendo così il sovraccarico informativo.
- Migliore generalizzazione: poiché Titans può affinare la sua comprensione basandosi su dati live, riesce a generalizzare meglio a dati fuori distribuzione—input che non facevano parte del set di training originale. Questa capacità è importante nelle applicazioni reali, dove gli input variano significativamente rispetto ai dati di addestramento.
- Maggiore capacità di catturare dipendenze a lungo termine: l'apprendimento in fase di inferenza consente a Titans di riconoscere e memorizzare più efficacemente le dipendenze a lungo termine nei dati. Ciò è particolarmente utile per compiti che richiedono l'elaborazione di sequenze estese, come la comprensione di testi o video lunghi.
- Applicabilità nel mondo reale: il meccanismo di apprendimento in inferenza consente a Titans di evolvere continuamente, imparando nuovi schemi e conoscenze man mano che emergono. Questa caratteristica è in linea con le esigenze delle applicazioni reali, in cui i modelli devono rimanere rilevanti in ambienti di dati dinamici e complessi.
Modalità di memoria in Titans
L'architettura Titans utilizza tre modalità distinte per incorporare la memoria, ciascuna ispirata a diversi aspetti della cognizione umana. Vediamo ogni modalità di memoria con analogie semplici.
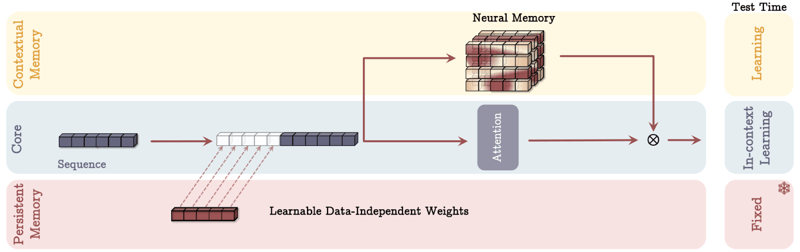
Fonte: Behrouz et. al, 2024
Memory as context (MAC)
Immagina di avere un assistente personale durante una riunione. Questo assistente prende appunti dettagliati delle conversazioni precedenti (memoria a lungo termine) e ti sussurra all'orecchio le informazioni rilevanti quando servono (recupero).
Nella modalità MAC, il modello di IA funziona in modo simile. Conserva una cronologia dettagliata dei dati passati e la integra con l'input corrente per prendere decisioni informate. Proprio come il tuo assistente ti aiuta a fondere le conoscenze passate con le discussioni presenti per migliorare il decision-making, MAC utilizza la memoria a lungo termine per fornire contesto alle informazioni immediate in elaborazione.
Memory as gate (MAG)
Immagina di avere due consulenti nella tua mente. Uno si concentra solo su ciò che sta accadendo ora, fornendo spunti sui compiti immediati (attenzione a breve termine). L'altro attinge a anni di esperienza e saggezza accumulate (memoria a lungo termine).
La modalità MAG agisce come un portinaio che decide quanta attenzione dare a ciascun consulente, regolando dinamicamente il focus in base alle esigenze presenti rispetto all'apprendimento passato. Questo garantisce un approccio equilibrato, consentendo all'IA di adattarsi sia quando il compito richiede precisione immediata sia quando servono intuizioni derivanti da esperienze passate.
Memory as layer (MAL)
Pensa a questa modalità come a più strati di comprensione, in cui ogni strato elabora le informazioni in modo unico:
- Il primo strato può agire come un filtro storico, concentrandosi su pattern e ricordi a lungo termine.
- Il secondo strato affronta i contesti immediati, come le osservazioni a breve termine.
- Man mano che l'informazione attraversa ogni strato, viene affinata e trasformata, assicurando che il modello comprenda in modo completo sia il contesto ampio sia i dettagli fini prima di prendere una decisione.
Questa elaborazione stratificata rispecchia il modo in cui spesso assimiliamo informazioni complesse a tappe, costruendo e affinando la nostra comprensione passo dopo passo. Ogni modalità offre punti di forza unici, permettendo a Titans di gestire efficacemente compiti diversi imitando vari aspetti di come gli esseri umani elaborano e conservano le informazioni.
Implicazioni nel mondo reale e risultati sperimentali
I risultati sperimentali evidenziano la superiorità dell'architettura Titans rispetto ai Transformer tradizionali e ai modelli moderni in vari compiti. Ecco una sintesi dei risultati principali:
- Linguistic modeling e ragionamento di buon senso: Titans, in particolare la variante memory-as-context (MAC), mostra prestazioni robuste nel linguistic modeling e nei compiti di ragionamento di buon senso.
- Compiti "ago nel pagliaio": nei compiti che prevedono il recupero di informazioni specifiche da lunghe sequenze, noti come needle-in-a-haystack, Titans eccelle in modo significativo.
- Gestione di contesti più ampi: Titans è in grado di scalare a dimensioni della finestra di contesto superiori a 2 milioni di token senza compromessi in accuratezza, un miglioramento sostanziale rispetto ai modelli allo stato dell'arte attuali.
- Previsione di serie temporali: il modulo di memoria neurale all'interno di Titans supera vari baseline, inclusi modelli basati su Transformer e modelli lineari, nei compiti di forecasting.
- Modeling del DNA: l'architettura di Titans mostra inoltre prestazioni competitive nei compiti di modeling del DNA, dimostrando la sua versatilità oltre i tradizionali compiti di linguaggio naturale.
Nel complesso, Titans sfrutta un nuovo approccio alla gestione della memoria che consente di affrontare in modo più efficace compiti complessi e a lungo contesto, fissando un nuovo standard per i modelli di IA in termini di scalabilità e accuratezza.
Conclusione
L'attuale architettura Transformer, pur essendo potente, fatica a gestire contesti estremamente lunghi a causa di problemi di scalabilità. L'innovativa architettura di Titans, ispirata alla memoria umana, supera questi limiti gestendo dinamicamente la memoria a breve termine, a lungo termine e persistente.
Credo che la capacità di Titans di imparare in fase di inferenza, adattarsi a nuovi dati e dare priorità alla memoria in base a un meccanismo di "sorpresa" abbia il potenziale per creare sistemi di IA più simili agli esseri umani nell'elaborazione delle informazioni. Questo potrebbe migliorare le prestazioni dei sistemi di IA in ambienti complessi e dinamici, rappresentando un possibile punto di svolta per agenti di IA come Operator di OpenAI.







Nel 2017, Google ha scosso la comunità dell'IA con il suo rivoluzionario paper "Attention is All You Need". Questo lavoro ha introdotto l'architettura Transformer, che ha rivoluzionato il modeling delle sequenze grazie ai meccanismi di self-attention.
Di recente, Google ha pubblicato un nuovo paper intitolato "Titans: Learning to Memorize at Test Time", in cui propone una nuova architettura di memoria progettata per migliorare il modo in cui i sistemi di IA archiviano e utilizzano le informazioni.
Ispirandosi alle complessità della memoria umana, questa ricerca mira a superare i limiti dei sistemi di memoria esistenti nei modelli di IA, in particolare la finestra di contesto limitata dei Transformer.
L'architettura Titans introduce un approccio sofisticato per integrare diversi tipi di memoria—a breve termine, a lungo termine e persistente—all'interno dei modelli di IA, consentendo loro di imparare e memorizzare in modo dinamico durante il test.
Il meccanismo della "sorpresa" è centrale e trae spunto dalla tendenza del cervello umano a ricordare gli eventi inattesi. Questa architettura permette ai modelli di gestire la memoria in modo efficiente incorporando sorprese momentanee e passate, garantendo una memorizzazione e un recupero dei dati efficaci.
In questo articolo, semplificherò i concetti e i meccanismi introdotti nel paper su Titans ed esplorerò il potenziale impatto che questa nuova architettura potrebbe avere sul futuro dell'IA.
Il problema dell'attuale architettura Transformer
I Transformer sono l'architettura usata nella maggior parte degli LLM di oggi. Sono noti per la loro capacità di elaborare sequenze di dati, come le parole in una frase. Funzionano in modo molto efficace utilizzando qualcosa chiamato "attenzione", che li aiuta a concentrarsi sulle parti rilevanti dei dati. Tuttavia, devono affrontare una sfida chiave: la dimensione della loro finestra di contesto.
La finestra di contesto è, in sostanza, quante informazioni un Transformer può considerare in una volta. Pensala come una finestra che scorre lungo una frase, catturando un segmento di parole per comprenderne il significato nel contesto.
Idealmente, vorremmo che questa finestra fosse il più grande possibile per elaborare ampie sezioni di testo in una volta sola, ma c'è un problema. Man mano che proviamo ad allargare questa finestra di contesto, la quantità di calcolo necessaria aumenta in modo significativo a causa della complessità quadratica in tempo e spazio dell'architettura del Transformer.
Questo significa che se raddoppiamo la dimensione della finestra di contesto, il computo non raddoppia soltanto—diventa quattro volte più oneroso! Questo accade perché ogni parola nella finestra deve essere confrontata con ogni altra parola, quindi i calcoli crescono rapidamente.
I modelli allo stato dell'arte (SOTA) di oggi hanno finestre di contesto da 2 milioni di token. Tuttavia, elaborarli è piuttosto costoso, e alcune applicazioni, come la comprensione video, richiedono finestre di contesto ancora più ampie. Disporre di una finestra di contesto più lunga senza un enorme aumento del costo computazionale permetterebbe agli LLM di gestire sequenze più lunghe in modo più efficace, migliorando le prestazioni nei compiti che richiedono di comprendere grandi porzioni di dati tutte insieme. Ecco perché superare il problema del costo quadratico è un obiettivo fondamentale per far progredire questi modelli.
Che cos'è l'architettura Titans?
Titans è una nuova architettura che migliora la capacità dei modelli di IA di archiviare e recuperare informazioni in modo efficace, soprattutto quando si lavora con dati grandi e complessi, ispirandosi alle complessità della memoria umana.
L'ispirazione dalla memoria umana
La memoria svolge un ruolo cruciale nell'apprendimento e nel comportamento umano. Ci aiuta a trattenere informazioni dalle esperienze passate, che utilizziamo per prendere decisioni, adattarci a nuove situazioni e risolvere problemi. La memoria umana può essere ampiamente suddivisa in tre tipi:
Nel comportamento umano, questi tipi di memoria lavorano insieme per permetterci di apprendere dall'ambiente, adattare strategie e migliorare i comportamenti nel tempo. Senza di essa, saremmo limitati a riflessi di base e comportamenti stereotipati.
La struttura della memoria di Titans
Proprio come il modello di memoria umana, la struttura della memoria di Titans è composta da tre parti:
Integrando questi tre tipi di memoria, l'architettura Titans permette ai modelli di IA di gestire le informazioni in modo dinamico, proprio come i nostri cervelli, fondendo l'elaborazione immediata con la conservazione di esperienze e conoscenze passate.
Il meccanismo della "sorpresa"
Il meccanismo della "sorpresa" in Titans imita un aspetto fondamentale della memoria umana: la nostra tendenza a ricordare più vividamente eventi sorprendenti o inaspettati. Questo approccio aiuta i modelli di IA a decidere quali informazioni archiviare identificando i dati che si discostano da ciò che il modello si aspetta.
Immagina di camminare per strada e che tutto appaia ordinario e di routine. Potresti non ricordare questa passeggiata quotidiana qualche settimana dopo. Tuttavia, se succede qualcosa di inatteso, come il passaggio di una parata colorata o una telefonata con una notizia entusiasmante, questi elementi sorprendenti catturano la tua attenzione, rendendoli più memorabili.
Allo stesso modo, Titans utilizza questa idea di sorpresa per dare priorità a quali informazioni memorizzare. Quando il modello incontra dati che differiscono significativamente da ciò che aveva previsto (proprio come la nostra parata colorata), contrassegna queste informazioni come sorprendenti. Il sistema di memoria di Titans assegna quindi priorità alla memorizzazione di questi eventi imprevisti, assicurandosi che dati importanti ma insoliti non vengano trascurati.
Questo meccanismo consente a Titans di gestire in modo efficiente le risorse di memoria concentrandosi su informazioni significative e fuori scala, invece di cercare di trattenere ogni singolo dettaglio. Proprio come gli esseri umani sono più propensi a ricordare l'inatteso, Titans applica questa strategia naturale per elaborare e conservare efficacemente le informazioni vitali, consentendo prestazioni migliori in compiti complessi che implicano lo smistamento di grandi quantità di dati.
Formalmente, il concetto di sorpresa è definito come il gradiente della funzione di loss rispetto all'input. In sostanza, misura di quanto i parametri del modello dovrebbero cambiare in risposta al nuovo input per minimizzare la loss.
L'intuizione dietro l'uso del gradiente come misura della sorpresa è che un gradiente elevato implica che sono necessari cambiamenti significativi nel modello per accogliere il nuovo input, indicando che l'input è piuttosto diverso da ciò che il modello ha visto prima o che è inatteso e quindi sorprendente.
Il meccanismo dell'oblio
Il meccanismo dell'oblio nell'architettura Titans è un componente cruciale progettato per gestire in modo efficace la memoria neurale a lungo termine, garantendo che il modello trattenga le informazioni rilevanti eliminando ciò che non serve più.
Questo meccanismo è vitale quando si affrontano enormi quantità di dati, in cui la memoria potrebbe essere potenzialmente saturata da informazioni obsolete o irrilevanti. In pratica, il meccanismo di oblio agisce regolando la regola di aggiornamento della memoria per cancellare selettivamente le informazioni in base al loro fattore di sorpresa e alla rilevanza, valutata dinamicamente durante l'inferenza.
In particolare, un parametro di gating adattivo determina quanto dello stato di memoria precedente deve essere mantenuto, consentendo al modello di cancellare o preservare il contenuto della memoria in modo adattivo. Un tale meccanismo previene il sovraccarico della memoria e promuove un utilizzo efficiente dello spazio, migliorando in definitiva la capacità del modello di concentrarsi su input critici e nuovi senza essere appesantito dall'accumulo di dati non necessari.
Questo approccio rispecchia da vicino i processi cognitivi umani, in cui i ricordi non importanti o datati svaniscono nel tempo, consentendo un'elaborazione e un recupero delle informazioni più efficienti.
Apprendimento in fase di inferenza
Nei modelli di machine learning tradizionali, l'apprendimento avviene durante la fase di training. Una volta addestrato, il modello viene distribuito per eseguire l'inferenza—ossia fare previsioni basate su nuovi dati non visti—senza ulteriori modifiche ai parametri appresi.
L'architettura Titans introduce un cambiamento radicale in questo paradigma consentendo ai modelli di imparare dinamicamente durante l'inferenza, nota anche come test time. Questa capacità permette a Titans di aggiornare la memoria e i parametri in base alla sorpresa e alla rilevanza dei dati in arrivo mentre li elabora.
La capacità di imparare in fase di inferenza offre diversi vantaggi significativi:
Modalità di memoria in Titans
L'architettura Titans utilizza tre modalità distinte per incorporare la memoria, ciascuna ispirata a diversi aspetti della cognizione umana. Vediamo ogni modalità di memoria con analogie semplici.
Fonte: Behrouz et. al, 2024
Memory as context (MAC)
Immagina di avere un assistente personale durante una riunione. Questo assistente prende appunti dettagliati delle conversazioni precedenti (memoria a lungo termine) e ti sussurra all'orecchio le informazioni rilevanti quando servono (recupero).
Nella modalità MAC, il modello di IA funziona in modo simile. Conserva una cronologia dettagliata dei dati passati e la integra con l'input corrente per prendere decisioni informate. Proprio come il tuo assistente ti aiuta a fondere le conoscenze passate con le discussioni presenti per migliorare il decision-making, MAC utilizza la memoria a lungo termine per fornire contesto alle informazioni immediate in elaborazione.
Memory as gate (MAG)
Immagina di avere due consulenti nella tua mente. Uno si concentra solo su ciò che sta accadendo ora, fornendo spunti sui compiti immediati (attenzione a breve termine). L'altro attinge a anni di esperienza e saggezza accumulate (memoria a lungo termine).
La modalità MAG agisce come un portinaio che decide quanta attenzione dare a ciascun consulente, regolando dinamicamente il focus in base alle esigenze presenti rispetto all'apprendimento passato. Questo garantisce un approccio equilibrato, consentendo all'IA di adattarsi sia quando il compito richiede precisione immediata sia quando servono intuizioni derivanti da esperienze passate.
Memory as layer (MAL)
Pensa a questa modalità come a più strati di comprensione, in cui ogni strato elabora le informazioni in modo unico:
Questa elaborazione stratificata rispecchia il modo in cui spesso assimiliamo informazioni complesse a tappe, costruendo e affinando la nostra comprensione passo dopo passo. Ogni modalità offre punti di forza unici, permettendo a Titans di gestire efficacemente compiti diversi imitando vari aspetti di come gli esseri umani elaborano e conservano le informazioni.
Implicazioni nel mondo reale e risultati sperimentali
I risultati sperimentali evidenziano la superiorità dell'architettura Titans rispetto ai Transformer tradizionali e ai modelli moderni in vari compiti. Ecco una sintesi dei risultati principali:
Nel complesso, Titans sfrutta un nuovo approccio alla gestione della memoria che consente di affrontare in modo più efficace compiti complessi e a lungo contesto, fissando un nuovo standard per i modelli di IA in termini di scalabilità e accuratezza.
Conclusione
L'attuale architettura Transformer, pur essendo potente, fatica a gestire contesti estremamente lunghi a causa di problemi di scalabilità. L'innovativa architettura di Titans, ispirata alla memoria umana, supera questi limiti gestendo dinamicamente la memoria a breve termine, a lungo termine e persistente.
Credo che la capacità di Titans di imparare in fase di inferenza, adattarsi a nuovi dati e dare priorità alla memoria in base a un meccanismo di "sorpresa" abbia il potenziale per creare sistemi di IA più simili agli esseri umani nell'elaborazione delle informazioni. Questo potrebbe migliorare le prestazioni dei sistemi di IA in ambienti complessi e dinamici, rappresentando un possibile punto di svolta per agenti di IA come Operator di OpenAI.