
基础机器学习面试题
基础问题与术语、算法和方法论相关。面试官会通过这些问题评估候选人的技术知识。
什么是半监督机器学习?
半监督学习是监督学习与无监督学习的结合。算法在带标注与未标注数据的混合数据上训练。通常用于带标注数据集很小但未标注数据集很大的情况。
简单来说,使用无监督算法创建聚类,并利用现有的带标注数据为其余未标注数据打标签。半监督算法通常基于连续性假设、聚类假设和流形假设。
它通常用于降低获取标注数据的成本。例如,蛋白质序列分类、自动语音识别和自动驾驶汽车。
如何为一个数据集选择合适的算法?
除了数据集本身,您还需要业务用例或应用需求。同一份数据可以同时应用监督学习和无监督学习。
一般而言:
- 监督学习算法需要带标注数据。
- 回归算法需要连续的数值型目标
- 分类算法需要类别型目标
- 无监督学习算法需要未标注数据。
- 半监督学习需要带标注与未标注数据集的组合。
- 强化学习算法需要环境、智能体、状态与奖励数据。
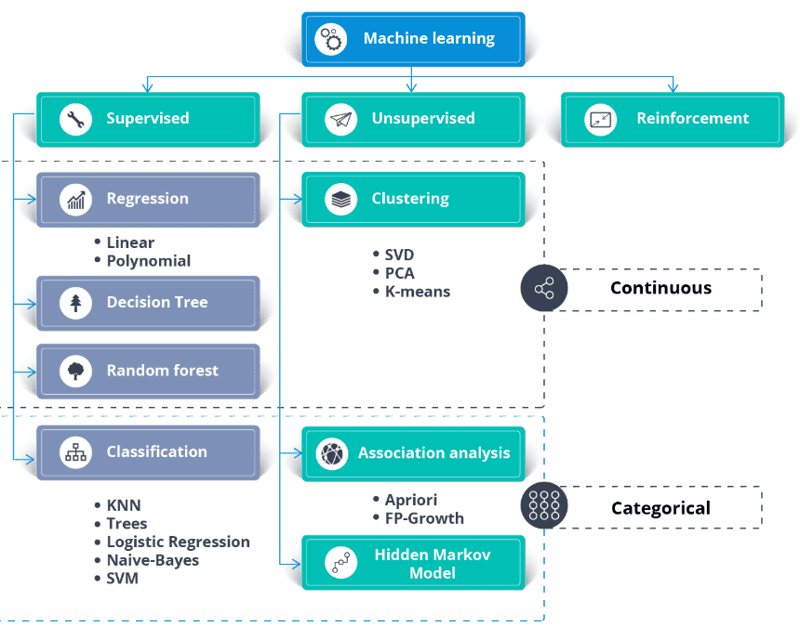
图片来源:thecleverprogrammer
通过我们的课程学习机器学习基础。
解释 K 最近邻算法。
K 最近邻(KNN)是一个监督学习分类器。它使用近邻性来对标签进行分类或预测单个数据点的归属。我们可以将其用于回归和分类。KNN 算法是非参数化的,即不对数据分布作底层假设。
在 KNN 分类器中:
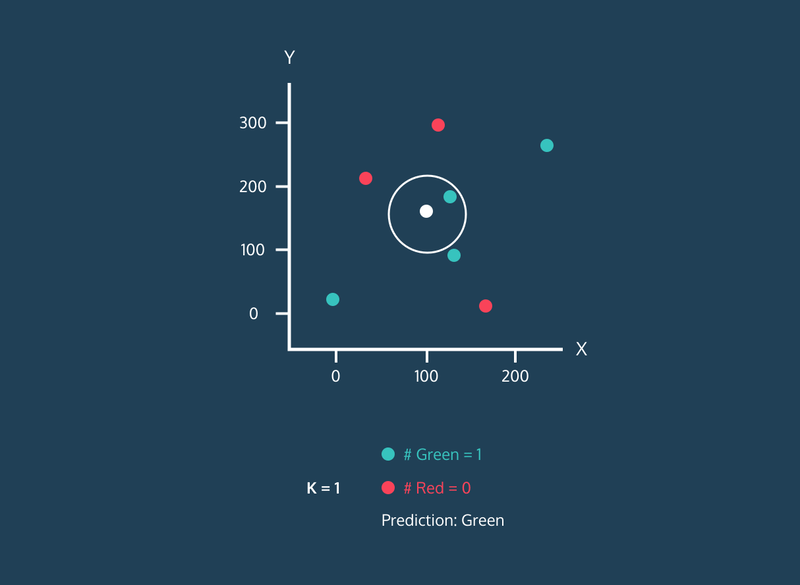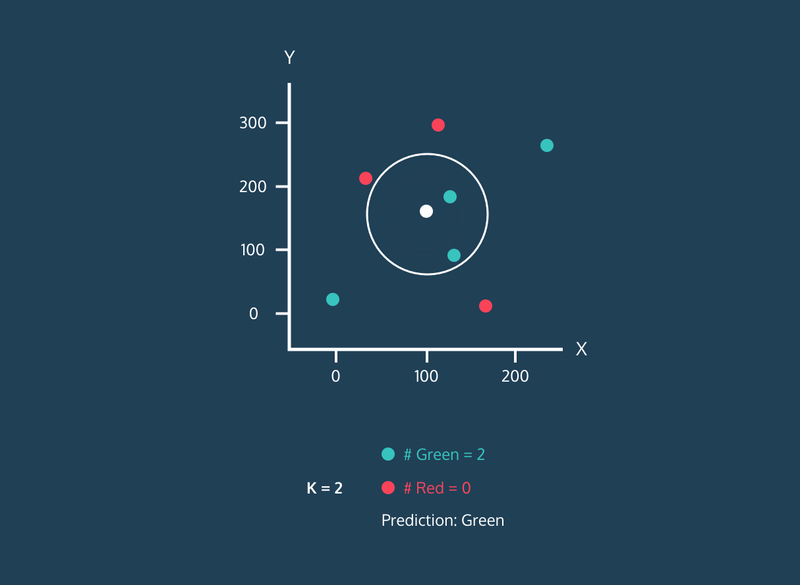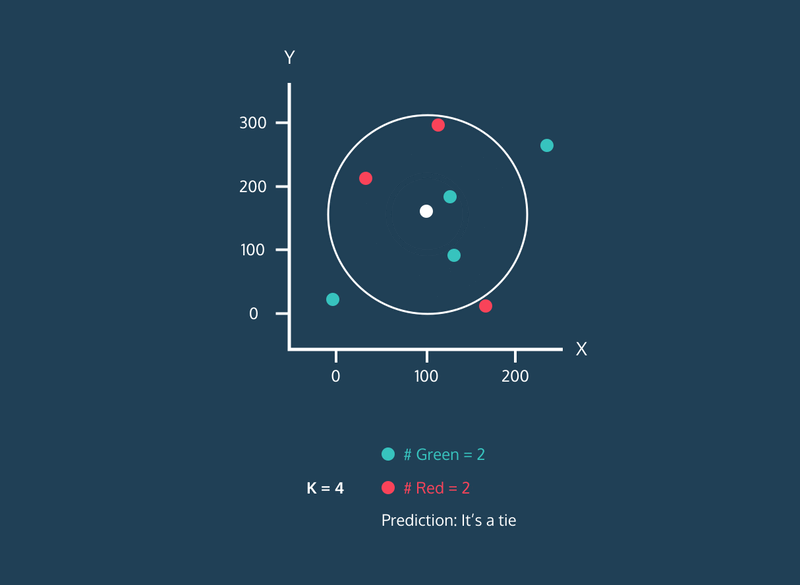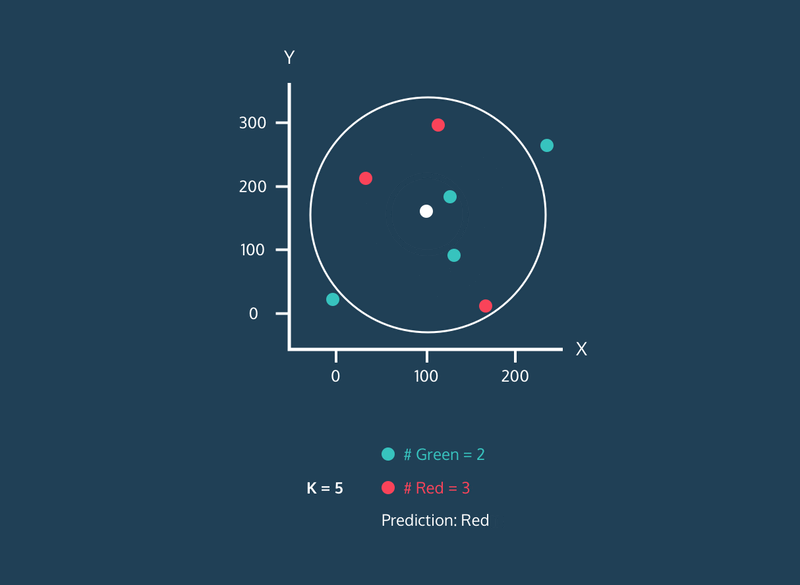
- 我们找到最接近白点的 K 个邻居。在下面的示例中,我们选择 k=5。
- 为找到 5 个最近邻,我们计算白点与其他点之间的欧氏距离,然后选择与白点最近的 5 个点。
- 当 K=5 时有 3 个红点和 2 个绿点。由于红色占多数,我们为其分配红色标签。
通过短课程学习监督学习中的分类与回归模型。
什么是机器学习中的特征重要性?如何确定它?
特征重要性指的是一类技术,它为输入特征分配分数,以衡量其对目标变量预测的有用程度。它对于理解数据的底层结构、模型行为以及让模型更易解释至关重要。
确定特征重要性的方法包括:
- 基于模型的重要性:某些算法(如决策树和随机森林)内置评估特征重要性的方法。例如,随机森林会计算到达某节点的概率加权后的节点不纯度下降,并在所有树上取平均。
- 置换重要性:打乱验证集中的单个变量,观察对模型性能的影响。若模型性能显著下降,表明该特征重要。
- SHAP(Shapley 加性解释):使用博弈论来度量复杂模型中每个特征对预测的贡献。SHAP 值能深入洞察模型行为,尤其适用于梯度提升机或神经网络等复杂模型。
- 相关系数:如皮尔逊或斯皮尔曼等简单统计量,可提供每个特征与目标变量线性关系的洞见。
理解特征重要性对模型优化、通过移除无信息特征减少过拟合、以及提升可解释性都十分关键,尤其在需要理解模型决策过程的领域。
什么是过拟合?如何避免?
过拟合是指模型在训练数据上表现良好,但由于“记住”了训练数据而非学习到底层模式,无法泛化到未见数据。避免方法包括:
- 使用交叉验证技术。
- 应用正则化(L1、L2)。
- 降低模型复杂度。
- 收集更多训练数据或使用数据增强。
监督学习与无监督学习有何区别?
- 监督学习:在带标注数据上训练,目标变量已知。示例包括分类与回归。
- 无监督学习:在未标注数据上训练以发现模式或分组。示例包括聚类与降维。
什么是混淆矩阵?为何有用?
混淆矩阵是评估分类模型性能的表格,显示真正例、真负例、假正例和假负例的计数。它有助于计算准确率、精确率、召回率和 F1 分数等指标。
参数模型与非参数模型有何区别?
参数模型:对数据的底层分布作出假设,且参数数量固定(例如,线性回归)。
非参数模型:不对数据分布作出假设,且可随着数据增多而适应更高的复杂度(例如,K 最近邻)。
什么是机器学习中的偏差-方差权衡?
偏差-方差权衡指的是在模型捕捉复杂模式的能力(低偏差)与对训练数据波动的敏感性(低方差)之间寻求平衡。优秀的模型通过同时最小化偏差与方差来避免欠拟合和过拟合。
机器学习技术面试题
技术面更多在评估您对流程的理解,以及处理不确定性的能力。招聘经理会围绕数据处理、模型训练与验证、以及高级算法来提问机器学习相关问题。
当特征值差异很大时,是否需要进行特征缩放?
需要。大多数算法使用数据点之间的欧氏距离,若特征值差异很大,结果会被严重影响。在多数情况下,离群点会导致模型在测试集上的表现变差。
我们也使用特征缩放来缩短收敛时间。当特征未归一化时,梯度下降到达局部最小值会更慢。
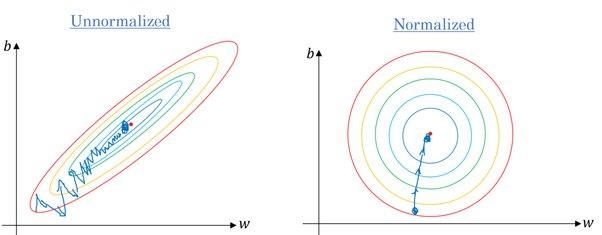
未缩放与缩放下的梯度 | Quora
特征工程技能需求很高。您可以通过 DataCamp 课程系统学习该主题,例如 用 Python 做机器学习特征工程。
您训练的模型偏差低方差高。如何处理?
偏差低意味着模型预测值接近真实值,正在“模仿”训练集。模型缺乏泛化能力,即在未见数据上表现不佳。
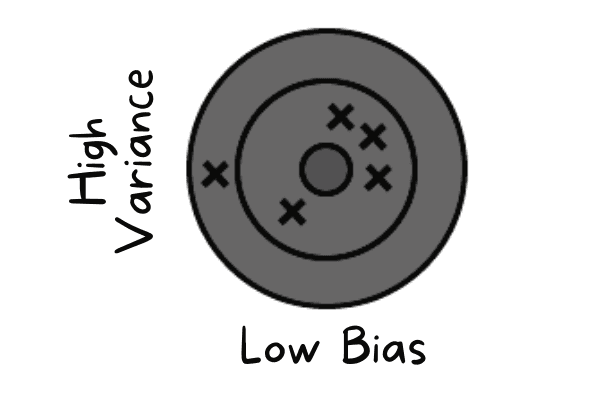
低偏差高方差 | 作者
为解决这些问题,我们可以使用袋装算法,它通过随机采样将数据集划分为子集,然后用同一算法在这些样本上训练多组模型,最后使用投票分类或取平均来融合预测。
针对高方差,我们还可以使用正则化技术,对较大的模型系数进行惩罚以降低模型复杂度。此外,还可根据特征重要性图选择最重要的特征来训练模型。
什么是模型漂移?如何在生产中检测?
模型漂移是指由于真实世界数据相较训练数据发生变化,导致模型性能随时间退化。主要有两类:
- 数据漂移(协变量偏移):输入数据分布发生变化(例如用户开始在夜间而非白天上传图片)。可通过监控训练与生产特征分布之间的统计距离(如 KL 散度)来检测。
- 概念漂移:输入与输出之间的关系发生变化(例如“垃圾邮件”的定义随时间改变)。可通过监控下游业务指标(如点击率)或可用时的真实准确率来检测。
针对时间序列数据,您会建议使用哪种交叉验证技术?为什么?
交叉验证用于稳健评估模型性能并防止过拟合。常规交叉验证会从数据中随机抽样并拆分为训练集与测试集,拆分次数由 K 值决定。
例如,当 K = 5 时,会有四折用于训练、一折用于测试;重复五次以衡量模型在不同折上的表现。
对于时间序列数据不能这样做,因为用“未来”的值去预测“过去”的值没有意义。观测之间存在时间依赖,我们只能单向拆分数据,使测试集的时间在训练集之后。
下图展示了时间序列数据的单向 K 折拆分。蓝点为训练集,红点为测试集,白点为未使用数据。可以看到每次迭代都向前推进训练集,而测试集始终位于训练集之后,而非随机选择。
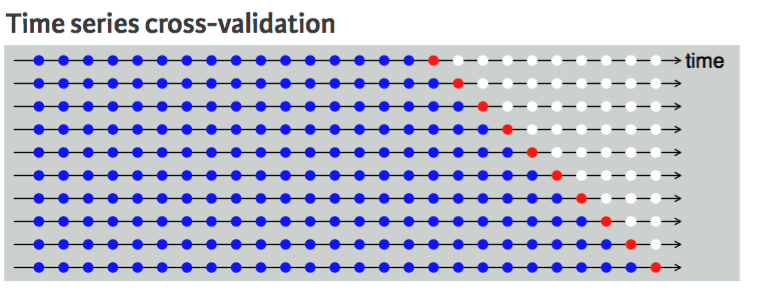
时间序列交叉验证 | UC Business Analytics R Programming Guide
通过 Time Series with Python 学习时间序列的数据处理、分析、可视化与建模。
计算机视觉工程面试题
多数在 LinkedIn、Glassdoor 和 Indeed 上发布的机器学习岗位都具有岗位针对性。因此,面试中会聚焦岗位相关问题。针对计算机视觉工程岗位,招聘经理会重点考察图像处理方面的问题。
为什么计算机视觉问题的输入会非常庞大?请举例说明。
设想一张 250 X 250 的图像,以及一个含 1000 个隐藏单元的全连接首个隐藏层。该图像的输入特征为 250 X 250 X 3 = 187,500,而首个隐藏层的权重矩阵维度为 187,500 X 1000。这些数字在存储与计算上都非常庞大。为应对该问题,我们使用卷积操作。
通过短课程用 Python 进行图像处理学习图像处理
当数据集很小时,如何训练卷积神经网络?
当您没有足够的数据来训练卷积神经网络时,可以使用迁移学习来训练模型并获得先进效果。您需要一个在通用但更大数据集上训练过的预训练模型,然后通过训练模型的最后几层在新数据上进行微调。
迁移学习使数据科学家能够用更少的资源、算力与存储在小数据上训练模型。您可以很容易地为各种用例找到开源的预训练模型,其中大多数带有商业许可,意味着您可以用它们来构建应用。
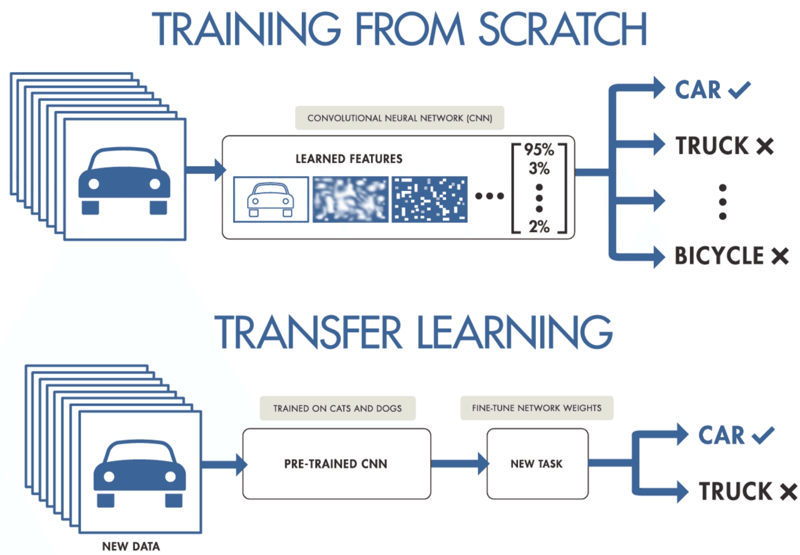
迁移学习,作者 purnasai gudikandula
什么是先进的目标检测算法 YOLO?其架构近期如何演进?
YOLO 是基于卷积神经网络的目标检测算法,能够提供实时结果。YOLO 算法只需一次 CNN 前向传播即可识别目标。它同时预测各类概率和边界框。
该模型已被训练以检测多种目标,各家公司通过迁移学习在新数据上进行微调,将其应用于自动驾驶、野生动物保护和安防等现代场景。
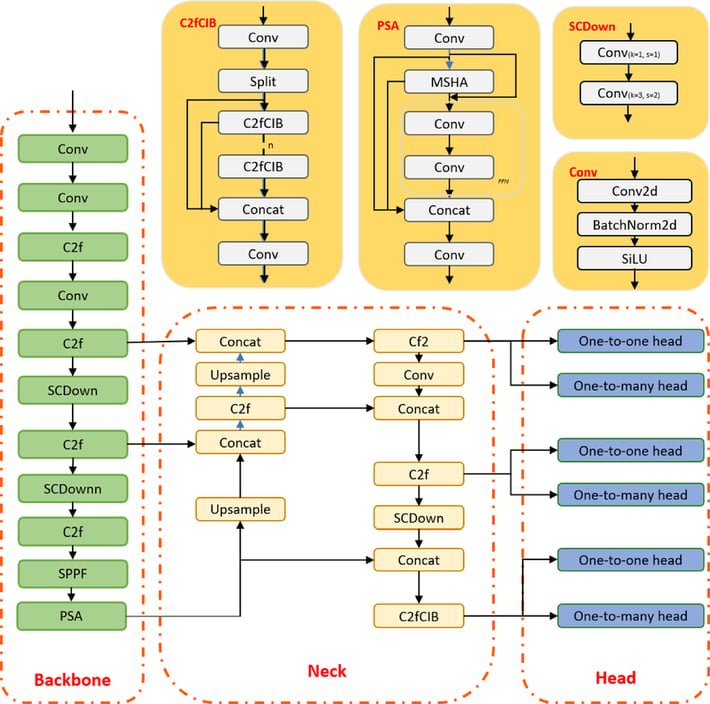
YOLOv10 模型架构 | researchgate
NLP 工程面试题
自然语言处理(NLP)是现代 AI 应用的基石之一。您需要准备好回答连接语言学理论与实践实现的问题,考察您如何使用经典技术与现代深度学习方法来处理、分析并从非结构化文本中提取含义。
什么是句法分析?
句法分析(Syntax analysis 或 Parsing)是一种文本分析,旨在揭示句子或句子片段背后的逻辑含义。它关注词语之间的关系与句子的语法结构。也可以说,是利用语法规则对自然语言进行分析处理。
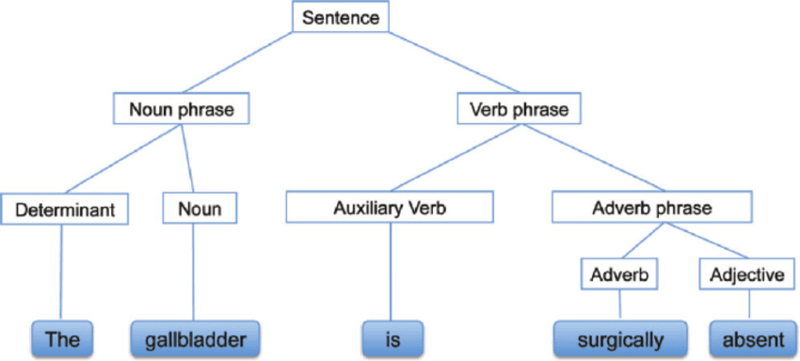
句法分析 | researchgate
什么是词干提取与词形还原?
词干提取与词形还原是用于最小化句子中词形结构变化的规范化技术。
词干提取会移除添加到单词上的词缀并将其还原为基础形式。例如,将 Changing 变为 Chang。
它被搜索引擎广泛用于存储优化。不必存储单词的所有形式,只需存储词干。
词形还原将单词转换为其词元(lemma)形式。输出是词根而非词干。经过词形还原后,我们得到有意义的有效单词。例如,将 Changing 变为 Change。
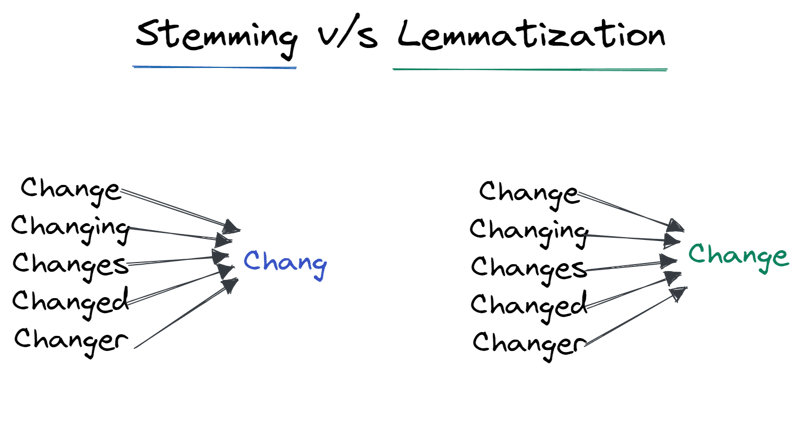
词干提取 vs. 词形还原 | 作者
在生产中优化大语言模型推理速度的现代技术有哪些?
优化大型 Transformer 需要同时解决内存带宽与计算瓶颈:
- 量化:将模型权重由 FP16(16 位)降为 INT8 或 INT4,并尽量减少精度损失。这样可在更小的 GPU 显存中容纳更大的模型。
- PagedAttention(vLLM):一种将 KV(键-值)缓存视作虚拟内存页的内存管理技术,通过消除内存碎片,实现 2-4 倍的吞吐提升。
- 推测式解码:使用一个小型“草稿”模型快速预测接下来的若干 token,再由大型模型并行校验。利用单 token 情况下内存读写往往慢于计算的事实。
通过完成 Natural Language Processing in Python 技能路径学习 NLP 基础。
LLM 工程面试题
随着 LLM 主导当前的 AI 版图,面试官更看重理解如何高效部署它们的候选人。本节聚焦 2026 年一些最大的工程实践挑战。
什么是 LLM 的上下文窗口?当任务需要的上下文超出模型一次可接收的范围时如何处理?
LLM 的上下文窗口是指模型在一次生成响应时可同时考虑的最大文本量(以 token 计),它直接限制了模型的“工作记忆”。
即使大上下文窗口越来越常见,性能与成本也并非线性扩展:长提示会增加延迟,且当关键信息埋在中间时,仍可能出现可靠性问题。
在面试中,我会从实用策略出发,解释长文档任务的处理方式:
- 使用分块(将文档按语义拆分为有意义的段落),并仅检索与当前问题最相关的块。
- 当需要事实支撑与定向检索时,优先选择检索增强生成(RAG),而非每次都发送整篇文档。这样可降低成本并避免“中间遗失”现象。
- 当需要全局视图时,使用摘要或分层笔记(章节摘要 → 摘要的摘要),再按需检索细节。
如何缓解大语言模型的幻觉问题?
幻觉是指 LLM 生成看似合理但事实错误的信息。到 2026 年,缓解需要多层次方法:
- 检索增强生成(RAG):将模型“落地”,强制其仅基于从可信知识库检索到的文档作答。
- 提示工程:诸如思维链(要求模型逐步解释推理)与少样本提示(提供已验证示例)等技巧可显著减少错误。
- 置信度打分与自一致性:对同一提示生成多个答案并选择最一致者,或先让模型在回答前给出自评置信度。
- 防护栏:实现后处理层(如 NeMo Guardrails),在输出展示给用户前依据既定规则进行事实核查。
何时应选择检索增强生成(RAG)而非微调?
这是一个典型的“权衡”问题。决策取决于数据的新鲜度与领域特异性:
- 选择 RAG 的场景:需要访问最新信息(如股价、时事)或频繁变化的私有数据。RAG 成本更低,并通过在上下文中提供确切答案来降低幻觉。
- 选择微调的场景:需要模型学习特定的行为、风格或格式(如用海盗口吻说话,或用内部专有语言编写代码)。微调将知识“烘焙”进权重,但不能解决“知识截止”问题。
- 混合方案:在许多生产系统中,先微调模型以理解领域术语,再用 RAG 提供最新事实。
更多讨论详见我们的博客 RAG vs 微调。
强化学习工程面试题
强化学习(RL)处理的是智能体通过与环境交互而非静态数据集来学习的问题。请准备好讨论 RL 的工作原理,并解释策略等核心概念。
典型的强化学习算法包含哪些步骤?
强化学习通过试错来达成目标。它是目标导向的算法,通过采取正确的动作来最大化累计奖励,从而从环境中学习。
典型的强化学习流程:
- 开始时,智能体从环境接收初始状态
- 基于该状态,智能体采取一个动作
- 状态发生变化,智能体在环境中的位置更新。
- 若动作正确,智能体会获得奖励。
- 该过程重复,直到智能体通过最大化累计奖励学到到达目标的最优路径。
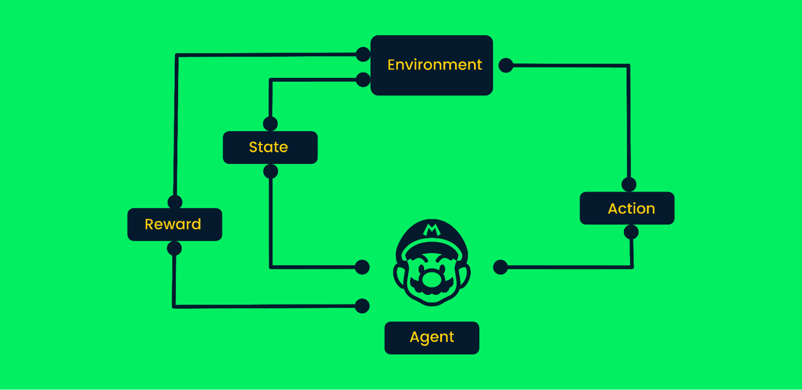
强化学习框架 | 作者
离策略与在策略学习有何区别?
在策略学习算法评估并改进同一个用于行动与更新的策略。换言之,用于更新的策略与用于采取行动的策略相同。
目标策略 == 行为策略
在策略算法包括 Sarsa、在策略蒙特卡洛、价值迭代与策略迭代。
离策略学习算法则不同,更新的策略与行为策略不同。比如在 Q-learning 中,智能体借助贪婪策略学习最优策略,但采取行动时可使用其他策略。
目标策略 != 行为策略
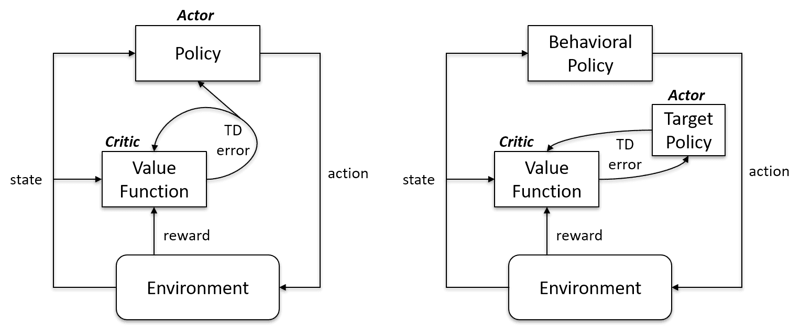
在策略 vs. 离策略 | Artificial Intelligence Stack Exchange
为什么需要“深度”Q 学习?
简单的 Q 学习在小规模问题上效果很好,但在大规模问题上会失效。
设想环境有 1000 个状态,每个状态有 1000 个动作,我们将需要一个拥有数百万单元格的 Q 表。象棋或围棋所需的表会更大。此时深度 Q 学习就派上用场了。
它使用神经网络来逼近 Q 值函数。神经网络以状态为输入,输出所有可能动作的 Q 值。
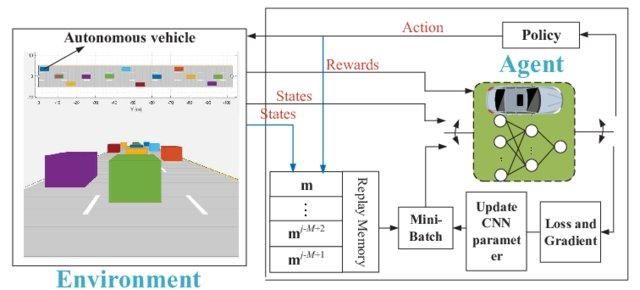
用于自动驾驶的深度 Q 网络 | researchgate
FAANG 机器学习工程师面试题
下面是一些顶尖科技公司面试官可能会问的问题:
如何解读 ROC 曲线下面积?
受试者工作特征(ROC)展示了灵敏度与特异性的权衡。
- 灵敏度:当真实值为正时,模型预测为正的概率。
- 特异性:当真实值为负时,模型预测为负的概率。
该曲线以假正率(FP/(TN + FP))与真正率(TP/(TP + FN))为坐标绘制。
曲线下面积(AUC)表示模型性能。若 ROC 曲线下面积为 0.5,则模型完全随机。AUC 越接近 1,模型越好。
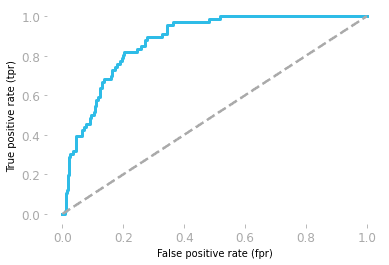
ROC 曲线 作者 Hadrien Jean
当不存在单一“标准答案”时,如何评估生成式 AI 模型?
与分类(对错分明)不同,生成式 AI 往往需要人工评估或“LLM 评审”框架:
- 无参考指标:使用更强的模型(如 GPT-4)依据“有用性”“安全性”“连贯性”等标准对小模型的回答打分。
- RAGAS(检索增强生成评估):一个标准框架,专门衡量“忠实度”(答案是否来源于上下文?)与“答案相关性”(是否回答了用户问题?)。
- 人工评估(Elo 评分):最终验证时,将两个模型输出并排比较(A/B 测试)并计算 Elo 评分,类似 LMArena 排行榜。
有哪些降维方法?
降维可以使用特征选择或特征提取方法。
特征选择是选择最优特征、丢弃无关特征的过程。我们使用过滤、包裹和嵌入式方法来分析特征重要性,移除不重要的特征以提升模型性能。
特征提取将高维空间转换为更少的维度。在此过程中不丢失信息,并用更少资源处理数据。常见的提取技术包括线性判别分析(LDA)、核 PCA 与二次判别分析。
如何为分类器选择阈值?
以垃圾邮件分类器为例,逻辑回归模型会返回概率。我们可以直接使用 0.8999 的概率,或通过阈值将其转为类别(垃圾/非垃圾)。
通常分类器阈值为 0.5,但在某些情况下需要微调以提升准确率。0.5 的阈值意味着当概率大于等于 0.5 时判为垃圾,否则判为非垃圾。
寻找阈值的方法包括使用精确率-召回率曲线与 ROC 曲线、网格搜索,或手动调整以获得更好的交叉验证结果。
通过完成 Machine Learning Scientist with Python 职业路径成为专业的机器学习工程师。
线性回归的假设有哪些?
线性回归用于理解特征(X)与目标(y)之间的关系。在训练模型前,需要满足以下假设:
- 残差相互独立
- 自变量 X 与因变量 y 之间存在线性关系。
- 在每个 X 水平上残差方差恒定
- 残差服从正态分布。
注意:线性回归中的残差是实际值与预测值之间的差。
编写函数 find_bigrams,接收字符串并返回所有二元词组的列表。
在编码面试中,除了机器学习问题,您有时还会被要求解答通用的 Python 编程问题。通过 Python Programmer 职业路径,提升您的 Python 编程能力。
创建一个二元词组函数很容易。您需要结合两个循环与 zip 函数。
- 在二元词组函数中,我们将句子列表作为输入
- 创建循环以访问单个句子
- 将句子转换为小写并拆分为词列表
- 使用
zip创建前后相邻词的组合 - 将输出追加到结果中
- 打印结果。
如果将问题拆解并使用 zip 函数,这会相当轻松。
def bigram(text_list:list):
result = []
for ls in text_list:
words = ls.lower().split()
for bi in zip(words, words[1:]):
result.append(bi)
return result
text = ["Data drives everything", "Get the skills you need for the future of work"]
print(bigram(text))结果:
[('Data', 'drives'), ('drives', 'everything'), ('Get', 'the'), ('the', 'skills'), ('skills', 'you'), ('you', 'need'), ('need', 'for'), ('for', 'the'), ('the', 'future'), ('future', 'of'), ('of', 'work')]什么是机器学习中的激活函数?
激活函数是神经网络中的非线性变换。我们在将输入传递到下一层之前先通过激活函数处理。
净输入值可能在 -inf 到 +inf 之间,神经元不知道如何对其进行边界化,因此无法决定触发模式。激活函数用于判断神经元是否应被激活,并对净输入值进行边界化。
常见的激活函数类型:
- 阶跃函数
- Sigmoid 函数
- ReLU
- Leaky ReLU
您将如何在 Facebook 上构建餐厅推荐?
答案完全取决于您。但在作答前,您需要考虑希望达成的业务目标,以设定绩效指标,以及您将如何获取数据。
在典型的机器学习系统设计中,我们会:
- 收集、清洗并分析数据。
- 执行特征工程
- 选择方法论、算法或机器学习模型
- 在测试集与验证集上训练并评估性能。
- 优化流程并将模型部署到生产环境。
您需要确保重点在于系统设计而非理论或模型结构。务必谈到模型推理,并说明改进推理如何提升整体营收。
同时,概述为何选择某种方法而非另一种方法。
通过 DataCamp 的课程进一步了解构建推荐系统。
给定两个字符串 A 和 B,编写函数 can_shift,判断 A 是否可通过某种位移得到 B。
通过挑战编程题并打磨 Python 技能,将提升您通过编码面试的机会。
在动手前先理解问题。您需要创建一个布尔函数:若将字符串 B 的字母循环位移后可以得到字符串 A,则返回 True。
A = 'abid'
B = 'bida'
can_shift(A, B) == True- 若字符串长度不同则返回 false。
- 按字符串 A 的长度范围循环
- 创建 mut_a,利用字符串 A 生成不同的字符组合
- 循环过程中,若 mut_a 等于字符串 B 返回 True,否则返回 false。
def can_shift(a, b):
if len(a) != len(b):
return False
for i in range(len(a)):
mut_a = a[i:] + a[:i]
if mut_a == b:
return True
return False
A = 'abid'
B = 'bida'
print(can_shift(A, B))
>>> True什么是集成学习?
集成学习通过结合多个机器学习模型的见解来提升准确率与性能指标。
简单的集成方法:
- 均值/平均:对多个高性能模型的预测取平均。
- 加权平均:根据模型性能分配不同权重,然后进行组合。
高级集成方法:
- 袋装(Bagging)用于最小化方差误差。它随机创建训练数据子集并在各模型上训练。模型组合能降低方差,相比单一模型更可靠。
- 提升(Boosting)用于降低偏差误差并产生更强的预测模型。这是一种迭代集成技术,会根据上一次分类结果调整样本权重。提升算法会对先前模型预测错误的样本赋予更高权重。
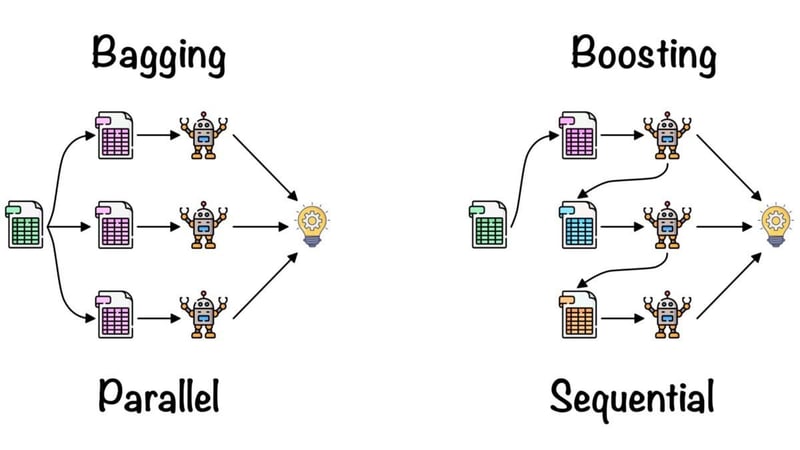
袋装与提升,作者 Fernando López
通过完成 Ensemble Methods in Python 课程,了解平均、袋装、堆叠与提升。
结语
在结束对关键机器学习面试题的梳理后,不难发现,要在此类面试中脱颖而出,需要兼具理论知识、实践技能,以及对领域内最新趋势与技术的敏锐洞察。从理解半监督学习与算法选择等基础概念,到深入具体算法(如 KNN),再到应对 NLP、计算机视觉或强化学习等岗位特定挑战,范围广泛。
无论您是准备入门的新手,还是希望进一步精进的从业者,持续学习与实践都是关键。DataCamp 提供结构化、深入的 Machine Learning Scientist with Python 学习路径,助您系统提升技能。
FAQs
机器学习面试是怎样的?
通常,机器学习技术面试分为多个部分:
- 编码面试
- 算法与数据处理
- 岗位相关面试
- 机器学习系统设计面试
- 机器学习运维与最佳实践
非技术或现场面试也是机器学习面试流程的一部分,但它们更为通用且因公司而异。
通过亚马逊的机器学习面试容易吗?
不容易。您需要为面试的各个阶段做好准备:在线测评、招聘人员电话初筛、技术电话面试以及现场面试。每个阶段都会考察您的技能与知识。
机器学习工程师会参加编码面试吗?
是的。它会考察您的 Python 问题求解能力与 SQL 数据分析能力。此外,您还会被问到机器学习工具相关问题。通过参加如 DataCamp 测评等编程挑战进行练习会更好。
AI/ML 工程师的主要工作有哪些?
一般而言,AI/ML 工程师负责研究、设计与开发机器学习系统,但不同岗位与公司会有所不同。
另外:
- 他们会清洗数据、执行数据验证,并为模型训练进行数据增强。
- 为获得更好结果而调优模型结构与超参数。
- 理解业务与数据可用性。
- 性能指标、算法与部署策略。
- 有时,他们也参与云计算与 DevOps。
如何准备机器学习面试?
了解公司与岗位职责、练习编程挑战、复盘以往项目、设计并学习端到端机器学习生命周期、练习模拟面试题,并阅读 AI/ML 领域的最新进展。无论您是刚开始成为机器学习工程师,还是已有多年从业经验,这些都很重要。
在本文中,我们整理了您在申请行业职位或面试候选人时最常遇到的一些机器学习面试题。练习这些问题并准备答案,有助于确保您的面试顺利进行。