
बेसिक मशीन लर्निंग इंटरव्यू प्रश्न
बेसिक प्रश्न शब्दावली, एल्गोरिदम और कार्यप्रणालियों से संबंधित होते हैं। इंटरव्यूअर इनसे उम्मीदवार के तकनीकी ज्ञान का आकलन करते हैं।
सेमी-सुपरवाइज्ड मशीन लर्निंग क्या है?
सेमी-सुपरवाइज्ड लर्निंग, सुपरवाइज्ड और अनसुपरवाइज्ड लर्निंग का मिश्रण है। एल्गोरिदम को लेबल्ड और अनलेबल्ड डेटा के मिश्रण पर प्रशिक्षित किया जाता है। आमतौर पर इसका उपयोग तब किया जाता है जब हमारे पास बहुत छोटा लेबल्ड डेटासेट और बड़ा अनलेबल्ड डेटासेट हो।
सरल शब्दों में, अनसुपरवाइज्ड एल्गोरिदम से क्लस्टर बनाए जाते हैं और मौजूदा लेबल्ड डेटा का उपयोग करके शेष अनलेबल्ड डेटा को लेबल किया जाता है। सेमी-सुपरवाइज्ड एल्गोरिदम निरंतरता, क्लस्टर और मैनिफोल्ड जैसी धारणाएँ मानता है।
इसे आमतौर पर लेबल्ड डेटा प्राप्त करने की लागत बचाने के लिए उपयोग किया जाता है। उदाहरण के लिए, प्रोटीन सीक्वेंस वर्गीकरण, स्वचालित वाक् पहचान, और स्वचालित वाहन।
आप किसी डेटासेट के लिए कौन सा एल्गोरिदम चुनते हैं?
डेटासेट के अलावा, आपको व्यावसायिक उपयोग-मामला या एप्लिकेशन की आवश्यकताएँ चाहिए। आप एक ही डेटा पर सुपरवाइज्ड और अनसुपरवाइज्ड लर्निंग दोनों लागू कर सकते हैं।
सामान्यतः:
- सुपरवाइज्ड लर्निंग एल्गोरिदम को लेबल्ड डेटा चाहिए।
- रिग्रेशन एल्गोरिदम को सतत संख्यात्मक लक्ष्य चाहिए
- क्लासिफिकेशन एल्गोरिदम को श्रेणीगत लक्ष्य चाहिए
- अनसुपरवाइज्ड लर्निंग एल्गोरिदम को अनलेबल्ड डेटा चाहिए।
- सेमी-सुपरवाइज्ड लर्निंग में लेबल्ड और अनलेबल्ड डेटासेट का संयोजन चाहिए।
- रीइन्फोर्समेंट लर्निंग एल्गोरिदम के लिए वातावरण, एजेंट, स्टेट और रिवार्ड डेटा चाहिए।
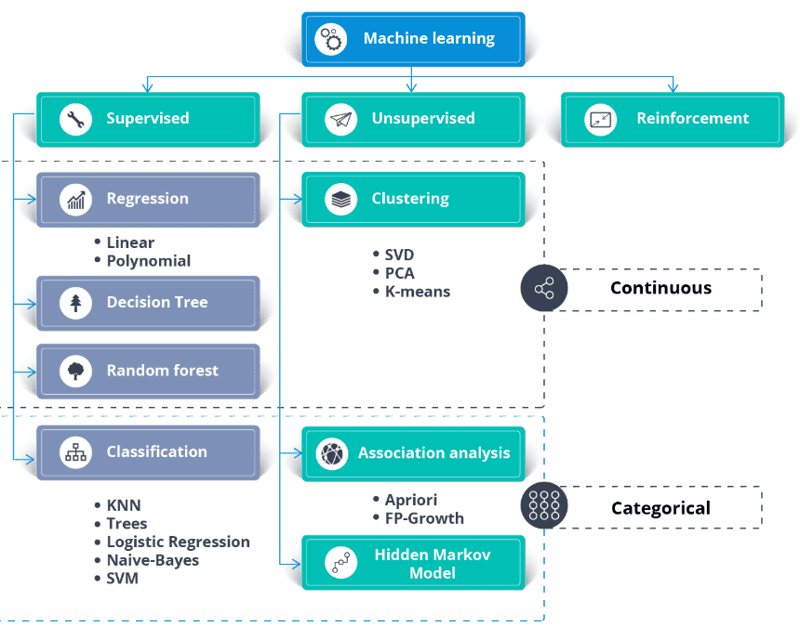
छवि: thecleverprogrammer
हमारा कोर्स लेकर मशीन लर्निंग की बुनियादी बातें सीखें।
K Nearest Neighbor एल्गोरिदम समझाइए।
K Nearest Neighbor (KNN) एक सुपरवाइज्ड लर्निंग क्लासिफायर है। यह निकटता का उपयोग करके लेबल वर्गीकृत करता है या व्यक्तिगत डेटा बिंदुओं के समूह का पूर्वानुमान लगाता है। हम इसे रिग्रेशन और क्लासिफिकेशन दोनों के लिए उपयोग कर सकते हैं। KNN एल्गोरिदम नॉन-पैरामीट्रिक है, यानी यह डेटा वितरण के बारे में कोई अंतर्निहित मान्यता नहीं बनाता।
KNN क्लासिफायर में:
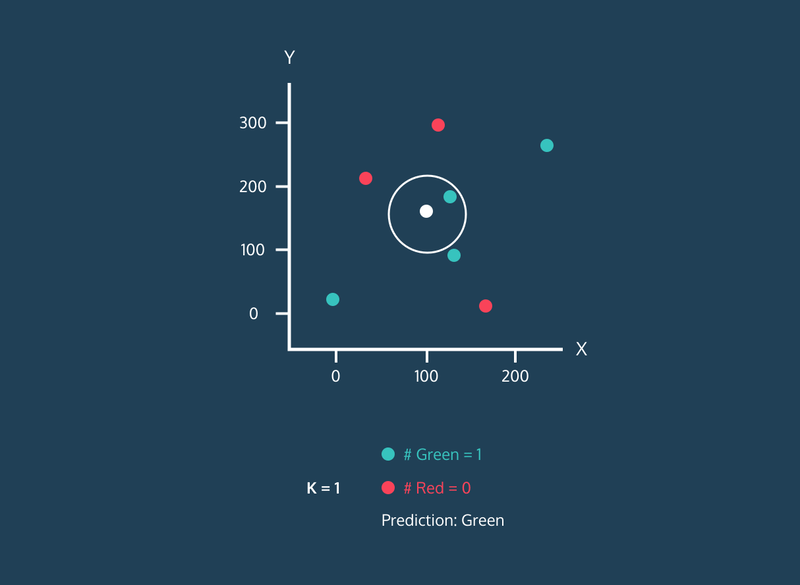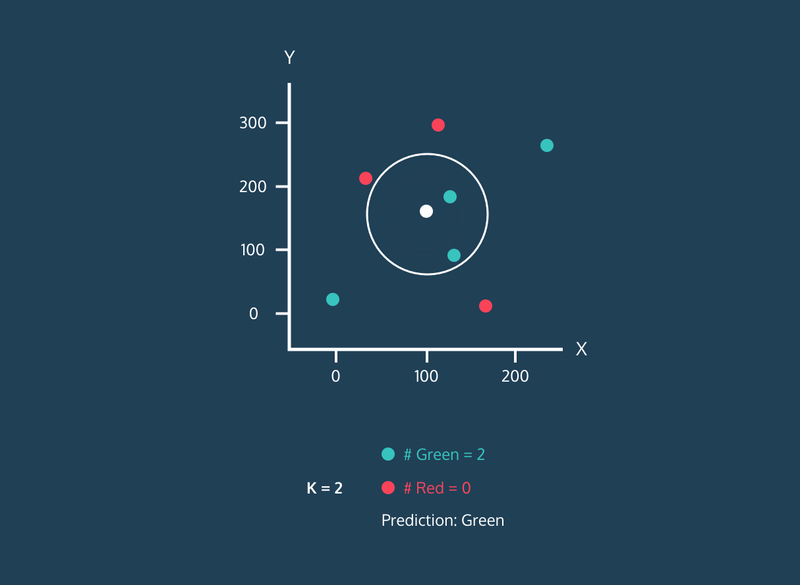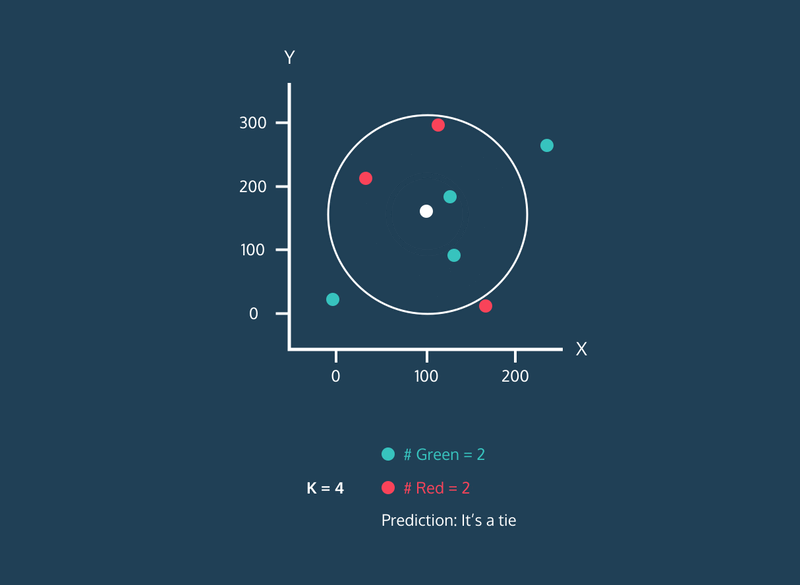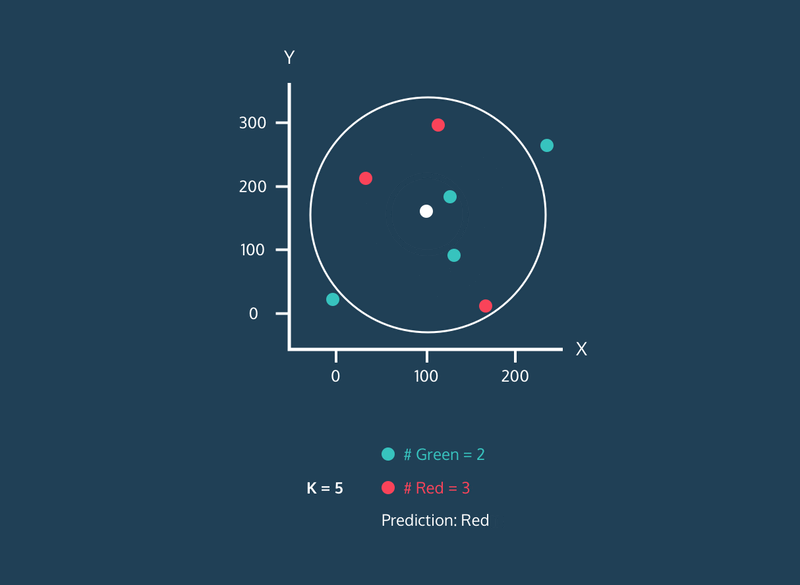
- हम सफेद बिंदु के सबसे नजदीक K-पड़ोसी ढूंढते हैं। नीचे दिए उदाहरण में हमने k=5 चुना है।
- पाँच निकटतम पड़ोसी ढूँढने के लिए, हम सफेद बिंदु और अन्य बिंदुओं के बीच यूक्लिडियन दूरी की गणना करते हैं। फिर, सफेद बिंदु के सबसे नज़दीक 5 बिंदु चुनते हैं।
- K=5 पर तीन लाल और दो हरे बिंदु हैं। चूँकि लाल बहुमत में हैं, हम इसे लाल लेबल सौंपते हैं।
एक लघु कोर्स लेकर सुपरवाइज्ड लर्निंग क्लासिफिकेशन और रिग्रेशन मॉडल के बारे में सब कुछ सीखें।
मशीन लर्निंग में फीचर इम्पोर्टेंस क्या है, और इसे कैसे निर्धारित करते हैं?
फीचर इम्पोर्टेंस उन तकनीकों को संदर्भित करता है जो इनपुट फीचर्स को इस आधार पर स्कोर देती हैं कि वे टार्गेट वेरिएबल की भविष्यवाणी में कितने उपयोगी हैं। यह डेटा की अंतर्निहित संरचना, मॉडल के व्यवहार को समझने और मॉडल को अधिक व्याख्यात्मक बनाने में महत्वपूर्ण भूमिका निभाता है।
फीचर इम्पोर्टेंस निर्धारित करने के कई तरीके हैं:
- मॉडल-आधारित इम्पोर्टेंस: कुछ एल्गोरिदम जैसे Decision Trees और Random Forests में फीचर इम्पोर्टेंस का आकलन करने के इन-बिल्ट तरीके होते हैं। उदाहरण के लिए, Random Forests नोड इम्प्योरिटी में कमी की गणना करते हैं, जिसे उस नोड तक पहुँचने की संभावना से वेट किया जाता है और सभी पेड़ों पर औसत लिया जाता है।
- परमुटेशन इम्पोर्टेंस: इसमें वैलिडेशन सेट में व्यक्तिगत वेरिएबल्स को शफ़ल करना और मॉडल प्रदर्शन पर उसके प्रभाव का निरीक्षण करना शामिल है। प्रदर्शन में उल्लेखनीय गिरावट उच्च इम्पोर्टेंस दर्शाती है।
- SHAP (SHapley Additive exPlanations): यह दृष्टिकोण गेम थ्योरी का उपयोग करके जटिल मॉडल में प्रत्येक फीचर के योगदान को मापता है। SHAP वैल्यूज़ मॉडल के व्यवहार में गहरी अंतर्दृष्टि प्रदान करती हैं और विशेष रूप से ग्रेडिएंट बूस्टिंग मशीन या न्यूरल नेटवर्क जैसे जटिल मॉडलों के लिए उपयोगी हैं।
- कोरिलेशन कोएफ़िशिएंट्स: Pearson या Spearman जैसे सरल सांख्यिकीय उपाय प्रत्येक फीचर और टार्गेट वेरिएबल के बीच रैखिक संबंध में अंतर्दृष्टि दे सकते हैं।
फीचर इम्पोर्टेंस को समझना मॉडल ऑप्टिमाइज़ेशन, गैर-सूचनात्मक फीचर्स को हटाकर ओवरफिटिंग को कम करने, और मॉडल की व्याख्येयता में सुधार के लिए महत्वपूर्ण है—विशेषकर उन डोमेनों में जहाँ मॉडल की निर्णय-प्रक्रिया को समझना ज़रूरी होता है।
मशीन लर्निंग में ओवरफिटिंग क्या है, और इसे कैसे टाला जा सकता है?
ओवरफिटिंग तब होता है जब कोई मॉडल ट्रेनिंग डेटा पर अच्छा प्रदर्शन करता है लेकिन अनदेखे डेटा पर सामान्यीकरण करने में विफल रहता है, क्योंकि उसने अंतर्निहित पैटर्न सीखने के बजाय ट्रेनिंग डेटा को याद कर लिया होता है। इसे निम्न तरीकों से टाला जा सकता है:
- क्रॉस-वैलिडेशन तकनीकों का उपयोग करना।
- रेगुलराइज़ेशन (L1, L2) लागू करना।
- मॉडल की जटिलता कम करना।
- अधिक ट्रेनिंग डेटा एकत्र करना या डेटा ऑगमेंटेशन का उपयोग करना।
सुपरवाइज्ड और अनसुपरवाइज्ड लर्निंग में क्या अंतर है?
- सुपरवाइज्ड लर्निंग: मॉडल को लेबल्ड डेटा पर प्रशिक्षित किया जाता है, जहाँ टार्गेट वेरिएबल ज्ञात होता है। उदाहरण: क्लासिफिकेशन और रिग्रेशन।
- अनसुपरवाइज्ड लर्निंग: मॉडल को अनलेबल्ड डेटा पर पैटर्न या समूह खोजने के लिए प्रशिक्षित किया जाता है। उदाहरण: क्लस्टरिंग और डायमेंशनलिटी रिडक्शन।
कन्फ्यूज़न मैट्रिक्स क्या है, और यह उपयोगी क्यों है?
कन्फ्यूज़न मैट्रिक्स एक तालिका है जो क्लासिफिकेशन मॉडल के प्रदर्शन का आकलन करने के लिए उपयोग की जाती है। यह ट्रू पॉज़िटिव, ट्रू नेगेटिव, फ़ॉल्स पॉज़िटिव और फ़ॉल्स नेगेटिव की गणना दिखाती है। यह सटीकता, प्रिसिजन, रिकॉल और F1 स्कोर जैसे मैट्रिक्स की गणना में उपयोगी है।
पैरामीट्रिक और नॉन-पैरामीट्रिक मॉडलों में क्या अंतर है?
पैरामीट्रिक मॉडल: ये डेटा के अंतर्निहित वितरण के बारे में मान्यताएँ बनाते हैं और इनके पैरामीटरों की संख्या निश्चित होती है (जैसे, Linear Regression)।
नॉन-पैरामीट्रिक मॉडल: ये डेटा वितरण के बारे में कोई मान्यताएँ नहीं बनाते और अधिक डेटा जुड़ने पर जटिलता के अनुरूप ढल सकते हैं (जैसे, K-Nearest Neighbors)।
मशीन लर्निंग में बायस-वैरिएंस ट्रेड-ऑफ़ क्या है?
बायस-वैरिएंस ट्रेड-ऑफ़ उस संतुलन को संदर्भित करता है जो किसी मॉडल की जटिल पैटर्न पकड़ने की क्षमता (कम बायस) और ट्रेनिंग डेटा में उतार-चढ़ाव के प्रति संवेदनशीलता (कम वैरिएंस) के बीच होता है। एक अच्छा मॉडल अंडरफिटिंग और ओवरफिटिंग से बचने के लिए दोनों को कम करते हुए संतुलन बनाता है।
मशीन लर्निंग टेक्निकल इंटरव्यू प्रश्न
टेक्निकल इंटरव्यू सत्र में प्रक्रियाओं के आपके ज्ञान और अनिश्चितता से निपटने की आपकी क्षमता का आकलन अधिक होता है। हायरिंग मैनेजर डेटा प्रोसेसिंग, मॉडल ट्रेनिंग और वैलिडेशन, और उन्नत एल्गोरिदम पर प्रश्न पूछेंगे।
क्या यह सही है कि जब फीचर मान बहुत भिन्न हों तो हमें उन्हें स्केल करना चाहिए?
हाँ। अधिकांश एल्गोरिदम डेटा बिंदुओं के बीच यूक्लिडियन दूरी का उपयोग करते हैं, और यदि फीचर मान बहुत अधिक भिन्न हों, तो परिणाम काफी अलग होंगे। अधिकांश मामलों में, आउट्लायर्स के कारण मशीन लर्निंग मॉडल टेस्ट डेटासेट पर खराब प्रदर्शन करते हैं।
हम कन्वर्जेन्स समय कम करने के लिए भी फीचर स्केलिंग का उपयोग करते हैं। जब फीचर्स नॉर्मलाइज़ नहीं होते, तो ग्रेडिएंट डिसेंट को लोकल मिनिमा तक पहुँचने में अधिक समय लगता है।
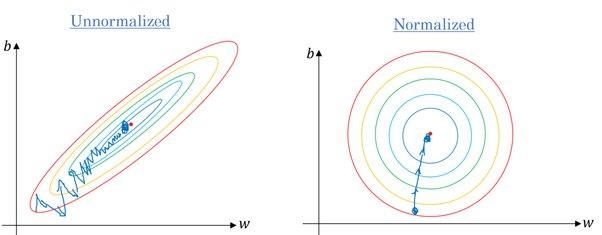
स्केलिंग के बिना और स्केलिंग के साथ ग्रेडिएंट | Quora
फीचर इंजीनियरिंग कौशल की काफी मांग है। आप DataCamp का Feature Engineering for Machine Learning in Python जैसे कोर्स लेकर इस विषय के बारे में सब कुछ सीख सकते हैं।
जिस मॉडल को आपने प्रशिक्षित किया है उसमें बायस कम और वैरिएंस अधिक है। आप इससे कैसे निपटेंगे?
कम बायस तब होता है जब मॉडल वास्तविक मान के क़रीब भविष्यवाणी करता है। यह ट्रेनिंग डेटासेट की नकल कर रहा होता है। मॉडल में सामान्यीकरण नहीं होता, यानी अनदेखे डेटा पर टेस्ट करने पर यह खराब परिणाम देगा।
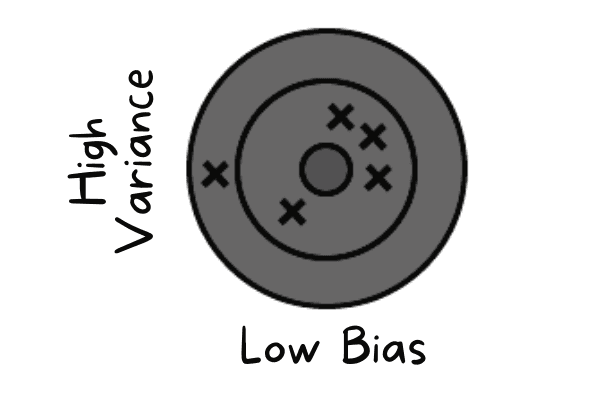
कम बायस और अधिक वैरिएंस | लेखक
इन समस्याओं को ठीक करने के लिए, हम बैगिंग एल्गोरिदम का उपयोग करेंगे क्योंकि यह रैंडम सैंपलिंग से डेटा सेट को सबसेट्स में विभाजित करता है। फिर, हम इन सैंपल्स से एक ही एल्गोरिदम के साथ मॉडलों के सेट बनाते हैं। उसके बाद, हम वोटिंग क्लासिफिकेशन या एवरेजिंग का उपयोग करके मॉडल की भविष्यवाणियों को संयोजित करते हैं।
उच्च वैरिएंस के लिए, हम रेगुलराइज़ेशन तकनीकों का उपयोग कर सकते हैं। यह उच्च मॉडल कोएफ़िशिएंट्स को दंडित करके मॉडल की जटिलता कम करता है। साथ ही, हम फीचर इम्पोर्टेंस ग्राफ से शीर्ष फीचर्स चुनकर मॉडल को ट्रेन कर सकते हैं।
मॉडल ड्रिफ्ट क्या है और प्रोडक्शन में आप इसे कैसे डिटेक्ट करते हैं?
मॉडल ड्रिफ्ट तब होता है जब समय के साथ मॉडल का प्रदर्शन घटता है क्योंकि वास्तविक दुनिया का डेटा ट्रेनिंग डेटा की तुलना में बदल जाता है। इसके दो मुख्य प्रकार हैं:
- डेटा ड्रिफ्ट (Covariate shift): इनपुट डेटा वितरण बदलता है (जैसे, उपयोगकर्ता दिन की बजाय रात में छवियाँ अपलोड करने लगते हैं)। इसे ट्रेनिंग और प्रोडक्शन फीचर डिस्ट्रीब्यूशन्स के बीच सांख्यिकीय दूरी (जैसे KL Divergence) मॉनिटर करके पकड़ा जाता है।
- कॉन्सेप्ट ड्रिफ्ट: इनपुट और आउटपुट के बीच संबंध बदलता है (जैसे, समय के साथ "स्पैम" की परिभाषा बदलना)। इसे डाउनस्ट्रीम बिज़नेस मैट्रिक्स (जैसे क्लिक-थ्रू रेट) या यदि उपलब्ध हो तो ग्राउंड-ट्रुथ एक्यूरेसी मॉनिटर करके पकड़ा जाता है।
टाइम-सीरीज़ डेटासेट के लिए आप कौन सी क्रॉस-वैलिडेशन तकनीक सुझाते हैं और क्यों?
क्रॉस-वैलिडेशन का उपयोग मॉडल के प्रदर्शन का मजबूती से मूल्यांकन करने और ओवरफिटिंग को रोकने के लिए किया जाता है। सामान्यतः, क्रॉस-वैलिडेशन तकनीकें डेटा से रैंडम सैंपल लेकर उन्हें ट्रेन और टेस्ट सेट में विभाजित करती हैं। विभाजनों की संख्या K मान पर आधारित होती है।
उदाहरण के लिए, यदि K = 5 है, तो ट्रेन के लिए चार फोल्ड और टेस्ट के लिए एक फोल्ड होंगे। यह पाँच बार दोहराया जाएगा ताकि अलग-अलग फोल्ड्स पर मॉडल के प्रदर्शन को मापा जा सके।
हम टाइम-सीरीज़ डेटासेट के साथ ऐसा नहीं कर सकते क्योंकि भविष्य के मानों का उपयोग अतीत का पूर्वानुमान लगाने के लिए करना तार्किक नहीं है। प्रेक्षणों के बीच समय-सापेक्ष निर्भरता होती है, और हम डेटा को केवल एक दिशा में विभाजित कर सकते हैं ताकि टेस्ट डेटासेट के मान ट्रेनिंग सेट के बाद के हों।
डायग्राम दिखाता है कि टाइम-सीरीज़ डेटा का K-फोल्ड स्प्लिट एकदिशात्मक होता है। नीले बिंदु ट्रेनिंग सेट हैं, लाल बिंदु टेस्ट सेट है और सफेद अप्रयुक्त डेटा है। हर इटरेशन में हम ट्रेनिंग सेट के साथ आगे बढ़ते हैं जबकि टेस्ट सेट ट्रेनिंग सेट के आगे रहता है, रैंडम रूप से चयनित नहीं।
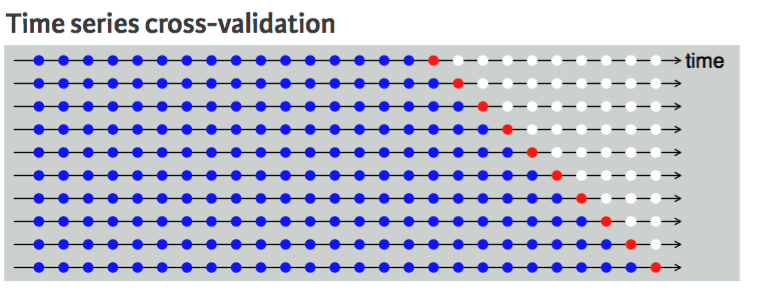
टाइम-सीरीज़ क्रॉस-वैलिडेशन | UC Business Analytics R Programming Guide
Time Series with Python लेकर टाइम-सीरीज़ डेटा का प्रबंधन, विश्लेषण, विज़ुअलाइज़ेशन और मॉडलिंग सीखें।
कंप्यूटर विज़न इंजीनियरिंग इंटरव्यू प्रश्न
LinkedIn, Glassdoor और Indeed पर मिलने वाली अधिकांश मशीन लर्निंग नौकरियाँ भूमिका-विशिष्ट होती हैं। ऐसे में इंटरव्यू में ध्यान भूमिका-विशिष्ट प्रश्नों पर होगा। कंप्यूटर विज़न इंजीनियरिंग भूमिका के लिए हायरिंग मैनेजर इमेज प्रोसेसिंग से जुड़े प्रश्नों पर फोकस करेंगे।
कंप्यूटर विज़न समस्याओं में इनपुट इतने बड़े क्यों हो सकते हैं? किसी उदाहरण से समझाइए।
मान लीजिए 250 X 250 की छवि है और पहले हिडन लेयर में 1000 हिडन यूनिट्स के साथ एक फुली-कनेक्टेड लेयर है। इस छवि के लिए इनपुट फीचर्स 250 X 250 X 3 = 187,500 होंगे, और पहले हिडन लेयर पर वेट मैट्रिक्स 187,500 X 1000 डाइमेंशनल मैट्रिक्स होगा। स्टोरेज और कम्प्यूटेशन के लिए ये संख्याएँ बहुत बड़ी हैं, और इस समस्या से निपटने के लिए हम कन्वॉल्यूशन ऑपरेशंस का उपयोग करते हैं।
Image Processing in Python का छोटा कोर्स लेकर इमेज प्रोसेसिंग सीखें
जब आपके पास छोटा डेटासेट हो, तो कन्वॉल्यूशनल न्यूरल नेटवर्क को ट्रेन करने का एक तरीका सुझाइए।
यदि आपके पास कन्वॉल्यूशनल न्यूरल नेटवर्क को ट्रेन करने के लिए पर्याप्त डेटा नहीं है, तो आप ट्रांसफर लर्निंग का उपयोग करके अपने मॉडल को ट्रेन कर सकते हैं और अत्याधुनिक परिणाम प्राप्त कर सकते हैं। आपको एक प्री-ट्रेन्ड मॉडल चाहिए जो किसी सामान्य लेकिन बड़े डेटासेट पर प्रशिक्षित हो। उसके बाद, आप मॉडल की अंतिम लेयर्स को ट्रेन करके इसे नए डेटा पर फाइन-ट्यून करेंगे।
ट्रांसफर लर्निंग डेटा वैज्ञानिकों को कम संसाधनों, कम्प्यूटिंग और स्टोरेज का उपयोग करके छोटे डेटा पर मॉडल प्रशिक्षित करने देती है। विभिन्न उपयोग-मामलों के लिए ओपन-सोर्स प्री-ट्रेन्ड मॉडल आसानी से मिल जाते हैं, और उनमें से अधिकांश का कमर्शियल लाइसेंस होता है, यानी आप उन्हें अपनी एप्लिकेशन बनाने के लिए उपयोग कर सकते हैं।
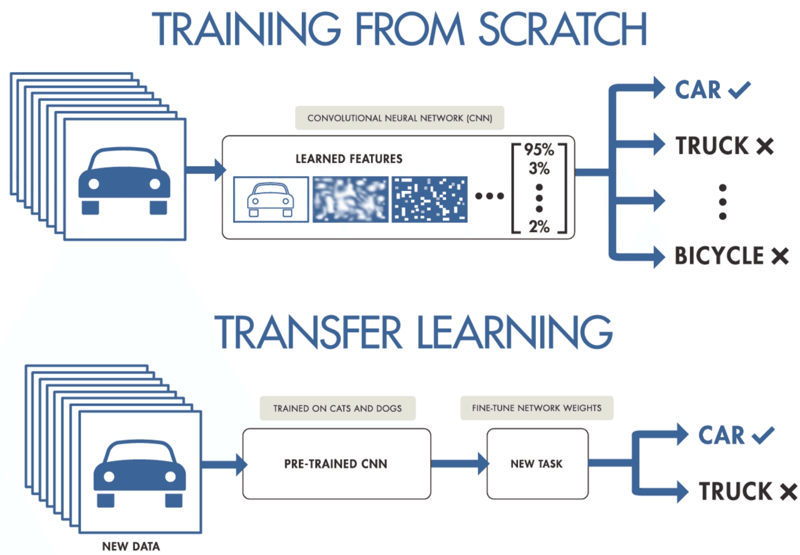
ट्रांसफर लर्निंग: purnasai gudikandula
स्टेट-ऑफ-द-आर्ट ऑब्जेक्ट डिटेक्शन एल्गोरिदम YOLO क्या है, और हाल ही में इसकी आर्किटेक्चर कैसे विकसित हुई है?
YOLO एक कन्वॉल्यूशनल न्यूरल नेटवर्क पर आधारित ऑब्जेक्ट डिटेक्शन एल्गोरिदम है, और यह रियल-टाइम परिणाम दे सकता है। YOLO एल्गोरिदम को ऑब्जेक्ट पहचानने के लिए CNN के एक ही फॉरवर्ड पास की आवश्यकता होती है। यह विभिन्न क्लास प्रॉबेबिलिटीज़ और बॉन्डरी बॉक्स दोनों की भविष्यवाणी करता है।
मॉडल को विभिन्न ऑब्जेक्ट्स का पता लगाने के लिए प्रशिक्षित किया गया था, और कंपनियाँ इसे स्वचालित ड्राइविंग, वन्यजीव संरक्षण और सुरक्षा जैसी आधुनिक एप्लिकेशंस के लिए नए डेटा पर फाइन-ट्यून करने हेतु ट्रांसफर लर्निंग का उपयोग कर रही हैं।
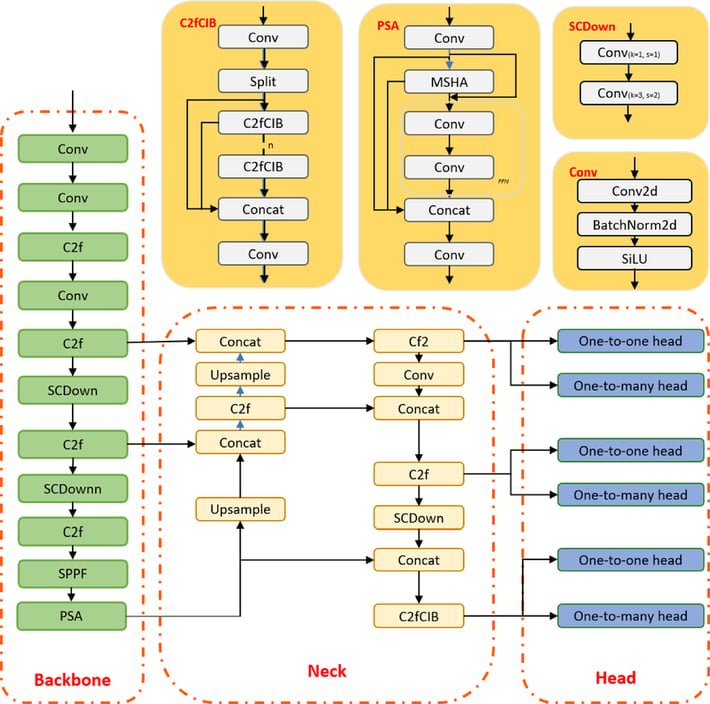
YOLOv10 मॉडल आर्किटेक्चर | researchgate
NLP इंजीनियरिंग इंटरव्यू प्रश्न
Natural Language Processing (NLP) आधुनिक AI एप्लिकेशंस की नींव में से एक है। ऐसे प्रश्नों की अपेक्षा करें जो भाषावैज्ञानिक सिद्धांत और व्यावहारिक इम्प्लीमेंटेशन के बीच पुल बनाते हैं, और आपकी क्षमता का परीक्षण करते हैं कि आप असंरचित टेक्स्ट डेटा को कैसे प्रोसेस, विश्लेषित और अर्थ-उद्धरण करते हैं—क्लासिकल तकनीकों और आधुनिक डीप लर्निंग दृष्टिकोणों, दोनों का उपयोग करके।
सिंटैक्टिक एनालिसिस क्या है?
सिंटैक्टिक एनालिसिस, जिसे सिंटैक्स एनालिसिस या पार्सिंग भी कहा जाता है, एक टेक्स्ट विश्लेषण है जो हमें वाक्य या वाक्य के किसी हिस्से के पीछे का तार्किक अर्थ बताता है। यह शब्दों के बीच संबंध और वाक्यों की व्याकरणिक संरचना पर केंद्रित होता है। आप यह भी कह सकते हैं कि यह व्याकरणिक नियमों का उपयोग करके प्राकृतिक भाषा का विश्लेषण करने की प्रक्रिया है।
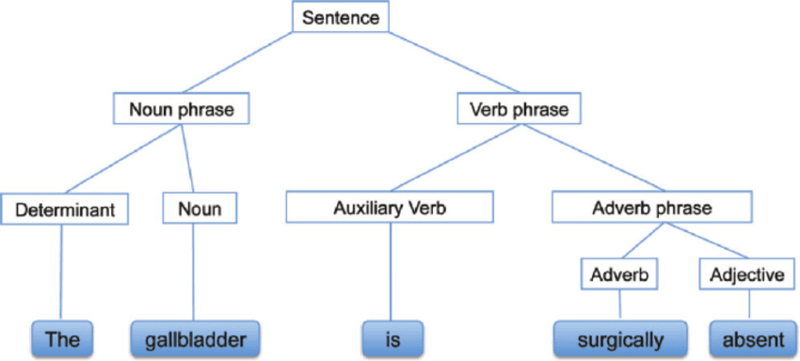
सिंटैक्टिक एनालिसिस | researchgate
स्टेमिंग और लेम्माटाइज़ेशन क्या हैं?
स्टेमिंग और लेम्माटाइज़ेशन सामान्यीकरण तकनीकें हैं जो वाक्य में शब्दों के संरचनात्मक विभिन्नताओं को कम करने के लिए उपयोग होती हैं।
स्टेमिंग, शब्द में जुड़े उपसर्ग/प्रत्यय हटाकर उसे बेस फॉर्म में छोड़ देती है। उदाहरण, Changing से Chang।
इसे सर्च इंजनों द्वारा स्टोरेज ऑप्टिमाइज़ेशन के लिए व्यापक रूप से उपयोग किया जाता है। सभी रूपों को स्टोर करने की बजाय, यह केवल स्टेम्स स्टोर करता है।
लेम्माटाइज़ेशन शब्द को उसके लेम्मा रूप में बदलता है। आउटपुट स्टेम शब्द के बजाय रूट शब्द होता है। लेम्माटाइज़ेशन के बाद हमें वैध शब्द मिलता है जिसका अर्थ होता है। उदाहरण, Changing से Change।
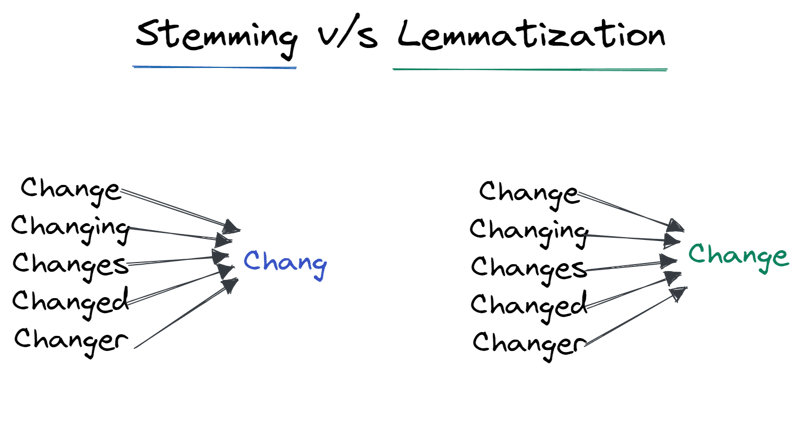
स्टेमिंग बनाम लेम्माटाइज़ेशन | लेखक
प्रोडक्शन में LLM इन्फरेंस स्पीड को ऑप्टिमाइज़ करने की आधुनिक तकनीकें क्या हैं?
बड़े ट्रांसफ़ॉर्मर्स का अनुकूलन मेमोरी बैंडविड्थ और कम्प्यूट, दोनों बॉटलनेक्स को संबोधित करने की माँग करता है:
- क्वांटाइज़ेशन: मॉडल वेट्स को FP16 (16-बिट) से INT8 या INT4 तक घटाना, न्यूनतम सटीकता हानि के साथ। इससे छोटे GPU मेमोरी में बड़े मॉडल फिट हो पाते हैं.
- PagedAttention (vLLM): एक मेमोरी मैनेजमेंट तकनीक जो KV (Key-Value) कैश को वर्चुअल मेमोरी पेज की तरह ट्रीट करती है, मेमोरी फ्रैगमेंटेशन खत्म करके 2-4x उच्च थ्रूपुट देती है.
- स्पेक्युलेटिव डिकोडिंग: एक छोटा "ड्राफ्ट" मॉडल अगले कुछ टोकन जल्दी प्रेडिक्ट करता है, जिन्हें बड़े मॉडल द्वारा समानांतर में सत्यापित किया जाता है। यह इस तथ्य का लाभ उठाता है कि एकल टोकन के लिए मेमोरी रीड/राइट अक्सर कम्प्यूट से धीमा होता है।
एक स्किल ट्रैक पूरा करके NLP की बुनियादी बातें सीखें: Natural Language Processing in Python.
LLM इंजीनियरिंग इंटरव्यू प्रश्न
वर्तमान AI परिदृश्य में LLMs का वर्चस्व है, इसलिए इंटरव्यूअर उन उम्मीदवारों को प्राथमिकता देते हैं जो इन्हें प्रभावी ढंग से डिप्लॉय करना समझते हों। यह अनुभाग 2026 की कुछ सबसे बड़ी व्यावहारिक इंजीनियरिंग चुनौतियों पर केंद्रित है।
LLM का कॉन्टेक्स्ट विंडो क्या है, और जिन कार्यों को एक बार में मॉडल से अधिक संदर्भ चाहिए, उनसे आप कैसे निपटते हैं?
LLM का कॉन्टेक्स्ट विंडो वह अधिकतम टेक्स्ट (टोकन में मापा गया) है जिसे मॉडल एक समय में प्रतिक्रिया बनाते समय ध्यान में रख सकता है, और यह सीधे तौर पर उस “वर्किंग मेमोरी” को सीमित करता है जो मॉडल के पास प्रभावी रूप से होती है।
भले ही बड़े कॉन्टेक्स्ट विंडो आम होते जा रहे हों, प्रदर्शन और लागत रैखिक रूप से नहीं बढ़ते: लंबे प्रॉम्प्ट लेटेंसी बढ़ाते हैं और जब प्रासंगिक जानकारी संदर्भ के बीचोंबीच दब जाती है तो विश्वसनीयता की समस्याएँ पैदा हो सकती हैं।
इंटरव्यू में, मैं व्यावहारिक रणनीतियाँ बताऊँगा, खासकर लंबे दस्तावेज़ों के लिए:
- चंकिंग का उपयोग करें (दस्तावेज़ों को सार्थक खंडों में विभाजित करें) और किसी दिए गए प्रश्न के लिए केवल सबसे प्रासंगिक चंक्स को रिट्रीव करें।
- जब तथ्यात्मक आधार और लक्षित रिट्रीवल चाहिए तो Retrieval-Augmented Generation (RAG) को प्राथमिकता दें, पूरे दस्तावेज़ को हर बार भेजने की बजाय—इससे लागत घटती है और “मिडिल में खो जाना” वाला व्यवहार टलता है।
- जब समग्र दृष्टि चाहिए तो सार-संक्षेप या पदानुक्रमित नोट्स (सेक्शनों का सार → सार का सार) का उपयोग करें, और विवरण ज़रूरत पर रिट्रीव करें।
बड़े भाषा मॉडलों में हेलूसिनेशन को कैसे कम करते हैं?
हेलूसिनेशन तब होती है जब LLM संभावित लगने वाली पर तथ्यात्मक रूप से गलत जानकारी जनरेट करता है। 2026 में, शमन के लिए बहु-स्तरीय दृष्टिकोण चाहिए:
- Retrieval-Augmented Generation (RAG): मॉडल को एक विश्वसनीय नॉलेज बेस से रिट्रीव किए गए दस्तावेज़ों के आधार पर ही उत्तर देने के लिए बाध्य करके ग्राउंडिंग करना।
- प्रॉम्प्ट इंजीनियरिंग: Chain-of-Thought (मॉडल से चरण-दर-चरण तर्क माँगना) और Few-Shot Prompting (सत्यापित उदाहरण देना) जैसी तकनीकें त्रुटियाँ घटाती हैं।
- कॉन्फिडेंस स्कोरिंग और सेल्फ-कंसिस्टेंसी: एक ही प्रॉम्प्ट के कई उत्तर जनरेट कर सबसे सुसंगत को चुनना, या मॉडल से उत्तर देने से पहले अपना आत्मविश्वास रेट करने को कहना।
- गार्डरेल्स: आउटपुट को उपयोगकर्ता को दिखाने से पहले नियम-आधारित परतों (जैसे NeMo Guardrails) से फैक्ट-चेक कराना।
आपको कब Retrieval-Augmented Generation (RAG) को फाइन-ट्यूनिंग पर चुनना चाहिए?
यह एक क्लासिक "ट्रेड-ऑफ़" प्रश्न है। निर्णय डेटा की नवीनता और डोमेन-विशिष्टता पर निर्भर करता है:
- RAG चुनें जब: मॉडल को अद्यतन जानकारी (जैसे, स्टॉक कीमतें, ताज़ा समाचार) या अक्सर बदलने वाला निजी डेटा एक्सेस करना हो। RAG सस्ता है और हेलूसिनेशन घटाता है क्योंकि यह मॉडल को संदर्भ में सटीक उत्तर देता है।
- फाइन-ट्यूनिंग चुनें जब: आपको मॉडल से कोई विशिष्ट व्यवहार, शैली या फ़ॉर्मैट सीखवाना हो (जैसे, समुद्री डाकू की तरह बोलना या किसी मालिकाना आंतरिक भाषा में कोड लिखना)। फाइन-ट्यूनिंग ज्ञान को वेट्स में समाहित करता है लेकिन "नॉलेज कटऑफ" समस्या हल नहीं करता।
- हाइब्रिड दृष्टिकोण: कई प्रोडक्शन सिस्टम्स में, आप मॉडल को डोमेन-विशिष्ट शब्दावली समझने के लिए फाइन-ट्यून करते हैं और फिर नवीनतम तथ्यों को देने के लिए RAG का उपयोग करते हैं।
इस प्रश्न पर विस्तार से चर्चा हमारे ब्लॉग RAG बनाम फाइन-ट्यूनिंग में की गई है।
रीइन्फोर्समेंट लर्निंग इंजीनियरिंग इंटरव्यू प्रश्न
रीइन्फोर्समेंट लर्निंग (RL) उन समस्याओं से निपटता है जहाँ एजेंट, स्थिर डेटासेट्स की बजाय, वातावरण के साथ इंटरैक्ट करके सीखता है। समझाएँ कि RL कैसे काम करता है और पॉलिसीज़ जैसी मुख्य अवधारणाएँ क्या हैं—ऐसे प्रश्नों के लिए तैयार रहें।
एक सामान्य रीइन्फोर्समेंट लर्निंग एल्गोरिदम में कौन-से चरण शामिल होते हैं?
रीइन्फोर्समेंट लर्निंग लक्ष्य तक पहुँचने के लिए ट्रायल-एंड-एरर का उपयोग करता है। यह लक्ष्य-उन्मुख एल्गोरिदम है और यह संचयी रिवार्ड को अधिकतम करने के लिए सही कदम उठाकर वातावरण से सीखता है।
सामान्य रीइन्फोर्समेंट लर्निंग में:
- शुरुआत में, एजेंट को वातावरण से स्टेट शून्य प्राप्त होता है
- स्टेट के आधार पर, एजेंट एक एक्शन लेता है
- स्टेट बदल जाता है, और एजेंट वातावरण में नई जगह पर होता है।
- यदि एजेंट ने सही कदम उठाया है, तो उसे रिवार्ड मिलता है।
- यह प्रक्रिया तब तक दोहराई जाती है जब तक एजेंट संचयी रिवार्ड को अधिकतम करके लक्ष्य तक पहुँचने का सर्वश्रेष्ठ मार्ग सीख नहीं लेता।
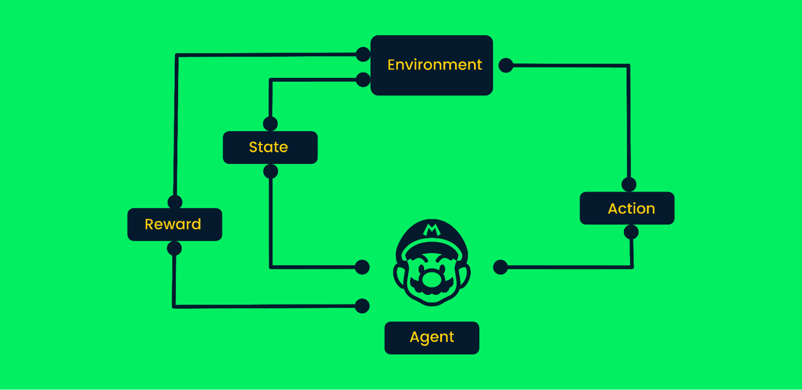
रीइन्फोर्समेंट लर्निंग फ्रेमवर्क | लेखक
ऑफ़-पॉलिसी और ऑन-पॉलिसी लर्निंग में क्या अंतर है?
ऑन-पॉलिसी लर्निंग एल्गोरिदम उसी पॉलिसी का मूल्यांकन और सुधार करते हैं जिसका उपयोग एक्शन लेने और अपडेट करने के लिए किया जाता है। दूसरे शब्दों में, अपडेट के लिए उपयोग की गई पॉलिसी और एक्शन लेने के लिए उपयोग की गई पॉलिसी एक ही होती है।
Target Policy == Behavior Policy
ऑन-पॉलिसी एल्गोरिदम हैं: Sarsa, Monte Carlo for On-Policy, Value Iteration, और Policy Iteration
ऑफ़-पॉलिसी लर्निंग एल्गोरिदम में अपडेट की गई पॉलिसी, बिहेवियर पॉलिसी से अलग होती है। उदाहरण के लिए, Q-learning में एजेंट एक ग्रीडी पॉलिसी की मदद से एक ऑप्टिमल पॉलिसी से सीखता है और अन्य पॉलिसीज़ का उपयोग करके एक्शन लेता है।
Target Policy != Behavior Policy
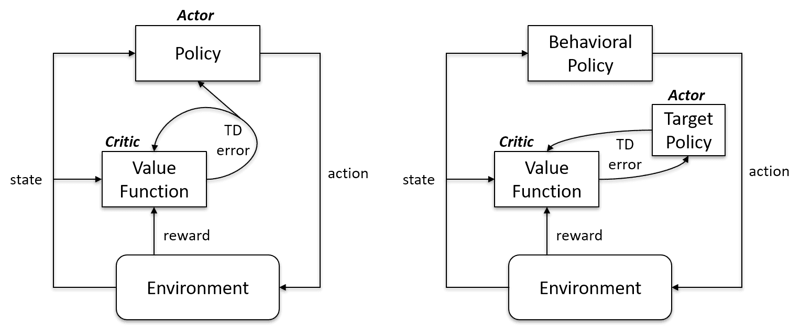
ऑन-पॉलिसी बनाम ऑफ़-पॉलिसी केस | Artificial Intelligence Stack Exchange
हमें "डीप" Q लर्निंग की आवश्यकता क्यों है?
सरल Q लर्निंग बढ़िया है। यह छोटे स्तर पर समस्या हल कर देता है, पर बड़े स्तर पर असफल हो जाता है।
कल्पना करें कि वातावरण में 1000 स्टेट्स और प्रति स्टेट 1000 एक्शंस हैं। हमें लाखों सेल्स वाली Q-टेबल चाहिए होगी। शतरंज और गो जैसे खेलों के लिए तो इससे भी बड़ी टेबल चाहिए। यहीं डीप Q-लर्निंग मदद करता है।
यह Q-वैल्यू फ़ंक्शन के सन्निकटन के लिए न्यूरल नेटवर्क का उपयोग करता है। न्यूरल नेटवर्क्स स्टेट्स को इनपुट के रूप में लेते हैं और सभी संभावित एक्शंस के Q-वैल्यू आउटपुट करते हैं।
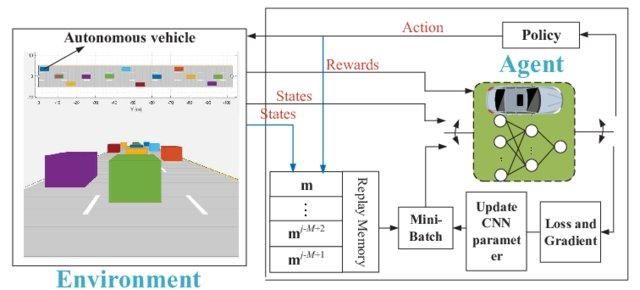
स्वायत्त ड्राइविंग के लिए डीप Q-नेटवर्क | researchgate
FAANG मशीन लर्निंग इंजीनियर प्रश्न
नीचे, हमने कुछ संभावित प्रश्न दिए हैं जो शीर्ष टेक कंपनियों में इंटरव्यूअर आपसे पूछ सकते हैं:
ROC कर्व के नीचे के क्षेत्र (AUC) की व्याख्या क्या है?
Receiver Operating Characteristics (ROC) संवेदनशीलता और विशिष्टता के बीच ट्रेड-ऑफ़ दिखाता है।
- संवेदनशीलता (Sensitivity): वह प्रायिकता कि मॉडल सकारात्मक परिणाम का पूर्वानुमान लगाए जब वास्तविक मान भी सकारात्मक हो।
- विशिष्टता (Specificity): वह प्रायिकता कि मॉडल नकारात्मक परिणाम का पूर्वानुमान लगाए जब वास्तविक मान भी नकारात्मक हो।
कर्व को फ़ॉल्स पॉज़िटिव रेट (FP/(TN + FP)) और ट्रू पॉज़िटिव रेट (TP/(TP + FN)) का उपयोग करके प्लॉट किया जाता है।
कर्व के नीचे का क्षेत्र (AUC) मॉडल का प्रदर्शन दिखाता है। यदि ROC कर्व के नीचे का क्षेत्र 0.5 है, तो हमारा मॉडल पूरी तरह रैंडम है। AUC जो 1 के क़रीब हो, वह बेहतर मॉडल दर्शाता है।
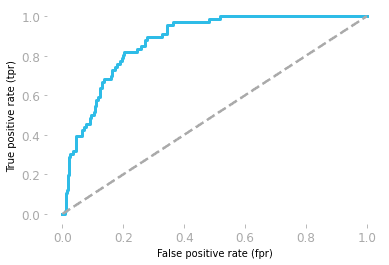
ROC कर्व Hadrien Jean द्वारा
आप जनरेटिव AI मॉडलों का मूल्यांकन कैसे करते हैं जहाँ कोई एकल "ग्राउंड ट्रुथ" नहीं होता?
क्लासिफिकेशन (जहाँ उत्तर सही या गलत है) के विपरीत, GenAI में अक्सर मानव मूल्यांकन या "LLM-as-a-Judge" फ्रेमवर्क की ज़रूरत होती है:
- रेफरेंस-फ्री मैट्रिक्स: किसी मज़बूत मॉडल (जैसे GPT-4) का उपयोग छोटे मॉडल की प्रतिक्रिया का "सहायकता", "सुरक्षा" और "सुसंगतता" जैसे मानदंडों पर ग्रेड करने के लिए।
- RAGAS (Retrieval Augmented Generation Assessment): एक मानक फ्रेमवर्क जो विशेष रूप से "faithfulness" (क्या उत्तर संदर्भ से आया?) और "answer relevance" (क्या इसने उपयोगकर्ता के प्रश्न का उत्तर दिया?) मापता है।
- मानव मूल्यांकन (Elo Ratings): अंतिम सत्यापन के लिए, दो मॉडल आउटपुट को साथ-साथ तुलना करना (A/B टेस्टिंग) और Elo रेटिंग निकालना, जैसा कि LMArena लीडरबोर्ड में होता है।
डायमेंशनलिटी घटाने के तरीके क्या हैं?
डायमेंशनलिटी रिडक्शन के लिए हम फीचर सेलेक्शन या फीचर एक्सट्रैक्शन तरीकों का उपयोग कर सकते हैं।
फीचर सेलेक्शन इष्टतम फीचर्स का चयन करने और अप्रासंगिक फीचर्स को हटाने की प्रक्रिया है। हम फ़िल्टर, रैपर और एम्बेडेड तरीकों का उपयोग करके फीचर इम्पोर्टेंस का विश्लेषण करते हैं और कम महत्वपूर्ण फीचर्स को हटाकर मॉडल प्रदर्शन में सुधार करते हैं।
फीचर एक्सट्रैक्शन बहु-आयामी स्पेस को कम आयामों में बदलता है। प्रक्रिया के दौरान कोई जानकारी नहीं खोती और डेटा प्रोसेस करने के लिए कम संसाधन लगते हैं। सबसे सामान्य एक्सट्रैक्शन तकनीकें हैं Linear Discriminant Analysis (LDA), Kernel PCA, और Quadratic Discriminant Analysis।
आप किसी क्लासिफायर के लिए थ्रेशोल्ड कैसे ढूँढते हैं?
स्पैम क्लासिफायर के मामले में, लॉजिस्टिक रिग्रेशन मॉडल प्रायिकता लौटाएगा। हम या तो 0.8999 जैसी प्रायिकता का उपयोग करते हैं या थ्रेशोल्ड से इसे क्लास (Spam/Not Spam) में बदलते हैं।
आम तौर पर, क्लासिफायर का थ्रेशोल्ड 0.5 होता है, पर कुछ मामलों में सटीकता सुधारने के लिए हमें इसे फाइन-ट्यून करना होता है। 0.5 थ्रेशोल्ड का मतलब है कि यदि प्रायिकता 0.5 के बराबर या उससे अधिक है तो वह स्पैम है, और यदि कम है तो स्पैम नहीं है।
थ्रेशोल्ड ढूँढने के लिए, हम Precision-Recall कर्व्स और ROC कर्व्स, ग्रिड सर्च, और मान को मैन्युअली बदलकर बेहतर CV प्राप्त करने का उपयोग कर सकते हैं।
Machine Learning Scientist with Python करियर ट्रैक पूरा करके प्रोफेशनल मशीन लर्निंग इंजीनियर बनें।
लिनियर रिग्रेशन की धारणाएँ क्या हैं?
लिनियर रिग्रेशन का उपयोग फीचर्स (X) और टार्गेट (y) के बीच संबंध समझने के लिए होता है। मॉडल को ट्रेन करने से पहले हमें कुछ धारणाएँ पूरी करनी होती हैं:
- रेज़िडुअल्स स्वतंत्र हों
- X स्वतंत्र वेरिएबल और y आश्रित वेरिएबल के बीच रैखिक संबंध हो।
- X के हर स्तर पर रेज़िडुअल वैरिएंस स्थिर हो
- रेज़िडुअल्स सामान्य वितरण का पालन करें।
नोट: लिनियर रिग्रेशन में रेज़िडुअल्स वास्तविक और भविष्यवाणी किए गए मानों के बीच का अंतर होते हैं।
एक फ़ंक्शन find_bigrams लिखें जो एक स्ट्रिंग ले और सभी बाइग्राम्स की सूची लौटाए।
कोडिंग इंटरव्यू के दौरान आपसे मशीन लर्निंग समस्याओं के बारे में पूछा जाएगा, लेकिन कुछ मामलों में आपकी Python कौशल का आकलन करने के लिए सामान्य कोडिंग प्रश्न भी पूछे जाएँगे। Python Programmer करियर ट्रैक लेकर विशेषज्ञ Python प्रोग्रामर बनें।
बाइग्राम फ़ंक्शन बनाना काफी आसान है। आपको zip फ़ंक्शन के साथ दो लूप्स का उपयोग करना है।
- बाइग्राम फ़ंक्शन में, हम इनपुट के रूप में वाक्यों की सूची लेते हैं
- एकल वाक्य तक पहुँचने के लिए लूप बनाना
- वाक्य को लोअर करना और शब्दों की सूची में बाँटना
zipका उपयोग करके पिछले शब्द और अगले शब्द के संयोजन बनाना- आउटपुट को परिणाम में जोड़ना
- परिणाम प्रिंट करना।
यदि आप समस्या को तोड़कर zip फ़ंक्शन का उपयोग करें तो यह काफी आसान है।
def bigram(text_list:list):
result = []
for ls in text_list:
words = ls.lower().split()
for bi in zip(words, words[1:]):
result.append(bi)
return result
text = ["Data drives everything", "Get the skills you need for the future of work"]
print(bigram(text))परिणाम:
[('Data', 'drives'), ('drives', 'everything'), ('Get', 'the'), ('the', 'skills'), ('skills', 'you'), ('you', 'need'), ('need', 'for'), ('for', 'the'), ('the', 'future'), ('future', 'of'), ('of', 'work')]मशीन लर्निंग में एक्टिवेशन फ़ंक्शन क्या है?
एक्टिवेशन फ़ंक्शन न्यूरल नेटवर्क्स में एक नॉन-लीनियर ट्रांसफ़ॉर्मेशन है। हम इनपुट को अगली लेयर में भेजने से पहले एक्टिवेशन फ़ंक्शन से गुजारते हैं।
नेट इनपुट मान -अनंत से +अनंत तक कुछ भी हो सकते हैं, और न्यूरॉन को इन मानों को सीमाबद्ध करना नहीं आता, इसलिए फ़ायरिंग पैटर्न तय नहीं कर पाता। एक्टिवेशन फ़ंक्शन तय करता है कि किसी न्यूरॉन को सक्रिय होना चाहिए या नहीं, ताकि नेट इनपुट मान सीमाबद्ध रहें।
सबसे सामान्य एक्टिवेशन फ़ंक्शंस:
- स्टेप फ़ंक्शन
- सिग्मॉइड फ़ंक्शन
- ReLU
- लीकी ReLU
आप Facebook पर रेस्तरां की रिकमेंडेशन कैसे बनाएँगे?
उत्तर पूरी तरह आपके ऊपर है। लेकिन उत्तर देने से पहले, आपको यह देखना चाहिए कि आप किस व्यावसायिक लक्ष्य को प्राप्त करना चाहते हैं ताकि प्रदर्शन मीट्रिक तय कर सकें और डेटा कैसे प्राप्त करेंगे।
एक सामान्य मशीन लर्निंग सिस्टम डिज़ाइन में, हम:
- डेटा एकत्र, साफ़ और विश्लेषित करते हैं।
- फीचर इंजीनियरिंग करते हैं
- किसी कार्यप्रणाली, एल्गोरिदम या मशीन लर्निंग मॉडल का चयन करते हैं
- टेस्ट और वैलिडेशन डेटासेट्स पर प्रदर्शन का आकलन करते हुए ट्रेन करते हैं।
- प्रक्रियाओं को सुगम बनाते हैं और मॉडल को प्रोडक्शन में डिप्लॉय करते हैं।
सुनिश्चित करें कि आप थ्योरी या मॉडल आर्किटेक्चर की बजाय डिज़ाइन पर फोकस कर रहे हैं। मॉडल इन्फरेंस पर बात करें और कैसे इसे सुधारने से समग्र राजस्व बढ़ सकता है।
साथ ही, इस बात का अवलोकन दें कि आपने एक कार्यप्रणाली को दूसरी पर क्यों चुना।
DataCamp पर कोर्स लेकर रिकमेंडेशन सिस्टम बनाना सीखें।
दो स्ट्रिंग A और B दिए गए हैं, एक फ़ंक्शन can_shift लिखें जो बताए कि क्या A को कुछ स्थानों पर शिफ्ट करके B बनाया जा सकता है।
कोडिंग चुनौतियाँ हल करना और अपनी Python कौशल पर काम करना आपको कोडिंग इंटरव्यू चरण पार करने की संभावना बढ़ाएगा।
समस्या सुलझाने में कूदने से पहले, प्रश्न समझें। आपको बस एक बूलियन फ़ंक्शन बनाना है जो True लौटाए यदि String B के अक्षरों को शिफ्ट करने पर आपको String A मिल जाए।
A = 'abid'
B = 'bida'
can_shift(A, B) == True- यदि स्ट्रिंग की लंबाई समान नहीं है तो False लौटाएँ।
- स्ट्रिंग A की लंबाई की रेंज पर लूप चलाएँ
- mut_a बनाएँ ताकि String A का उपयोग कर विभिन्न कैरेक्टर संयोजन बन सकें
- लूप के दौरान, यदि mut_a String B के बराबर हो तो True लौटाएँ, अन्यथा False लौटाएँ।
def can_shift(a, b):
if len(a) != len(b):
return False
for i in range(len(a)):
mut_a = a[i:] + a[:i]
if mut_a == b:
return True
return False
A = 'abid'
B = 'bida'
print(can_shift(A, B))
>>> Trueएन्सेम्बल लर्निंग क्या है?
एन्सेम्बल लर्निंग का उपयोग कई मशीन लर्निंग मॉडलों की अंतर्दृष्टियों को संयोजित करने के लिए किया जाता है ताकि सटीकता और प्रदर्शन मैट्रिक्स में सुधार किया जा सके।
सरल एन्सेम्बल तरीके:
- मीन/एवरेज: हम कई उच्च-प्रदर्शन करने वाले मॉडलों की भविष्यवाणियों का औसत लेते हैं।
- वेटेड एवरेज: हम प्रदर्शन के आधार पर मॉडलों को अलग-अलग वेट देते हैं और फिर उन्हें संयोजित करते हैं।
उन्नत एन्सेम्बल तरीके:
- बैगिंग का उपयोग वैरिएंस त्रुटियाँ कम करने के लिए होता है। यह ट्रेनिंग डेटा के सबसेट्स रैंडमली बनाता है और मॉडलों पर ट्रेन करता है। मॉडलों का संयोजन वैरिएंस घटाता है और एकल मॉडल की तुलना में अधिक विश्वसनीय बनाता है।
- बूस्टिंग का उपयोग बायस त्रुटियाँ घटाने और बेहतर प्रिडिक्टिव मॉडल बनाने के लिए होता है। यह एक इटरेटिव एन्सेम्बल तकनीक है जो पिछली क्लासिफिकेशन के आधार पर वेट्स समायोजित करती है। बूस्टिंग एल्गोरिदम उन ऑब्ज़र्वेशंस को अधिक वेट देते हैं जिन्हें पिछले मॉडल ने गलत भविष्यवाणी किया था।
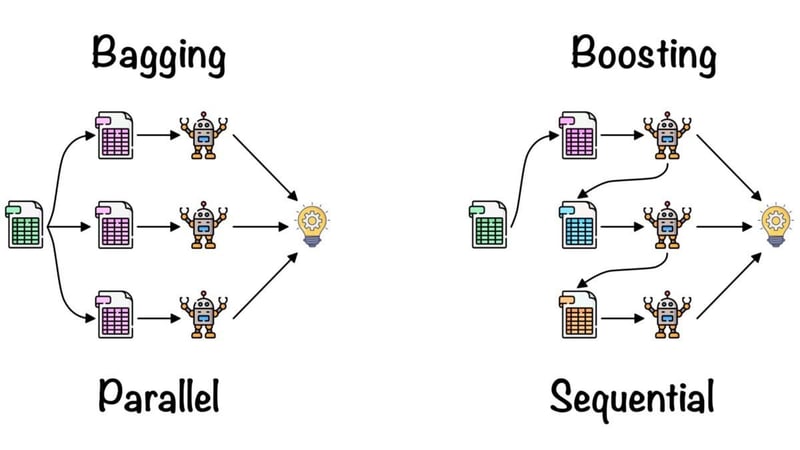
बैगिंग और बूस्टिंग: Fernando López
एवरेजिंग, बैगिंग, स्टैकिंग और बूस्टिंग के बारे में अधिक जानने के लिए Ensemble Methods in Python कोर्स पूरा करें।
निष्कर्ष
आवश्यक मशीन लर्निंग इंटरव्यू प्रश्नों की इस समीक्षा के समापन पर स्पष्ट है कि ऐसे इंटरव्यू में सफल होने के लिए सैद्धांतिक ज्ञान, व्यावहारिक कौशल और इस क्षेत्र की नवीनतम प्रवृत्तियों व तकनीकों की समझ—इन सबका मिश्रण चाहिए। सेमी-सुपरवाइज्ड लर्निंग और एल्गोरिदम चयन जैसी बुनियादी अवधारणाओं से लेकर KNN जैसे विशिष्ट एल्गोरिदम की जटिलताओं तक, और NLP, कंप्यूटर विज़न या रीइन्फोर्समेंट लर्निंग में भूमिका-विशिष्ट चुनौतियों तक—दायरा व्यापक है।
चाहे आप इस क्षेत्र में प्रवेश करने वाले शुरुआती हों या आगे बढ़ना चाहने वाले अनुभवी प्रैक्टिशनर, सतत सीखना और अभ्यास ही कुंजी है। DataCamp एक व्यापक Machine Learning Scientist with Python ट्रैक प्रदान करता है, जो आपकी कौशल वृद्धि के लिए संरचित और गहन मार्ग देता है।
FAQs
मशीन लर्निंग इंटरव्यू कैसा होता है?
आम तौर पर, मशीन लर्निंग तकनीकी इंटरव्यू कई भागों में विभाजित होते हैं:
- कोडिंग इंटरव्यू
- एल्गोरिदम और डेटा प्रोसेसिंग
- भूमिका-विशिष्ट इंटरव्यू
- ML सिस्टम डिज़ाइन इंटरव्यू
- मशीन लर्निंग संचालन और सर्वश्रेष्ठ प्रथाएँ
नॉन-टेक्निकल या ऑन-साइट इंटरव्यू भी प्रक्रिया का हिस्सा होते हैं, पर वे अधिक सामान्य और कंपनी-विशिष्ट होते हैं।
Amazon में मशीन लर्निंग इंटरव्यू पास करना आसान है?
नहीं, आपको इंटरव्यू के विभिन्न चरणों की तैयारी करनी होती है। आपको ऑनलाइन असेसमेंट टेस्ट, रिक्रूटर फोन स्क्रीन, तकनीकी फोन स्क्रीन और ऑनसाइट इंटरव्यू की तैयारी करनी होगी। हर चरण आपके कौशल और ज्ञान की जाँच करता है।
क्या मशीन लर्निंग इंजीनियरों के कोडिंग इंटरव्यू होते हैं?
हाँ। यह आपके Python समस्या-समाधान कौशल और SQL डेटा विश्लेषण कौशल का परीक्षण करेगा। साथ ही, आपसे मशीन लर्निंग टूल्स के बारे में भी पूछा जाएगा। बेहतर है कि DataCamp असेसमेंट टेस्ट जैसी कोडिंग चुनौतियों से अभ्यास करें।
AI/ML इंजीनियर द्वारा किए जाने वाले मुख्य कार्य क्या हैं?
आमतौर पर, AI/ML इंजीनियर मशीन लर्निंग सिस्टम्स पर शोध, डिज़ाइन और विकास करते हैं, पर यह नौकरी और कंपनी के अनुसार बदल सकता है।
इसके अतिरिक्त:
- वे डेटा साफ़ करते हैं, डेटा वैलिडेशन करते हैं, और मॉडल ट्रेनिंग के लिए डेटा ऑगमेंट करते हैं।
- बेहतर परिणामों के लिए मॉडल आर्किटेक्चर और हाइपरपैरामीटर्स ट्यून करते हैं।
- व्यवसाय और डेटा उपलब्धता को समझते हैं।
- प्रदर्शन मैट्रिक्स, एल्गोरिदम और डिप्लॉयमेंट रणनीति।
- कभी-कभी वे क्लाउड कम्प्यूटिंग और डेवलपमेंट ऑपरेशंस में भी शामिल होते हैं।
मैं मशीन लर्निंग इंटरव्यू की तैयारी कैसे करूँ?
कंपनी और नौकरी की ज़िम्मेदारियों के बारे में जानें, कोडिंग चुनौतियाँ हल करें, पिछले प्रोजेक्ट्स की समीक्षा करें, एंड-टू-एंड मशीन लर्निंग लाइफसाइकल को डिज़ाइन और सीखें, मॉक इंटरव्यू प्रश्नों का अभ्यास करें, और AI/ML क्षेत्र में नवीनतम विकास के बारे में पढ़ें। यह महत्वपूर्ण है—चाहे आप अभी मशीन लर्निंग इंजीनियर बनना शुरू कर रहे हों, या वर्षों का पेशेवर अनुभव रखते हों।
इस लेख में, हमने उद्योग में किसी भूमिका के लिए आवेदन करते समय या किसी उम्मीदवार का इंटरव्यू लेते समय मिलने वाले कुछ सबसे सामान्य मशीन लर्निंग इंटरव्यू प्रश्नों का संकलन किया है। इन प्रश्नों का अभ्यास करना और उत्तर तैयार रखना आपको इंटरव्यू को सुचारू रूप से आगे बढ़ाने में मदद कर सकता है।