
为什么 DAG 在数据工程中很重要
作为数据工程师或承担数据工程任务的人,您常常需要构建复杂的数据流水线,其中各步骤相互依赖。这正是 DAG 大显身手的地方!
由于可以将任务表示为节点、将依赖表示为边,DAG 能够强制执行逻辑的执行顺序,确保任务依据依赖关系按序执行,防止因乱序运行而导致的错误和不一致。此外,如果某一步失败,DAG 能识别并重新运行受影响的任务,从而节省时间和精力。
如果您刚开始构建数据流水线或想夯实基础,Understanding Data Engineering 课程是很好的起点。
DAG 的无环特性是其适用于数据流水线的关键特征之一。它确保任务执行不会出现无限循环或递归依赖,从而避免系统不稳定。
我们来看一个简单的数据流水线示例:
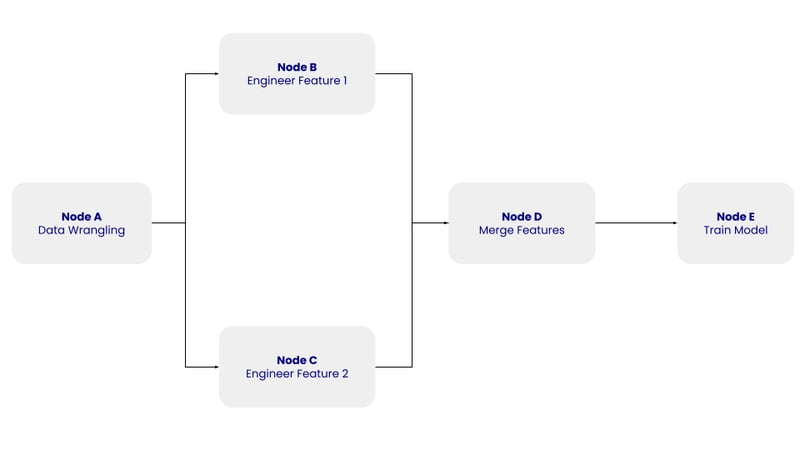 该简单 DAG 的结构:节点 A、B、C、D、E 及其依赖关系。作者绘制。
在上述 DAG 中,节点 A 表示数据整形步骤,其中包含数据清洗,即对提取的数据进行清洗和预处理。节点 B 和 C 表示特征工程步骤,对清洗后的数据分别独立地构造两个特征。节点 D 负责合并这些特征。最后,节点 E 表示模型训练步骤,即在变换后的数据上训练机器学习模型。
DAG 并不关心任务内部发生了什么,而是关心它们应被执行的顺序。
此外,DAG 使您能够创建自动化、可扩展的数据工作流,尤其适用于分布式系统和云环境。它将复杂的数据处理任务拆解为更小、独立、易于管理的子任务,从而实现并行执行与高效的资源利用。面对大型数据集和复杂流水线时,这种可扩展性尤为重要,因为它能实现更具成本效益的数据处理。
最后,DAG 能为任何数据流水线提供可视化表示,帮助您理解并传达工作流。这种视觉清晰度在与其他团队成员或非技术相关方协作时非常重要。只要您能理解数据的流动和任务之间的依赖关系,就更容易定位并修复问题、优化资源利用,并就流水线改进做出明智决策。
关于动手创建与优化数据流水线,ETL and ELT in Python 课程是极好的实践资源。
DAG 在数据工程中的常见用途
DAG 被广泛采用,并在数据工程中有多种应用。我们在上一节中已提到其中一些。现在,让我们更详细地看看几个场景。
ETL 流水线
DAG 最常见的应用之一是编排抽取、转换与加载(ETL)过程。ETL 流水线涉及从各类源中抽取数据,将其转化为合适的格式,并加载到目标系统。
例如,Apache Airflow 和 Luigi 等工具使用 DAG 高效编排 ETL 流水线。一个实际用例可能是整合来自 CRM 系统的数据,将其转换以符合业务需求,并加载到用于分析的 Snowflake 数据仓库。
您还可以利用 DAG 监控并记录 ETL 过程中任务的运行时长,从而帮助识别瓶颈或需要优化的任务。
复杂工作流编排
DAG 也非常适合管理包含多个任务与依赖关系的复杂数据工作流。例如,机器学习工作流可能包括特征工程、模型训练和模型部署等任务。
例如,在Apache Airflow 中的 DAG 可能会先执行特征选择脚本,并仅在特征处理完成后才触发模型训练,从而确保依赖管理与可复现性。
数据处理流水线
DAG 广泛用于数据处理流水线中,以管理来自多个数据源的数据流,并将其转化为有价值的洞见。例如,在 Apache Spark 中的 DAG 可能会处理网站的点击流数据,执行聚合以计算会话时长,并将洞见输送到仪表板。
Spark 中的 DAG 并非由用户显式定义,而是由框架在内部创建,用于优化转换的执行。
机器学习流水线
在机器学习中,DAG 有助于应对工作流的迭代性与模块化特征。它们允许您在保持流水线有序的同时,尝试不同的预处理步骤、算法和超参数。
Kubeflow Pipelines 和 MLflow 等工具使用 DAG 管理机器学习工作流,实现无缝试验与部署。例如,您可以使用 DAG 启用由数据漂移检测触发的重训练流水线,确保模型随时间保持准确且相关。
管理 DAG 的热门数据工程工具
您可以使用多种工具来高效管理与编排 DAG。下面介绍几个最受欢迎的选项:
Apache Airflow
Apache Airflow 是一个广泛使用的平台,用于创建、调度和监控工作流。它擅长将复杂的数据流水线定义为 DAG。Airflow 提供了用户友好的界面来可视化和管理这些 DAG,使理解与排查数据工作流变得更容易。其灵活性与可扩展性使其成为许多数据工程团队的首选。
Prefect
Prefect 是一款现代编排工具,简化了数据工作流的创建与管理。它提供基于 Python 的 API 来定义 DAG,便于与现有 Python 代码集成。Prefect 重视可靠性与可观测性,提供自动重试、回填与强大的监控等功能。
Dask
Dask 是一个 Python 的并行计算库,用于管理分布式数据工作流。它可以在多核或多台机器上并行化计算,非常适合大规模数据处理任务。Dask 采用基于 DAG 的执行模型来调度与协调任务,确保高效的资源利用。
Kubeflow Pipelines
Kubeflow Pipelines 是一个用于构建与部署可扩展机器学习工作流的开源平台。它使用 DAG 来定义从数据预处理到模型部署的端到端工作流。其与 Kubernetes 的紧密集成使其非常适合在云环境中运行工作流。Kubeflow 还提供可视化界面来管理与监控工作流,提升透明度与可控性。
Dagster
Dagster 是一个为现代数据工作流而设计的编排平台。它强调模块化与类型安全,使测试与维护 DAG 更加容易。Dagster 能与 Apache Spark、Snowflake 和 dbt 等流行工具集成,非常适合技术栈多样化的数据工程团队。
动手示例:在 Apache Airflow 中创建基础 DAG
设置 Apache Airflow
在创建 DAG 之前,您需要先安装并设置 Apache Airflow。您可以使用 Docker 或 pip 等软件包管理器进行安装:
pip install apache-airflow安装完成后,您需要配置 Airflow 的 Web 服务器和调度器。这包括设置并初始化数据库连接,然后启动 Web 服务器:
airflow db init
airflow webserver --port 8080定义一个简单的 DAG
完成 Airflow 设置后,您可以创建自己的 DAG。可用 Python 按如下方式定义 DAG 及其任务:
from airflow import DAG
from airflow.operators.bash import BashOperator
from datetime import datetime
with DAG(
'simple_dag',
start_date=datetime(2023, 1, 1),
schedule_interval=None,
catchup=False
) as dag:
task1 = BashOperator(
task_id='task_1',
bash_command='echo "Hello, World!"'
)
task2 = BashOperator(
task_id='task_2',
bash_command='echo "This is task 2"'
)
task1 >> task2在这个示例中,简单的 DAG 包含两个任务:task_1 和 task_2。>> 运算符设置了任务间的依赖,确保 task_2 只会在 task_1 完成后执行。
运行并监控 DAG
在定义并部署 DAG 到 Airflow 后,您可以通过 Web 界面与之交互。
DAG 的运行方式有两种:
- 您可以手动触发或通过 API 触发
- 您可以定义调度。DAG 不要求必须有调度,但通过
schedule参数定义调度非常常见。
每次运行 DAG时,都会创建该 DAG 的一个新实例,称为 DAG run。同一 DAG 可以并行运行多个 DAG Run,每个都有定义的数据区间,用于标识任务应操作的数据时间范围。
触发后,您可以在 DAG 视图中监控其进度,该视图以可视化方式展示工作流。
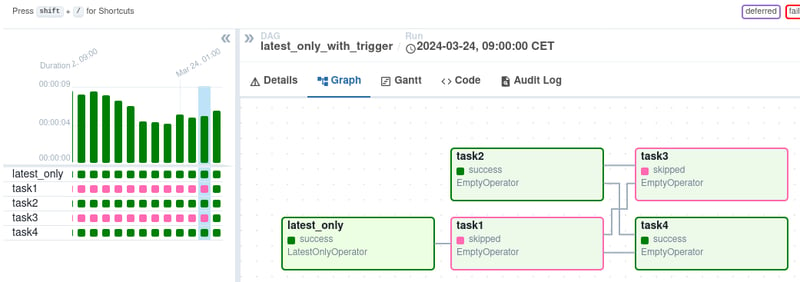 Airflow 界面中的 DAG 视图。图片来源:Airflow
在Graph 视图中,您可以详细查看特定的 DAG Run,包括任务依赖与执行时间。Task Instances 视图提供单个任务的细粒度信息,包括其状态、开始与结束时间以及日志。您可以查看任务日志以排查错误并了解失败的根因。该Task Instances 视图还显示任务时长,帮助您识别潜在的性能问题。
结论
DAG 是数据工程中的基础概念,提供了以可视化、结构化方式表示复杂工作流的方法。理解节点、边与依赖关系,有助于您高效设计与管理数据流水线。
DAG 被广泛用于编排 ETL 过程、管理数据处理流水线以及自动化机器学习工作流。您可以借助 Apache Airflow、Prefect 和 Dask 等工具高效创建与管理 DAG。这些工具提供用户友好的界面、调度功能,以及高级监控、错误处理与扩展能力。
若想获得实操经验,这门 Airflow in Python 入门课程可帮助您学习如何高效创建与管理 DAG。若想更广泛地理解数据工程概念与工作流,这门数据工程理解课程将为您打下坚实基础!
FAQs
DAG 与流程图有什么不同?
尽管 DAG 和流程图都用于可视化流程:
- DAG 侧重于任务依赖与执行顺序,常用于计算型工作流。
- 流程图则更广泛地展示决策流程与逻辑,不局限于任务依赖。
DAG 能处理实时数据工作流吗?
是的,许多工具(如 Apache Airflow 和 Prefect)支持实时或准实时数据工作流。例如,Airflow 的传感器可监控数据到达并触发工作流,而 Prefect 则允许基于实时触发器动态执行任务。
使用 DAG 存在哪些常见挑战?
常见挑战包括:
- 复杂性管理:包含大量任务的大型工作流可能难以调试与维护。
- 性能瓶颈:优化不佳的 DAG 可能导致任务执行延迟。
- 工具的学习曲线:掌握 Airflow 或 Prefect 等工具需要时间与实践。
DAG 如何改进工作流中的错误处理?
DAG 通过以下方式改进错误处理:
- 跟踪依赖以定位任务失败的根因。
- 允许对特定失败任务进行部分重跑,而无需重执行整个工作流。
- 在 Airflow 和 Prefect 等工具中提供监控功能,包含详细日志与错误通知。
工作流编排是否有 DAG 的替代方案?
虽然 DAG 很受欢迎,但事件驱动架构或状态机等其他模型也可用于管理工作流。不过,对于复杂的流水线,这些替代方案可能不具备 DAG 所提供的那种清晰性与依赖管理能力。

作者
Maria Eugenia Inzaugarat
数据工作流和流水线常常需要精确协调,以确保任务按正确的顺序执行。有向无环图(DAG)是一种强大的工具,能够高效管理这些工作流并避免出错。
在本文中,我们将探讨 DAG 及其在数据工程中的重要性,回顾其一些应用场景,并通过一个使用 Airflow 的动手示例来理解如何使用它们。
什么是 DAG?
要理解什么是 DAG,我们先定义一些关键概念。在计算机科学中,图是一种非线性数据结构,由节点和边组成。节点代表独立的实体或对象,边用于连接这些节点,表示它们之间的关系或关联。
在有向图中,这些边具有特定方向,表示节点之间的单向关系。这意味着如果存在一条从节点 A 指向节点 B 的边,则表示从 A 到 B 的连接,但并不一定存在从 B 到 A 的连接。
有向图的可视化说明。图片来源:Astronomer
一条路径是由有向边连接起来的节点序列。它从某个特定节点出发,沿着边的方向到达另一个节点。只要始终遵循边的方向,路径可以是任意长度,从单个节点到多个节点的序列。
有了这些基本定义,让我们看看什么是 DAG:DAG 是一种没有有向环的有向图,其中每个节点代表一个具体任务,每条边表示它们之间的依赖关系。
DAG 的关键在于其无环性,也就是说,一旦从某个节点开始,您只能向前推进,无法回到先前的节点。这样可以确保任务按顺序执行,避免陷入无限循环。DAG 往往具有分层结构,任务按层级组织。较高层的任务通常依赖于较低层任务的完成。