
什么是数据匿名化?
在数据科学中,数据匿名化指的是以一种方式修改数据集,使得基于可用数据识别个人变得不可能或非常困难的过程。
本质上,数据匿名化过程包括从数据集中移除或转换可识别个人身份的信息(PII),例如姓名和地址,同时仍保留数据用于分析的实用性。
它还可最大限度降低数据泄露与重新识别的风险,使我们能够在不损害个人隐私的情况下安全地共享和分析数据。
一个著名的非严格数据匿名化案例发生在2006年。当时 Netflix 为改进其推荐系统的 Netflix Prize 竞赛发布了包含用户数据的电影数据集。
德克萨斯大学的研究人员利用公开可得的 IMDb 数据重新识别了个体,证明了该匿名化数据的脆弱性。此事件引发了对数据匿名化技术有效性的重大担忧,并凸显了更为严谨方法的必要性。
数据匿名化技术
移除 PII 并非数据匿名化的唯一方法。在某些情况下,还可以对数据进行泛化,以降低数据集中个体的唯一性。例如,用年龄区间替代精确年龄。此外,还可以通过引入轻微不准确性来扰动数据,使得新数据更难与具体个人建立关联。
了解不同的数据匿名化技术有助于我们为具体用例选择最合适的方法。本节将介绍最常见的几种技术。
泛化
如上所述,数据匿名化并不只是移除 PII。与其删除数据,泛化会将数据转换为更广泛、更难识别的形式。换言之,泛化通过降低数据粒度来防止身份识别。这样既能让数据在分析中保持用处,又能降低重新识别的风险。
例如,在处理出生日期等个人数据时,可不显示精确日期,而是将数据泛化为某年某月,或仅保留年份,以在防止识别的同时,保持对年龄段分析的相关性。下表展示了在年龄与位置数据上通过泛化进行数据匿名化的一些简单示例:
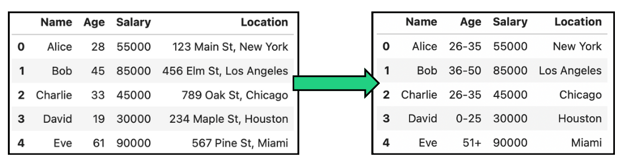
在年龄和位置数据中通过泛化实现数据匿名化的示例。
该技术主要用于人口统计研究和市场调研,但可能会导致数据效用下降,使细粒度分析变得困难。
泛化通常与其他技术结合使用,例如K-匿名性,即对多条记录进行泛化,直到它们与至少另外 k 条记录无法区分,从而降低重新识别个体的风险。
数据扰动
在某些分析中,个体数据点的精确值并非必要,而总体分布更为重要,此时可以应用数据扰动。它是指在受控的方式下修改原始数据以保护隐私。这种修改可以包括随机化、缩放或交换值等多种技术。数据扰动旨在模糊数据,同时保留其分析价值。
加噪
数据扰动的一个具体做法是加噪。加噪是指向数据引入随机或系统性的变化,即所谓的“噪声”。这些噪声会掩盖敏感数据点的真实值,使重新识别个体变得更加困难。下图中,我们对上表中的原始薪资数据添加了高斯噪声:
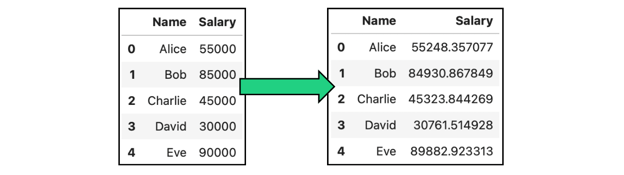
在包含薪资的数据中通过加噪实现数据匿名化的示例。
合成数据生成
与其向真实数据中添加噪声,数据匿名化的另一种方法是在特定条件下生成假数据。合成数据生成是指创建在统计属性上与原始数据相似的人工数据集,但不包含真实、可识别的信息。它为分析符合隐私要求、且能模拟原始数据模式与结构的数据集提供了替代方案。
要生成与原数据分布一致的数据,需要进行统计建模,以识别需要复制的模式、关系和分布。总体而言,合成数据生成的实施难度较高。
推荐参考以下资源以了解更多:
- Alexandra Ebert 的网络研讨会Using Synthetic Data for Machine Learning & AI in Python。
- Abid Ali Awan 撰写的文章Creating Synthetic Data with Python Faker Tutorial。
假名化
假名化是指用假名或虚构标识符替换数据集中的标识符,以防止直接识别个体。与完全匿名化不同,假名化数据可通过将假名与真实身份关联的密钥重新识别。
该技术常用于医学研究、数据分析和客户数据处理,可在不暴露个人身份的情况下进行分析,同时在安全环境中保留可追溯选项。
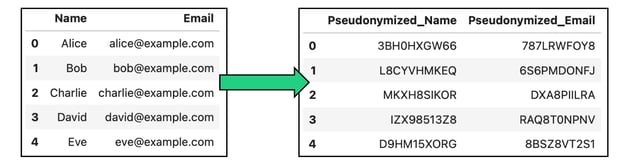
在包含姓名和邮箱的数据中通过假名化实现数据匿名化的示例。
数据遮蔽
另一种常用技术是数据遮蔽,即在保持原始数据格式与结构的同时对其进行修改或混淆。在实践中,数据遮蔽有两种不同的方法:
- 静态数据遮蔽(SDM):一种永久性方法,在所有数据点上以一致方式更改敏感数据。实施 SDM 后,敏感数据将不再暴露,且无法恢复原始信息。
- 动态数据遮蔽(DDM):在 DDM 中,数据在实时过程中被遮蔽。因此,原始数据以其原始形式保存,但在分析时即时进行遮蔽。
下图展示了数据遮蔽中的一些常见转换:
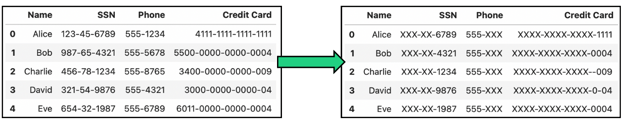
在包含社会安全号(SSN)、电话和信用卡号的数据中通过数据遮蔽实现数据匿名化的示例。
数据匿名化工具
鉴于数据匿名化的重要性,已经开发出多种工具,既可让开发者更顺畅地完成流程,也能开箱即用地提供验证功能。本节将介绍三种工具,具体选择取决于我们的用例。
ARX
ARX 是一款开源数据匿名化工具,支持多种隐私保护技术。它非常适合研究、医疗,以及任何需要对大型数据集进行严格匿名化的组织。
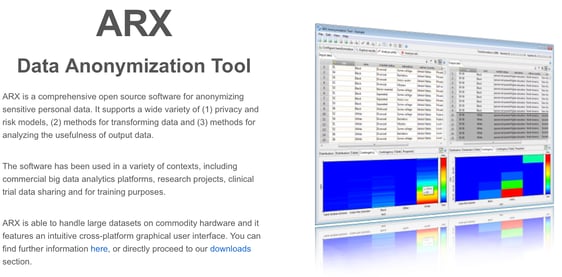
ARX 主页截图。
如果您是希望公开发布数据的研究人员,ARX 可能是最佳选择。
IBM Guardium
IBM 的Guardium 是一款旨在跨混合多云环境保护敏感数据的解决方案。它提供端到端数据加密、假名化和细粒度访问控制,以确保数据在整个生命周期中的隐私。它拥有用于监控与防护的多种独立产品:
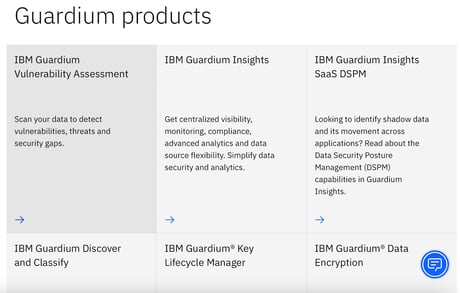
IBM Guard 主页截图。
该工具非常适合数据环境复杂的企业,尤其是采用多云基础设施、且对数据保护、访问控制和合规性要求严格的场景。
Google TensorFlow Privacy
最后,TensorFlow Privacy 在 TensorFlow 机器学习框架上扩展了对差分隐私的支持。换言之,它使开发者能够构建保护个体数据隐私的机器学习模型,通过限制可从任一数据点中提取的信息量来实现。
TensorFlow Privacy 主页截图。
TensorFlow Privacy 非常适合自行开发模型的公司或个人。
数据匿名化工具对比
下表对不同的数据匿名化工具进行了对比:
|
工具 |
描述 |
关键特性 |
理想用例 |
局限性 |
|
ARX |
具备多种隐私保护技术的开源匿名化工具。 |
- 支持 K-匿名性、L-多样性、T-接近性 - 风险分析 - 重新识别测试 |
研究、医疗与公共数据共享 |
对初学者而言配置较复杂 |
|
IBM Guardium |
适用于混合云的数据安全与匿名化综合解决方案。 |
- 端到端数据加密 - 数据遮蔽 - 访问控制 - 监控与告警 |
复杂、混合与多云环境的企业 |
成本较高;更适合大型企业 |
|
Google TensorFlow Privacy |
用于以差分隐私训练机器学习模型的框架。 |
- 支持差分隐私 - 与 TensorFlow 无缝集成 - 面向隐私的模型微调 |
含敏感数据的机器学习应用 |
受限于 TensorFlow 生态 |
数据匿名化流程
了解可用的数据匿名化技术与工具很重要,但为我们的用例选对技术更具挑战。下面来看看在实践中实施数据匿名化的分步流程:
1. 了解数据
第一步是弄清我们正在处理的数据类型以及哪些元素需要保护。这涉及识别 PII,例如姓名、地址、社会安全号或医疗数据。
接下来,应确定数据在匿名化之后将如何使用。是用于内部研究、公开共享,还是用于训练机器学习模型?这一步很重要,因为根据合规要求,某些数据可能需要更强的匿名化技术。
2. 将合适技术匹配到具体数据类型
不同类型的数据和应用需要量身定制的匿名化技术。根据数据的特性、隐私要求和预期用途,将适当技术进行匹配十分重要。
3. 验证匿名化效果
在应用合适的匿名化技术后,务必验证其有效性,确保数据真正得到保护。我个人建议使用上述风险评估工具,检查通过与外部数据源对比,匿名化数据被重新识别的难易程度。最后,如果您在公司内执行数据匿名化流程,尤其在数据经常被共享或更新的情况下,请考虑定期审计匿名化数据。
这有助于保持对隐私法规的合规,并确保匿名化在一段时间内持续有效。有关隐私法规的更多信息,请参阅文章什么是欧盟AI法案?领导者速览指南。
数据匿名化 vs. 数据遮蔽
您可能已经注意到,数据遮蔽与前文介绍的其他数据匿名化技术略有不同。数据匿名化通过移除或更改个人标识符,使数据完全不可识别;而数据遮蔽是在保持原始数据格式的情况下,用填充或虚构值来模糊敏感数据,即数据本身并未被改变,只是被遮蔽。
通用匿名化是永久且不可逆的,而遮蔽通常可逆。遮蔽维护数据结构,并可用于特定的内部应用;匿名化则可能牺牲一定的数据效用,以换取更强的隐私保护。
总之,如果您的主要目标是永久保护隐私,尤其是可能对外共享或用于洞察分析的数据,数据匿名化是最佳做法。但如果您需要在非生产环境中保护数据,多数情况下数据遮蔽已足够。
数据匿名化的挑战
数据匿名化的主要挑战在于匿名化程度与数据可用性之间的权衡。过度匿名化会降低数据质量,使其在分析或机器学习中的价值下降;而匿名化不足则可能留下隐私漏洞。在匿名化与保留数据效用之间取得平衡,是一项重大挑战。
此外,按不同隐私法对数据进行匿名化相当复杂,尤其是不同地区与行业的要求各不相同,且相关法律会不断演变。为确保更好的保护,我建议建立稳健的端到端流程,包括对数据的持续监控以及对匿名化技术的不断优化。
大语言模型中的数据匿名化
在 大语言模型(LLM)(如 ChatGPT)的语境下,数据匿名化同样是热门话题。它对于确保在使用这些模型时不泄露或暴露敏感信息至关重要。
由于 LLM 使用的大规模非结构化数据集来源广泛,包括公开可得的文本、电子邮件、聊天记录和文档等,敏感个人信息可能会无意中被包含在训练数据中,从而引发隐私担忧。
在处理非结构化数据时,更难在训练前识别并彻底移除敏感个人信息。因此,在部署后监控 LLM 的输出,并过滤可能暴露敏感信息的响应,对于降低数据泄露风险至关重要。
最后,带有特定隐私保障的模型微调以及在加密环境中进行训练等新选项也在不断涌现。但作为用户,我们始终应保持谨慎,不要向工具分享个人信息。
结论
随着数据驱动应用的增长,个人数据的收集也在增加,使保护个人信息比以往任何时候都更为关键。
作为用户,我们应意识到数据泄露的风险;作为开发者,我们应持续关注最新的匿名化技术,以确保在应用中保护数据。当数据对外公开时,这种意识尤为重要,因为重新识别的风险更高。通过优先考虑数据隐私并持续改进匿名化实践,我们能够打造更安全、更负责任的应用。
最后,如果您有兴趣在 Python 中应用上述所有技术,欢迎学习课程Data Privacy and Anonymization in Python!
数据匿名化常见问答
数据匿名化与加密有何不同?
加密通过将数据转换为不可读的代码并用密钥解密来保护数据;而匿名化则是永久更改或移除个人标识符,即使数据被获取也无法追溯到个人。匿名化是不可逆的,而加密在拥有正确密钥时可被还原。
什么是 L-多样性?
L-多样性是对 K-匿名性的扩展,确保每个等价类中的敏感属性至少具有L个不同且具有代表性的取值。
什么是 T-接近性?
T-接近性旨在弥补 K-匿名性与 L-多样性的不足,要求每个等价类中敏感属性的分布与整个数据集中该属性的分布足够接近。
何时使用合成数据生成?
一个明确的用例是任何医疗相关应用。医院和研究机构常常需要在严格的隐私监管下,为医学研究共享患者数据。合成数据生成允许医疗机构创建在统计上与真实患者数据相似、但不使用真实病历的人工数据集。
差分隐私与数据扰动相比是什么概念?
差分隐私与数据扰动相关,但两者关注点不同。数据扰动会修改实际数据;而差分隐私则修改查询输出,通过向分析结果添加噪声提供可数学证明的隐私保障。总体而言,差分隐私比数据扰动更稳健。

Andrea Valenzuela 目前在瑞士日内瓦的欧洲核子研究中心(CERN)粒子加速器的 CMS 实验工作。她在过去六年深耕数据工程与数据分析,主要职责包括数据分析与软件开发。她现正通过 Medium 出版物 ForCode'Sake 推动数据相关技术的学习大众化。
她拥有加泰罗尼亚理工大学工程物理学学士学位,以及庞培法布拉大学智能交互系统硕士学位。她的研究经历包括基于早期 OpenAI 图像生成算法(如 Normalizing Flows)的专业工作。
在大数据时代,信息已成为新的驱动力。但随着数据应用在医疗到推荐系统等各个领域的普及,个人敏感信息被泄露的风险也随之增加。
欧洲的通用数据保护条例(GDPR)和美国的加州消费者隐私法案(CCPA)等法规旨在保护个人数据,并要求组织建立严格的数据匿名化流程。如果您对这些法规特别感兴趣,建议阅读我们的文章什么是数据隐私?
本文将讨论数据匿名化的概念,以及用于确保用户数据保护的最常见技术。此外,我们还将探讨数据匿名化面临的挑战,并介绍在工作流中实施数据保护时能简化工作的工具。
通过我们的网络研讨会了解美国、欧盟及全球范围内的AI监管,掌握不同市场的AI法规。