
डेटा अज्ञातकरण क्या है?
डेटा साइंस में, डेटा अज्ञातकरण उस प्रक्रिया को संदर्भित करता है जिसमें डेटासेट को इस तरह बदला जाता है कि उपलब्ध डेटा के आधार पर व्यक्तियों की पहचान करना असंभव या अत्यंत कठिन हो जाए।
मूल रूप से, डेटा अज्ञातकरण प्रक्रिया में डेटासेट से व्यक्तित्व-पहचान योग्य जानकारी (PII) जैसे नाम और पते को हटाना या बदलना शामिल है, जबकि विश्लेषण के लिए डेटा की उपयोगिता बरकरार रहती है।
यह डेटा लीक और पुन: पहचान के जोखिम को भी कम करता है, जिससे हम व्यक्तिगत गोपनीयता से समझौता किए बिना सुरक्षित रूप से डेटा साझा और विश्लेषण कर सकते हैं।
कठोर अज्ञातकरण प्रक्रिया के अभाव का एक प्रसिद्ध मामला 2006 में सामने आया, जब Netflix ने अपने सिफारिश सिस्टम को बेहतर बनाने के उद्देश्य से Netflix Prize प्रतियोगिता के हिस्से के रूप में उपयोगकर्ता डेटा सहित एक मूवी डेटासेट जारी किया।
टेक्सास विश्वविद्यालय के शोधकर्ताओं ने IMDb के सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करके व्यक्तियों की पुन: पहचान कर यह दिखाया कि कथित तौर पर अज्ञात किए गए डेटा में कमजोरियाँ हैं। इस घटना ने डेटा अज्ञातकरण तकनीकों की प्रभावशीलता पर गंभीर चिंताएँ उठाईं और अधिक सूक्ष्म दृष्टिकोणों की आवश्यकता को रेखांकित किया।
डेटा अज्ञातकरण तकनीकें
PII को हटाना डेटा अज्ञातकरण का एकमात्र तरीका नहीं है। कुछ मामलों में, डेटासेट में व्यक्तियों की विशिष्टता घटाने के लिए डेटा का सामान्यीकरण भी किया जा सकता है। इसका एक उदाहरण सटीक आयु के स्थान पर आयु सीमा देना है। इसके अलावा, हल्की अशुद्धियाँ जोड़कर डेटा को विकृत (perturb) भी किया जा सकता है, जिससे नए डेटा को किसी व्यक्ति से जोड़ना कठिन हो जाता है।
विभिन्न डेटा अज्ञातकरण तकनीकों को जानना हमें अपने उपयोग-परिदृश्य के लिए सबसे उपयुक्त तकनीक चुनने में मदद कर सकता है। इस अनुभाग में, हम सबसे आम तकनीकों का अन्वेषण करेंगे।
सामान्यीकरण (Generalization)
जैसा कि ऊपर उल्लेख किया गया है, डेटा अज्ञातकरण केवल PIIs हटाने के बारे में नहीं है। डेटा को हटाने के बजाय, सामान्यीकरण उसे व्यापक, कम पहचान योग्य रूप में बदल देता है। दूसरे शब्दों में, सामान्यीकरण पहचान रोकने के लिए डेटा की ग्रैन्युलैरिटी कम करता है। इससे डेटा विश्लेषण के लिए उपयोगी बना रहता है, जबकि पुन: पहचान का जोखिम घटता है।
उदाहरण के लिए, जन्मतिथि जैसे निजी डेटा के मामले में, सटीक जन्मतिथि दिखाने के बजाय डेटा को माह और वर्ष तक, या केवल वर्ष तक सामान्यीकृत किया जा सकता है, ताकि पहचान रोकी जा सके जबकि आयु समूह विश्लेषण के लिए प्रासंगिक बना रहे। निम्न तालिकाएँ आयु और स्थान पर सामान्यीकरण के माध्यम से डेटा अज्ञातकरण के कुछ सरल उदाहरण दिखाती हैं:
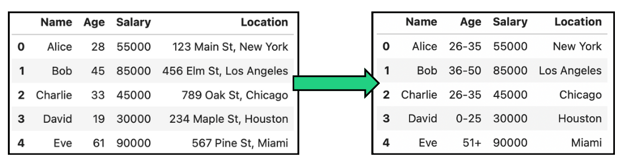
आयु और स्थान डेटा में सामान्यीकरण के माध्यम से डेटा अज्ञातकरण का उदाहरण।
यह तकनीक मुख्य रूप से जनसांख्यिकीय अध्ययनों और बाजार अनुसंधान में उपयोग होती है, लेकिन इससे डेटा की उपयोगिता कम हो सकती है, जिससे विस्तृत विश्लेषण कठिन हो जाता है।
सामान्यीकरण का अक्सर K-Anonymity जैसी अन्य तकनीकों के साथ संयोजन में उपयोग किया जाता है, जहाँ कई रिकॉर्ड्स को तब तक सामान्यीकृत किया जाता है जब तक कि वे कम-से-कम k अन्य रिकॉर्ड्स से अलग न पहचाने जा सकें, जिससे व्यक्तियों की पुन: पहचान का जोखिम घटता है।
डेटा विक्षोभ (Data perturbation)
ऐसे विश्लेषणों में जहाँ सटीक व्यक्तिगत डेटा बिंदु आवश्यक नहीं हैं बल्कि समग्र वितरण महत्त्वपूर्ण है, वहाँ डेटा विक्षोभ लागू किया जा सकता है। यह गोपनीयता की रक्षा हेतु मूल डेटा में नियंत्रित तरीके से संशोधन करने की प्रक्रिया है। इस संशोधन में रैंडमाइज़ेशन, स्केलिंग, या मानों की अदला-बदली जैसी विविध तकनीकें शामिल हो सकती हैं। डेटा विक्षोभ का उद्देश्य डेटा को धुंधला करना है, जबकि विश्लेषण के लिए उसकी उपयोगिता बनाए रखना।
शोर (Noise) जोड़ना
डेटा विक्षोभ का एक ठोस मामला शोर जोड़ना है। शोर जोड़ना डेटा में रैंडम या व्यवस्थित परिवर्तन—जिसे “शोर” कहा जाता है—लाने पर आधारित है। यह शोर संवेदनशील डेटा बिंदुओं के वास्तविक मानों को छिपा देता है, जिससे व्यक्तियों की पुन: पहचान करना कठिन हो जाता है। नीचे दी गई छवि में, हमने ऊपर की तालिकाओं में दिखाए गए मूल वेतन में Gaussian शोर जोड़कर संशोधन किया है:
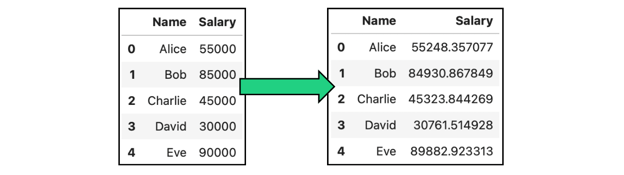
वेतन वाले डेटा में शोर जोड़कर डेटा अज्ञातकरण का उदाहरण।
कृत्रिम (Synthetic) डेटा जनरेशन
वास्तविक डेटा में शोर जोड़ने के बजाय, डेटा अज्ञातकरण का एक और तरीका है—कुछ शर्तों के तहत नकली डेटा बनाना। Synthetic डेटा जनरेशन मूल डेटा के सांख्यिकीय गुणों को दोहराते हुए कृत्रिम डेटासेट बनानी की प्रक्रिया है, जिसमें वास्तविक, पहचान योग्य जानकारी शामिल नहीं होती। यह एक वैकल्पिक, गोपनीयता-अनुरूप डेटासेट के रूप में काम करता है जो मूल डेटा के पैटर्न और संरचना की नकल करता है।
उसी डेटा वितरण के साथ डेटा जनरेट करने की प्रक्रिया में सांख्यिकीय मॉडलिंग की आवश्यकता होती है, ताकि हमें पुनरुत्पादित करने के लिए आवश्यक पैटर्न, संबंध और वितरण पहचाने जा सकें। सामान्यतः, synthetic डेटा जनरेशन लागू करना अधिक कठिन होता है।
अधिक जानने के लिए निम्न संसाधन देखें:
- Alexandra Ebert का वेबिनार Using Synthetic Data for Machine Learning & AI in Python।
- Abid Ali Awan का लेख Creating Synthetic Data with Python Faker Tutorial।
छद्मनामकरण (Pseudonymization)
छद्मनामकरण में डेटासेट में पहचानों को छद्मनामों या नकली पहचानकर्ताओं से बदलना शामिल है, ताकि व्यक्तियों की सीधी पहचान न हो सके। पूर्ण अज्ञातकरण के विपरीत, छद्मनामित डेटा को एक कुंजी की मदद से पुन: पहचाना जा सकता है जो छद्मनामों को वास्तविक पहचान से जोड़ती है।
यह तकनीक प्रायः चिकित्सा अनुसंधान, डेटा एनालिटिक्स, और ग्राहक डेटा प्रसंस्करण में उपयोग होती है, जिससे व्यक्तिगत पहचान उजागर किए बिना विश्लेषण संभव हो जाता है, जबकि सुरक्षित वातावरण में वापस ट्रेस करने का विकल्प बना रहता है।
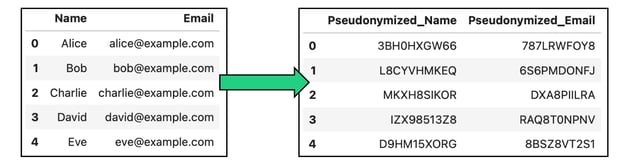
नाम और ईमेल वाले डेटा में छद्मनामकरण के माध्यम से डेटा अज्ञातकरण का उदाहरण।
डेटा मास्किंग
एक अन्य सामान्य तकनीक है डेटा मास्किंग, जिसमें मूल डेटा के प्रारूप और संरचना को बनाए रखते हुए उसे बदलना या धुंधला करना शामिल है। व्यवहार में, डेटा मास्किंग के दो अलग-अलग दृष्टिकोण हैं:
- स्टैटिक डेटा मास्किंग (SDM): यह एक स्थायी तरीका है, जिसमें सभी डेटा बिंदुओं पर एकसमान रूप से संवेदनशील डेटा को बदला जाता है। SDM के बाद संवेदनशील डेटा कभी उजागर नहीं होता, क्योंकि मूल जानकारी की पुनर्प्राप्ति असंभव होती है।
- डायनेमिक डेटा मास्किंग (DDM): DDM में, डेटा को रियल-टाइम में मास्क किया जाता है। अतः मूल डेटा अपनी मूल अवस्था में सुरक्षित रहता है, लेकिन विश्लेषण के लिए तुरंत मास्क कर दिया जाता है।
नीचे दी गई छवि डेटा मास्किंग में कुछ सामान्य रूपांतरण दिखाती है:
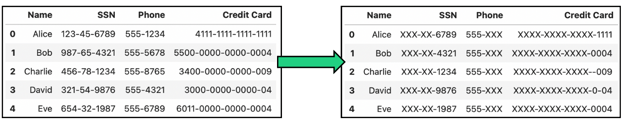
सोशल सिक्योरिटी नंबर (SSN), फोन और क्रेडिट कार्ड नंबर वाले डेटा में डेटा मास्किंग द्वारा अज्ञातकरण का उदाहरण।
डेटा अज्ञातकरण टूल्स
डेटा अज्ञातकरण के महत्व के कारण, डेवलपर्स के लिए प्रक्रिया को सुगम बनाने और बॉक्स से बाहर सत्यापन टूल्स प्रदान करने हेतु कई टूल विकसित किए गए हैं। इस अनुभाग में, हम तीन टूल्स का अन्वेषण करेंगे, जिनमें से प्रत्येक हमारे उपयोग-परिदृश्य के अनुसार उपयुक्त है।
ARX
ARX एक ओपन-सोर्स डेटा अज्ञातकरण टूल है जो विभिन्न गोपनीयता-संरक्षण तकनीकों का समर्थन करता है। यह अनुसंधान, स्वास्थ्य सेवा, और उन सभी संगठनों के लिए आदर्श है जो बड़े डेटासेट्स के साथ काम करते हैं और जहाँ कठोर अज्ञातकरण आवश्यक है।
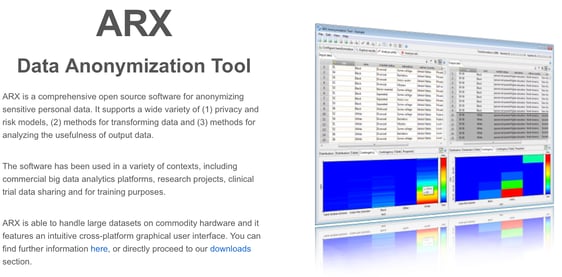
ARX मुख्य पृष्ठ का स्क्रीनशॉट।
यदि आप एक शोधकर्ता हैं और अपना डेटा सार्वजनिक रूप से जारी करना चाहते हैं, तो ARX आपके लिए सबसे अच्छा विकल्प हो सकता है।
IBM Guardium
IBM का Guardium हाइब्रिड, मल्टी-क्लाउड वातावरणों में संवेदनशील डेटा की सुरक्षा के लिए डिज़ाइन किया गया समाधान है। यह डेटा जीवनचक्र भर में डेटा गोपनीयता सुनिश्चित करने के लिए एंड-टू-एंड डेटा एन्क्रिप्शन, छद्मनामकरण और सूक्ष्म एक्सेस नियंत्रण प्रदान करता है। इसमें मॉनिटरिंग और प्रोटेक्शन के लिए कई स्वतंत्र उत्पाद शामिल हैं:
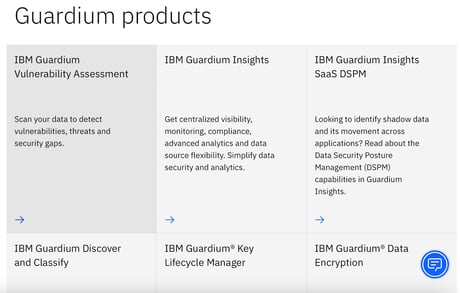
IBM Guard मुख्य पृष्ठ का स्क्रीनशॉट।
यह टूल जटिल डेटा वातावरण वाली एंटरप्राइज़ेस के लिए उपयुक्त है, विशेषकर वे जो मल्टी-क्लाउड इन्फ्रास्ट्रक्चर का उपयोग करते हैं जहाँ डेटा सुरक्षा, एक्सेस नियंत्रण और विनियामक अनुपालन महत्वपूर्ण हैं।
Google TensorFlow Privacy
अंत में, TensorFlow Privacy TensorFlow मशीन लर्निंग फ़्रेमवर्क को differential privacy के समर्थन के साथ विस्तारित करता है। अर्थात, यह डेवलपर्स को ऐसे मशीन लर्निंग मॉडल बनाने में सक्षम बनाता है जो किसी भी एकल डेटा बिंदु के बारे में निकाली जा सकने वाली जानकारी को सीमित कर व्यक्तिगत डेटा गोपनीयता की रक्षा करते हैं।
TensorFlow Privacy मुख्य पृष्ठ का स्क्रीनशॉट।
TensorFlow Privacy उन कंपनियों या व्यक्तियों के लिए उपयुक्त है जो स्वयं मॉडल विकसित कर रहे हैं।
डेटा अज्ञातकरण टूल्स की तुलना
नीचे, हमने विभिन्न डेटा अज्ञातकरण टूल्स और उनकी तुलना दर्शाने वाली तालिका बनाई है:
|
टूल |
विवरण |
मुख्य विशेषताएँ |
आदर्श उपयोग-परिदृश्य |
सीमाएँ |
|
ARX |
विभिन्न गोपनीयता-संरक्षण तकनीकों वाला ओपन-सोर्स अज्ञातकरण टूल। |
- K-Anonymity, L-Diversity, T-Closeness का समर्थन - जोखिम विश्लेषण - पुन: पहचान परीक्षण |
अनुसंधान, स्वास्थ्य सेवा, और सार्वजनिक डेटा साझाकरण |
शुरुआती के लिए जटिल कॉन्फ़िगरेशन |
|
IBM Guardium |
हाइब्रिड क्लाउड के लिए व्यापक डेटा सुरक्षा और अज्ञातकरण समाधान। |
- एंड-टू-एंड डेटा एन्क्रिप्शन - डेटा मास्किंग - एक्सेस नियंत्रण - मॉनिटरिंग और अलर्ट्स |
जटिल, हाइब्रिड और मल्टी-क्लाउड वातावरण वाली एंटरप्राइज़ेस |
उच्च लागत; बड़े उद्यमों के लिए अधिक उपयुक्त |
|
Google TensorFlow Privacy |
डिफरेंशियल प्राइवेसी के साथ मशीन लर्निंग मॉडल प्रशिक्षण के लिए फ़्रेमवर्क। |
- डिफरेंशियल प्राइवेसी समर्थन - TensorFlow के साथ सहज एकीकरण - गोपनीयता हेतु मॉडल फाइन-ट्यूनिंग |
संवेदनशील डेटा वाली मशीन लर्निंग एप्लीकेशंस |
केवल TensorFlow इकोसिस्टम तक सीमित |
डेटा अज्ञातकरण प्रक्रिया
उपलब्ध डेटा अज्ञातकरण तकनीकों और टूल्स को जानना महत्वपूर्ण है, लेकिन हमारे उपयोग-परिदृश्य के लिए सही तकनीक चुनना और भी चुनौतीपूर्ण है। आइए व्यवहार में डेटा अज्ञातकरण लागू करने की चरण-दर-चरण प्रक्रिया को समझें:
1. डेटा को समझना
पहला कदम यह समझना है कि हम किस प्रकार के डेटा पर काम कर रहे हैं और किन तत्वों की सुरक्षा आवश्यक है। इसमें नाम, पते, सोशल सिक्योरिटी नंबर, या चिकित्सा डेटा जैसे PII की पहचान करना शामिल है।
इसके बाद, हमें यह निर्धारित करना चाहिए कि अज्ञातकरण के बाद डेटा का उपयोग कैसे होगा। क्या यह आंतरिक अनुसंधान, सार्वजनिक साझाकरण, या मशीन लर्निंग मॉडल प्रशिक्षण के लिए होगा? यह चरण महत्त्वपूर्ण है क्योंकि कुछ डेटा को नियामक आवश्यकताओं के आधार पर अधिक मजबूत अज्ञातकरण तकनीकों की आवश्यकता हो सकती है।
2. विशिष्ट डेटा प्रकारों से उपयुक्त तकनीक का मिलान
डेटा और अनुप्रयोगों के विभिन्न प्रकार अनुकूलित अज्ञातकरण तकनीकों की माँग करते हैं। चर्चा की गई तकनीकों के आधार पर, डेटा की प्रकृति, गोपनीयता आवश्यकताओं और इच्छित उपयोग के अनुसार उपयुक्त तकनीक का मिलान करना महत्त्वपूर्ण है।
3. अज्ञातकरण की प्रभावशीलता का सत्यापन
उपयुक्त अज्ञातकरण तकनीकों को लागू करने के बाद, यह सुनिश्चित करने के लिए उनकी प्रभावशीलता की जाँच करना महत्त्वपूर्ण है कि डेटा वास्तव में सुरक्षित है। मैं व्यक्तिगत रूप से ऊपर प्रस्तुत जोखिम आकलन टूल्स जैसे साधनों का उपयोग करने की सलाह दूँगा, ताकि बाहरी डेटा स्रोतों से तुलना कर यह परखा जा सके कि अज्ञात किए गए डेटा की पुन: पहचान कितनी आसानी से हो सकती है। अंततः, यदि आप किसी कंपनी के हिस्से के रूप में डेटा अज्ञातकरण प्रक्रिया संचालित कर रहे हैं, तो विशेष रूप से तब, जब डेटा बार-बार साझा या अद्यतन होता है, अज्ञात डेटा का नियमित ऑडिट करना सुनिश्चित करें।
यह गोपनीयता विनियमों के अनुपालन को बनाए रखने में मदद करता है और सुनिश्चित करता है कि समय के साथ अज्ञातकरण प्रभावी बना रहे। गोपनीयता विनियमों पर अधिक जानकारी के लिए, लेख EU AI अधिनियम क्या है? नेताओं के लिए एक सारांश गाइड देखें।
डेटा अज्ञातकरण बनाम डेटा मास्किंग
जैसा कि आपने देखा होगा, डेटा मास्किंग अब तक प्रस्तुत अन्य डेटा अज्ञातकरण तकनीकों से कुछ अलग है। जहाँ डेटा अज्ञातकरण, व्यक्तिगत पहचानकर्ताओं को हटाकर या बदलकर डेटा को पूरी तरह से अप्रतिचिन्ह्य (unidentifiable) बनाता है, वहीं डेटा मास्किंग मूल डेटा प्रारूप को बनाए रखते हुए संवेदनशील डेटा को पैडिंग या काल्पनिक मानों से बदलकर धुंधला करता है, अर्थात डेटा बदला नहीं जाता, केवल छिपाया जाता है।
सामान्य अज्ञातकरण स्थायी और अपरिवर्तनीय होता है, जबकि मास्किंग अक्सर परिवर्तनीय (reversible) हो सकती है। मास्किंग विशिष्ट आंतरिक अनुप्रयोगों के लिए डेटा संरचना और उपयोगिता बनाए रखती है, जबकि अज्ञातकरण अधिक मजबूत गोपनीयता सुरक्षा के लिए कुछ डेटा उपयोगिता का त्याग कर सकता है।
सारांश में, यदि आपका प्राथमिक लक्ष्य गोपनीयता की स्थायी सुरक्षा है, विशेष रूप से वह डेटा जो बाहरी रूप से साझा किया जा सकता है या अंतर्दृष्टि के लिए विश्लेषित किया जा सकता है, तो डेटा अज्ञातकरण सर्वोत्तम दृष्टिकोण है। हालाँकि, यदि आपको नॉन-प्रोडक्शन वातावरणों में डेटा की सुरक्षा करनी है, तो अधिकांश मामलों में डेटा मास्किंग पर्याप्त होता है।
डेटा अज्ञातकरण में चुनौतियाँ
डेटा अज्ञातकरण में मुख्य चुनौती है अज्ञातकरण की डिग्री और डेटा की उपयोगिता के बीच संतुलन। अत्यधिक अज्ञातकरण डेटा गुणवत्ता को घटा सकता है, जिससे विश्लेषण या मशीन लर्निंग के लिए उसका मूल्य कम हो जाता है, जबकि अपर्याप्त अज्ञातकरण गोपनीयता कमजोरियाँ छोड़ सकता है। अज्ञातकरण और डेटा उपयोगिता बनाए रखने के बीच सही संतुलन बनाना एक बड़ी चुनौती है।
इसके अतिरिक्त, विभिन्न गोपनीयता क़ानूनों के अनुरूप डेटा का अज्ञातकरण करना जटिल है, विशेषकर क्योंकि अलग-अलग क्षेत्रों और उद्योगों की आवश्यकताएँ भिन्न होती हैं और समय के साथ ये क़ानून विकसित होते रहते हैं। बेहतर सुरक्षा सुनिश्चित करने के लिए, मैं एक मज़बूत एंड-टू-एंड प्रक्रिया स्थापित करने की सलाह दूँगा, जिसमें डेटा की सतत मॉनिटरिंग और डेटा अज्ञातकरण तकनीकों का परिष्करण शामिल हो।
बड़े भाषा मॉडल्स (LLMs) में डेटा अज्ञातकरण
डेटा अज्ञातकरण बड़े भाषा मॉडल्स (LLMs) जैसे ChatGPT के संदर्भ में भी एक गरम विषय है। इन मॉडलों के उपयोग के दौरान संवेदनशील जानकारी लीक या उजागर न हो, यह सुनिश्चित करने के लिए यह अत्यंत महत्वपूर्ण है।
क्योंकि LLMs को विशाल, असंरचित डेटासेट्स पर प्रशिक्षित किया जाता है, जिनका स्रोत सार्वजनिक रूप से उपलब्ध पाठ जैसे ईमेल, चैट लॉग्स और दस्तावेज़ होते हैं, इसलिए संवेदनशील व्यक्तिगत जानकारी के अनजाने में प्रशिक्षण डेटा में शामिल होने का जोखिम रहता है, जो गोपनीयता चिंताएँ बढ़ाता है।
असंरचित डेटा के साथ काम करते समय, प्रशिक्षण से पहले संवेदनशील व्यक्तिगत जानकारी की पहचान करना और उसका पूर्ण निष्कासन सुनिश्चित करना अधिक कठिन होता है। यही कारण है कि LLMs के आउटपुट की निगरानी करना और ऐसी किसी भी प्रतिक्रिया को फ़िल्टर करना जो संवेदनशील जानकारी उजागर कर सकती हो, परिनियोजन के बाद डेटा लीक के जोखिम को कम करने के लिए महत्वपूर्ण है।
अंततः, मॉडलों का फाइन-ट्यून करना, विशिष्ट गोपनीयता सुरक्षा के साथ, और प्रशिक्षण के लिए एन्क्रिप्टेड वातावरण का उपयोग जैसी नई विकल्प भी उभर रहे हैं, लेकिन एक उपयोगकर्ता के रूप में, हम हमेशा सावधान रह सकते हैं और टूल के साथ अपनी व्यक्तिगत जानकारी साझा न करने का प्रयास कर सकते हैं।
निष्कर्ष
जैसे-जैसे डेटा-चालित अनुप्रयोगों का उपयोग बढ़ता है, व्यक्तियों के डेटा का संग्रह भी बढ़ता है, जिससे व्यक्तिगत जानकारी की सुरक्षा पहले से अधिक महत्वपूर्ण हो जाती है।
उपयोगकर्ताओं के रूप में, हमें डेटा उल्लंघनों के जोखिमों के प्रति जागरूक होना चाहिए, और डेवलपर्स के रूप में, हमें अपनी एप्लीकेशंस में डेटा संरक्षण सुनिश्चित करने के लिए नवीनतम अज्ञातकरण तकनीकों से अवगत रहना चाहिए। यह जागरूकता विशेष रूप से तब महत्वपूर्ण है जब डेटा सार्वजनिक किया जाता है, क्योंकि पुन: पहचान का जोखिम अधिक होता है। डेटा गोपनीयता को प्राथमिकता देकर और अज्ञातकरण प्रथाओं को लगातार परिष्कृत करके, हम अधिक सुरक्षित और जिम्मेदार एप्लीकेशंस बना सकते हैं।
अंत में, यदि आप ये सभी तकनीकें Python में लागू करना चाहते हैं, तो Data Privacy and Anonymization in Python पाठ्यक्रम आपके लिए है!
डेटा अज्ञातकरण FAQs
डेटा अज्ञातकरण एन्क्रिप्शन से कैसे अलग है?
एन्क्रिप्शन डेटा को अपठनीय कोड में बदलकर उसकी रक्षा करता है, जिसे एक कुंजी से डिक्रिप्ट किया जा सकता है, जबकि अज्ञातकरण व्यक्तिगत पहचानकर्ताओं को स्थायी रूप से बदल देता या हटा देता है ताकि डेटा को व्यक्तियों तक वापस नहीं जोड़ा जा सके, भले ही उस तक पहुँच हो जाए। अज्ञातकरण अपरिवर्तनीय है, जबकि एन्क्रिप्शन को सही कुंजी के साथ उलटा जा सकता है।
L-Diversity क्या है?
L-Diversity, K-Anonymity का एक विस्तार है जो सुनिश्चित करता है कि प्रत्येक समकक्ष वर्ग (equivalence class) में संवेदनशील गुणों के कम-से-कम L अलग-अलग और अच्छी तरह से प्रतिनिधित्व किए गए मान हों।
T-Closeness क्या है?
T-Closeness, K-Anonymity और L-Diversity दोनों की सीमाओं को संबोधित करने के लिए डिज़ाइन किया गया है, यह सुनिश्चित कर कि प्रत्येक समकक्ष वर्ग में संवेदनशील गुणों का वितरण पूरे डेटासेट में उस गुण के वितरण के क़रीब हो।
Synthetic डेटा जनरेशन का उपयोग कब करें?
एक स्पष्ट उपयोग-परिदृश्य किसी भी हेल्थकेयर एप्लीकेशन में है। अस्पताल और अनुसंधान संस्थान अक्सर चिकित्सा अनुसंधान के लिए मरीजों का डेटा साझा करने की आवश्यकता रखते हैं, जबकि वे कड़े गोपनीयता विनियमों के दायरे में होते हैं। Synthetic डेटा जनरेशन स्वास्थ्य सेवा प्रदाताओं को वास्तविक मरीज रिकॉर्ड का उपयोग किए बिना वास्तविक मरीज डेटा की नकल करने वाले कृत्रिम डेटासेट बनाने की अनुमति देता है।
डेटा विक्षोभ की तुलना में डिफरेंशियल प्राइवेसी क्या है?
डिफरेंशियल प्राइवेसी का संबंध डेटा विक्षोभ से है, लेकिन दोनों का फोकस अलग है। जहाँ डेटा विक्षोभ वास्तविक डेटा को संशोधित करता है, वहीं डिफरेंशियल प्राइवेसी क्वेरी आउटपुट्स को संशोधित करती है और डेटा विश्लेषण के परिणामों में शोर जोड़कर गणितीय रूप से सिद्ध गोपनीयता गारंटी प्रदान करती है। सामान्यतः, डिफरेंशियल प्राइवेसी डेटा विक्षोभ की तुलना में अधिक मज़बूत होती है।

एंड्रिया वेलेंज़ुएला वर्तमान में जेनेवा, स्विट्ज़रलैंड में स्थित कण त्वरक (CERN) पर CMS प्रयोग में कार्यरत हैं। पिछले छह वर्षों से डेटा इंजीनियरिंग और विश्लेषण में विशेषज्ञता के साथ, उनकी जिम्मेदारियों में डेटा विश्लेषण और सॉफ्टवेयर विकास शामिल हैं। वह फिलहाल Medium प्रकाशन ForCode'Sake के माध्यम से डेटा-संबंधित तकनीकों के सीखने को लोकतांत्रिक बनाने की दिशा में काम कर रही हैं।
उन्होंने पॉलीटेक्निक यूनिवर्सिटी ऑफ कैटालोनिया से इंजीनियरिंग फ़िज़िक्स में बीएस और पोम्पेउ फ़ाब्रा यूनिवर्सिटी से इंटेलिजेंट इंटरेक्टिव सिस्टम्स में एमएस किया है। उनके शोध अनुभव में छवि जनरेशन के लिए Normalizing Flows जैसे पूर्व OpenAI एल्गोरिदम पर व्यावसायिक कार्य शामिल है।
बिग डेटा के युग में जानकारी नई प्रेरक शक्ति बन गई है। हालांकि, जैसे-जैसे स्वास्थ्य सेवा से लेकर सिफारिश प्रणालियों तक विभिन्न क्षेत्रों में डेटा अनुप्रयोगों का विस्तार होता जा रहा है, व्यक्तियों की संवेदनशील जानकारी के समझौता होने का जोखिम भी बढ़ता जा रहा है।
यूरोप में General Data Protection Regulation (GDPR) और अमेरिका में California Consumer Privacy Act (CCPA) जैसी कुछ विनियम मौजूद हैं, जिनका उद्देश्य व्यक्तियों के निजी डेटा की रक्षा करना है और संगठनों को कड़े डेटा अज्ञातकरण प्रक्रिया अपनाने के लिए बाध्य करना है। यदि आप विशेष रूप से इन विनियमों में रुचि रखते हैं, तो हमारा लेख डेटा प्राइवेसी क्या है? अवश्य पढ़ें।
इस लेख में, हम डेटा अज्ञातकरण की अवधारणा और उपयोगकर्ताओं के डेटा संरक्षण सुनिश्चित करने के लिए सबसे आम तकनीकों पर चर्चा करेंगे। साथ ही, हम डेटा अज्ञातकरण की चुनौतियों का अन्वेषण करेंगे और ऐसे टूल प्रस्तुत करेंगे जो हमारे वर्कफ़्लो में डेटा सुरक्षा लागू करते समय प्रक्रिया को आसान बनाते हैं।
विभिन्न बाज़ारों में AI विनियमों के बारे में हमारे वेबिनार Understanding Regulations for AI in the USA, the EU, and Around the World के साथ जानें।