

Corso
Riservatezza dei dati e anonimizzazione in Python
4 ore
3.9K
Pratica and corso your progress.
Continua Con GoogleNel data science, l’anonimizzazione dei dati indica il processo di modifica di un dataset in modo tale che diventi impossibile o molto difficile identificare i singoli individui sulla base dei dati disponibili.
In sostanza, il processo di anonimizzazione consiste nel rimuovere o trasformare le informazioni di identificazione personale (PII) dai dataset, come nomi e indirizzi, mantenendo al contempo l’utilità dei dati per l’analisi.
Riduce inoltre il rischio di fughe di dati e di re-identificazione, permettendoci di condividere e analizzare i dati in sicurezza senza compromettere la privacy delle persone.
Un caso famoso di processo di anonimizzazione non rigoroso si è verificato nel 2006, quando Netflix ha pubblicato un dataset di film contenente dati degli utenti come parte della competizione Netflix Prize, volta a migliorare il proprio sistema di raccomandazione.
Ricercatori dell’Università del Texas hanno dimostrato la vulnerabilità dei dati “anonimizzati” re-identificando gli individui tramite dati pubblici di IMDb. Questo episodio ha sollevato notevoli preoccupazioni sull’efficacia delle tecniche di anonimizzazione e ha evidenziato la necessità di approcci più scrupolosi.
La rimozione delle PII non è l’unico approccio all’anonimizzazione. In alcuni casi, i dati possono essere generalizzati per ridurre l’unicità degli individui in un dataset. Un esempio è la sostituzione dell’età esatta con fasce d’età. Inoltre, i dati possono essere perturbati introducendo leggere inesattezze, rendendo più difficile ricollegare i nuovi dati a un individuo.
Conoscere le diverse tecniche di anonimizzazione aiuta a scegliere la più adatta al nostro caso d’uso. In questa sezione esploreremo le più comuni.
Come detto, l’anonimizzazione non riguarda solo la rimozione delle PII. Invece di eliminare i dati, la generalizzazione li trasforma in una forma più ampia e meno identificabile. In altre parole, la generalizzazione riduce la granularità dei dati per impedire l’identificazione. Ciò consente ai dati di rimanere utili per l’analisi, riducendo il rischio di re-identificazione.
Ad esempio, quando si lavora con dati personali come la data di nascita, invece di mostrare la data esatta, i dati vengono generalizzati al mese e all’anno, o solo all’anno, per evitare l’identificazione pur mantenendo rilevante il gruppo d’età per l’analisi. Le seguenti tabelle mostrano alcuni semplici esempi di anonimizzazione per generalizzazione su età e localizzazione:
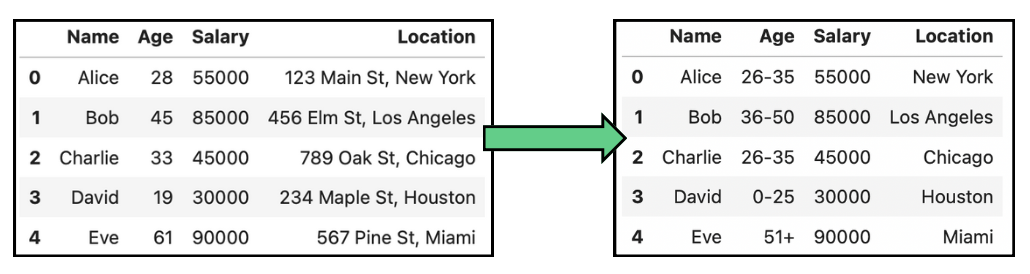
Esempio di anonimizzazione per generalizzazione su dati di età e localizzazione.
Questa tecnica è usata soprattutto in studi demografici e ricerche di mercato, ma può comportare una perdita di utilità dei dati, rendendo difficili le analisi dettagliate.
La generalizzazione è spesso utilizzata insieme ad altre tecniche come la K-Anonymity, in cui più record vengono generalizzati finché non possono essere distinti da almeno k altri record, riducendo il rischio di re-identificazione.
Nelle analisi in cui non sono necessari punti dati individuali precisi ma interessa la distribuzione complessiva, si può applicare la perturbazione dei dati. Si riferisce al processo di modifica controllata dei dati originali per proteggere la privacy. Questa modifica può includere varie tecniche come randomizzazione, scaling o scambio di valori. La perturbazione dei dati mira a offuscare i dati mantenendone l’utilità per l’analisi.
Un caso concreto di perturbazione è l’aggiunta di rumore. L’aggiunta di rumore consiste nell’introdurre variazioni casuali o sistematiche, il cosiddetto “rumore”, nei dati. Questo rumore offusca i veri valori dei punti dati sensibili, rendendo più difficile re-identificare gli individui. Nell’immagine seguente, abbiamo modificato gli stipendi originali mostrati nelle tabelle sopra aggiungendo rumore gaussiano:
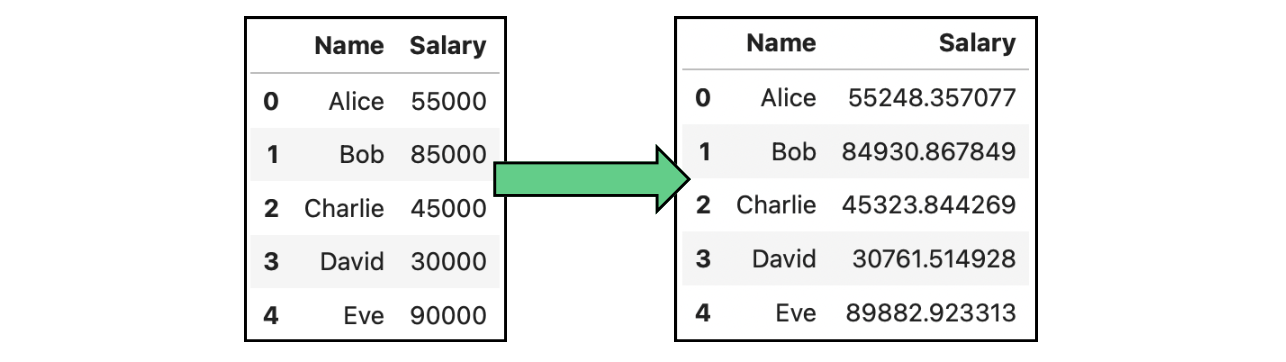
Esempio di anonimizzazione tramite aggiunta di rumore su dati di stipendio.
Invece di aggiungere rumore ai dati reali, un altro approccio all’anonimizzazione è generare dati fittizi, a determinate condizioni. La generazione di dati sintetici è il processo di creazione di dataset artificiali che replicano le proprietà statistiche dei dati originali senza includere informazioni reali e identificabili. Serve come alternativa per analizzare un dataset conforme alla privacy che imita pattern e struttura di quello originale.
Il processo di generazione di dati con la stessa distribuzione richiede modellazione statistica per identificare pattern, relazioni e distribuzioni da replicare. In generale, la generazione di dati sintetici è più difficile da implementare.
Ti consiglio di consultare le seguenti risorse per saperne di più:
La pseudonimizzazione consiste nel sostituire gli identificatori in un dataset con pseudonimi o identificatori fittizi per impedire l’identificazione diretta degli individui. A differenza della piena anonimizzazione, i dati pseudonimizzati possono essere re-identificati usando una chiave che collega gli pseudonimi alle identità reali.
Questa tecnica è comunemente usata nella ricerca medica, nell’analisi dei dati e nell’elaborazione di dati dei clienti, consentendo l’analisi senza rivelare le identità, ma con la possibilità di risalirvi in ambienti sicuri.
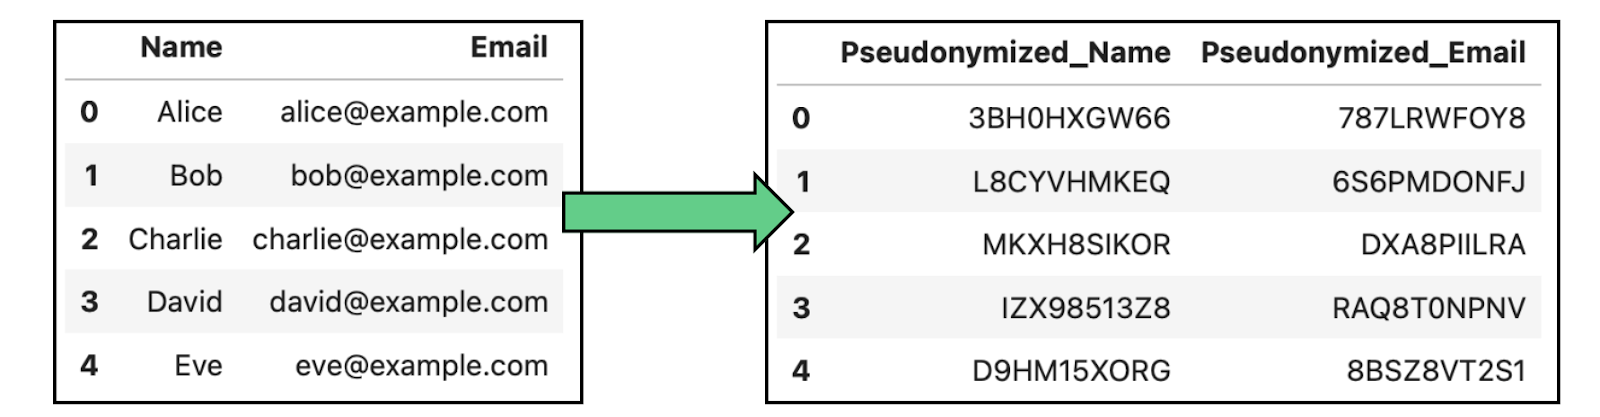
Esempio di anonimizzazione tramite pseudonimizzazione su dati contenenti nomi ed email.
Un’altra tecnica comunemente usata è il data masking, che consiste nell’alterare o offuscare i dati originali mantenendone formato e struttura. In pratica, esistono due approcci al data masking:
L’immagine seguente mostra alcune trasformazioni comuni nel data masking:
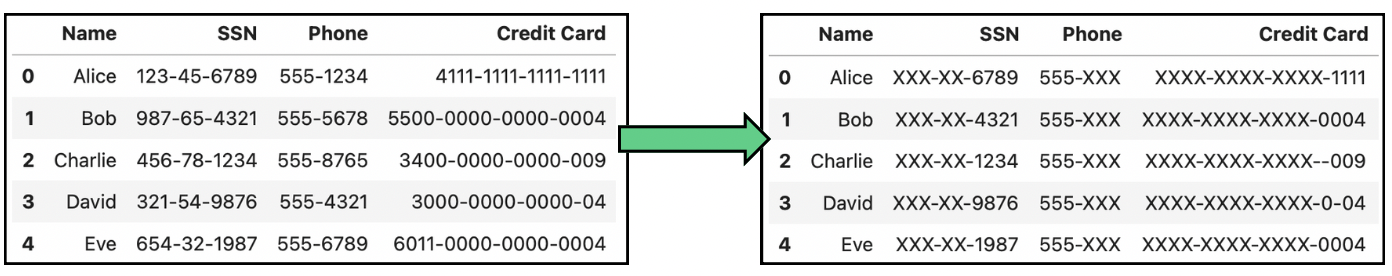
Esempio di anonimizzazione tramite data masking su dati contenenti numeri di Social Security (SSN), telefoni e numeri di carta di credito.
Data l’importanza dell’anonimizzazione, sono stati sviluppati diversi strumenti per rendere il processo più fluido per gli sviluppatori e fornire tool di validazione pronti all’uso. In questa sezione esploreremo tre strumenti, ciascuno più adatto a seconda del nostro caso d’uso.
ARX è uno strumento open-source per l’anonimizzazione che supporta varie tecniche di tutela della privacy. È ideale per la ricerca, l’assistenza sanitaria e per qualsiasi organizzazione che gestisca grandi dataset che richiedono un’anonimizzazione rigorosa.
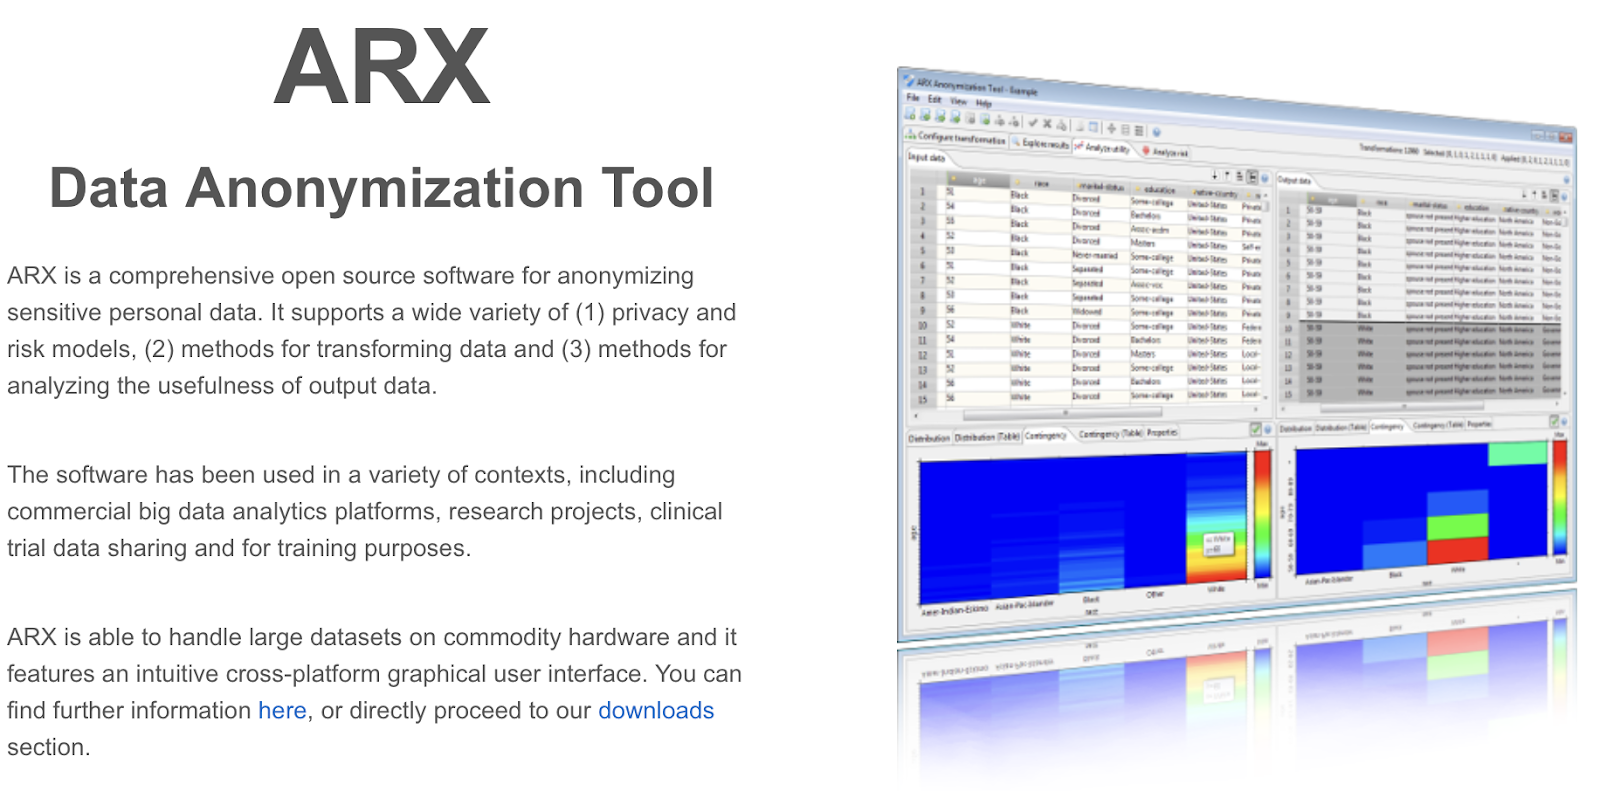
Screenshot della pagina principale di ARX.
Se sei un ricercatore e vuoi rendere pubblici i tuoi dati, ARX potrebbe essere l’opzione migliore per te.
Guardium di IBM è una soluzione progettata per proteggere i dati sensibili in ambienti ibridi e multi-cloud. Offre crittografia end-to-end, pseudonimizzazione e controlli di accesso granulari per garantire la privacy dei dati lungo tutto il loro ciclo di vita. Include diversi prodotti indipendenti sia per il monitoraggio sia per la protezione:
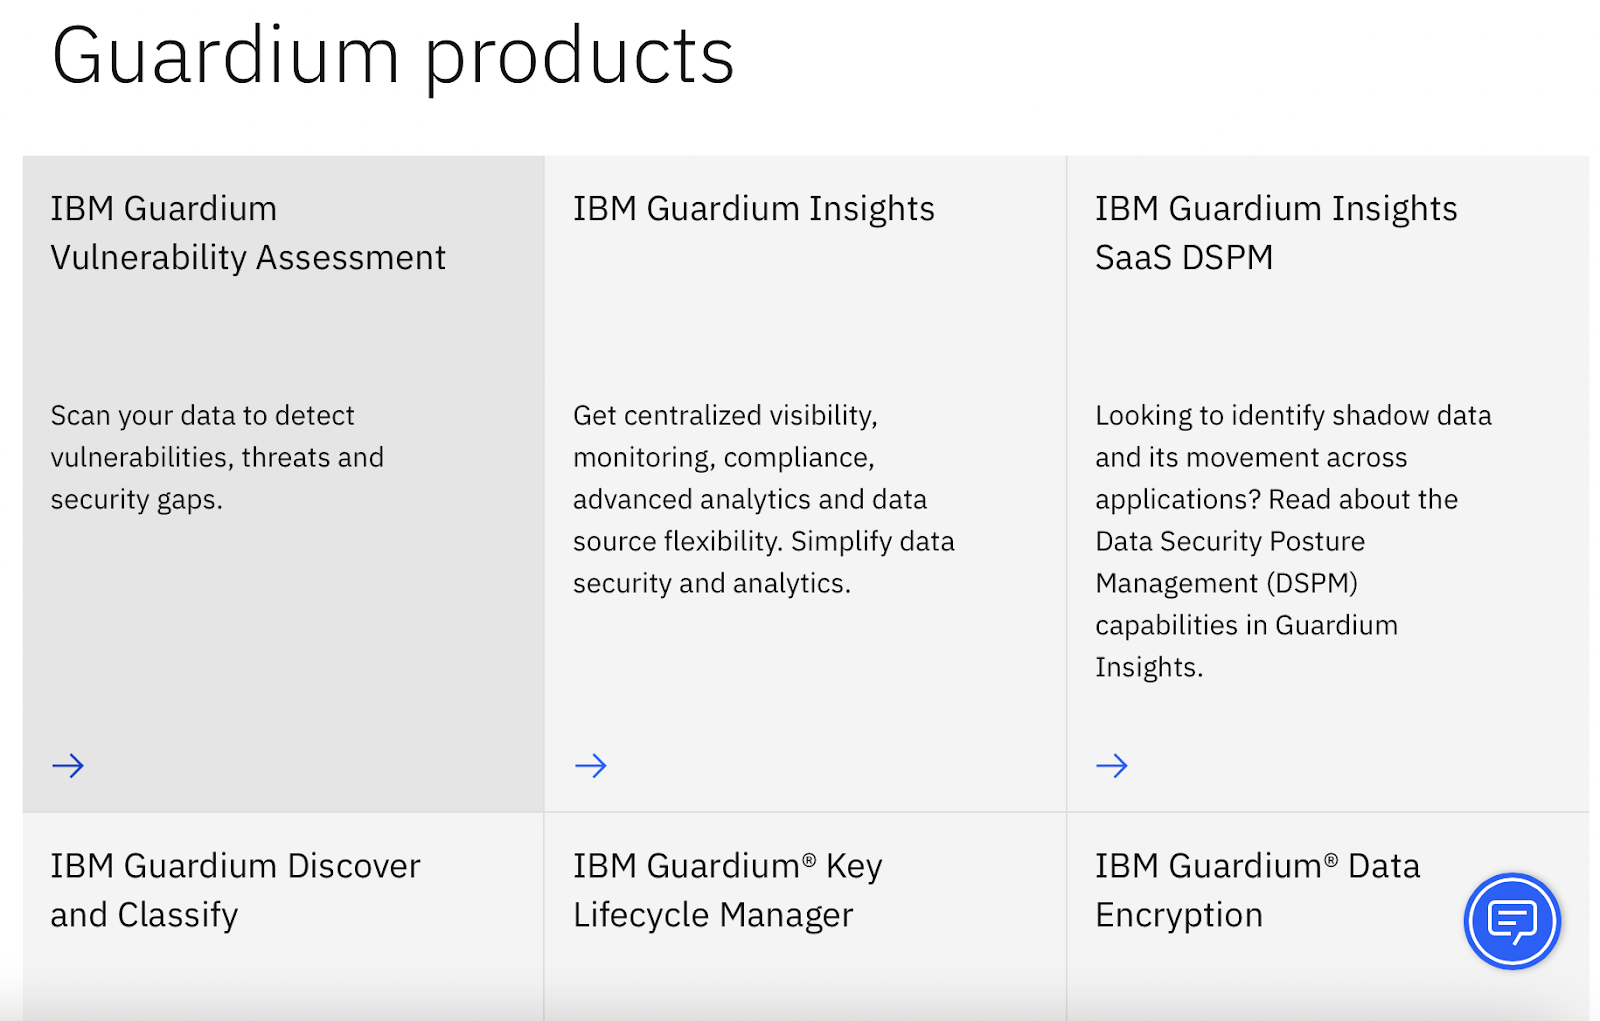
Screenshot della pagina principale di IBM Guard.
Questo strumento è adatto alle aziende con ambienti dati complessi, in particolare quelle che utilizzano infrastrutture multi-cloud in cui protezione dei dati, controllo degli accessi e conformità normativa sono critici.
Infine, TensorFlow Privacy estende il framework di machine learning TensorFlow aggiungendo il supporto per la privacy differenziale. In altre parole, consente di creare modelli di machine learning che proteggono la privacy dei singoli limitando la quantità di informazioni estraibili da ogni singolo punto dati.
Screenshot della pagina principale di TensorFlow Privacy.
TensorFlow Privacy è perfetto per aziende o individui che sviluppano direttamente i modelli.
Di seguito, abbiamo creato una tabella di confronto che mostra i diversi strumenti di anonimizzazione e come si differenziano:
|
Strumento |
Descrizione |
Caratteristiche principali |
Caso d’uso ideale |
Limitazioni |
|
ARX |
Strumento open-source di anonimizzazione con varie tecniche di tutela della privacy. |
- Supporto a K-Anonymity, L-Diversity, T-Closeness - Analisi del rischio - Test di re-identificazione |
Ricerca, sanità e condivisione pubblica dei dati |
Configurazione complessa per i principianti |
|
IBM Guardium |
Soluzione completa per sicurezza e anonimizzazione dei dati in cloud ibrido. |
- Crittografia end-to-end dei dati - Data Masking - Controllo degli accessi - Monitoraggio e avvisi |
Imprese con ambienti ibridi e multi-cloud complessi |
Costo elevato; più adatto a grandi aziende |
|
Google TensorFlow Privacy |
Framework per addestrare modelli di machine learning con privacy differenziale. |
- Supporto alla privacy differenziale - Integrazione trasparente con TensorFlow - Fine-tuning dei modelli per la privacy |
Applicazioni di machine learning con dati sensibili |
Limitato all’ecosistema TensorFlow |
Conoscere tecniche e strumenti è importante, ma scegliere l’approccio giusto per il nostro caso d’uso è ancora più impegnativo. Vediamo il processo passo per passo per implementare l’anonimizzazione nella pratica:
Il primo passo è capire con quale tipo di dati stiamo lavorando e quali elementi richiedono protezione. Ciò implica identificare le PII, come nomi, indirizzi, numeri di previdenza sociale o dati medici.
Successivamente, dovremmo determinare come verranno utilizzati i dati dopo l’anonimizzazione. Saranno per ricerca interna, condivisione pubblica o training di modelli di machine learning? Questo passaggio è importante perché alcuni dati potrebbero richiedere tecniche più forti in base ai requisiti normativi.
Tipi di dati e applicazioni diversi richiedono tecniche su misura. È importante abbinare la tecnica appropriata alla natura dei dati, ai requisiti di privacy e all’uso previsto in base alle tecniche discusse.
Dopo aver applicato le tecniche appropriate, è importante verificarne l’efficacia per assicurarsi che i dati siano davvero protetti. Personalmente consiglio di utilizzare strumenti di valutazione del rischio come quelli presentati sopra per verificare con quanta facilità i dati anonimizzati possano essere re-identificati confrontandoli con fonti esterne. Infine, se conduci un processo di anonimizzazione in azienda, valuta di eseguire audit regolari sui dati anonimizzati, soprattutto se i dati vengono condivisi o aggiornati frequentemente.
Questo aiuta a mantenere la conformità alle normative sulla privacy e garantisce che l’anonimizzazione resti efficace nel tempo. Per ulteriori informazioni sulle normative in materia di privacy, consulta l’articolo What is the EU AI Act? A Summary Guide for Leaders.
Come avrai notato, il data masking è leggermente diverso dalle altre tecniche di anonimizzazione presentate finora. Mentre l’anonimizzazione rende i dati completamente non identificabili rimuovendo o alterando gli identificatori personali, il masking consiste nell’offuscare i dati sensibili sostituendoli con riempitivi o valori fittizi mantenendo il formato originale, cioè i dati non vengono alterati, solo offuscati.
L’anonimizzazione generale è permanente e irreversibile, mentre il masking è spesso reversibile. Il masking mantiene struttura e usabilità dei dati per specifiche applicazioni interne, mentre l’anonimizzazione può sacrificare parte dell’utilità in cambio di una protezione più forte.
In sintesi, se il tuo obiettivo principale è proteggere in modo permanente la privacy, soprattutto per dati che potrebbero essere condivisi esternamente o analizzati per insight, l’anonimizzazione è l’approccio migliore. Tuttavia, se devi proteggere i dati in ambienti non di produzione, nella maggior parte dei casi il data masking è sufficiente.
La principale sfida nell’anonimizzazione è il trade-off tra il grado di anonimizzazione e l’utilità dei dati. Un’eccessiva anonimizzazione può degradare la qualità, rendendo i dati meno preziosi per analisi o machine learning, mentre una anonimizzazione insufficiente può lasciare vulnerabilità di privacy. Trovare il giusto equilibrio è una sfida significativa.
Inoltre, anonimizzare i dati per soddisfare varie leggi sulla privacy è complesso, soprattutto perché regioni e settori hanno requisiti differenti e queste leggi evolvono nel tempo. Per garantire una protezione migliore, consiglio di stabilire un processo end-to-end solido che includa monitoraggio continuo dei dati e affinamento delle tecniche di anonimizzazione.
L’anonimizzazione dei dati è un tema caldo anche nel contesto dei Large Language Model (LLM) come ChatGPT. È fondamentale per garantire che informazioni sensibili non vengano divulgate o esposte durante l’uso di questi modelli.
Poiché gli LLM sono addestrati su enormi dataset non strutturati, provenienti da testi pubblicamente disponibili come email, log di chat e documenti, esiste il rischio che informazioni personali sensibili vengano incluse involontariamente nei dati di training, sollevando preoccupazioni sulla privacy.
Quando si lavora con dati non strutturati, è più difficile identificare e garantire la completa rimozione di informazioni personali sensibili prima dell’addestramento. Per questo è fondamentale monitorare gli output degli LLM e filtrare eventuali risposte che potrebbero esporre informazioni sensibili, per mitigare il rischio di leakage dopo il deployment.
Infine, stanno emergendo nuove opzioni come la messa a punto dei modelli con specifiche tutele della privacy e l’uso di ambienti crittografati per l’addestramento; ma come utenti, possiamo sempre cercare di essere prudenti e non condividere informazioni personali con lo strumento.
Con la crescita delle applicazioni data-driven, aumenta anche la raccolta di dati delle persone, rendendo la tutela delle informazioni personali più critica che mai.
Come utenti, dovremmo essere consapevoli dei rischi di violazioni dei dati, e come sviluppatori dovremmo restare aggiornati sulle ultime tecniche di anonimizzazione per garantire la protezione dei dati nelle nostre applicazioni. Questa consapevolezza è particolarmente importante quando i dati vengono resi pubblici, poiché il rischio di re-identificazione è maggiore. Dando priorità alla privacy e perfezionando continuamente le pratiche di anonimizzazione, possiamo creare applicazioni più sicure e responsabili.
Infine, se ti interessa applicare tutte queste tecniche in Python, il corso Data Privacy and Anonymization in Python fa per te!
I migliori corsi DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



