

Kursus
Privasi Data dan Anonimisasi di Python
4 jam
3.9K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleDalam ilmu data, anonimisasi data mengacu pada proses memodifikasi suatu dataset sedemikian rupa sehingga menjadi tidak mungkin atau sangat sulit untuk mengidentifikasi individu berdasarkan data yang tersedia.
Intinya, proses anonimisasi data terdiri dari menghapus atau mengubah informasi pribadi yang dapat diidentifikasi (PII) dari dataset, seperti nama dan alamat, sambil tetap mempertahankan kegunaan data untuk analisis.
Ini juga meminimalkan risiko kebocoran data dan re-identifikasi, sehingga kita dapat berbagi dan menganalisis data secara aman tanpa mengorbankan privasi individu.
Salah satu kasus terkenal dari proses anonimisasi data yang tidak ketat terjadi pada 2006, ketika Netflix merilis dataset film yang memuat data pengguna sebagai bagian dari kompetisi Netflix Prize yang bertujuan meningkatkan sistem rekomendasi mereka.
Para peneliti dari University of Texas menunjukkan kerentanan data yang dianonimkan dengan mengidentifikasi ulang individu menggunakan data IMDb yang tersedia untuk umum. Insiden ini menimbulkan kekhawatiran besar tentang efektivitas teknik anonimisasi data dan menyoroti perlunya pendekatan yang lebih cermat.
Menghapus PII bukan satu-satunya pendekatan untuk anonimisasi data. Dalam beberapa kasus, data juga dapat digeneralisasi untuk mengurangi keunikan individu dalam sebuah dataset. Salah satu contohnya adalah mengganti usia pasti dengan rentang usia. Selain itu, data juga dapat diperturbasi dengan memperkenalkan ketidakakuratan kecil, sehingga lebih sulit mengaitkan kembali data baru tersebut ke individu.
Mengetahui berbagai teknik anonimisasi data membantu kita memilih yang paling sesuai untuk kasus penggunaan kita. Pada bagian ini, kita akan meninjau teknik yang paling umum.
Seperti disebutkan di atas, anonimisasi data tidak hanya tentang menghapus PII. Alih-alih menghapus data, generalisasi mengubahnya menjadi bentuk yang lebih luas dan kurang dapat diidentifikasi. Dengan kata lain, generalisasi mengurangi granularitas data untuk mencegah identifikasi. Ini memungkinkan data tetap berguna untuk analisis sambil menurunkan risiko re-identifikasi.
Sebagai contoh, saat menangani data pribadi seperti tanggal lahir, alih-alih menampilkan tanggal lahir yang tepat, data digeneralisasi menjadi bulan dan tahun, atau hanya tahun, untuk mencegah identifikasi sekaligus menjaga relevansi kelompok usia untuk analisis. Tabel berikut menunjukkan beberapa contoh sederhana anonimisasi data melalui generalisasi pada data usia dan lokasi:
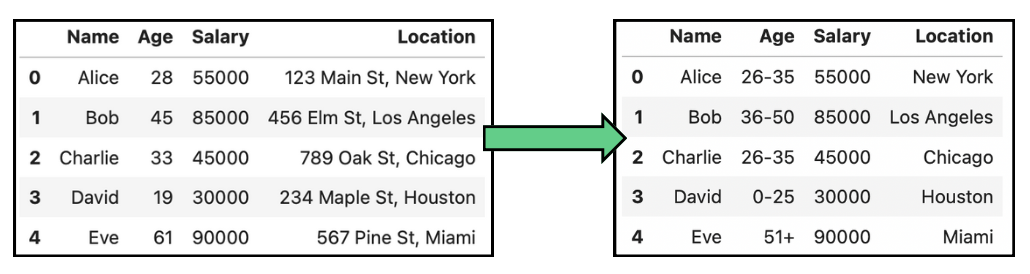
Contoh anonimisasi data melalui generalisasi pada data usia dan lokasi.
Teknik ini paling sering digunakan dalam studi demografi dan riset pasar, namun dapat menyebabkan hilangnya utilitas data sehingga menyulitkan analisis mendetail.
Generalisasi sering digunakan bersama teknik lain seperti K-Anonymity, di mana beberapa rekaman digeneralisasi hingga tidak dapat dibedakan dari setidaknya k rekaman lainnya, sehingga mengurangi risiko mengidentifikasi kembali individu.
Dalam analisis yang tidak memerlukan titik data individu yang presisi namun mementingkan distribusi keseluruhan, perturbasi data dapat diterapkan. Ini mengacu pada proses memodifikasi data asli secara terkontrol untuk melindungi privasi. Modifikasi ini dapat mencakup berbagai teknik seperti pengacakan, penskalaan, atau penukaran nilai. Perturbasi data bertujuan mengaburkan data sambil mempertahankan kegunaannya untuk analisis.
Salah satu kasus konkret perturbasi data adalah penambahan noise. Penambahan noise terdiri dari memperkenalkan perubahan acak atau sistematis, yang disebut “noise”, ke dalam data. Noise ini mengaburkan nilai sebenarnya dari titik data sensitif, sehingga lebih sulit mengidentifikasi ulang individu. Pada gambar berikut, kami memodifikasi gaji asli yang ditampilkan pada tabel di atas dengan menambahkan noise Gaussian:
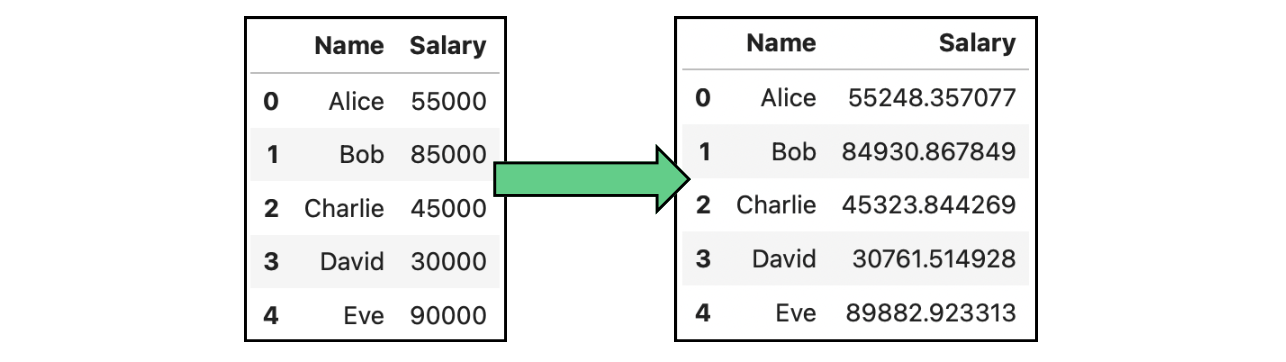
Contoh anonimisasi data melalui penambahan noise pada data gaji.
Alih-alih menambahkan noise pada data nyata, pendekatan lain untuk anonimisasi data adalah menghasilkan data palsu, dalam kondisi tertentu. Pembuatan data sintetis adalah proses menciptakan dataset buatan yang meniru sifat statistik data asli tanpa menyertakan informasi nyata yang dapat diidentifikasi. Ini menjadi alternatif untuk menganalisis dataset yang patuh privasi dan meniru pola serta struktur data asli.
Proses menghasilkan data dengan distribusi yang sama memerlukan pemodelan statistik untuk mengidentifikasi pola, hubungan, dan distribusi yang perlu direplikasi. Secara umum, pembuatan data sintetis lebih sulit diterapkan.
Saya merekomendasikan sumber berikut untuk mempelajarinya lebih lanjut:
Pseudonimisasi berarti mengganti pengenal dalam suatu dataset dengan pseudonim atau pengenal palsu untuk mencegah identifikasi langsung terhadap individu. Berbeda dengan anonimisasi penuh, data yang dipseudonimkan dapat diidentifikasi kembali menggunakan kunci yang menautkan pseudonim ke identitas asli.
Teknik ini umum digunakan dalam riset medis, analitik data, dan pemrosesan data pelanggan, memungkinkan analisis tanpa mengungkap identitas individu, namun tetap memiliki opsi pelacakan kembali di lingkungan yang aman.
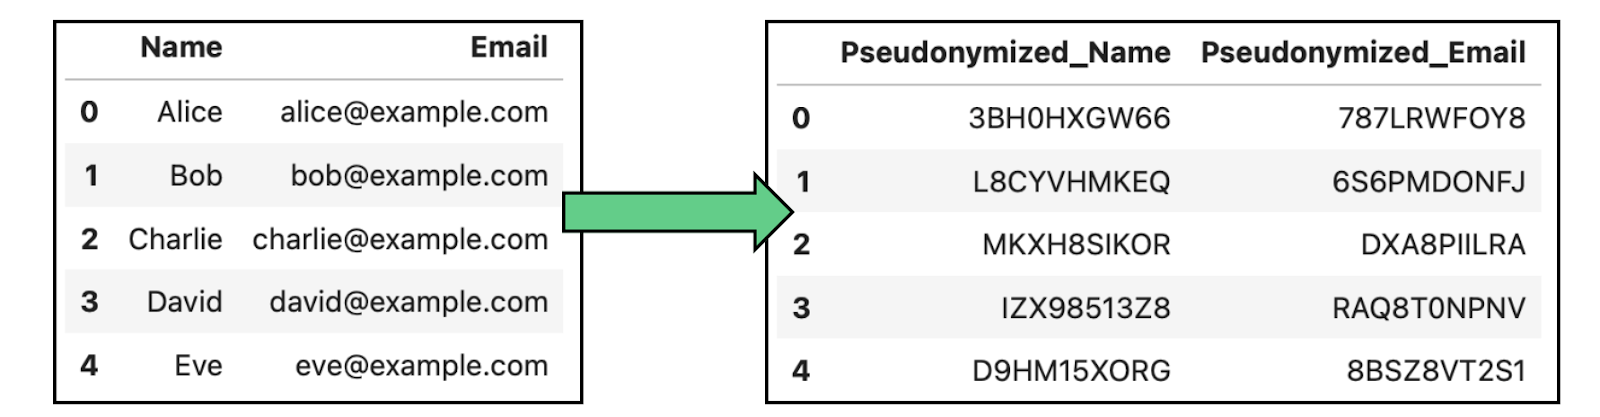
Contoh anonimisasi data melalui pseudonimisasi pada data yang memuat nama dan email.
Teknik lain yang umum digunakan adalah masking data, yang melibatkan mengubah atau mengaburkan data asli sambil mempertahankan format dan strukturnya. Dalam praktiknya, ada dua pendekatan berbeda untuk masking data:
Gambar berikut menunjukkan beberapa transformasi umum dalam masking data:
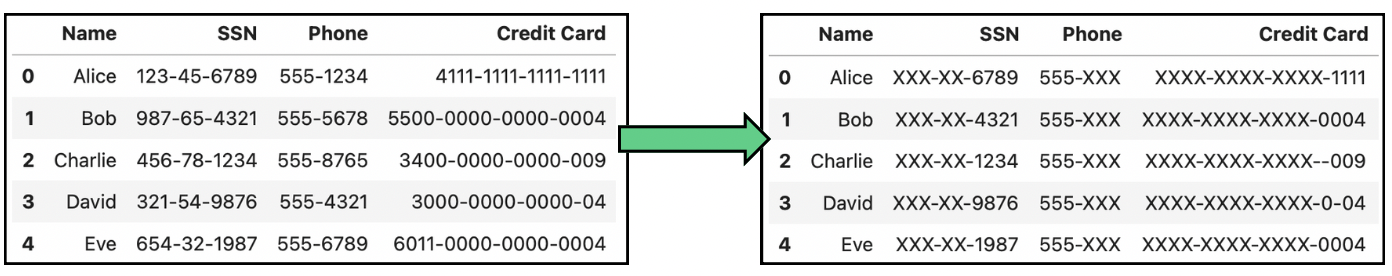
Contoh anonimisasi data melalui masking pada data yang memuat Social Security Number (SSN), telepon, dan nomor kartu kredit.
Karena pentingnya anonimisasi data, sejumlah alat telah dikembangkan untuk mempermudah proses bagi pengembang, sekaligus menyediakan alat validasi siap pakai. Pada bagian ini, kita akan membahas tiga alat, masing-masing lebih cocok tergantung kasus penggunaan.
ARX adalah alat anonimisasi data open-source yang mendukung berbagai teknik perlindungan privasi. Alat ini ideal untuk penelitian, layanan kesehatan, dan organisasi apa pun yang menangani dataset besar yang memerlukan anonimisasi ketat.
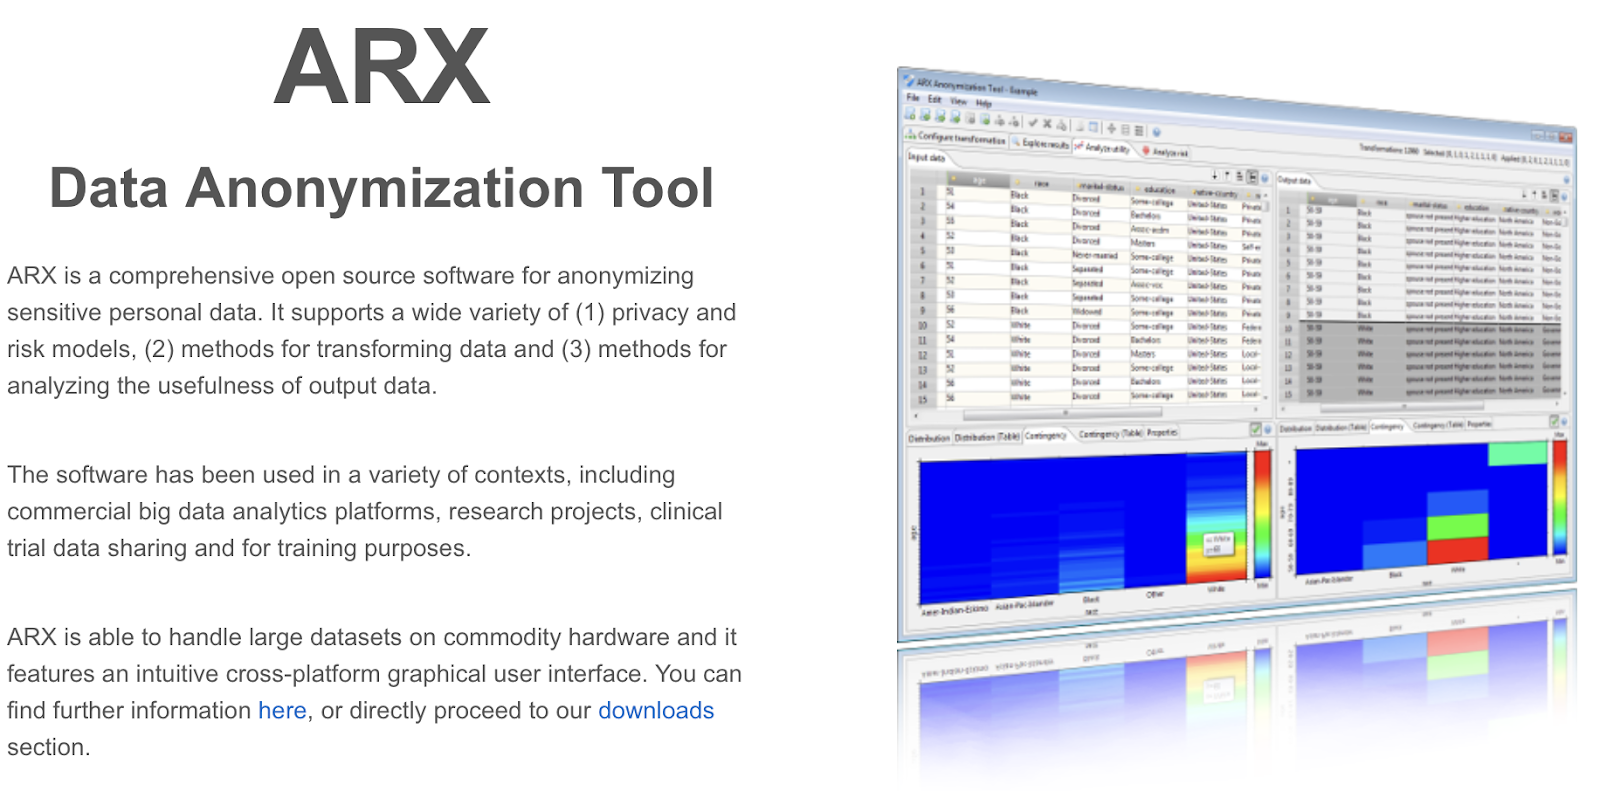
Tangkapan layar halaman utama ARX.
Jika Anda seorang peneliti yang ingin merilis data Anda ke publik, ARX mungkin pilihan terbaik.
Guardium milik IBM adalah solusi yang dirancang untuk melindungi data sensitif di lingkungan hybrid dan multi-cloud. Solusi ini menawarkan enkripsi data end-to-end, pseudonimisasi, dan kontrol akses terperinci untuk memastikan privasi data sepanjang siklus hidupnya. Tersedia berbagai produk mandiri baik untuk pemantauan maupun perlindungan:
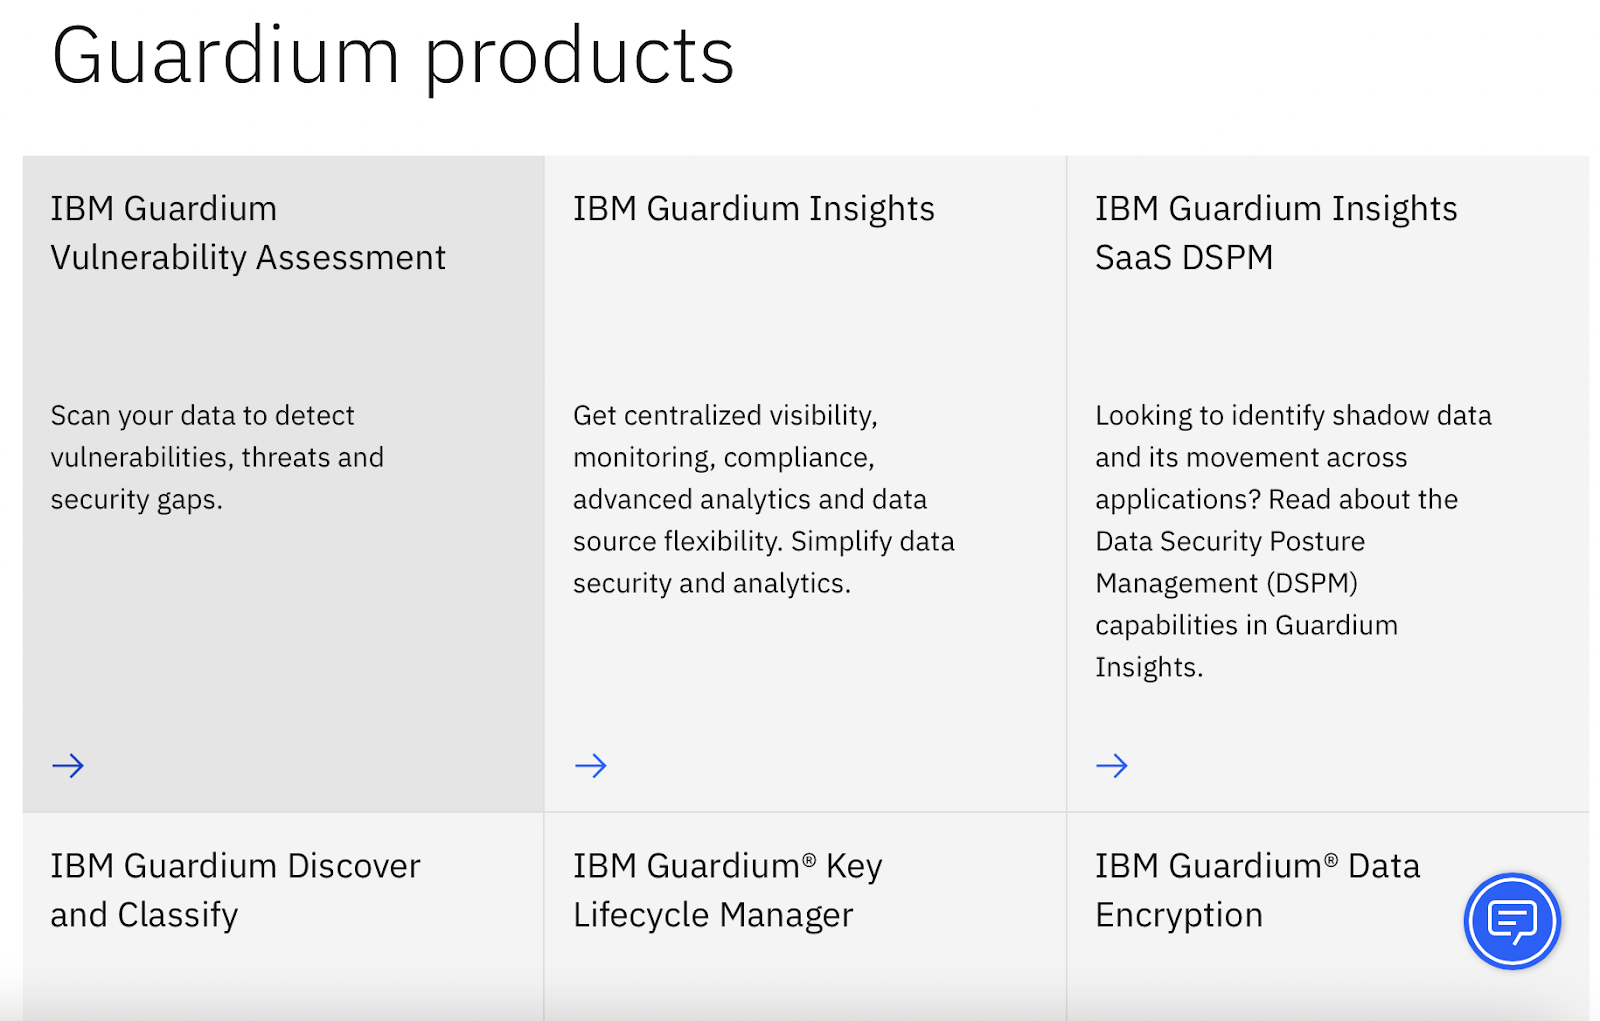
Tangkapan layar halaman utama IBM Guard.
Alat ini cocok untuk perusahaan dengan lingkungan data yang kompleks, khususnya yang menggunakan infrastruktur multi-cloud di mana perlindungan data, kontrol akses, dan kepatuhan regulasi sangat krusial.
Terakhir, TensorFlow Privacy memperluas kerangka kerja machine learning TensorFlow dengan menambahkan dukungan untuk differential privacy. Dengan kata lain, ini memungkinkan pengembang membangun model machine learning yang melindungi privasi data individu dengan membatasi jumlah informasi yang dapat diekstraksi tentang satu titik data.
Tangkapan layar halaman utama TensorFlow Privacy.
TensorFlow Privacy sangat cocok bagi perusahaan atau individu yang mengembangkan modelnya sendiri.
Di bawah ini, kami membuat tabel perbandingan yang menampilkan beragam alat anonimisasi data dan bagaimana perbandingannya:
|
Alat |
Deskripsi |
Fitur Utama |
Kasus Penggunaan Ideal |
Keterbatasan |
|
ARX |
Alat anonimisasi open-source dengan berbagai teknik perlindungan privasi. |
- Dukungan K-Anonymity, L-Diversity, T-Closeness - Analisis Risiko - Pengujian Re-identifikasi |
Riset, Kesehatan, dan Berbagi Data Publik |
Konfigurasi kompleks bagi pemula |
|
IBM Guardium |
Solusi keamanan dan anonimisasi data komprehensif untuk hybrid cloud. |
- Enkripsi data end-to-end - Masking Data - Kontrol Akses - Pemantauan dan Peringatan |
Perusahaan dengan lingkungan hybrid dan multi-cloud yang kompleks |
Biaya tinggi; paling cocok untuk perusahaan besar |
|
Google TensorFlow Privacy |
Kerangka untuk melatih model machine learning dengan differential privacy. |
- Dukungan Differential Privacy - Integrasi mulus dengan TensorFlow - Penyempurnaan model untuk privasi |
Aplikasi machine learning dengan data sensitif |
Terbatas pada ekosistem TensorFlow |
Mengetahui teknik dan alat anonimisasi data yang tersedia itu penting, tetapi memilih teknik yang tepat untuk kasus penggunaan kita lebih menantang lagi. Mari telusuri proses langkah demi langkah dalam menerapkan anonimisasi data secara praktik:
Langkah pertama adalah memahami jenis data yang sedang kita tangani dan elemen mana yang memerlukan perlindungan. Ini mencakup mengidentifikasi PII, seperti nama, alamat, nomor Jaminan Sosial, atau data medis.
Selanjutnya, tentukan bagaimana data akan digunakan setelah dianonimkan. Apakah untuk riset internal, dibagikan ke publik, atau melatih model machine learning? Langkah ini penting karena beberapa data mungkin memerlukan teknik anonimisasi yang lebih kuat berdasarkan persyaratan regulasi.
Beragam jenis data dan aplikasi memerlukan teknik anonimisasi yang disesuaikan. Penting untuk mencocokkan teknik yang tepat dengan karakter data, kebutuhan privasi, dan tujuan penggunaan berdasarkan teknik yang telah dibahas.
Setelah menerapkan teknik anonimisasi yang sesuai, penting untuk memverifikasi efektivitasnya guna memastikan data benar-benar terlindungi. Saya secara pribadi merekomendasikan menggunakan alat penilaian risiko seperti yang dipaparkan di atas untuk memeriksa seberapa mudah data yang telah dianonimkan dapat diidentifikasi kembali dengan membandingkannya dengan sumber data eksternal. Terakhir, jika Anda melakukan proses anonimisasi data sebagai bagian dari perusahaan, pertimbangkan untuk mengaudit data yang dianonimkan secara berkala, terutama jika data sering dibagikan atau diperbarui.
Ini membantu menjaga kepatuhan terhadap regulasi privasi dan memastikan anonimisasi tetap efektif seiring waktu. Untuk informasi lebih lanjut tentang regulasi privasi, lihat artikel What is the EU AI Act? A Summary Guide for Leaders.
Seperti yang mungkin Anda perhatikan, masking data sedikit berbeda dari teknik anonimisasi data lainnya yang telah dipaparkan. Sementara anonimisasi data membuat data sepenuhnya tidak dapat diidentifikasi dengan menghapus atau mengubah pengenal pribadi, masking data mengaburkan data sensitif dengan menggantinya menggunakan padding atau nilai fiktif sambil mempertahankan format data asli, yakni data tidak diubah, hanya diaburkan.
Anonimisasi umum bersifat permanen dan tidak dapat dibalik, sedangkan masking sering kali dapat dibalik. Masking mempertahankan struktur dan kegunaan data untuk aplikasi internal tertentu, sedangkan anonimisasi mungkin mengorbankan sebagian utilitas data demi perlindungan privasi yang lebih kuat.
Singkatnya, jika tujuan utama Anda adalah melindungi privasi secara permanen, terutama untuk data yang mungkin dibagikan ke eksternal atau dianalisis untuk mendapatkan wawasan, anonimisasi data adalah pendekatan terbaik. Namun, jika Anda perlu melindungi data di lingkungan non-produksi, sebagian besar waktu masking data sudah cukup.
Tantangan utama dalam anonimisasi data adalah pertukaran antara tingkat anonimisasi dan kegunaan data. Anonimisasi berlebihan dapat menurunkan kualitas data, sehingga kurang bernilai untuk analisis atau machine learning, sementara anonimisasi yang kurang dapat menyisakan kerentanan privasi. Menemukan keseimbangan yang tepat antara anonimisasi dan pelestarian utilitas data merupakan tantangan besar.
Selain itu, menganonimkan data agar memenuhi berbagai undang-undang privasi itu kompleks, terutama karena wilayah dan industri yang berbeda memiliki persyaratan yang beragam, dan regulasi tersebut terus berkembang. Untuk memastikan perlindungan yang lebih baik, saya merekomendasikan membangun proses end-to-end yang kuat yang mencakup pemantauan data secara berkelanjutan dan penyempurnaan teknik anonimisasi data.
Anonimisasi data juga menjadi topik hangat dalam konteks Large Language Models (LLM) seperti ChatGPT. Ini krusial untuk memastikan informasi sensitif tidak bocor atau terekspos selama penggunaan model-model ini.
Karena LLM dilatih pada dataset tak terstruktur yang masif, bersumber dari teks yang tersedia untuk umum seperti email, log obrolan, dan dokumen, ada risiko informasi pribadi sensitif tanpa sengaja termasuk dalam data pelatihan, yang menimbulkan kekhawatiran privasi.
Saat menangani data tak terstruktur, lebih sulit mengidentifikasi dan memastikan penghapusan lengkap informasi pribadi sensitif sebelum pelatihan. Itulah mengapa memantau keluaran LLM dan menyaring respons yang mungkin mengekspos informasi sensitif sangat penting untuk mengurangi risiko kebocoran data setelah penerapan.
Terakhir, opsi baru seperti penyempurnaan model dengan pengaman privasi tertentu dan penggunaan lingkungan terenkripsi untuk pelatihan juga mulai bermunculan, tetapi sebagai pengguna, kita selalu dapat berhati-hati dan tidak membagikan informasi pribadi kita kepada alat tersebut.
Seiring meningkatnya penggunaan aplikasi berbasis data, pengumpulan data individu juga meningkat, menjadikan perlindungan informasi pribadi semakin krusial.
Sebagai pengguna, kita harus menyadari risiko pelanggaran data, dan sebagai pengembang, kita harus terus mengikuti teknik anonimisasi terbaru untuk memastikan perlindungan data dalam aplikasi kita. Kesadaran ini sangat penting saat data dipublikasikan, karena risiko re-identifikasi lebih tinggi. Dengan memprioritaskan privasi data dan terus menyempurnakan praktik anonimisasi, kita dapat menciptakan aplikasi yang lebih aman dan bertanggung jawab.
Terakhir, jika Anda tertarik menerapkan semua teknik ini dalam Python, kursus Data Privacy and Anonymization in Python cocok untuk Anda!
Kursus Teratas di DataCamp
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




