

Cursus
Dataprivacy en anonimisering in Python
4 uur
3.9K
Oefen en volg je voortgang.
Ga Verder Met GoogleIn data science verwijst data-anonimisering naar het proces waarbij een dataset zo wordt aangepast dat het onmogelijk of zeer moeilijk wordt om personen te identificeren aan de hand van de beschikbare gegevens.
Kort gezegd bestaat het anonimiseringsproces uit het verwijderen of transformeren van persoonlijk identificeerbare informatie (PII) uit datasets, zoals namen en adressen, terwijl de bruikbaarheid van de data voor analyse behouden blijft.
Het minimaliseert ook het risico op datalekken en heridentificatie, zodat we data veilig kunnen delen en analyseren zonder de privacy van individuen in gevaar te brengen.
Een bekend voorbeeld van een niet-rigoureus anonimiseringsproces vond plaats in 2006, toen Netflix een filmmeterdataset met gebruikersdata vrijgaf als onderdeel van de Netflix Prize-wedstrijd, die was bedoeld om hun aanbevelingssysteem te verbeteren.
Onderzoekers van de University of Texas toonden de kwetsbaarheid van de geanonimiseerde data aan door personen te heridentificeren met behulp van openbaar beschikbare IMDb-gegevens. Dit incident leidde tot aanzienlijke bezorgdheid over de effectiviteit van technieken voor data-anonimisering en benadrukte de noodzaak van nauwgezettere aanpakken.
Het verwijderen van PII is niet de enige aanpak voor data-anonimisering. In sommige gevallen kan data ook worden gegeneraliseerd om de uniciteit van individuen in een dataset te verminderen. Een voorbeeld hiervan is het vervangen van exacte leeftijden door leeftijdscategorieën. Daarnaast kan data ook worden verstoord door kleine onnauwkeurigheden in te voeren, waardoor het moeilijker wordt om de nieuwe data aan een individu te koppelen.
Kennis van de verschillende technieken voor data-anonimisering helpt ons om de meest geschikte te kiezen voor onze use-case. In deze sectie verkennen we de meest gebruikelijke.
Zoals hierboven vermeld, draait data-anonimisering niet alleen om het verwijderen van PII. In plaats van data te verwijderen, transformeert generalisatie deze naar een bredere, minder herkenbare vorm. Met andere woorden, generalisatie vermindert de granulariteit van data om identificatie te voorkomen. Zo blijft de data bruikbaar voor analyse, terwijl het risico op heridentificatie afneemt.
Bijvoorbeeld: bij persoonsgegevens zoals geboortedatum wordt in plaats van de exacte geboortedatum alleen de maand en het jaar, of alleen het jaar getoond om identificatie te voorkomen, terwijl de leeftijdsgroep relevant blijft voor analyse. De volgende tabellen laten eenvoudige voorbeelden zien van anonimisering door generalisatie op leeftijd en locatie:
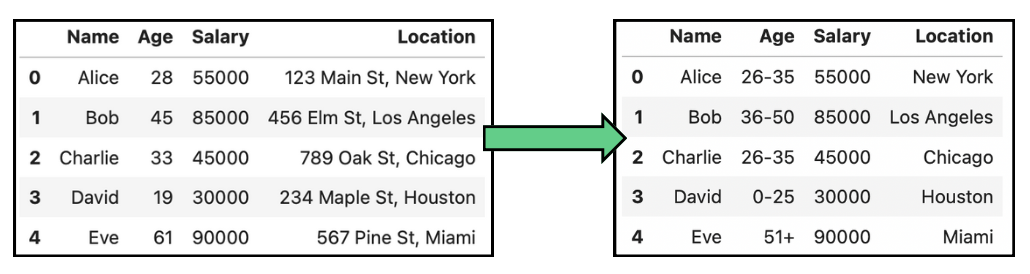
Voorbeeld van data-anonimisering door generalisatie in leeftijds- en locatiedata.
Deze techniek wordt vooral gebruikt in demografisch onderzoek en marktonderzoek, maar kan leiden tot verlies van datanuttigheid, waardoor gedetailleerde analyse moeilijker wordt.
Generalisatie wordt vaak gebruikt in combinatie met andere technieken zoals k-anonimiteit, waarbij meerdere records worden gegeneraliseerd totdat ze niet meer te onderscheiden zijn van ten minste k andere records, waardoor het risico op heridentificatie afneemt.
In analyses waarbij precieze individuele datapunten niet nodig zijn, maar wel de algemene verdeling, kan dataperturbatie worden toegepast. Dit verwijst naar het gecontroleerd wijzigen van de oorspronkelijke data om de privacy te beschermen. Deze wijziging kan verschillende technieken omvatten zoals randomisatie, schalen of het uitwisselen van waarden. Dataperturbatie heeft als doel de data te verhullen terwijl de bruikbaarheid voor analyse behouden blijft.
Een concreet geval van dataperturbatie is het toevoegen van ruis. Ruis toevoegen bestaat uit het invoeren van willekeurige of systematische veranderingen, de zogenaamde “ruis”, in de data. Deze ruis verhult de werkelijke waarden van gevoelige datapunten, waardoor heridentificatie van individuen moeilijker wordt. In de volgende afbeelding hebben we de oorspronkelijke salarissen uit de tabellen hierboven aangepast door Gaussiaanse ruis toe te voegen:
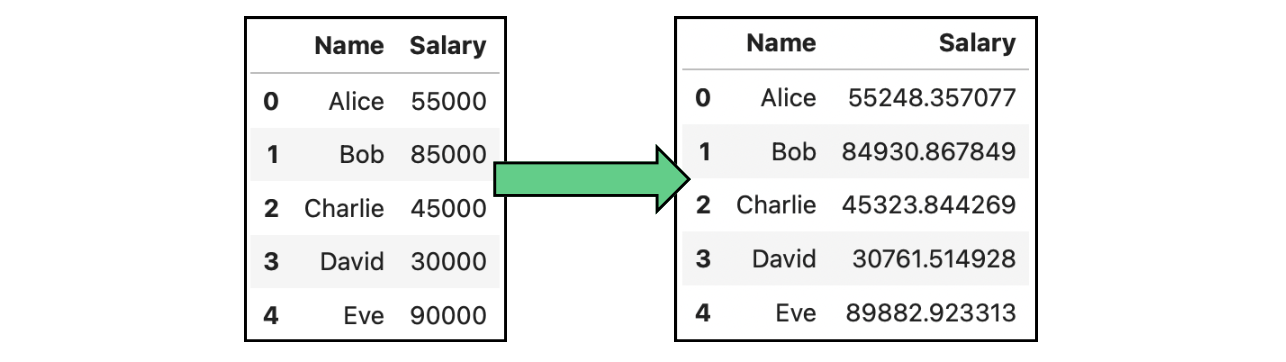
Voorbeeld van data-anonimisering door ruis toe te voegen aan data met salarissen.
In plaats van ruis toe te voegen aan echte data is een andere aanpak het genereren van nepdata, onder bepaalde voorwaarden. Synthetische data genereren is het creëren van kunstmatige datasets die de statistische eigenschappen van de oorspronkelijke data repliceren zonder echte, identificeerbare informatie op te nemen. Het dient als alternatief om een privacy-conforme dataset te analyseren die patronen en structuur van de originele data nabootst.
Het proces om data met dezelfde verdeling te genereren vereist statistische modellering om de patronen, relaties en verdelingen te identificeren die we moeten reproduceren. Over het algemeen is synthetische data genereren lastiger te implementeren.
Ik raad de volgende bronnen aan om meer te leren:
Pseudonimisering houdt in dat identificatoren in een dataset worden vervangen door pseudoniemen of valse identificatoren om directe identificatie van personen te voorkomen. In tegenstelling tot volledige anonimisering kan gepseudonimiseerde data worden herleid met een sleutel die de pseudoniemen aan echte identiteiten koppelt.
Deze techniek wordt vaak gebruikt in medisch onderzoek, data-analyse en de verwerking van klantdata. Zo kan er worden geanalyseerd zonder individuele identiteiten te onthullen, met de optie om in veilige omgevingen alsnog te herleiden.
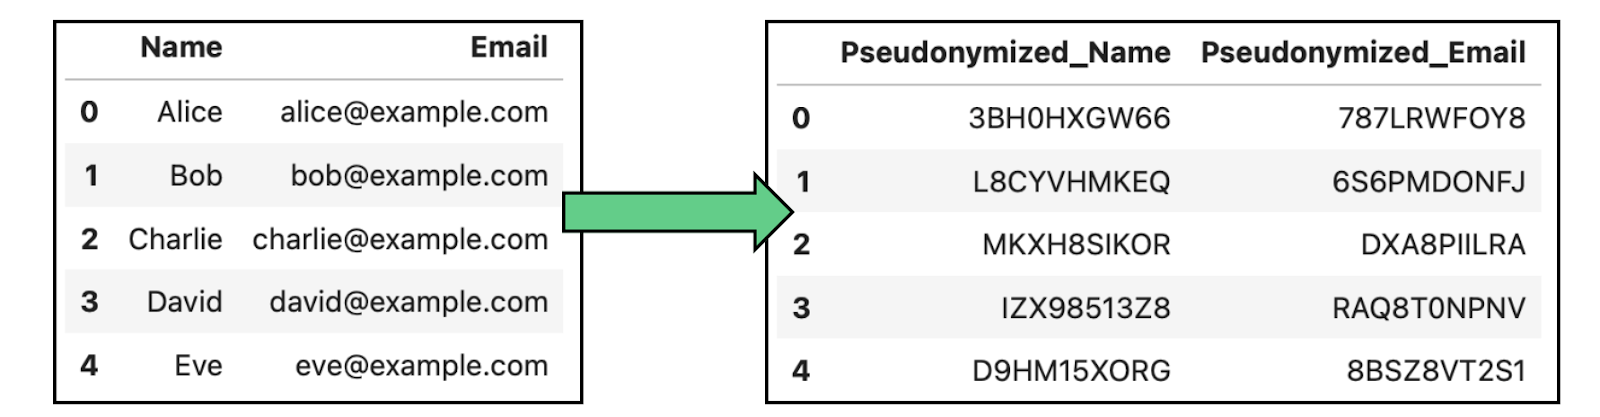
Voorbeeld van data-anonimisering door pseudonimisering in data met namen en e-mails.
Een andere veelgebruikte techniek is datamasking, waarbij de oorspronkelijke data wordt gewijzigd of verhuld terwijl het formaat en de structuur behouden blijven. In de praktijk zijn er twee verschillende benaderingen van datamasking:
De volgende afbeelding toont enkele veelvoorkomende transformaties bij datamasking:
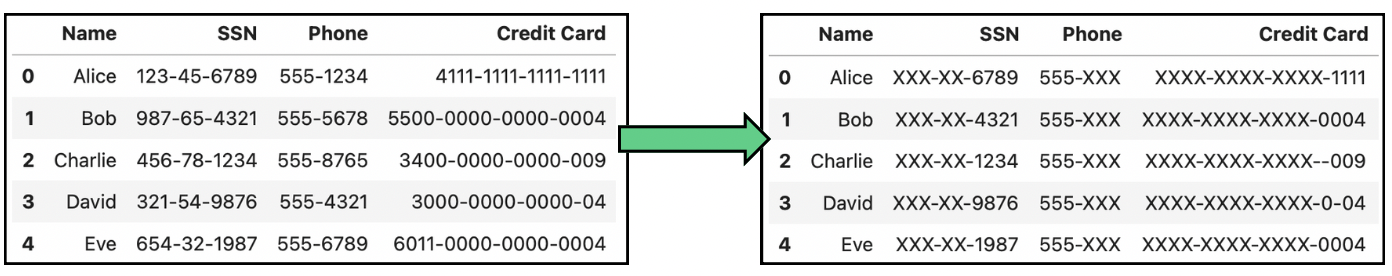
Voorbeeld van data-anonimisering door datamasking op data met burgerservicenummers (SSN), telefoons en creditcardnummers.
Vanwege het belang van data-anonimisering zijn er verschillende tools ontwikkeld om het proces voor ontwikkelaars te vereenvoudigen en direct validatietools te bieden. In deze sectie bekijken we drie tools die elk beter passen afhankelijk van onze use-case.
ARX is een open-sourcetool voor data-anonimisering die diverse privacybeschermende technieken ondersteunt. Het is ideaal voor onderzoek, de gezondheidszorg en elke organisatie die met grote datasets werkt die rigoureuze anonimisering vereisen.
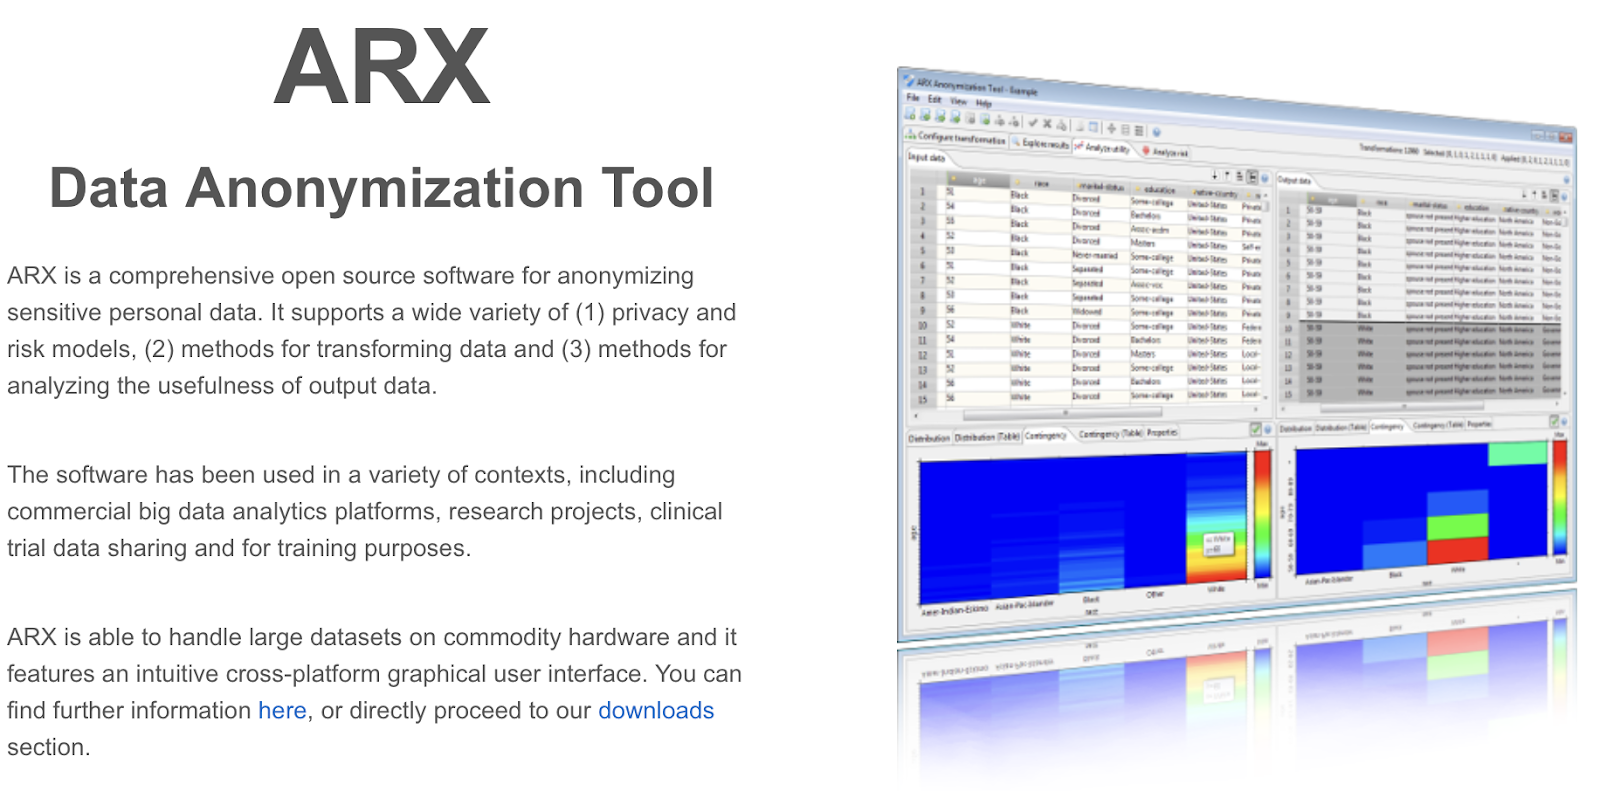
Schermafbeelding van de ARX-hoofdpagina.
Als je als onderzoeker je data openbaar wilt maken, is ARX mogelijk de beste optie voor jou.
IBM’s Guardium is een oplossing die is ontworpen om gevoelige data te beschermen in hybride multicloudomgevingen. Het biedt end-to-end-versleuteling, pseudonimisering en fijnmazige toegangscontrole om privacy gedurende de hele levenscyclus van data te waarborgen. Het heeft verschillende zelfstandige producten voor zowel monitoring als bescherming:
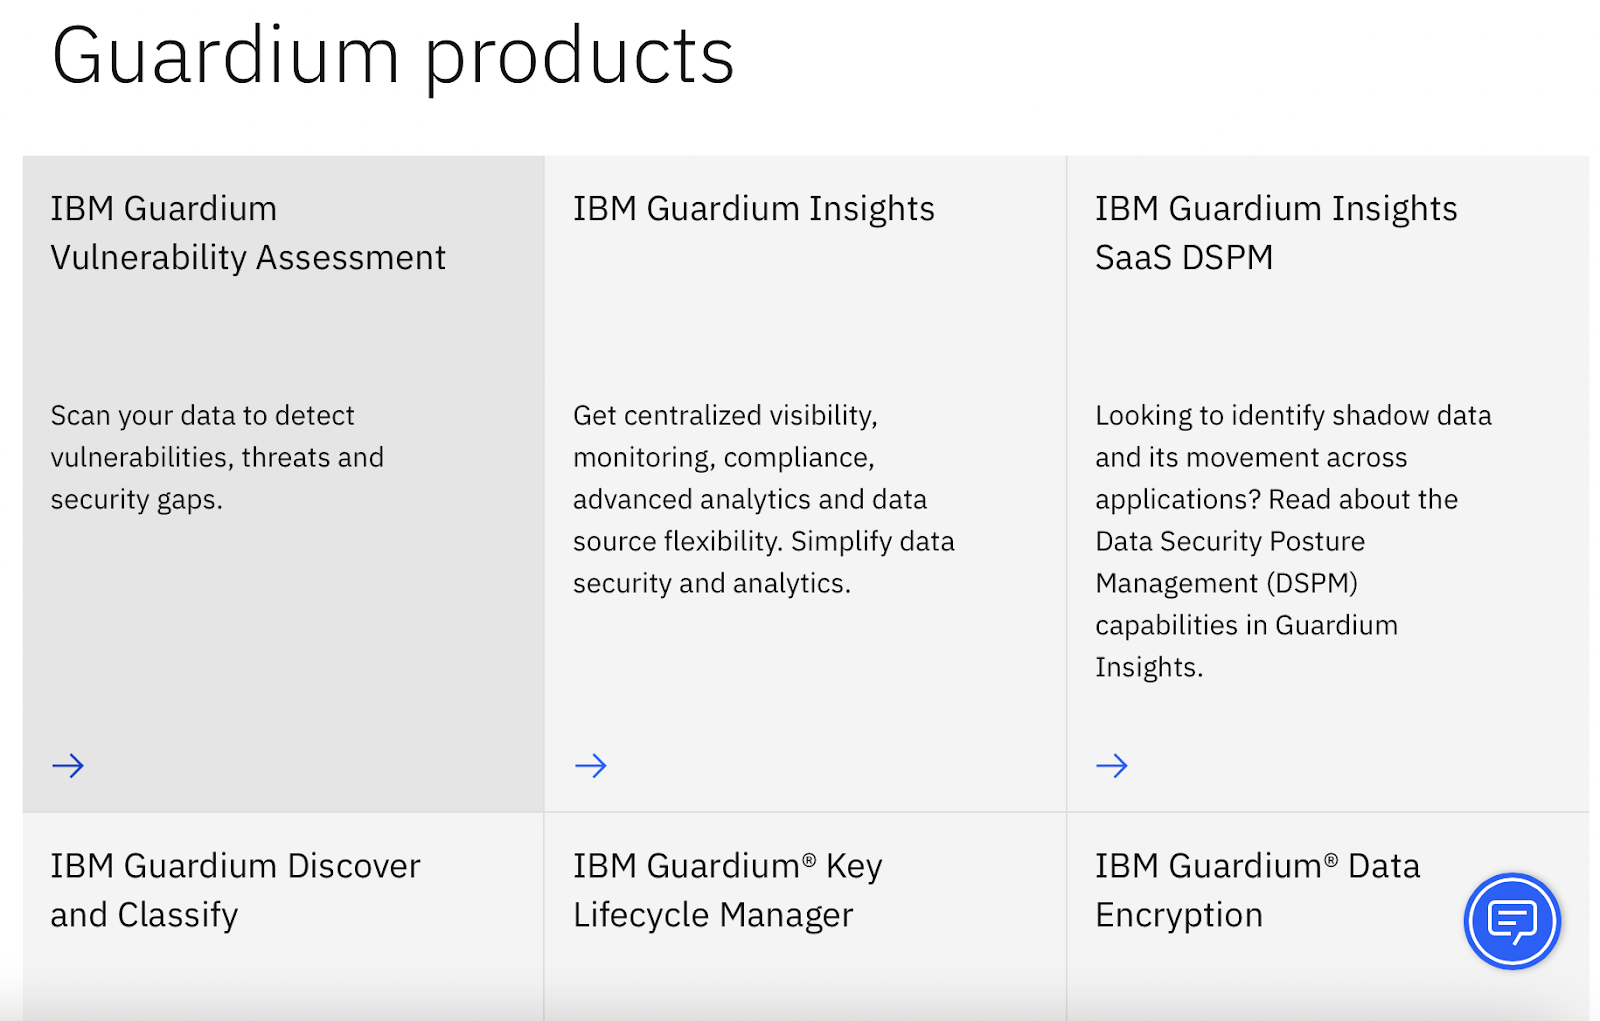
Schermafbeelding van de IBM Guard-hoofdpagina.
Deze tool is geschikt voor enterprises met complexe dataomgevingen, met name organisaties die multicloudinfrastructuren gebruiken waar gegevensbescherming, toegangscontrole en naleving van regelgeving cruciaal zijn.
Tot slot voegt TensorFlow Privacy ondersteuning voor differentiële privacy toe aan het TensorFlow-machinelearningframework. Met andere woorden, het stelt ontwikkelaars in staat modellen te bouwen die de privacy van individuele data beschermen door te beperken hoeveel informatie over één enkel datapunt kan worden afgeleid.
Schermafbeelding van de TensorFlow Privacy-hoofdpagina.
TensorFlow Privacy is perfect voor bedrijven of individuen die de modellen zelf ontwikkelen.
Hieronder vind je een vergelijkingstabel met verschillende tools voor data-anonimisering en hoe ze zich tot elkaar verhouden:
|
Tool |
Beschrijving |
Belangrijkste features |
Ideale use-case |
Beperkingen |
|
ARX |
Open-sourcetool voor anonimisering met diverse privacybeschermende technieken. |
- Ondersteuning voor k-anonimiteit, l-diversiteit, t-closeness - Risicoanalyse - Heridentificatietests |
Onderzoek, gezondheidszorg en openbaar delen van data |
Complexe configuratie voor beginners |
|
IBM Guardium |
Uitgebreide oplossing voor databeveiliging en anonimisering voor hybride cloud. |
- End-to-end-dataversleuteling - Datamasking - Toegangscontrole - Monitoring en alerts |
Enterprises met complexe, hybride en multicloudomgevingen |
Hoge kosten; het meest geschikt voor grote enterprises |
|
Google TensorFlow Privacy |
Framework voor het trainen van machinelearningmodellen met differentiële privacy. |
- Ondersteuning voor differentiële privacy - Naadloze integratie met TensorFlow - Modelafstemming met oog op privacy |
Machinelearningtoepassingen met gevoelige data |
Beperkt tot het TensorFlow-ecosysteem |
Het kennen van beschikbare technieken en tools voor data-anonimisering is belangrijk, maar de juiste techniek kiezen voor onze use-case is nog uitdagender. Laten we het stapsgewijze proces verkennen om data-anonimisering in de praktijk te implementeren:
De eerste stap is begrijpen met welk type data we werken en welke elementen bescherming vereisen. Dit houdt in dat we PII identificeren, zoals namen, adressen, burgerservicenummers of medische gegevens.
Vervolgens moeten we bepalen hoe de data na anonimisering zal worden gebruikt. Is het voor intern onderzoek, openbaar delen of het trainen van machinelearningmodellen? Deze stap is belangrijk omdat sommige data sterkere anonimiseringstechnieken kunnen vereisen op basis van wettelijke eisen.
Verschillende soorten data en toepassingen vereisen op maat gemaakte anonimiseringstechnieken. Het is belangrijk de juiste techniek te koppelen aan de aard van de data, de privacyvereisten en het beoogde gebruik, op basis van de besproken technieken.
Na het toepassen van de juiste technieken is het belangrijk om de effectiviteit te verifiëren en zeker te zijn dat de data echt beschermd is. Ik raad persoonlijk aan om risicobeoordelingstools te gebruiken, zoals de hierboven gepresenteerde, om te controleren hoe gemakkelijk geanonimiseerde data kan worden hergeïdentificeerd door te vergelijken met externe databronnen. Tot slot, als je een data-anonimiseringsproces binnen een bedrijf uitvoert, overweeg dan om geanonimiseerde data regelmatig te auditen, vooral als de data vaak wordt gedeeld of bijgewerkt.
Dit helpt te voldoen aan privacyregelgeving en zorgt ervoor dat anonimisering in de loop van de tijd effectief blijft. Voor meer informatie over privacyregelgeving, bekijk het artikel What is the EU AI Act? A Summary Guide for Leaders.
Zoals je misschien hebt gemerkt, verschilt datamasking enigszins van de andere tot nu toe gepresenteerde technieken voor data-anonimisering. Terwijl data-anonimisering inhoudt dat data volledig onidentificeerbaar wordt gemaakt door persoonlijke identificatoren te verwijderen of te wijzigen, houdt datamasking in dat gevoelige data wordt verhuld door deze te vervangen door opvulling of gefingeerde waarden, terwijl het oorspronkelijke dataformaat behouden blijft; de data wordt dus niet gewijzigd, alleen verhuld.
Algemene anonimisering is permanent en onomkeerbaar, terwijl masking vaak omkeerbaar is. Masking behoudt datastructuur en bruikbaarheid voor specifieke interne toepassingen, terwijl anonimisering soms wat datanuttigheid opoffert in ruil voor sterkere privacybescherming.
Samengevat: als je primaire doel is om privacy permanent te beschermen, vooral voor data die extern gedeeld kan worden of geanalyseerd wordt voor inzichten, dan is data-anonimisering de beste aanpak. Heb je echter data te beschermen in niet-productieomgevingen, dan is datamasking meestal voldoende.
De grootste uitdaging bij data-anonimisering is de afweging tussen de mate van anonimisering en de bruikbaarheid van de data. Overmatige anonimisering kan de datakwaliteit aantasten, waardoor deze minder waardevol wordt voor analyse of machine learning, terwijl onvoldoende anonimisering privacykwetsbaarheden kan achterlaten. De juiste balans vinden tussen anonimisering en het behoud van datanuttigheid is een flinke uitdaging.
Bovendien is het anonimiseren van data om te voldoen aan uiteenlopende privacywetten complex, zeker omdat regio’s en sectoren verschillende vereisten hebben en deze wetten in de loop der tijd evolueren. Voor betere bescherming raad ik aan een robuust end-to-endproces op te zetten dat continuïteitsmonitoring van data en verfijning van de anonimiseringstechnieken omvat.
Data-anonimisering is ook een hot topic in de context van Large Language Models (LLM’s) zoals ChatGPT. Het is cruciaal om te voorkomen dat gevoelige informatie uitlekt of wordt blootgesteld bij het gebruik van deze modellen.
Omdat LLM’s worden getraind op enorme, ongestructureerde datasets die afkomstig zijn uit openbaar beschikbare tekst zoals e-mails, chatlogs en documenten, bestaat het risico dat gevoelige persoonlijke informatie onbedoeld in de trainingsdata terechtkomt, wat privacyzorgen oproept.
Bij ongestructureerde data is het moeilijker om gevoelige persoonlijke informatie te identificeren en volledig te verwijderen vóór het trainen. Daarom is het monitoren van de output van LLM’s en het filteren van reacties die mogelijk gevoelige informatie blootleggen cruciaal om het risico op datalekken na uitrol te beperken.
Tot slot ontstaan er nieuwe opties zoals modellen fine-tunen met specifieke privacywaarborgen en het gebruik van versleutelde omgevingen voor training. Maar als gebruiker kun je altijd voorzichtig zijn en je persoonlijke informatie niet met de tool delen.
Naarmate het gebruik van datagedreven applicaties toeneemt, groeit ook de verzameling van persoonsgegevens, waardoor het beschermen van persoonlijke informatie belangrijker is dan ooit.
Als gebruikers moeten we ons bewust zijn van de risico’s van datalekken, en als ontwikkelaars moeten we op de hoogte blijven van de nieuwste anonimiseringstechnieken om gegevensbescherming in onze applicaties te waarborgen. Deze alertheid is vooral belangrijk wanneer data openbaar wordt gemaakt, omdat het risico op heridentificatie dan groter is. Door prioriteit te geven aan dataprijvacy en anonimiseringspraktijken continu te verbeteren, kunnen we veiligere en verantwoordelijkere applicaties maken.
Ben je tot slot geïnteresseerd om al deze technieken in Python toe te passen? Dan is de cursus Data Privacy and Anonymization in Python iets voor jou!
Topcursussen op DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

