

Kurs
Python ile Veri Gizliliği ve Anonimleştirme
4 sa
3.9K
Alıştırma and program your progress.
Google Ile Devam EdinVeri biliminde veri anonimleştirme, bir veri kümesinin, mevcut verilere dayanarak bireylerin tanımlanmasını imkânsız veya çok zor hale getirecek şekilde değiştirilmesi sürecini ifade eder.
Özünde veri anonimleştirme süreci, isimler ve adresler gibi kişisel olarak tanımlanabilir bilgilerin (PII) veri kümelerinden çıkarılması veya dönüştürülmesinden oluşur; bu yapılırken verinin analiz için kullanışlılığı korunur.
Ayrıca veri sızıntısı ve yeniden tanımlama riskini en aza indirerek, bireysel gizliliği tehlikeye atmadan verileri güvenle paylaşmamıza ve analiz etmemize olanak tanır.
Titiz olmayan bir veri anonimleştirme sürecine dair ünlü bir örnek, Netflix’in 2006’da tavsiye sistemini iyileştirmeyi amaçlayan Netflix Prize yarışmasının bir parçası olarak kullanıcı verileri içeren bir film veri kümesi yayımlamasıyla yaşandı.
Teksas Üniversitesi’nden araştırmacılar, herkese açık IMDb verilerini kullanarak bireyleri yeniden tanımlayarak anonimleştirilmiş verinin zayıflığını gösterdi. Bu olay, veri anonimleştirme tekniklerinin etkinliği konusunda önemli endişeler uyandırdı ve daha özenli yaklaşımların gerekliliğini vurguladı.
PII’ları kaldırmak veri anonimleştirme için tek yaklaşım değildir. Bazı durumlarda, bir veri kümesindeki bireylerin benzersizliğini azaltmak amacıyla veriler genelleştirilebilir. Buna örnek olarak, tam yaşların yaş aralıklarıyla değiştirilmesi verilebilir. Ayrıca, verilere küçük tutarsızlıklar ekleyerek veriyi bozmak da mümkündür; bu, yeni veriyi bir bireyle ilişkilendirmeyi zorlaştırır.
Farklı veri anonimleştirme tekniklerini bilmek, kullanım senaryomuza en uygun olanı seçmemize yardımcı olur. Bu bölümde en yaygın olanlarını inceleyeceğiz.
Yukarıda belirtildiği gibi, veri anonimleştirme yalnızca PII’ları kaldırmak değildir. Veriyi kaldırmak yerine, genelleştirme onu daha geniş ve daha az tanımlanabilir bir forma dönüştürür. Başka bir deyişle, genelleştirme kimliği önlemek için verinin ayrıntı düzeyini düşürür. Bu sayede veri, yeniden tanımlama riskini azaltırken analiz için kullanışlı kalır.
Örneğin doğum tarihi gibi kişisel verilerle çalışırken, tam doğum tarihini göstermek yerine veriyi ay-yıl veya sadece yıl düzeyine genelleştirmek, kimliği önlerken yaş grubunu analiz için ilgili tutar. Aşağıdaki tablolar, yaş ve konum üzerinde genelleştirme yoluyla veri anonimleştirmeye dair basit örnekler gösterir:
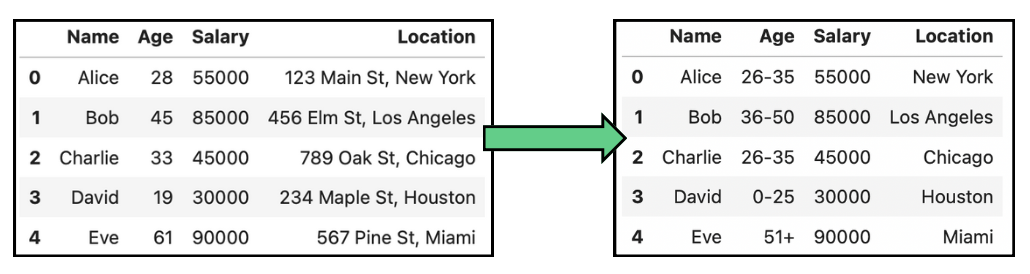
Yaş ve konum verilerinde genelleştirme ile veri anonimleştirme örneği.
Bu teknik çoğunlukla demografik çalışmalar ve pazar araştırmalarında kullanılır; ancak veri faydasında kayba yol açarak detaylı analizleri zorlaştırabilir.
Genelleştirme genellikle K-Anonimlik gibi diğer tekniklerle birlikte kullanılır; burada birden fazla kayıt, en az k diğer kayıttan ayırt edilemeyecek hale gelene kadar genelleştirilir ve bireylerin yeniden tanımlanma riski azaltılır.
Bireysel veri noktalarının hassas doğruluğunun gerekmediği, ancak genel dağılımın önemli olduğu analizlerde veri bozma uygulanabilir. Bu, gizliliği korumak için orijinal verilerin kontrollü biçimde değiştirilmesi sürecidir. Bu değişiklik; rastgeleleştirme, ölçekleme veya değerlerin yer değiştirmesi gibi çeşitli teknikleri içerebilir. Veri bozmanın amacı, verinin analiz için kullanılabilirliğini korurken onu bulanıklaştırmaktır.
Veri bozmanın somut bir örneği gürültü eklemedir. Gürültü ekleme, veriye rastgele veya sistematik değişiklikler, yani “gürültü” katmayı ifade eder. Bu gürültü, hassas veri noktalarının gerçek değerlerini gizleyerek bireylerin yeniden tanımlanmasını zorlaştırır. Aşağıdaki görselde, yukarıdaki tablolarda gösterilen orijinal maaşları Gauss gürültüsü ekleyerek değiştirdik:
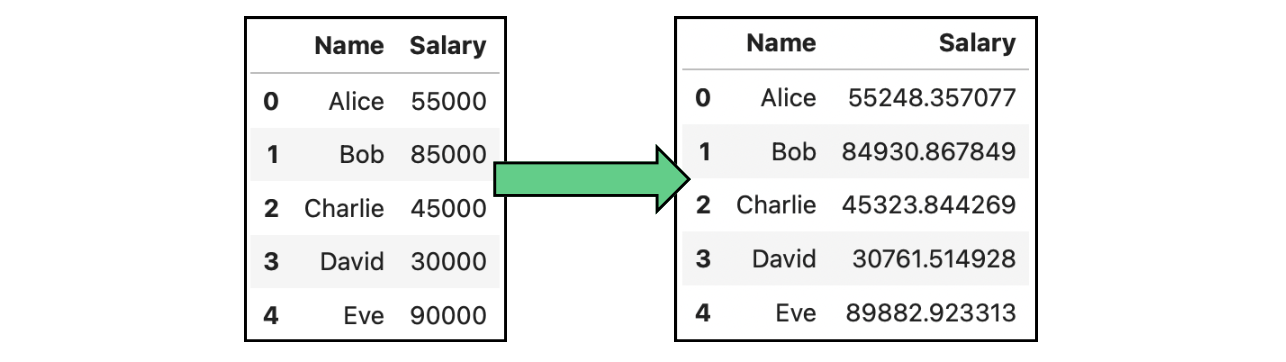
Maaş içeren verilerde gürültü ekleme ile veri anonimleştirme örneği.
Gerçek veriye gürültü eklemek yerine, belirli koşullar altında sahte veri üretmek de bir veri anonimleştirme yaklaşımıdır. Sentetik veri üretimi, orijinal verinin istatistiksel özelliklerini içeren ancak gerçek, tanımlanabilir bilgi barındırmayan yapay veri kümeleri oluşturma sürecidir. Bu, orijinal verinin kalıplarını ve yapısını taklit eden, gizlilik uyumlu bir veri kümesi üzerinde analiz yapmak için bir alternatiftir.
Aynı dağılıma sahip veri üretme süreci, tekrar etmemiz gereken kalıpları, ilişkileri ve dağılımları belirlemek için istatistiksel modellemeyi gerektirir. Genel olarak, sentetik veri üretimi uygulaması daha zordur.
Daha fazlasını öğrenmek için aşağıdaki kaynaklara göz atmanızı öneririm:
Takma adlandırma, doğrudan tanımlamayı önlemek için bir veri kümesindeki tanımlayıcıların takma adlar veya sahte tanımlayıcılarla değiştirilmesini ifade eder. Tam anonimleştirmenin aksine, takma adlandırılmış veriler, takma adları gerçek kimliklerle ilişkilendiren bir anahtar kullanılarak yeniden tanımlanabilir.
Bu teknik; tıbbi araştırmalar, veri analitiği ve müşteri verisi işleme gibi alanlarda yaygın olarak kullanılır; bireysel kimlikleri ifşa etmeden analiz yapılmasına olanak tanırken, güvenli ortamlarda geri izleme seçeneğini de sunar.
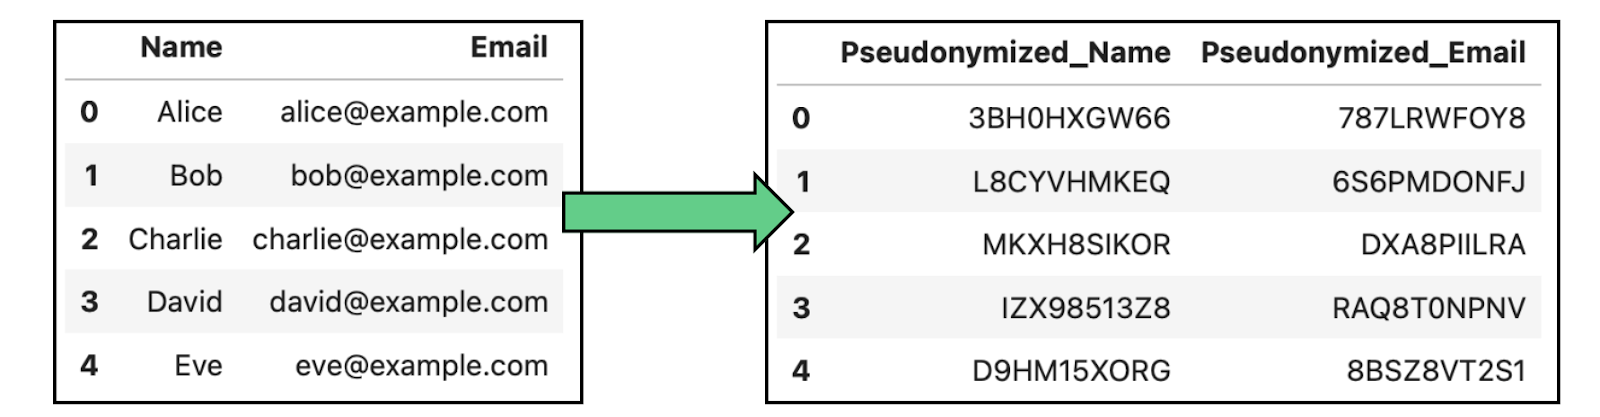
İsimler ve e-postalar içeren verilerde takma adlandırma ile veri anonimleştirme örneği.
Bir diğer yaygın teknik, orijinal verinin biçimini ve yapısını korurken veriyi değiştirme veya gizlemeyi içeren veri maskelemedir. Uygulamada veri maskelemenin iki farklı yaklaşımı vardır:
Aşağıdaki görsel, veri maskelemedeki bazı yaygın dönüşümleri göstermektedir:
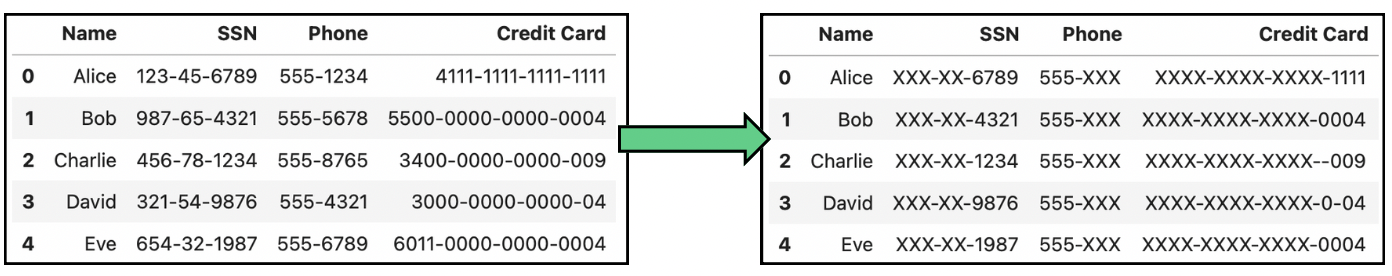
Sosyal Güvenlik Numaraları (SSN), telefonlar ve kredi kartı numaraları içeren verilerde veri maskeleme ile veri anonimleştirme örneği.
Veri anonimleştirmenin önemi nedeniyle, süreci geliştiriciler için daha sorunsuz hale getirmek ve hazır doğrulama yetenekleri sunmak üzere çeşitli araçlar geliştirilmiştir. Bu bölümde, kullanım senaryomuza göre daha uygun olabilecek üç aracı inceleyeceğiz.
ARX, çeşitli gizlilik koruma tekniklerini destekleyen açık kaynaklı bir veri anonimleştirme aracıdır. Araştırma, sağlık hizmetleri ve titiz anonimleştirme gerektiren büyük veri kümeleriyle çalışan tüm kuruluşlar için idealdir.
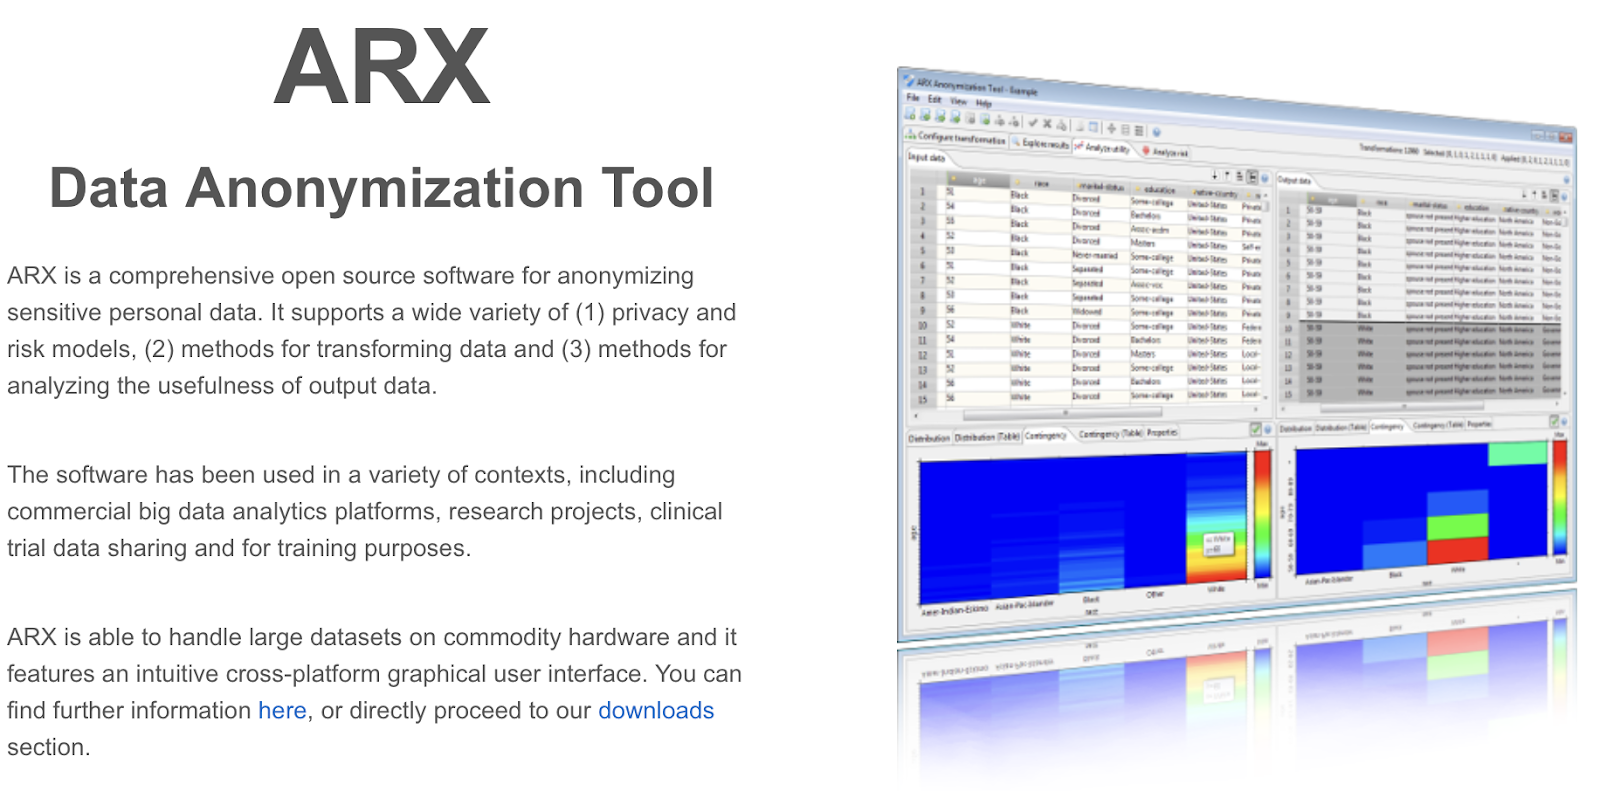
ARX ana sayfasının ekran görüntüsü.
Verilerinizi kamuya açık olarak yayımlamayı hedefleyen bir araştırmacıysanız, ARX sizin için en iyi seçenek olabilir.
IBM’in Guardium çözümü, hibrit ve çoklu bulut ortamlarında hassas verileri korumak üzere tasarlanmıştır. Uçtan uca veri şifreleme, takma adlandırma ve yaşam döngüsü boyunca veri gizliliğini sağlamak için ince taneli erişim kontrolleri sunar. Hem izleme hem de koruma için farklı bağımsız ürünleri vardır:
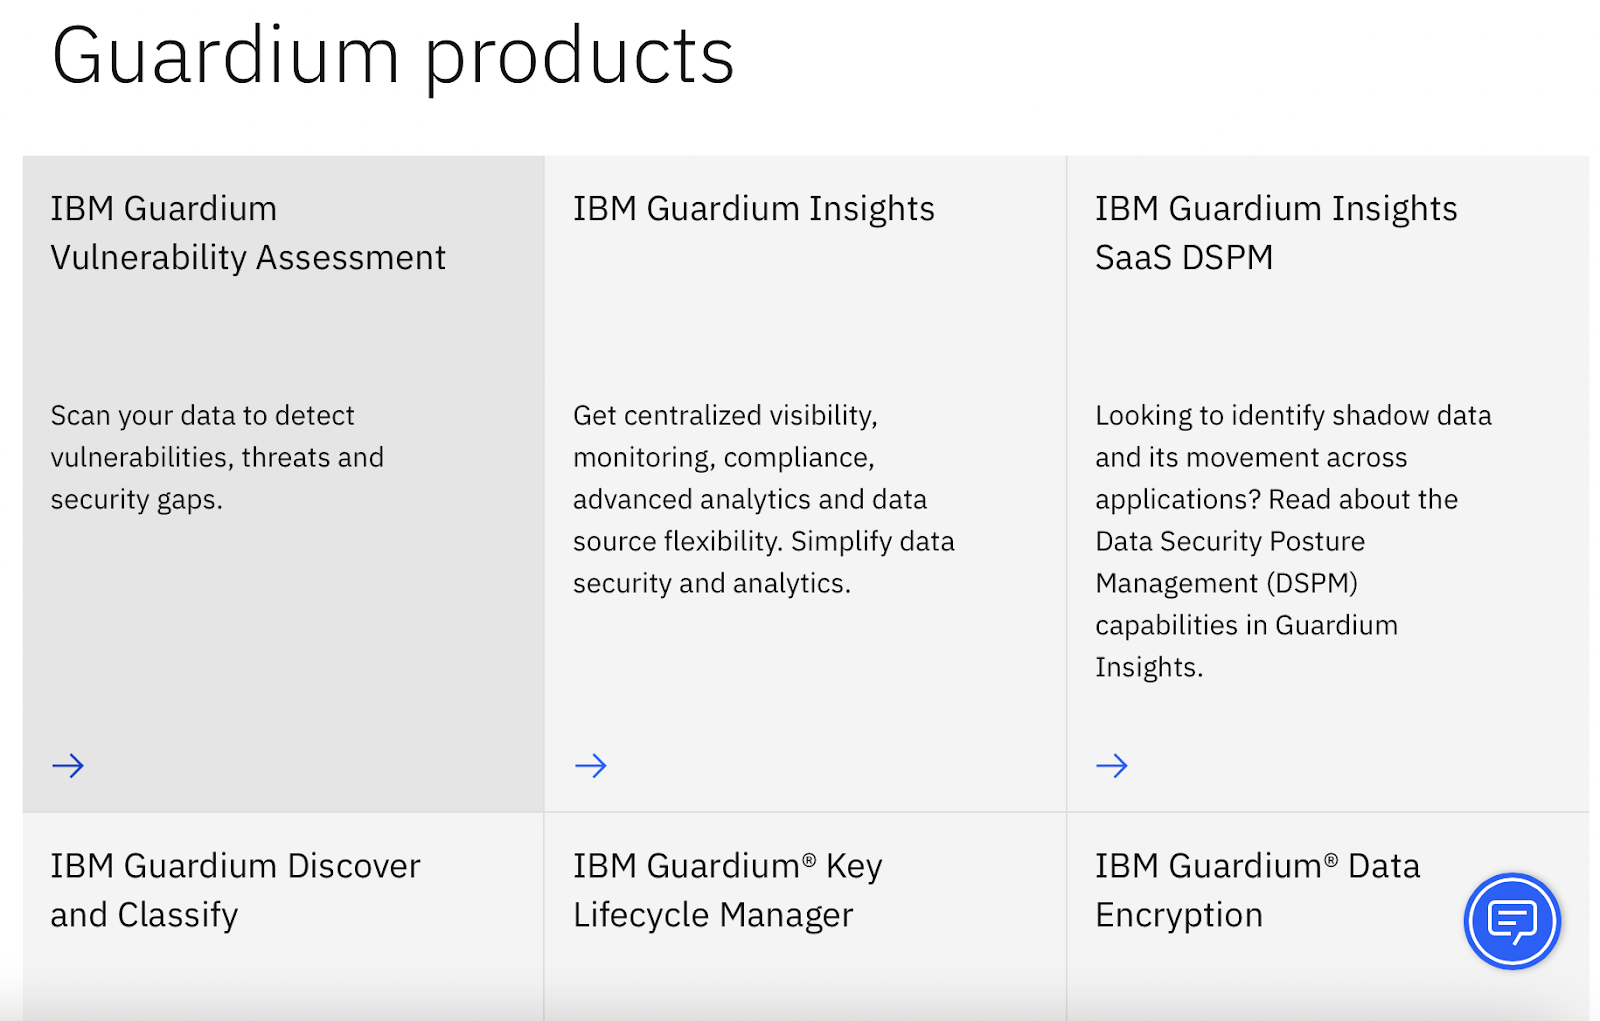
IBM Guard ana sayfasının ekran görüntüsü.
Bu araç, özellikle veri koruması, erişim kontrolü ve düzenleyici uyumluluğun kritik olduğu çoklu bulut altyapılarını kullanan, karmaşık veri ortamlarına sahip işletmeler için uygundur.
Son olarak TensorFlow Privacy, TensorFlow makine öğrenimi çerçevesini farklılaştırılmış gizlilik desteğiyle genişletir. Başka bir deyişle, geliştiricilerin tek bir veri noktası hakkında çıkarılabilecek bilgi miktarını sınırlayarak bireysel veri gizliliğini koruyan makine öğrenimi modelleri oluşturmalarını sağlar.
TensorFlow Privacy ana sayfasının ekran görüntüsü.
TensorFlow Privacy, modelleri bizzat geliştiren şirketler veya bireyler için idealdir.
Aşağıda, farklı veri anonimleştirme araçlarını ve nasıl karşılaştıklarını gösteren bir karşılaştırma tablosu oluşturduk:
|
Araç |
Açıklama |
Temel Özellikler |
İdeal Kullanım Durumu |
Sınırlamalar |
|
ARX |
Çeşitli gizlilik koruma tekniklerine sahip açık kaynaklı anonimleştirme aracı. |
- K-Anonimlik, L-Çeşitlilik, T-Yakınlık desteği - Risk Analizi - Yeniden Tanımlama Testi |
Araştırma, Sağlık ve Kamuya Veri Paylaşımı |
Yeni başlayanlar için karmaşık yapılandırma |
|
IBM Guardium |
Hibrit bulut için kapsamlı veri güvenliği ve anonimleştirme çözümü. |
- Uçtan uca veri şifreleme - Veri Maskeleme - Erişim Kontrolü - İzleme ve Uyarılar |
Karmaşık, hibrit ve çoklu bulut ortamlarına sahip işletmeler |
Yüksek maliyet; büyük işletmeler için daha uygun |
|
Google TensorFlow Privacy |
Farklılaştırılmış gizlilikle makine öğrenimi modelleri eğitme çerçevesi. |
- Farklılaştırılmış Gizlilik desteği - Sorunsuz TensorFlow entegrasyonu - Gizlilik için model ince ayarı |
Hassas verili makine öğrenimi uygulamaları |
TensorFlow ekosistemiyle sınırlı |
Mevcut veri anonimleştirme tekniklerini ve araçlarını bilmek önemlidir; ancak kullanım durumumuz için doğru tekniği seçmek daha da zordur. Veri anonimleştirmenin pratikte adım adım uygulanma sürecini inceleyelim:
İlk adım, hangi veri türleriyle çalıştığımızı ve hangi unsurların korunması gerektiğini anlamaktır. Bu, isimler, adresler, Sosyal Güvenlik numaraları veya tıbbi veriler gibi PII’ların belirlenmesini içerir.
Ardından, verinin anonimleştirmeden sonra nasıl kullanılacağını belirlemeliyiz. İç araştırma, kamuya açık paylaşım veya makine öğrenimi modellerinin eğitimi için mi kullanılacak? Bu adım önemlidir; zira bazı veriler düzenleyici gereksinimlere bağlı olarak daha güçlü anonimleştirme teknikleri gerektirebilir.
Farklı veri türleri ve uygulamalar, özel anonimleştirme teknikleri gerektirir. Uygun tekniğin, verinin doğası, gizlilik gereksinimleri ve amaçlanan kullanım ile uyumlu olması önemlidir.
Uygun anonimleştirme tekniklerini uyguladıktan sonra, verinin gerçekten korunduğundan emin olmak için etkinliklerini doğrulamak önemlidir. Kişisel olarak, yukarıda sunulanlar gibi risk değerlendirme araçlarını kullanarak anonimleştirilmiş verinin harici veri kaynaklarıyla karşılaştırıldığında ne kadar kolay yeniden tanımlanabileceğini kontrol etmenizi öneririm. Son olarak, bir şirketin parçası olarak veri anonimleştirme süreci yürütüyorsanız, özellikle veriler sıkça paylaşılıyor veya güncelleniyorsa, anonimleştirilmiş verileri düzenli olarak denetlemeyi düşünün.
Bu, gizlilik düzenlemelerine uyumu sürdürmeye ve zaman içinde anonimleştirmenin etkin kalmasına yardımcı olur. Gizlilik düzenlemeleri hakkında daha fazla bilgi için AB Yapay Zekâ Yasası Nedir? Yöneticiler için Özet Rehber makalesine göz atın.
Fark etmiş olabileceğiniz gibi, veri maskeleme şimdiye kadar sunulan diğer veri anonimleştirme tekniklerinden biraz farklıdır. Veri anonimleştirme, kişisel tanımlayıcıları kaldırarak veya değiştirerek veriyi tamamen tanımlanamaz hale getirirken, veri maskeleme, orijinal veri biçimini koruyarak hassas veriyi dolgu veya kurgusal değerlerle gizler; yani veri değiştirilmez, yalnızca gizlenir.
Genel anonimleştirme kalıcı ve geri döndürülemezken, maskeleme sıklıkla geri döndürülebilir. Maskeleme, belirli dahili uygulamalar için veri yapısını ve kullanılabilirliğini korur; anonimleştirme ise daha güçlü gizlilik koruması karşılığında veri faydasından bir miktar ödün verebilir.
Özetle, birincil hedefiniz gizliliği kalıcı olarak korumaksa—özellikle verilerin haricen paylaşılabileceği veya içgörü üretmek için analiz edileceği durumlarda—veri anonimleştirme en iyi yaklaşımdır. Ancak üretim dışı ortamlarda veriyi korumanız gerekiyorsa, çoğu zaman veri maskeleme yeterlidir.
Veri anonimleştirmenin temel zorluğu, anonimleştirme derecesi ile verinin kullanışlılığı arasındaki ödünleşimdir. Aşırı anonimleştirme, veri kalitesini düşürerek analize veya makine öğrenimine olan değerini azaltabilir; yetersiz anonimleştirme ise gizlilik açıkları bırakabilir. Anonimleştirme ile veri faydasını koruma arasında doğru dengeyi kurmak önemli bir zorluktur.
Ayrıca, çeşitli gizlilik yasalarına uyacak şekilde verileri anonimleştirmek karmaşıktır; zira farklı bölgeler ve endüstrilerin farklı gereksinimleri vardır ve bu yasalar zamanla evrilir. Daha iyi koruma sağlamak için, verinin sürekli izlenmesini ve veri anonimleştirme tekniklerinin iyileştirilmesini içeren sağlam, uçtan uca bir süreç kurulmasını öneririm.
Veri anonimleştirme, Büyük Dil Modelleri (LLM’ler) bağlamında, örneğin ChatGPT’de de sıcak bir konudur. Bu modellerin kullanımında hassas bilgilerin sızmaması veya ifşa olmamasını sağlamak için kritik öneme sahiptir.
LLM’ler, e-postalar, sohbet kayıtları ve belgeler gibi herkese açık metinlerden elde edilen devasa, yapılandırılmamış veri kümeleri üzerinde eğitildiğinden, hassas kişisel bilgilerin farkında olmadan eğitim verisine dahil edilmesi riski vardır; bu da gizlilik endişelerini artırır.
Yapılandırılmamış verilerle çalışırken, eğitime başlamadan önce hassas kişisel bilgileri tespit etmek ve tamamen kaldırmak daha zordur. Bu nedenle, dağıtımdan sonra veri sızıntısı riskini azaltmak için LLM çıktılarının izlenmesi ve hassas bilgileri ifşa edebilecek yanıtların filtrelenmesi kritik önemdedir.
Son olarak, modelleri ince ayar sırasında özel gizlilik güvenceleriyle eğitmek ve eğitim için şifreli ortamlar kullanmak gibi yeni seçenekler de ortaya çıkıyor; ancak kullanıcı olarak her zaman dikkatli olabilir ve kişisel bilgilerimizi bu araçla paylaşmaktan kaçınabiliriz.
Veriye dayalı uygulamaların kullanımı arttıkça, bireylerin verilerinin toplanması da artıyor ve kişisel bilgilerin korunması her zamankinden daha kritik hale geliyor.
Kullanıcılar olarak veri ihlallerinin risklerinin farkında olmalı, geliştiriciler olarak ise uygulamalarımızda veri korumasını sağlamak için en güncel anonimleştirme tekniklerinden haberdar kalmalıyız. Bu farkındalık, veriler kamuya açıldığında özellikle önemlidir; zira yeniden tanımlama riski daha yüksektir. Veri gizliliğine öncelik verip anonimleştirme uygulamalarını sürekli iyileştirerek, daha güvenli ve daha sorumlu uygulamalar oluşturabiliriz.
Son olarak, tüm bu teknikleri Python’da uygulamakla ilgileniyorsanız, Python’da Veri Gizliliği ve Anonimleştirme kursu tam size göre!
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



