

Khóa học
Bảo mật dữ liệu và Ẩn danh trong Python
4 giờ
3.9K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleTrong khoa học dữ liệu, ẩn danh dữ liệu đề cập đến quá trình sửa đổi một tập dữ liệu sao cho việc xác định danh tính cá nhân dựa trên dữ liệu hiện có trở nên không thể hoặc rất khó khăn.
Về bản chất, quy trình ẩn danh dữ liệu bao gồm loại bỏ hoặc chuyển đổi thông tin nhận dạng cá nhân (PII) khỏi các tập dữ liệu, như tên và địa chỉ, đồng thời vẫn giữ được tính hữu dụng của dữ liệu cho phân tích.
Nó cũng giảm thiểu rủi ro rò rỉ dữ liệu và tái nhận dạng, cho phép chúng ta chia sẻ và phân tích dữ liệu một cách an toàn mà không ảnh hưởng đến quyền riêng tư của từng cá nhân.
Một trường hợp nổi tiếng về quy trình ẩn danh dữ liệu không nghiêm ngặt xảy ra vào năm 2006, khi Netflix phát hành một tập dữ liệu phim chứa dữ liệu người dùng như một phần của cuộc thi Netflix Prize, nhằm cải thiện hệ thống gợi ý của họ.
Các nhà nghiên cứu từ Đại học Texas đã chứng minh lỗ hổng của dữ liệu đã ẩn danh bằng cách tái nhận dạng cá nhân sử dụng dữ liệu IMDb công khai. Sự cố này đã làm dấy lên những lo ngại đáng kể về hiệu quả của các kỹ thuật ẩn danh dữ liệu và nhấn mạnh nhu cầu về các cách tiếp cận tỉ mỉ hơn.
Loại bỏ PII không phải là cách tiếp cận duy nhất để ẩn danh dữ liệu. Trong một số trường hợp, dữ liệu cũng có thể được khái quát hóa để giảm tính duy nhất của từng cá nhân trong tập dữ liệu. Ví dụ cho điều này là thay thế tuổi chính xác bằng các khoảng tuổi. Ngoài ra, dữ liệu cũng có thể được gây nhiễu bằng cách đưa vào các sai lệch nhỏ, khiến việc liên kết dữ liệu mới với một cá nhân trở nên khó hơn.
Biết các kỹ thuật ẩn danh dữ liệu khác nhau có thể giúp chúng ta chọn được kỹ thuật phù hợp nhất cho trường hợp sử dụng của mình. Trong phần này, chúng ta sẽ khám phá những kỹ thuật phổ biến nhất.
Như đã đề cập ở trên, ẩn danh dữ liệu không chỉ là loại bỏ PII. Thay vì loại bỏ dữ liệu, khái quát hóa chuyển đổi dữ liệu thành dạng rộng hơn, ít nhận dạng hơn. Nói cách khác, khái quát hóa làm giảm độ chi tiết của dữ liệu để ngăn việc nhận dạng. Điều này cho phép dữ liệu vẫn hữu ích cho phân tích đồng thời giảm rủi ro tái nhận dạng.
Ví dụ, khi xử lý dữ liệu cá nhân như ngày sinh, thay vì hiển thị ngày sinh chính xác, dữ liệu được khái quát hóa thành tháng và năm, hoặc chỉ năm, để ngăn nhận dạng trong khi vẫn giữ nhóm tuổi có ý nghĩa cho phân tích. Các bảng sau đây cho thấy một số ví dụ đơn giản về ẩn danh dữ liệu bằng khái quát hóa theo tuổi và vị trí:
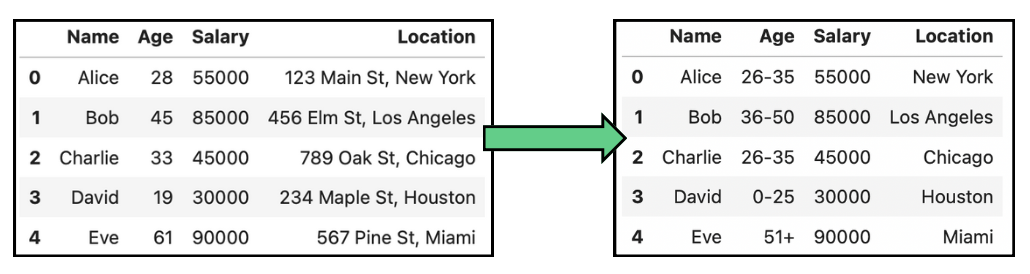
Ví dụ ẩn danh dữ liệu bằng khái quát hóa trong dữ liệu tuổi và vị trí.
Kỹ thuật này chủ yếu được dùng trong các nghiên cứu nhân khẩu học và nghiên cứu thị trường, nhưng có thể dẫn đến mất tính hữu dụng của dữ liệu, khiến phân tích chi tiết trở nên khó khăn.
Khái quát hóa thường được sử dụng cùng với các kỹ thuật khác như K-Anonymity, trong đó nhiều bản ghi được khái quát hóa cho đến khi chúng không thể phân biệt được với ít nhất k bản ghi khác, giảm rủi ro tái nhận dạng cá nhân.
Trong các phân tích mà các điểm dữ liệu cá nhân chính xác không cần thiết mà quan trọng là phân phối tổng thể, có thể áp dụng gây nhiễu dữ liệu. Đây là quá trình sửa đổi dữ liệu gốc một cách có kiểm soát để bảo vệ quyền riêng tư. Việc sửa đổi này có thể bao gồm các kỹ thuật như ngẫu nhiên hóa, co giãn tỉ lệ, hoặc hoán đổi giá trị. Gây nhiễu dữ liệu nhằm che mờ dữ liệu trong khi vẫn giữ được tính hữu dụng cho phân tích.
Một trường hợp cụ thể của gây nhiễu dữ liệu là thêm nhiễu. Thêm nhiễu bao gồm đưa vào các thay đổi ngẫu nhiên hoặc có hệ thống, gọi là “nhiễu”, vào dữ liệu. Nhiễu này che mờ giá trị thực của các điểm dữ liệu nhạy cảm, khiến việc tái nhận dạng cá nhân trở nên khó khăn hơn. Trong hình sau, chúng tôi đã sửa đổi mức lương gốc hiển thị ở các bảng trên bằng cách thêm nhiễu Gaussian:
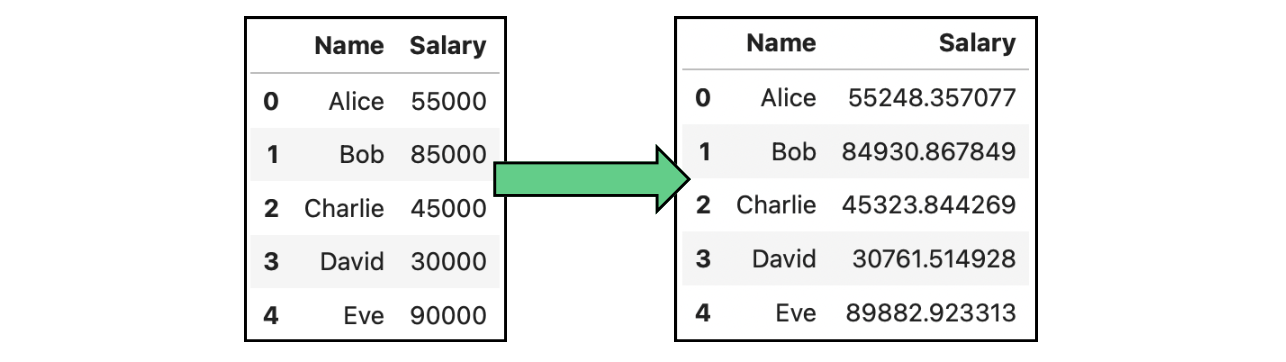
Ví dụ ẩn danh dữ liệu bằng thêm nhiễu trên dữ liệu mức lương.
Thay vì thêm nhiễu vào dữ liệu thật, một cách tiếp cận khác để ẩn danh dữ liệu là tạo dữ liệu giả, dưới những điều kiện nhất định. Tạo dữ liệu tổng hợp là quá trình tạo các tập dữ liệu nhân tạo tái hiện các đặc tính thống kê của dữ liệu gốc mà không bao gồm thông tin nhận dạng thực. Đây là giải pháp thay thế để phân tích một tập dữ liệu tuân thủ quyền riêng tư, mô phỏng các mẫu và cấu trúc của dữ liệu ban đầu.
Quá trình tạo dữ liệu với cùng phân phối đòi hỏi mô hình hóa thống kê để xác định các mẫu, mối quan hệ và phân phối cần tái tạo. Nhìn chung, tạo dữ liệu tổng hợp khó triển khai hơn.
Tôi khuyến nghị tham khảo các tài nguyên sau để tìm hiểu thêm:
Bút danh hóa là việc thay thế các định danh trong tập dữ liệu bằng bút danh hoặc định danh giả để ngăn việc nhận dạng trực tiếp cá nhân. Không giống ẩn danh hoàn toàn, dữ liệu đã bút danh hóa có thể được tái nhận dạng bằng một khóa liên kết bút danh với danh tính thật.
Kỹ thuật này thường được dùng trong nghiên cứu y khoa, phân tích dữ liệu và xử lý dữ liệu khách hàng, cho phép phân tích mà không tiết lộ danh tính cá nhân, nhưng vẫn có tùy chọn truy vết trong môi trường an toàn.
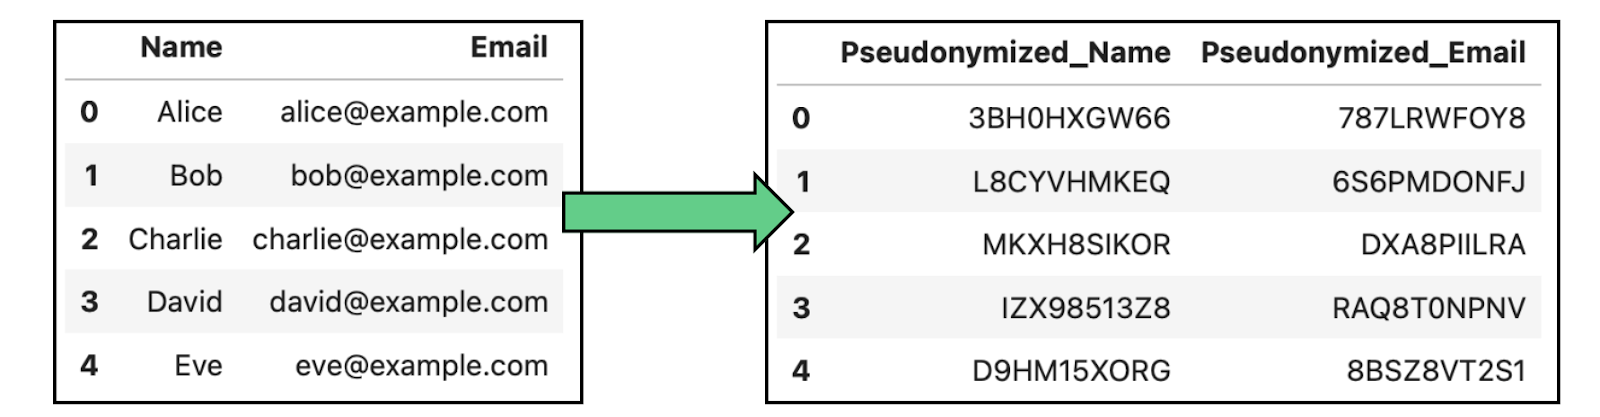
Ví dụ ẩn danh dữ liệu bằng bút danh hóa trên dữ liệu chứa tên và email.
Một kỹ thuật thường dùng khác là che giấu dữ liệu, liên quan đến việc thay đổi hoặc làm mờ dữ liệu gốc trong khi vẫn giữ nguyên định dạng và cấu trúc. Trên thực tế, có hai cách tiếp cận khác nhau cho che giấu dữ liệu:
Hình sau cho thấy một số biến đổi thường gặp trong che giấu dữ liệu:
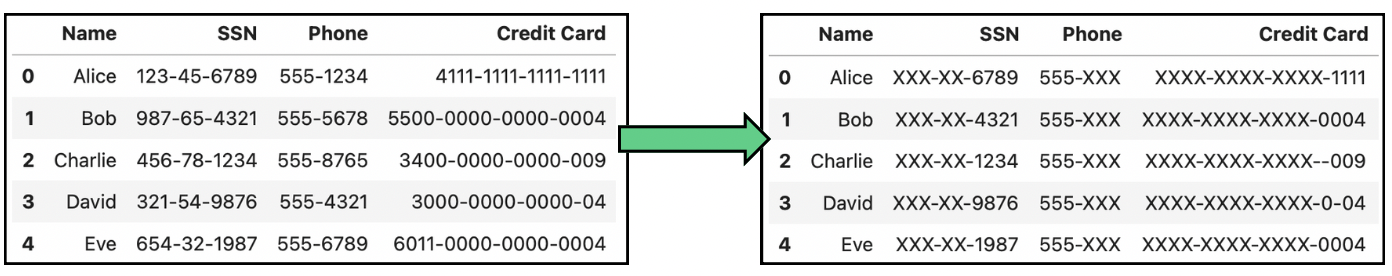
Ví dụ ẩn danh dữ liệu bằng che giấu dữ liệu trên dữ liệu chứa Số An sinh Xã hội (SSN), điện thoại và số thẻ tín dụng.
Do tầm quan trọng của ẩn danh dữ liệu, nhiều công cụ đã được phát triển để giúp quá trình này thuận tiện hơn cho nhà phát triển, cũng như cung cấp sẵn các công cụ kiểm định. Trong phần này, chúng ta sẽ khám phá ba công cụ, mỗi công cụ phù hợp hơn tùy vào trường hợp sử dụng.
ARX là công cụ ẩn danh dữ liệu mã nguồn mở hỗ trợ nhiều kỹ thuật bảo toàn quyền riêng tư. Nó lý tưởng cho nghiên cứu, chăm sóc sức khỏe và bất kỳ tổ chức nào xử lý các tập dữ liệu lớn cần ẩn danh nghiêm ngặt.
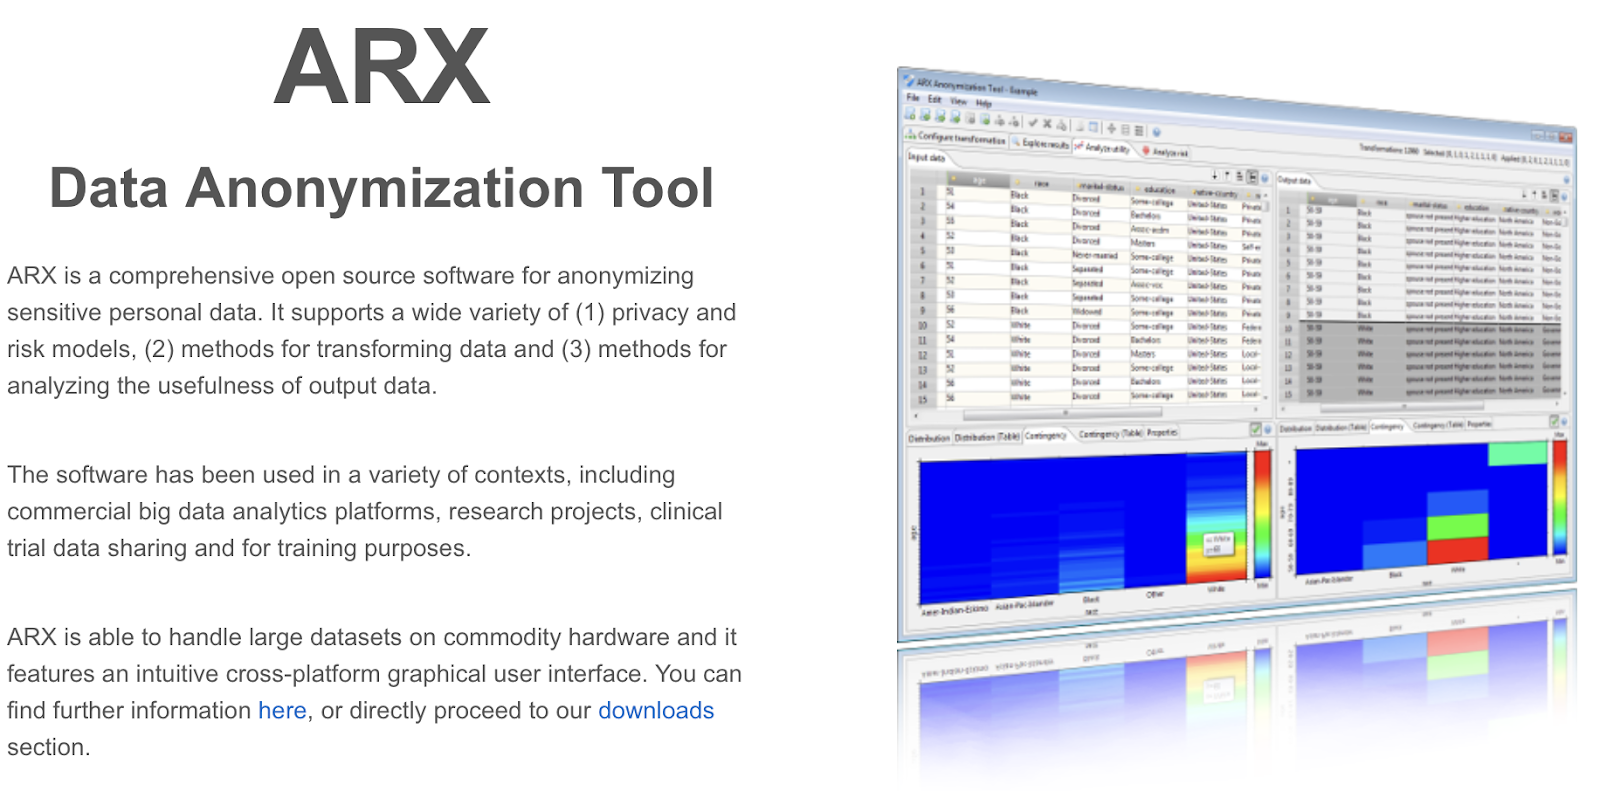
Ảnh chụp màn hình trang chính của ARX.
Nếu bạn là nhà nghiên cứu muốn công bố dữ liệu của mình, ARX có thể là lựa chọn tốt nhất.
Guardium của IBM là giải pháp được thiết kế để bảo vệ dữ liệu nhạy cảm trên môi trường đa đám mây lai. Nó cung cấp mã hóa dữ liệu đầu-cuối, bút danh hóa và kiểm soát truy cập chi tiết để đảm bảo quyền riêng tư dữ liệu trong suốt vòng đời. Có các sản phẩm độc lập khác nhau cho cả giám sát và bảo vệ:
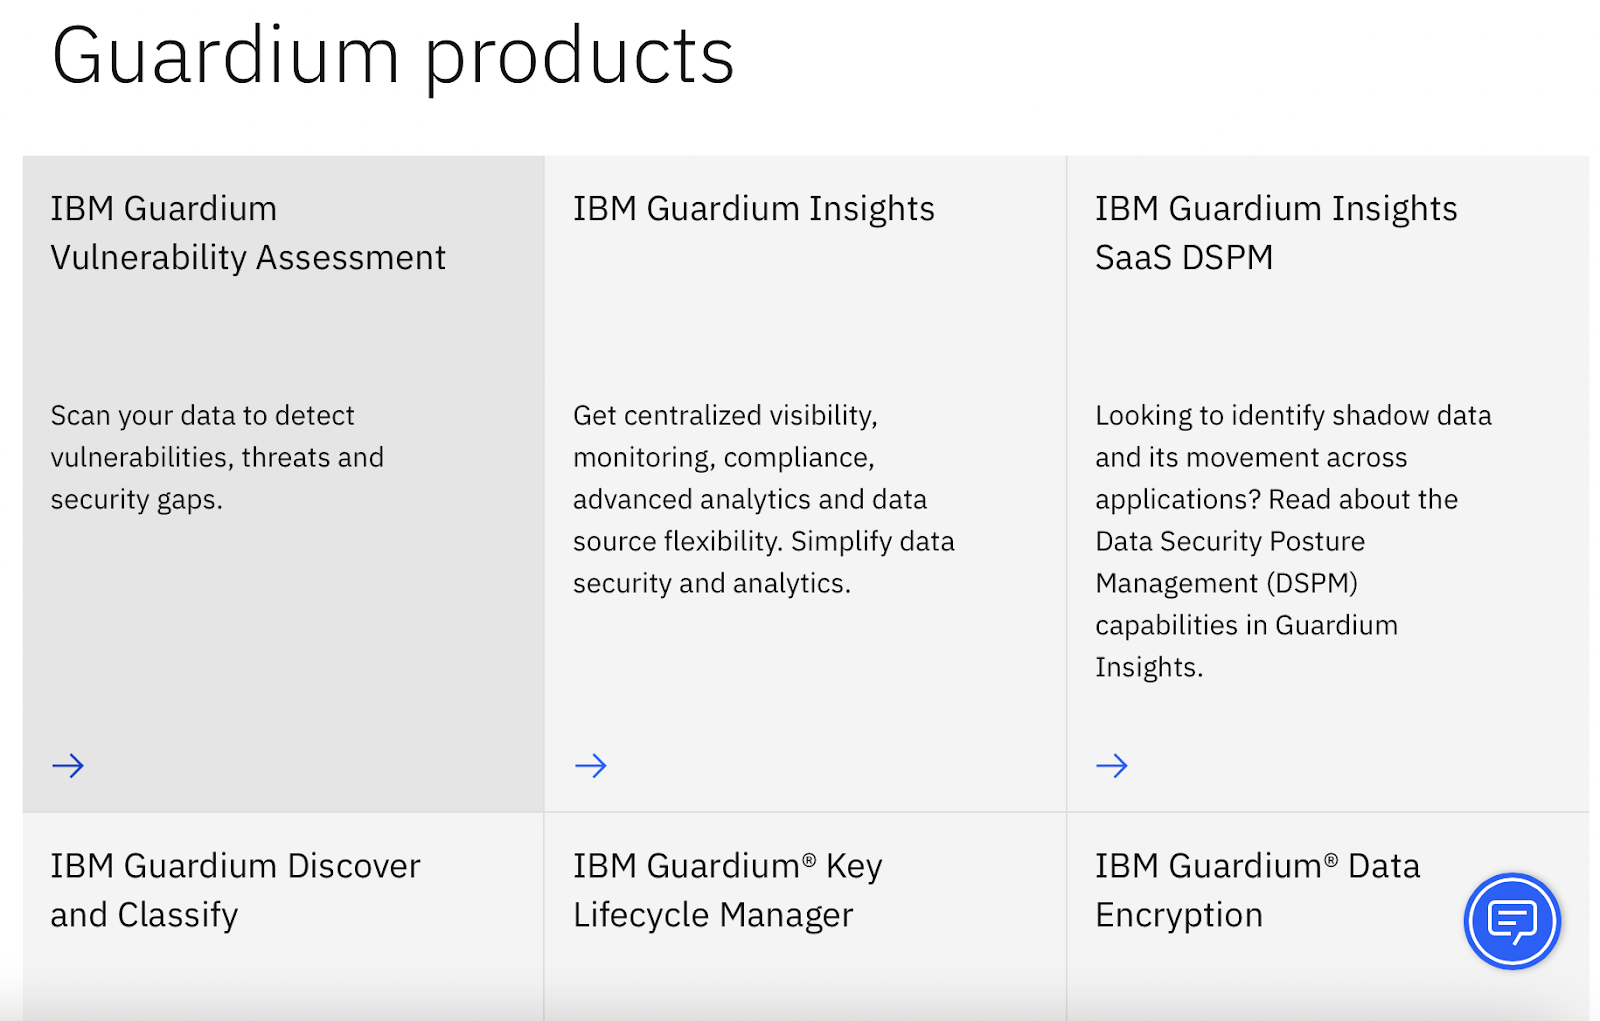
Ảnh chụp màn hình trang chính IBM Guard.
Công cụ này phù hợp với các doanh nghiệp có môi trường dữ liệu phức tạp, đặc biệt là những doanh nghiệp sử dụng hạ tầng đa đám mây, nơi bảo vệ dữ liệu, kiểm soát truy cập và tuân thủ quy định là thiết yếu.
Cuối cùng, TensorFlow Privacy mở rộng khung máy học TensorFlow bằng cách bổ sung hỗ trợ cho bảo mật vi sai. Nói cách khác, nó cho phép nhà phát triển xây dựng các mô hình học máy bảo vệ quyền riêng tư dữ liệu cá nhân bằng cách giới hạn lượng thông tin có thể trích xuất về bất kỳ điểm dữ liệu đơn lẻ nào.
Ảnh chụp màn hình trang chính TensorFlow Privacy.
TensorFlow Privacy rất phù hợp cho các công ty hoặc cá nhân tự phát triển mô hình.
Bên dưới, chúng tôi đã tạo bảng so sánh các công cụ ẩn danh dữ liệu khác nhau và cách chúng so sánh với nhau:
|
Công cụ |
Mô tả |
Tính năng chính |
Trường hợp sử dụng lý tưởng |
Hạn chế |
|
ARX |
Công cụ ẩn danh mã nguồn mở với nhiều kỹ thuật bảo toàn quyền riêng tư. |
- Hỗ trợ K-Anonymity, L-Diversity, T-Closeness - Phân tích rủi ro - Kiểm thử tái nhận dạng |
Nghiên cứu, Y tế và Chia sẻ dữ liệu công khai |
Cấu hình phức tạp đối với người mới bắt đầu |
|
IBM Guardium |
Giải pháp bảo mật và ẩn danh dữ liệu toàn diện cho đám mây lai. |
- Mã hóa dữ liệu đầu-cuối - Che giấu dữ liệu - Kiểm soát truy cập - Giám sát và cảnh báo |
Doanh nghiệp với môi trường phức tạp, lai và đa đám mây |
Chi phí cao; phù hợp nhất cho doanh nghiệp lớn |
|
Google TensorFlow Privacy |
Khung huấn luyện mô hình máy học với bảo mật vi sai. |
- Hỗ trợ bảo mật vi sai - Tích hợp liền mạch với TensorFlow - Tinh chỉnh mô hình cho quyền riêng tư |
Ứng dụng học máy với dữ liệu nhạy cảm |
Giới hạn trong hệ sinh thái TensorFlow |
Biết các kỹ thuật và công cụ ẩn danh dữ liệu là quan trọng, nhưng chọn kỹ thuật phù hợp cho trường hợp sử dụng của mình còn thách thức hơn. Hãy khám phá quy trình triển khai ẩn danh dữ liệu theo từng bước trong thực tế:
Bước đầu tiên là hiểu loại dữ liệu mà chúng ta đang làm việc và những thành phần nào cần được bảo vệ. Điều này bao gồm xác định PII, như tên, địa chỉ, số An sinh Xã hội hoặc dữ liệu y tế.
Tiếp theo, chúng ta nên xác định cách dữ liệu sẽ được sử dụng sau khi ẩn danh. Dùng cho nghiên cứu nội bộ, chia sẻ công khai hay huấn luyện mô hình học máy? Bước này quan trọng vì một số dữ liệu có thể cần kỹ thuật ẩn danh mạnh hơn dựa trên yêu cầu pháp lý.
Các loại dữ liệu và ứng dụng khác nhau đòi hỏi kỹ thuật ẩn danh phù hợp. Việc ghép đúng kỹ thuật với bản chất dữ liệu, yêu cầu quyền riêng tư và mục đích sử dụng dựa trên các kỹ thuật đã thảo luận là rất quan trọng.
Sau khi áp dụng các kỹ thuật ẩn danh phù hợp, điều quan trọng là phải xác minh hiệu quả của chúng để đảm bảo dữ liệu thực sự được bảo vệ. Cá nhân tôi khuyên dùng các công cụ đánh giá rủi ro như đã nêu ở trên để kiểm tra mức độ dễ bị tái nhận dạng của dữ liệu đã ẩn danh bằng cách so sánh với nguồn dữ liệu bên ngoài. Cuối cùng, nếu bạn thực hiện quy trình ẩn danh dữ liệu trong khuôn khổ công ty, hãy cân nhắc kiểm toán thường xuyên dữ liệu đã ẩn danh, đặc biệt nếu dữ liệu thường xuyên được chia sẻ hoặc cập nhật.
Điều này giúp duy trì tuân thủ các quy định về quyền riêng tư và đảm bảo việc ẩn danh vẫn hiệu quả theo thời gian. Để biết thêm về các quy định quyền riêng tư, hãy xem bài viết EU AI Act là gì? Hướng dẫn tóm tắt cho lãnh đạo.
Như bạn có thể nhận thấy, che giấu dữ liệu hơi khác so với các kỹ thuật ẩn danh dữ liệu khác đã trình bày. Trong khi ẩn danh dữ liệu làm cho dữ liệu hoàn toàn không thể nhận dạng bằng cách loại bỏ hoặc thay đổi các định danh cá nhân, che giấu dữ liệu làm mờ dữ liệu nhạy cảm bằng cách thay thế bằng ký tự che hoặc giá trị hư cấu trong khi vẫn giữ định dạng dữ liệu gốc, tức là dữ liệu không bị thay đổi, chỉ bị che mờ.
Ẩn danh tổng quát là vĩnh viễn và không thể đảo ngược, trong khi che giấu thường có thể đảo ngược. Che giấu duy trì cấu trúc dữ liệu và khả năng sử dụng cho các ứng dụng nội bộ cụ thể, trong khi ẩn danh có thể hy sinh một phần tính hữu dụng của dữ liệu để đổi lấy bảo vệ quyền riêng tư mạnh hơn.
Tóm lại, nếu mục tiêu chính của bạn là bảo vệ quyền riêng tư vĩnh viễn, đặc biệt với dữ liệu có thể được chia sẻ ra bên ngoài hoặc phân tích để rút ra thông tin, ẩn danh dữ liệu là cách tiếp cận tốt nhất. Tuy nhiên, nếu bạn cần bảo vệ dữ liệu trong môi trường phi sản xuất, phần lớn thời gian che giấu dữ liệu là đủ.
Thách thức chính trong ẩn danh dữ liệu là đánh đổi giữa mức độ ẩn danh và tính hữu dụng của dữ liệu. Ẩn danh quá mức có thể làm suy giảm chất lượng dữ liệu, khiến dữ liệu kém giá trị cho phân tích hoặc học máy, trong khi ẩn danh chưa đủ có thể để lại lỗ hổng quyền riêng tư. Đạt được cân bằng đúng đắn giữa ẩn danh và giữ lại tính hữu dụng là một thách thức đáng kể.
Ngoài ra, ẩn danh dữ liệu để đáp ứng các luật về quyền riêng tư khác nhau là phức tạp, đặc biệt vì các khu vực và ngành nghề có yêu cầu khác nhau, và các luật này thay đổi theo thời gian. Để đảm bảo bảo vệ tốt hơn, tôi khuyên thiết lập một quy trình đầu-cuối vững chắc bao gồm giám sát liên tục dữ liệu và tinh chỉnh các kỹ thuật ẩn danh dữ liệu.
Ẩn danh dữ liệu cũng là chủ đề nóng trong bối cảnh Mô hình Ngôn ngữ Lớn (LLM) như ChatGPT. Điều này rất quan trọng để đảm bảo thông tin nhạy cảm không bị rò rỉ hoặc lộ khi sử dụng các mô hình này.
Vì LLM được huấn luyện trên các tập dữ liệu phi cấu trúc khổng lồ, lấy từ văn bản công khai như email, nhật ký chat và tài liệu, có nguy cơ thông tin cá nhân nhạy cảm vô tình bị đưa vào dữ liệu huấn luyện, làm dấy lên lo ngại về quyền riêng tư.
Khi xử lý dữ liệu phi cấu trúc, việc xác định và đảm bảo loại bỏ hoàn toàn thông tin cá nhân nhạy cảm trước khi huấn luyện khó hơn. Đó là lý do giám sát đầu ra của LLM và lọc bỏ mọi phản hồi có thể làm lộ thông tin nhạy cảm là rất quan trọng để giảm thiểu rủi ro rò rỉ dữ liệu sau khi triển khai.
Cuối cùng, các lựa chọn mới như tinh chỉnh mô hình với những biện pháp bảo vệ quyền riêng tư cụ thể và sử dụng môi trường mã hóa để huấn luyện cũng đang xuất hiện, nhưng với tư cách người dùng, chúng ta luôn có thể cẩn trọng và không chia sẻ thông tin cá nhân của mình với công cụ.
Khi việc sử dụng các ứng dụng dựa trên dữ liệu tăng lên, việc thu thập dữ liệu của từng cá nhân cũng tăng, khiến việc bảo vệ thông tin cá nhân trở nên quan trọng hơn bao giờ hết.
Với tư cách người dùng, chúng ta nên nhận thức được rủi ro rò rỉ dữ liệu, và với tư cách nhà phát triển, chúng ta nên cập nhật các kỹ thuật ẩn danh mới nhất để đảm bảo bảo vệ dữ liệu trong ứng dụng của mình. Nhận thức này đặc biệt quan trọng khi dữ liệu được công bố công khai, vì rủi ro tái nhận dạng cao hơn. Bằng cách ưu tiên quyền riêng tư dữ liệu và liên tục cải tiến thực hành ẩn danh, chúng ta có thể tạo ra các ứng dụng an toàn và có trách nhiệm hơn.
Cuối cùng, nếu bạn quan tâm đến việc áp dụng tất cả các kỹ thuật này trong Python, khóa học Data Privacy and Anonymization in Python là dành cho bạn!
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
