像 ChatGPT 等生成式 AI 工具被大规模采用,引发了关于 AI 的益处与挑战以及其将如何重塑社会的广泛讨论。要更好地评估这些问题,了解下一代 AI 工具背后的所谓大型语言模型(LLM)如何工作至关重要。
本文将介绍来自人类反馈的强化学习(RLHF),这是一种将强化学习技术与人类引导相结合的创新方法,帮助像 ChatGPT 这样的 LLM 取得令人瞩目的效果。我们将讨论 RLHF 是什么、其优势与局限,以及它在快速发展的生成式 AI 领域未来演进中的重要性。继续阅读!
理解 RLHF
要理解 RLHF 的作用,我们首先需要谈谈 LLM 的训练过程。
最流行的 LLM 所采用的底层技术是 Transformer。自从谷歌研究人员提出以来,Transformer 已成为 AI 和深度学习领域的前沿模型,因为它为处理序列数据(如一句话中的词语)提供了一种更有效的方法。
若想获得关于 LLM 和 Transformer 更详尽的介绍,请查看我们的大型语言模型(LLM)概念课程。
Transformer 使用自监督学习在从互联网上收集的大规模语料库上进行预训练,这是一种无需人工标注数据的创新训练方式。预训练的 Transformer 能够解决广泛的自然语言处理(NLP)问题。
然而,要让像 ChatGPT 这样的 AI 工具提供引人入胜、准确且更像人类的回答,仅使用预训练的 LLM 还不够。归根结底,人类交流具有创造性和主观性。是什么让一段文字“好”,往往深受人类价值观与偏好的影响,这使得用明确的算法化手段来度量或捕捉变得非常困难。
ELF 背后的想法是利用人类反馈来衡量并改进模型的表现。与其他强化学习技术相比,RLHF 的独特之处在于通过人类参与来优化模型,而不是使用统计预设的函数来最大化智能体的回报。
这一策略带来了更具适应性和个性化的学习体验,使 LLM 适用于各类行业场景,例如代码辅助、法律检索、论文写作和诗歌生成。
RLHF 如何工作?
RLHF 是一项具有挑战性的流程,涉及多模型训练和不同的部署阶段。其本质可分为三个步骤。
1. 选择一个预训练模型
第一步是选择一个预训练的 LLM,随后将通过 RLHF 进行微调。
您也可以从零开始预训练自己的 LLM,但这既昂贵又耗时。因此,我们强烈建议选择众多面向公众的预训练 LLM 之一。
如果您想进一步了解如何训练 LLM,我们的使用 PyTorch 训练 LLM教程提供了一个示例。
请注意,为满足模型的特定需求,在开始基于人类反馈的微调阶段之前,您也可以先在额外的文本或条件上对模型进行微调。
例如,如果您想开发一款法律类 AI 助手,可以使用法律文本语料对模型进行微调,使 LLM 对法律措辞与概念更加熟悉。
2. 人类反馈
与其使用统计上预设的回报模型(在校准人类偏好方面会非常局限),RLHF 通过人类反馈帮助模型构建更细腻的回报模型。流程如下:
- 首先,由预训练模型抽样一组提示,生成训练集的“输入提示/生成文本”配对。
- 接着,人类测试者依据特定指南为生成文本打分或排序,使模型与人类价值观和偏好保持一致,并确保安全。这些排序可通过多种技术转换为分数输出,例如 Elo 评分体系。
- 最后,系统利用累积的人类反馈评估自身表现并构建回报模型。
下图展示了整个流程:
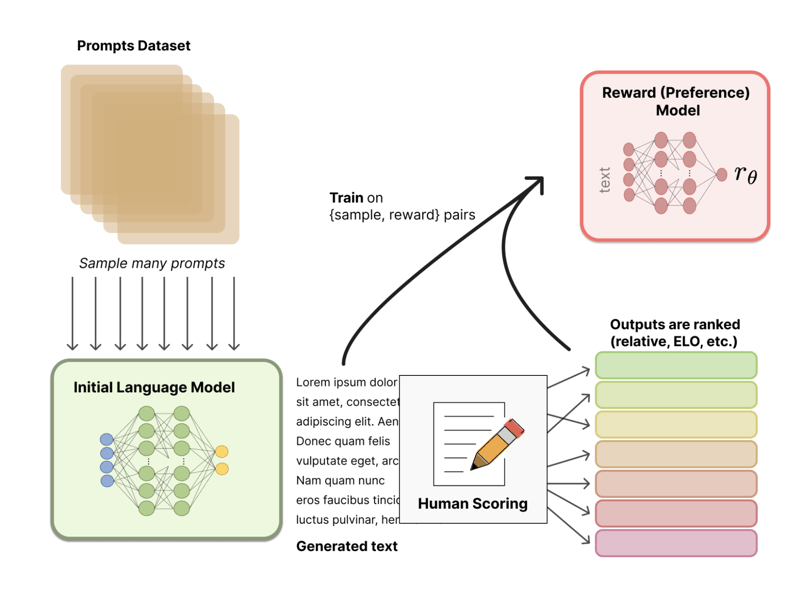
来源:Hugging Face
3. 使用强化学习进行微调
在最后阶段,LLM 生成新文本,并使用基于人类反馈的回报模型产生质量评分。模型随后利用该评分改进其在后续提示上的表现。
因此,人类反馈与强化学习微调被结合为一个迭代过程,直至达到一定的准确度为止。
来自人类反馈的强化学习的应用
RLHF 是对 ChatGPT 等 LLM 进行微调的前沿技术。不过,RLHF 也是一个热门话题,相关文献不断探索 NLP 之外的更多可能性。以下是 RLHF 已成功应用的其他一些领域:
- 聊天机器人。ChatGPT 是 RLHF 潜力的最典型示例。想了解 ChatGPT 如何使用 RLHF,请查看这篇文章“什么是 ChatGPT?”,我们直接向 ChatGPT 询问了其工作原理。
- 机器人。机器人是 RLHF 正在取得可喜成果的主要领域之一。利用人类反馈可以帮助机器人完成那些难以用回报函数精确描述的任务与动作。OpenAI 的研究人员曾使用 RLHF 教会机器人后空翻——这是一个很难建模的任务。
- 游戏。强化学习技术已被用于开发电子游戏机器人。而 RLHF 则可基于人类偏好训练机器人,使其更像人类玩家,而非单纯的回报最大化机器。例如,OpenAI 和 DeepMind 使用 RLHF 训练机器人玩Atari 游戏。
RLHF 的优势
没有 RLHF,这些下一代 AI 工具将难以实现。它是一种强大而有前景的技术。以下是 RLHF 的一些优势:
- 性能增强。人类反馈是让 ChatGPT 等 LLM “思考”并听起来像人的关键。HLHF 使机器能够处理涉及人类价值或偏好的复杂任务,例如 NLP 问题。
- 适应性强。由于 LLM 在各种提示上通过人类反馈进行微调,RLHF 使机器能够执行多种任务并适应预期情境。这使 LLM 更接近通用型 AI 的门槛。
- 持续改进。RLHF 是一个迭代过程,这意味着随着新的人工反馈到来、学习函数更新,系统将不断得到提升。
- 更高的安全性。通过接收人类反馈,系统不仅学会如何去做,还学会哪些不该做,从而构建更有效、更安全、更值得信赖的系统。
RLHF 的局限
然而,RLHF 并非万无一失。该技术也存在一定风险与局限。以下是一些最相关的问题:
- 人类反馈有限且成本高。RLHF 依赖于人类反馈的质量与可获得性。但完成这项工作可能很慢、劳动密集且成本高,尤其在需要大量反馈时。
- 人类反馈存在偏见。尽管提供了标准化指南用于反馈,但打分或排序最终仍会受到人类偏好与价值观的影响。如果排序任务设定不当,或人类反馈质量不佳,模型可能会产生偏见,或强化不良输出。
- 向新情境的泛化。即便 LLM 经历了大量人类反馈的微调,仍可能遇到意料之外的情境。这时的挑战在于让智能体在反馈有限的情况下依然具备稳健性。
- 幻觉。当人类反馈有限或质量较差时,智能体可能出现所谓的“幻觉”,即产生不理想、错误或无意义的行为。
RLHF 的未来趋势与发展
RLHF 是现代生成式 AI 工具(如 ChatGPT 和 GPT-4)的支柱之一。尽管效果卓著,RLHF 仍是一项相对较新的技术,仍有很大的改进空间。围绕 RLHF 的未来研究对于提升 LLM 的效率、降低其环境足迹,以及应对 LLM 的部分风险与局限至关重要。
要持续跟进生成式 AI、机器学习与 LLM 的最新进展,我们强烈建议您查看我们精选的学习材料:


像 ChatGPT 等生成式 AI 工具被大规模采用,引发了关于 AI 的益处与挑战以及其将如何重塑社会的广泛讨论。要更好地评估这些问题,了解下一代 AI 工具背后的所谓大型语言模型(LLM)如何工作至关重要。
本文将介绍来自人类反馈的强化学习(RLHF),这是一种将强化学习技术与人类引导相结合的创新方法,帮助像 ChatGPT 这样的 LLM 取得令人瞩目的效果。我们将讨论 RLHF 是什么、其优势与局限,以及它在快速发展的生成式 AI 领域未来演进中的重要性。继续阅读!
理解 RLHF
要理解 RLHF 的作用,我们首先需要谈谈 LLM 的训练过程。
最流行的 LLM 所采用的底层技术是 Transformer。自从谷歌研究人员提出以来,Transformer 已成为 AI 和深度学习领域的前沿模型,因为它为处理序列数据(如一句话中的词语)提供了一种更有效的方法。
若想获得关于 LLM 和 Transformer 更详尽的介绍,请查看我们的大型语言模型(LLM)概念课程。
Transformer 使用自监督学习在从互联网上收集的大规模语料库上进行预训练,这是一种无需人工标注数据的创新训练方式。预训练的 Transformer 能够解决广泛的自然语言处理(NLP)问题。
然而,要让像 ChatGPT 这样的 AI 工具提供引人入胜、准确且更像人类的回答,仅使用预训练的 LLM 还不够。归根结底,人类交流具有创造性和主观性。是什么让一段文字“好”,往往深受人类价值观与偏好的影响,这使得用明确的算法化手段来度量或捕捉变得非常困难。
ELF 背后的想法是利用人类反馈来衡量并改进模型的表现。与其他强化学习技术相比,RLHF 的独特之处在于通过人类参与来优化模型,而不是使用统计预设的函数来最大化智能体的回报。
这一策略带来了更具适应性和个性化的学习体验,使 LLM 适用于各类行业场景,例如代码辅助、法律检索、论文写作和诗歌生成。
RLHF 如何工作?
RLHF 是一项具有挑战性的流程,涉及多模型训练和不同的部署阶段。其本质可分为三个步骤。
1. 选择一个预训练模型
第一步是选择一个预训练的 LLM,随后将通过 RLHF 进行微调。
您也可以从零开始预训练自己的 LLM,但这既昂贵又耗时。因此,我们强烈建议选择众多面向公众的预训练 LLM 之一。
如果您想进一步了解如何训练 LLM,我们的使用 PyTorch 训练 LLM教程提供了一个示例。
请注意,为满足模型的特定需求,在开始基于人类反馈的微调阶段之前,您也可以先在额外的文本或条件上对模型进行微调。
例如,如果您想开发一款法律类 AI 助手,可以使用法律文本语料对模型进行微调,使 LLM 对法律措辞与概念更加熟悉。
2. 人类反馈
与其使用统计上预设的回报模型(在校准人类偏好方面会非常局限),RLHF 通过人类反馈帮助模型构建更细腻的回报模型。流程如下:
下图展示了整个流程:
来源:Hugging Face
3. 使用强化学习进行微调
在最后阶段,LLM 生成新文本,并使用基于人类反馈的回报模型产生质量评分。模型随后利用该评分改进其在后续提示上的表现。
因此,人类反馈与强化学习微调被结合为一个迭代过程,直至达到一定的准确度为止。
来自人类反馈的强化学习的应用
RLHF 是对 ChatGPT 等 LLM 进行微调的前沿技术。不过,RLHF 也是一个热门话题,相关文献不断探索 NLP 之外的更多可能性。以下是 RLHF 已成功应用的其他一些领域:
RLHF 的优势
没有 RLHF,这些下一代 AI 工具将难以实现。它是一种强大而有前景的技术。以下是 RLHF 的一些优势:
RLHF 的局限
然而,RLHF 并非万无一失。该技术也存在一定风险与局限。以下是一些最相关的问题:
RLHF 的未来趋势与发展
RLHF 是现代生成式 AI 工具(如 ChatGPT 和 GPT-4)的支柱之一。尽管效果卓著,RLHF 仍是一项相对较新的技术,仍有很大的改进空间。围绕 RLHF 的未来研究对于提升 LLM 的效率、降低其环境足迹,以及应对 LLM 的部分风险与局限至关重要。
要持续跟进生成式 AI、机器学习与 LLM 的最新进展,我们强烈建议您查看我们精选的学习材料: