
{count, plural, one {Khóa học} other {Khóa học}}
Nhập môn Deep Learning với Python
{hours} giờ
264.7K
Việc các công cụ như ChatGPT và những công cụ AI sinh nội dung khác được áp dụng rộng rãi đã dẫn đến một cuộc tranh luận lớn về lợi ích và thách thức của AI, cũng như cách nó sẽ tái định hình xã hội. Để đánh giá tốt hơn những câu hỏi này, điều quan trọng là hiểu cách các Mô hình Ngôn ngữ Lớn (LLM) đứng sau các công cụ AI thế hệ mới vận hành.
Bài viết này giới thiệu về Reinforcement Learning from Human Feedback (RLHF), một kỹ thuật sáng tạo kết hợp học tăng cường và sự hướng dẫn của con người để giúp các LLM như ChatGPT mang lại kết quả ấn tượng. Chúng tôi sẽ đề cập RLHF là gì, lợi ích, hạn chế, và mức độ liên quan của nó trong tương lai phát triển của lĩnh vực AI sinh nội dung đang thay đổi nhanh chóng. Hãy tiếp tục đọc!
Để hiểu vai trò của RLHF, trước hết chúng ta cần nói về quy trình huấn luyện của LLM.
Công nghệ nền tảng của các LLM phổ biến nhất là transformer. Kể từ khi được các nhà nghiên cứu Google phát triển, transformer đã trở thành mô hình tối tân trong lĩnh vực AI và học sâu, vì chúng cung cấp phương pháp hiệu quả hơn để xử lý dữ liệu tuần tự, như các từ trong một câu.
Để có phần giới thiệu chi tiết hơn về LLM và transformer, hãy xem khóa học Khái niệm về Mô hình Ngôn ngữ Lớn (LLM) của chúng tôi.
Transformer được tiền huấn luyện bằng một kho văn bản khổng lồ thu thập từ Internet thông qua học tự giám sát, một kiểu huấn luyện đổi mới không cần con người gán nhãn dữ liệu. Các transformer đã tiền huấn luyện có khả năng giải quyết nhiều bài toán xử lý ngôn ngữ tự nhiên (NLP).
Tuy nhiên, để một công cụ AI như ChatGPT đưa ra câu trả lời hấp dẫn, chính xác và giống con người, chỉ dùng một LLM đã tiền huấn luyện là chưa đủ. Suy cho cùng, giao tiếp của con người là một quá trình sáng tạo và chủ quan. Điều làm cho một văn bản “hay” chịu ảnh hưởng sâu sắc bởi giá trị và sở thích của con người, rất khó đo lường hay nắm bắt bằng một lời giải thuật toán rõ ràng.
Ý tưởng đằng sau RLHF là sử dụng phản hồi của con người để đo lường và cải thiện hiệu suất của mô hình. Điểm khác biệt của RLHF so với các kỹ thuật học tăng cường khác là việc sử dụng sự tham gia của con người để tối ưu hóa mô hình thay vì một hàm được xác định trước về mặt thống kê nhằm tối đa hóa phần thưởng của tác tử.
Chiến lược này cho phép trải nghiệm học tập linh hoạt và cá nhân hóa hơn, khiến LLM phù hợp với mọi loại ứng dụng theo ngành, như hỗ trợ viết mã, nghiên cứu pháp lý, viết luận và sáng tác thơ.
RLHF là một quy trình đầy thách thức, bao gồm huấn luyện nhiều mô hình và các giai đoạn triển khai khác nhau. Về bản chất, có thể chia thành ba bước.
Giai đoạn đầu tiên là chọn một LLM đã tiền huấn luyện để sau đó tinh chỉnh bằng RLHF.
Bạn cũng có thể tiền huấn luyện LLM từ đầu, nhưng đây là quá trình tốn kém và mất thời gian. Vì vậy, chúng tôi khuyến nghị chọn một trong nhiều LLM đã tiền huấn luyện hiện có cho công chúng.
Nếu bạn muốn tìm hiểu thêm về cách huấn luyện LLM, hướng dẫn Cách huấn luyện một LLM với PyTorch của chúng tôi cung cấp một ví dụ minh họa.
Lưu ý rằng, để đáp ứng nhu cầu cụ thể của mô hình, trước khi bắt đầu giai đoạn tinh chỉnh bằng phản hồi của con người, bạn có thể tinh chỉnh mô hình trên các văn bản hoặc điều kiện bổ sung.
Ví dụ, nếu bạn muốn phát triển một trợ lý pháp lý AI, bạn có thể tinh chỉnh mô hình bằng một kho văn bản pháp lý để LLM đặc biệt quen thuộc với thuật ngữ và khái niệm pháp lý.
Thay vì dùng một mô hình phần thưởng được xác định trước về mặt thống kê (vốn sẽ rất hạn chế khi hiệu chỉnh sở thích của con người), RLHF sử dụng phản hồi của con người để giúp mô hình phát triển một mô hình phần thưởng tinh tế hơn. Quy trình như sau:
Hình dưới minh họa toàn bộ quy trình:
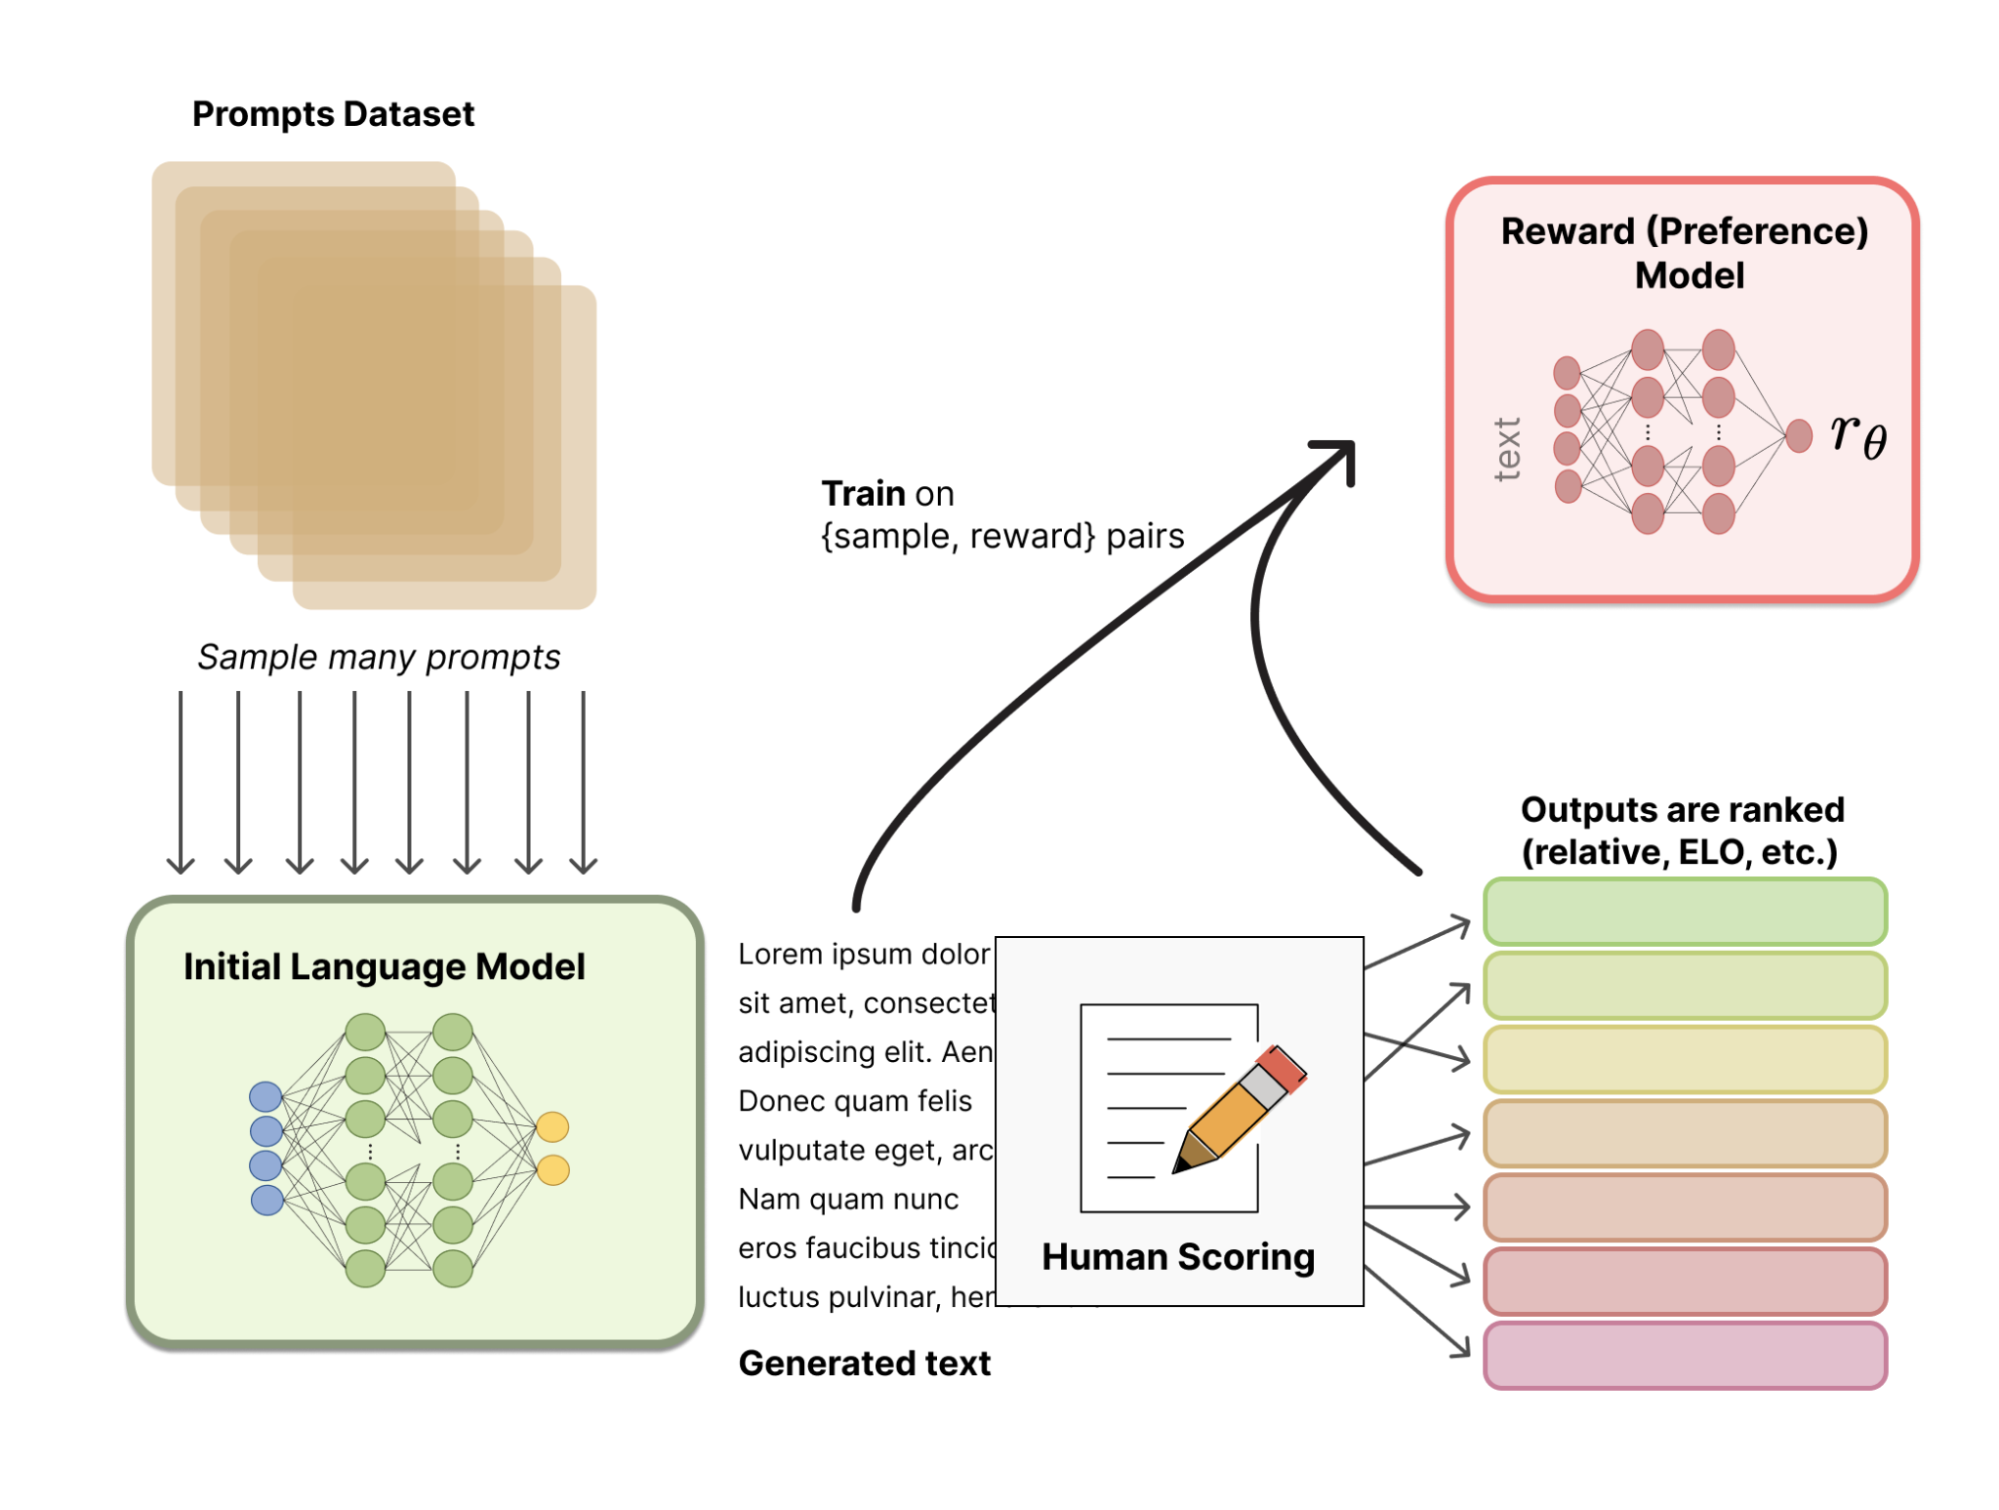
Nguồn: Hugging Face
Ở giai đoạn cuối, LLM tạo ra các văn bản mới và sử dụng mô hình phần thưởng dựa trên phản hồi của con người để tạo điểm chất lượng. Sau đó mô hình dùng điểm này để cải thiện hiệu suất cho các lời nhắc tiếp theo.
Phản hồi của con người và tinh chỉnh bằng các kỹ thuật học tăng cường được kết hợp trong một quy trình lặp, tiếp tục cho đến khi đạt tới mức độ chính xác nhất định.
RLHF là kỹ thuật tối tân để tinh chỉnh LLM, như ChatGPT. Tuy nhiên, RLHF là chủ đề phổ biến, với ngày càng nhiều tài liệu khám phá các khả năng vượt ra ngoài bài toán NLP. Dưới đây là danh sách những lĩnh vực khác mà RLHF đã được áp dụng thành công:
RLHF là một kỹ thuật mạnh mẽ và đầy hứa hẹn, thiếu nó thì các công cụ AI thế hệ mới sẽ không thể thành hiện thực. Dưới đây là một số lợi ích của RLHF:
Tuy nhiên, RLHF không phải là vạn năng. Kỹ thuật này cũng tiềm ẩn một số rủi ro và hạn chế. Dưới đây là một số điểm đáng chú ý:
RLHF là một trong những trụ cột của các công cụ AI sinh nội dung hiện đại, như ChatGPT và GPT-4. Dù mang lại kết quả ấn tượng, RLHF vẫn là kỹ thuật tương đối mới và còn nhiều dư địa để cải thiện. Nghiên cứu tương lai về các kỹ thuật RLHF là rất quan trọng để giúp LLM hiệu quả hơn, giảm dấu chân môi trường và giải quyết một số rủi ro, hạn chế của LLM.
Để cập nhật những phát triển mới nhất về AI sinh nội dung, học máy và LLM, chúng tôi khuyến nghị bạn tham khảo các tài liệu học tập được tuyển chọn sau:
Học các chủ đề được nhắc đến trong bài viết này!
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {blog} other {blog}}
Matt Crabtree
10 phút
