
Last chance! 50% off DataCamp Premium
Sale ends in
La diffusione massiccia di strumenti come ChatGPT e altre IA generative ha acceso un grande dibattito sui benefici e le sfide dell'IA e su come rimodellerà la nostra società. Per valutare meglio queste questioni, è importante conoscere come funzionano i cosiddetti Large Language Models (LLM) che alimentano gli strumenti di IA di nuova generazione.
Questo articolo offre un'introduzione al Reinforcement Learning from Human Feedback (RLHF), una tecnica innovativa che combina metodi di reinforcement learning e guida umana per aiutare LLM come ChatGPT a offrire risultati impressionanti. Vedremo che cos'è l'RLHF, i suoi vantaggi, le sue limitazioni e la sua rilevanza per lo sviluppo futuro del dinamico campo dell'IA generativa. Continua a leggere!
Per comprendere il ruolo dell'RLHF, dobbiamo prima parlare del processo di addestramento degli LLM.
La tecnologia alla base degli LLM più popolari è il transformer. Dalla sua introduzione da parte dei ricercatori di Google, i transformer sono diventati lo stato dell'arte nel campo dell'IA e del deep learning, perché offrono un metodo più efficace per gestire dati sequenziali, come le parole in una frase.
Per un'introduzione più dettagliata agli LLM e ai transformer, dai un'occhiata al nostro corso Concepts sui Large Language Models (LLM).
I transformer vengono pre-addestrati con un enorme corpus di testi raccolti da Internet tramite self-supervised learning, un tipo innovativo di addestramento che non richiede l'intervento umano per etichettare i dati. I transformer pre-addestrati sono in grado di risolvere un'ampia gamma di problemi di natural language processing (NLP).
Tuttavia, perché uno strumento di IA come ChatGPT fornisca risposte coinvolgenti, accurate e simili a quelle umane, un LLM pre-addestrato non basta. In fin dei conti, la comunicazione umana è un processo creativo e soggettivo. Ciò che rende un testo “buono” è profondamente influenzato da valori e preferenze umane, il che lo rende molto difficile da misurare o catturare con una soluzione algoritmica chiara.
L'idea alla base dell'RLHF è usare il feedback umano per misurare e migliorare le prestazioni del modello. Ciò che rende l'RLHF unico rispetto ad altre tecniche di reinforcement learning è l'uso della partecipazione umana per ottimizzare il modello invece di una funzione statisticamente predefinita per massimizzare la ricompensa dell'agente.
Questa strategia consente un apprendimento più adattabile e personalizzato, rendendo gli LLM adatti a ogni tipo di applicazione settoriale, come assistenza al codice, ricerca legale, stesura di saggi e generazione di poesie.
L'RLHF è un processo impegnativo che coinvolge l'addestramento di più modelli e diverse fasi di distribuzione. In sostanza, si può suddividere in tre passaggi.
La prima fase consiste nel selezionare un LLM pre-addestrato che verrà poi ottimizzato tramite RLHF.
Potresti anche pre-addestrare il tuo LLM da zero, ma è un processo costoso e che richiede molto tempo. Per questo consigliamo vivamente di scegliere uno dei tanti LLM pre-addestrati disponibili al pubblico.
Se vuoi saperne di più su come addestrare un LLM, il nostro tutorial How to Train a LLM with PyTorch offre un esempio illustrativo.
Tieni presente che, per soddisfare le esigenze specifiche del tuo modello, prima di iniziare la fase di fine-tuning con feedback umano, puoi effettuare un ulteriore fine-tuning del modello su testi o condizioni aggiuntive.
Ad esempio, se vuoi sviluppare un assistente legale basato su IA, potresti effettuare il fine-tuning del modello con un corpus di testi giuridici per renderlo particolarmente familiare al linguaggio e ai concetti legali.
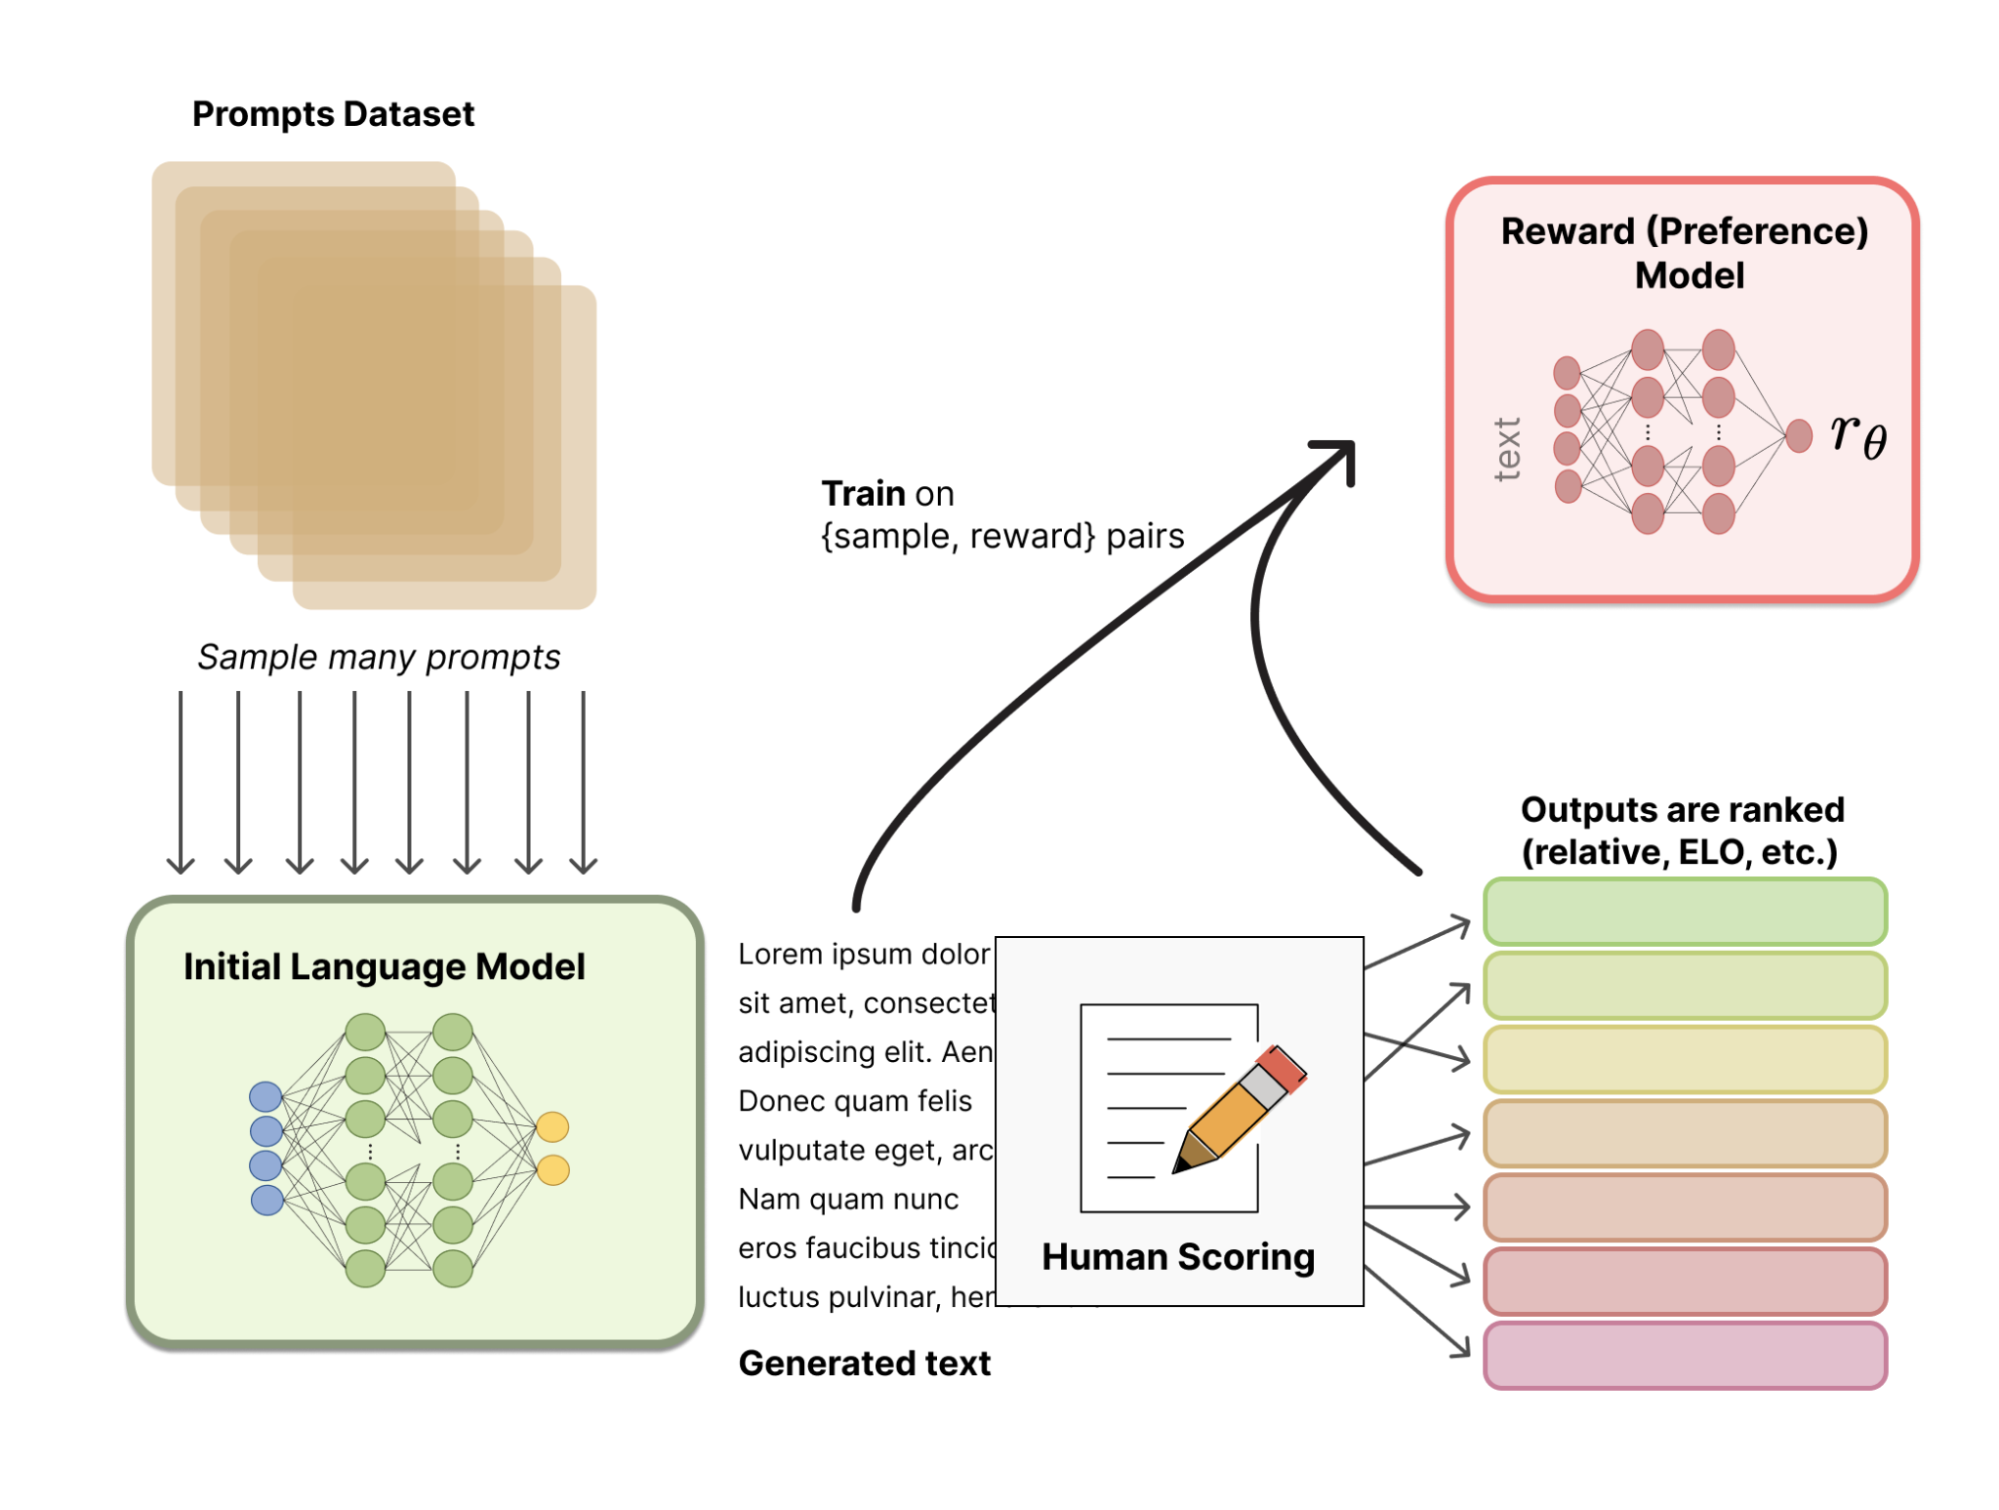
Invece di usare un modello di ricompensa statisticamente predefinito (che sarebbe molto restrittivo per calibrare le preferenze umane), l'RLHF utilizza il feedback umano per aiutare il modello a sviluppare un modello di ricompensa più sottile. Il processo è il seguente:
L'immagine seguente illustra l'intero processo:
Fonte: Hugging Face
Nell'ultima fase, l'LLM produce nuovi testi e utilizza il suo modello di ricompensa basato sul feedback umano per generare un punteggio di qualità. Il punteggio viene quindi usato dal modello per migliorare le prestazioni sui prompt successivi.
Il feedback umano e il fine-tuning con tecniche di reinforcement learning vengono quindi combinati in un processo iterativo che continua fino al raggiungimento di un certo grado di accuratezza.
L'RLHF è una tecnica all'avanguardia per il fine-tuning degli LLM, come ChatGPT. Tuttavia, l'RLHF è un tema molto discusso, con una letteratura in crescita che esplora possibilità oltre i problemi di NLP. Qui sotto trovi un elenco di altre aree in cui l'RLHF è stato applicato con successo:
L'RLHF è una tecnica potente e promettente senza la quale gli strumenti di IA di nuova generazione non sarebbero possibili. Ecco alcuni dei vantaggi dell'RLHF:
Tuttavia, l'RLHF non è infallibile. Questa tecnica presenta anche alcuni rischi e limitazioni. Di seguito puoi vedere alcune delle più rilevanti:
L'RLHF è uno dei pilastri degli strumenti di IA generativa moderni, come ChatGPT e GPT-4. Nonostante i risultati impressionanti, l'RLHF è una tecnica relativamente nuova e c'è ancora ampio margine di miglioramento. La ricerca futura sulle tecniche di RLHF è fondamentale per rendere gli LLM più efficienti, ridurne l'impatto ambientale e affrontare alcuni dei rischi e delle limitazioni degli LLM.
Per rimanere aggiornato sugli ultimi sviluppi in IA generativa, machine learning e LLM, ti consigliamo vivamente di consultare i nostri materiali didattici selezionati:
Impara gli argomenti menzionati in questo articolo!
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min




