
कोर्स
Python में Deep Learning परिचय
4 घंटा
264.7K
ChatGPT और अन्य जनरेटिव AI टूल्स को व्यापक रूप से अपनाए जाने से AI के लाभों और चुनौतियों तथा यह हमारी समाज को कैसे बदल देगा, इस पर बड़ी बहस हुई है। इन सवालों का बेहतर आकलन करने के लिए यह समझना ज़रूरी है कि अगली पीढ़ी के AI टूल्स के पीछे के तथाकथित Large Language Models (LLMs) कैसे काम करते हैं।
यह लेख मानव प्रतिक्रिया से रिइन्फोर्समेंट लर्निंग (RLHF) का परिचय देता है—एक ऐसी नवोन्मेषी तकनीक जो रिइन्फोर्समेंट लर्निंग और मानव मार्गदर्शन को जोड़ती है ताकि ChatGPT जैसे LLMs प्रभावशाली परिणाम दे सकें। हम जानेंगे कि RLHF क्या है, उसके लाभ, सीमाएँ, और तेज़ी से विकसित हो रहे जनरेटिव AI क्षेत्र के भविष्य के विकास में इसकी प्रासंगिकता क्या है। पढ़ते रहें!
RLHF की भूमिका समझने के लिए, हमें पहले LLMs की प्रशिक्षण प्रक्रिया पर बात करनी होगी।
सबसे लोकप्रिय LLMs की अंतर्निहित तकनीक ट्रांसफॉर्मर है। Google के शोधकर्ताओं द्वारा विकसित किए जाने के बाद से, ट्रांसफॉर्मर्स AI और डीप लर्निंग के क्षेत्र में अत्याधुनिक मॉडल बन गए हैं, क्योंकि वे क्रमबद्ध डेटा—जैसे किसी वाक्य के शब्द—को संभालने का अधिक प्रभावी तरीका प्रदान करते हैं।
LLMs और ट्रांसफॉर्मर्स का अधिक विस्तृत परिचय पाने के लिए हमारा Large Language Models (LLMs) Concepts Course देखें।
ट्रांसफॉर्मर्स को इंटरनेट से एकत्रित विशाल पाठ-कोष पर self-supervised learning के जरिए प्री-ट्रेन किया जाता है—यह प्रशिक्षण का एक अभिनव प्रकार है जिसे डेटा लेबल करने के लिए मानव हस्तक्षेप की आवश्यकता नहीं होती। प्रीट्रेंड ट्रांसफॉर्मर्स प्राकृतिक भाषा संसाधन (NLP) की एक विस्तृत शृंखला की समस्याएँ हल करने में सक्षम होते हैं।
हालाँकि, ChatGPT जैसे AI टूल से रोचक, सटीक और मानव-जैसे उत्तर प्राप्त करने के लिए सिर्फ एक प्री-ट्रेन LLM पर्याप्त नहीं होगा। आखिरकार, मानवीय संचार एक रचनात्मक और व्यक्तिपरक प्रक्रिया है। किसी पाठ को “अच्छा” बनाने में मानवीय मूल्यों और प्राथमिकताओं का गहरा प्रभाव होता है, जिसे किसी स्पष्ट, एल्गोरिथमिक समाधान से मापना या कैप्चर करना बहुत कठिन है।
RLHF के पीछे विचार यह है कि मॉडल के प्रदर्शन को मापने और सुधारने के लिए मानव प्रतिक्रिया का उपयोग किया जाए। अन्य रिइन्फोर्समेंट लर्निंग तकनीकों की तुलना में RLHF की विशिष्टता यह है कि यह एजेंट के पुरस्कार को अधिकतम करने के लिए सांख्यिकीय रूप से पूर्व-परिभाषित फ़ंक्शन के बजाय मॉडल को अनुकूलित करने हेतु मानव भागीदारी का उपयोग करता है।
यह रणनीति अधिक अनुकूलनीय और वैयक्तिकृत सीखने का अनुभव देती है, जिससे LLMs को कोड सहायता, विधि संबंधी शोध, निबंध लेखन और कविता रचना जैसी विभिन्न क्षेत्र-विशिष्ट अनुप्रयोगों के लिए उपयुक्त बनाया जा सकता है।
RLHF एक चुनौतीपूर्ण प्रक्रिया है जिसमें बहु-मॉडल प्रशिक्षण और परिनियोजन के अलग-अलग चरण शामिल होते हैं। सार रूप में, इसे तीन चरणों में बाँटा जा सकता है।
पहला चरण एक प्री-ट्रेन LLM का चयन करना है, जिसे बाद में RLHF का उपयोग करके फाइन-ट्यून किया जाएगा।
आप चाहें तो अपने LLM को शूरू से प्री-ट्रेन कर सकते हैं, लेकिन यह महँगा और समय-साध्य है। इसलिए, हम सार्वजनिक रूप से उपलब्ध अनेक प्री-ट्रेन LLMs में से किसी एक को चुनने की सिफारिश करते हैं।
यदि आप जानना चाहते हैं कि LLM को कैसे ट्रेन किया जाए, तो हमारा How to Train a LLM with PyTorch ट्यूटोरियल एक उदाहरण प्रस्तुत करता है।
ध्यान दें कि अपने मॉडल की विशिष्ट आवश्यकताओं को पूरा करने के लिए, मानव प्रतिक्रिया का उपयोग करके फाइन-ट्यूनिंग चरण शुरू करने से पहले, आप अपने मॉडल को अतिरिक्त पाठ या शर्तों पर भी फाइन-ट्यून कर सकते हैं।
उदाहरण के लिए, यदि आप एक AI विधिक सहायक विकसित करना चाहते हैं, तो आप अपने LLM को विधिक पाठ-कोष पर फाइन-ट्यून कर सकते हैं ताकि वह विधिक शब्दावली और अवधारणाओं से विशेष रूप से परिचित हो सके।
सांख्यिकीय रूप से पूर्व-परिभाषित पुरस्कार मॉडल (जो मानवीय प्राथमिकताओं को समायोजित करने में बहुत संकीर्ण हो सकता है) का उपयोग करने के बजाय, RLHF मॉडल को अधिक सूक्ष्म पुरस्कार मॉडल विकसित करने में मदद के लिए मानव प्रतिक्रिया का उपयोग करता है। प्रक्रिया इस प्रकार है:
निम्न छवि संपूर्ण प्रक्रिया को दर्शाती है:
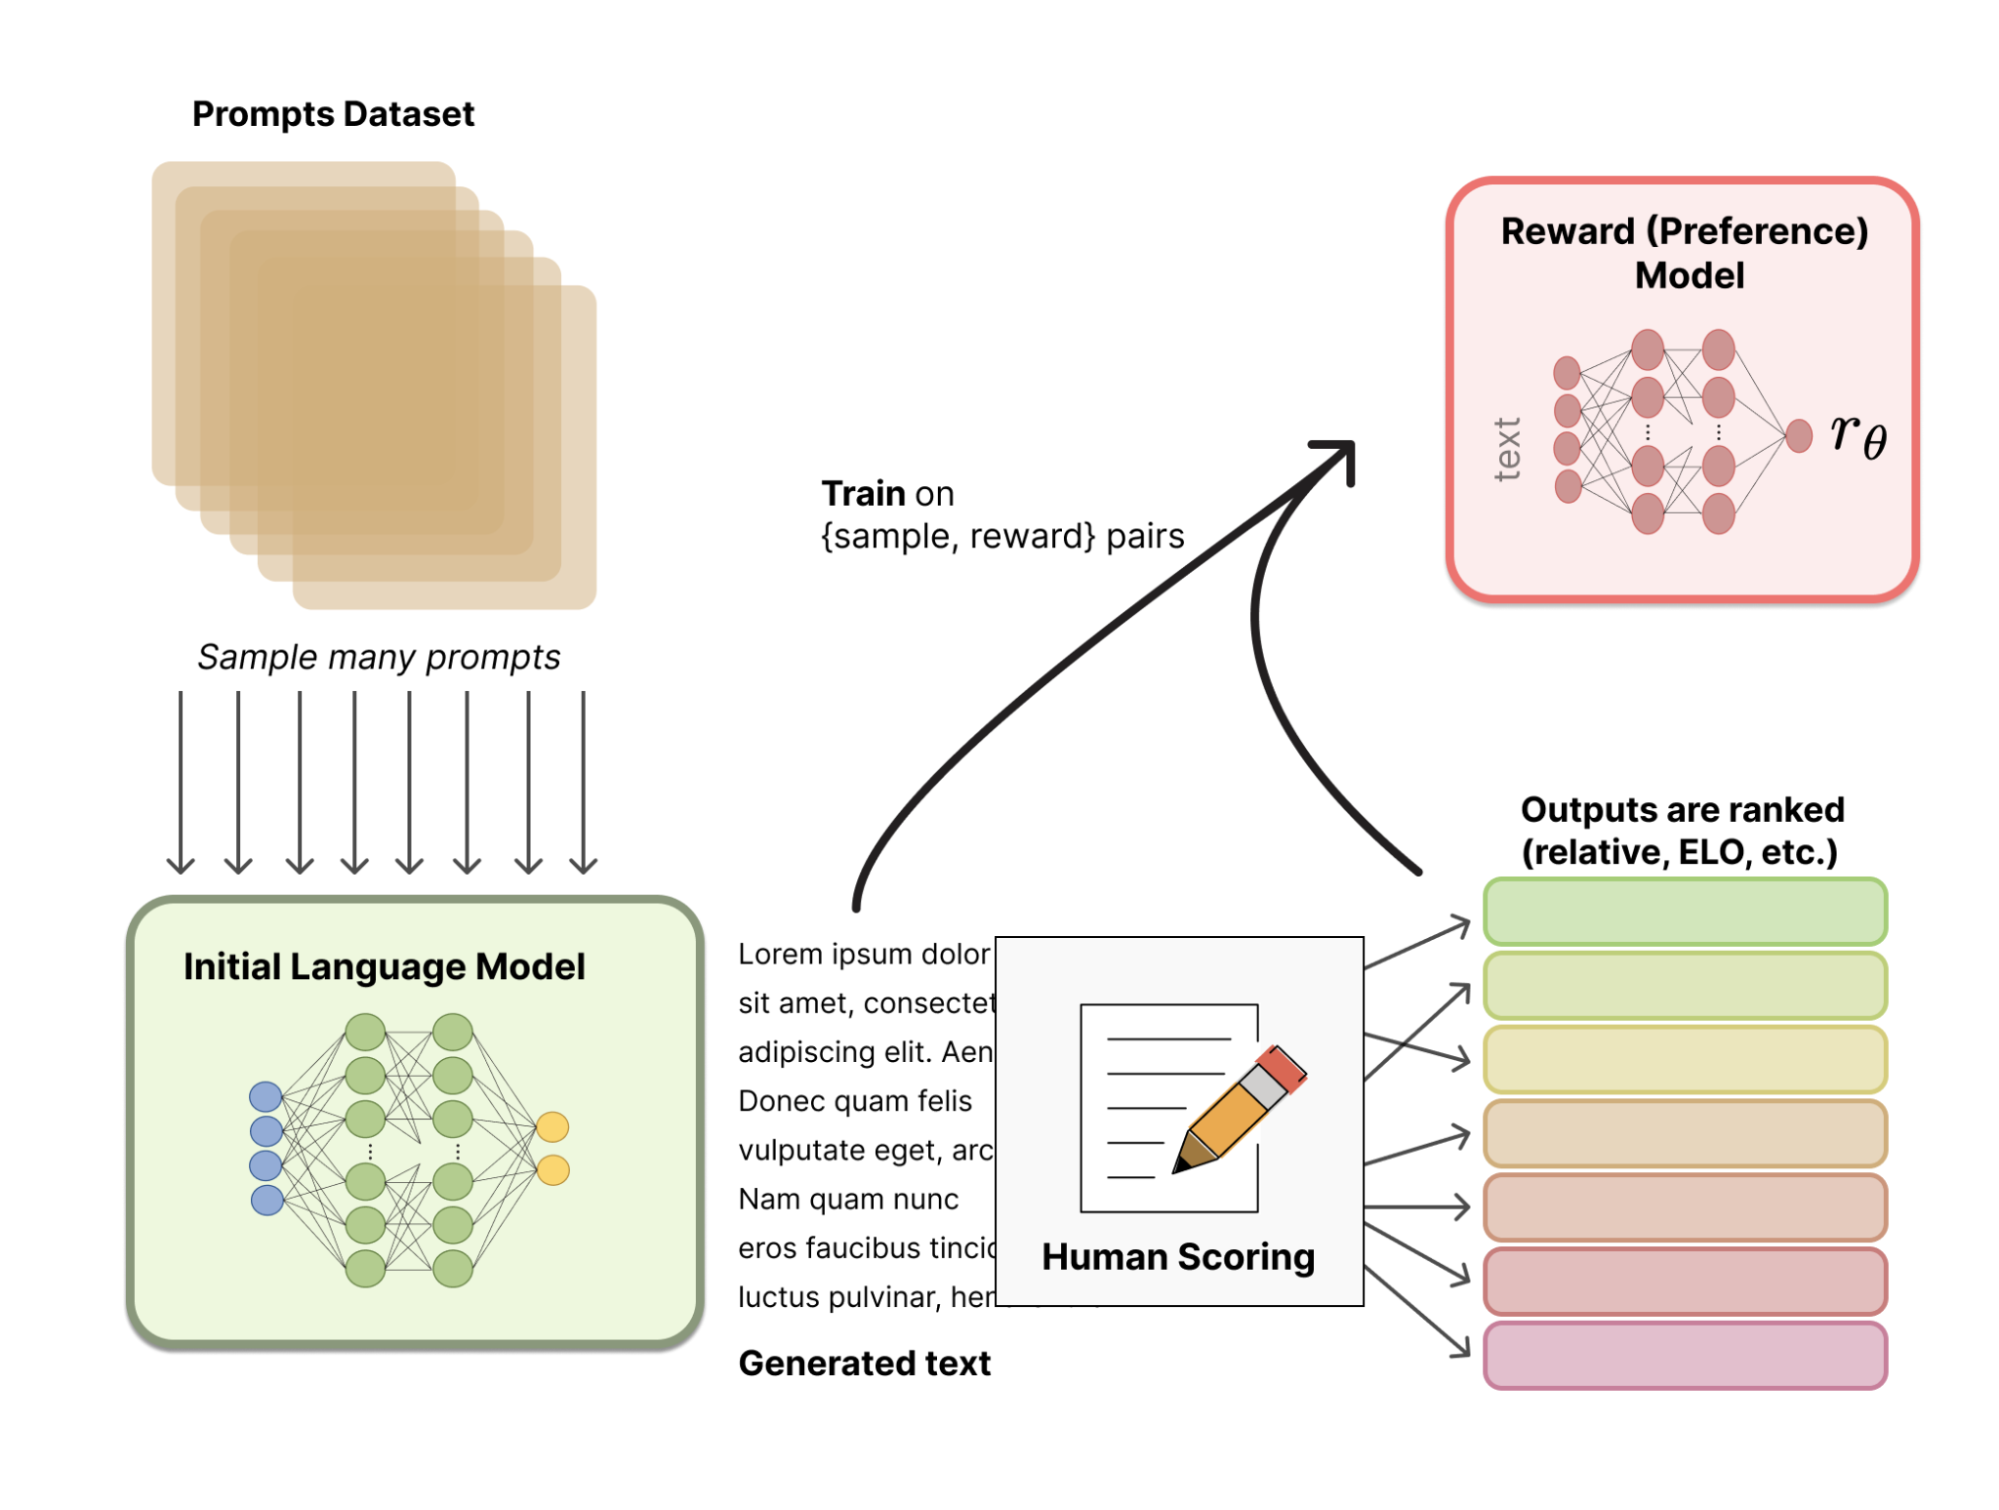
स्रोत: Hugging Face
अंतिम चरण में, LLM नए पाठ उत्पन्न करता है और मानव-प्रतिक्रिया-आधारित पुरस्कार मॉडल का उपयोग करके गुणवत्ता स्कोर बनाता है। फिर मॉडल इस स्कोर का उपयोग आगामी प्रॉम्प्ट्स पर अपने प्रदर्शन को बेहतर बनाने के लिए करता है।
मानव प्रतिक्रिया और रिइन्फोर्समेंट लर्निंग तकनीकों के साथ फाइन-ट्यूनिंग, इस प्रकार, एक आवर्तक प्रक्रिया में संयोजित होते हैं जो तब तक चलती है जब तक एक निश्चित स्तर की शुद्धता प्राप्त नहीं हो जाती।
RLHF, ChatGPT जैसे LLMs को फाइन-ट्यून करने की एक अत्याधुनिक तकनीक है। हालाँकि, RLHF एक लोकप्रिय विषय है, और NLP समस्याओं से परे अन्य संभावनाओं का भी बढ़ता साहित्य अन्वेषण कर रहा है। नीचे कुछ अन्य क्षेत्रों की सूची है जहाँ RLHF को सफलतापूर्वक लागू किया गया है:
RLHF एक शक्तिशाली और आशाजनक तकनीक है जिसके बिना अगली पीढ़ी के AI टूल्स संभव नहीं होते। इसके कुछ लाभ यहाँ हैं:
हालाँकि, RLHF त्रुटिरहित नहीं है। इस तकनीक में कुछ जोखिम और सीमाएँ भी हैं। नीचे कुछ महत्वपूर्ण बिंदु दिए गए हैं:
RLHF, ChatGPT और GPT-4 जैसे आधुनिक जनरेटिव AI टूल्स की रीढ़ में से एक है। प्रभावशाली परिणामों के बावजूद, RLHF अपेक्षाकृत नई तकनीक है और सुधार की बड़ी गुंजाइश है। RLHF पर भविष्य का शोध LLMs को अधिक दक्ष बनाने, उनके पर्यावरणीय प्रभाव को कम करने, और LLMs के कुछ जोखिमों व सीमाओं को संबोधित करने के लिए महत्वपूर्ण है।
जनरेटिव AI, मशीन लर्निंग और LLMs में नवीनतम विकासों से जुड़ने के लिए, हम आपको हमारे चयनित सीखने के संसाधन देखने की सलाह देते हैं:
इस लेख में उल्लिखित विषय सीखें!
कोर्स
कोर्स
कोर्स