迁移学习是一种技术,使机器能够利用在先前任务中获得的知识来改进对另一任务的泛化能力。它是 ChatGPT、Google Gemini 等模型背后的基础概念,并助力完成许多重要且实用的任务,如总结长文档、撰写复杂论文、规划行程,甚至写诗和作曲。
在本指南中,我们将深入探讨迁移学习。我们将讨论其定义、为何与深度学习和现代生成式 AI 模型密切相关,以及这种技术的挑战与局限。我们还会提供进一步学习的资源。准备好了吗?让我们开始吧。
什么是人工智能中的迁移学习?
迁移学习是一种将为某一特定任务开发的模型,复用于第二个任务起点的技术。换言之,您将预训练机器学习模型的组件,重新应用到旨在解决不同但相关问题的新模型上。
这一概念类似于人类学习新技能的方式。举个例子:想象您是一名出色的吉他手,现在决定学习尤克里里。您先前的吉他经验会加速学习进程。这是因为演奏吉他所需的许多技能与知识——如按弦位置、扫弦节奏、指板理解、乐理与节奏感——同样适用于演奏尤克里里。
在 AI 中,迁移学习使您能够利用先前的训练,更高效地解决新的相关问题,从而减少时间和计算资源的消耗。
为何使用迁移学习?
在开发神经网络时采用迁移学习有多项令人信服的理由,包括:
- 训练效率:迁移学习避免了从零开始训练模型,因而可缩短训练时间,并允许使用较小的数据集进行微调。
- 模型性能:迁移学习通过利用预训练知识来提升模型表现,降低过拟合风险,并在数据有限的情况下实现更快、更高效的训练。
- 降低运营成本:迁移学习免去了从头训练模型的需求,而数据获取与模型训练的计算成本往往都很高,因此可降低成本。
- 更强的适应性与可复用性:迁移学习是使模型适配多种场景与任务的关键技术,从而提升其潜力与可用性。
迁移学习如何工作
让我们来了解与迁移学习相关的三个概念:多任务学习、特征提取与微调。
多任务学习
在多任务学习中,一个模型同时被训练以执行多项任务。模型的前几层共享,以通用方式处理数据,随后为每个具体任务设置独立的层。这样既能让模型学习对所有任务都有用的通用特征,也能学习更具针对性的任务特异特征。
这一范式被广泛应用于现代 LLM。查看我们的LLM 入门课程了解全部细节。
特征提取
特征提取是指使用预训练模型从数据中提取有意义的特征或表示,然后将这些特征作为输入,供专注于特定目标的新模型使用。
基于特征的迁移学习利用神经网络在特征提取方面的独特能力。通过特征提取,模型可以“弄清楚”输入中哪些部分对于某个任务(例如图像分类)是重要的。实践中,这意味着当模型应用于新任务时,仅使用模型中包含更具泛化性的预训练的前几层与中间层。
微调
微调超越了特征提取,通常用于两个任务关联性不强的场景。它指的是在预训练模型的基础上,使用领域特定的数据集进行进一步训练。
当今多数 LLM 在整体表现上非常出色,但在特定的任务型问题上常常失手。微调可以使模型更好地适配特定任务,从而在真实世界应用中更高效、更灵活。若想进一步了解微调,请查看我们的LLM 微调入门指南。
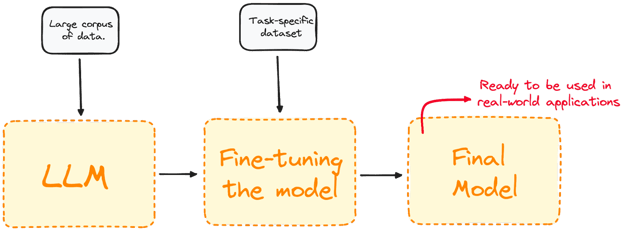 微调过程可视化。[DataCamp]
迁移学习的应用
迁移学习是应对多种数据科学任务的常用技术,包括计算机视觉和自然语言处理中的任务。
计算机视觉
计算机视觉是迁移学习尤其卓有成效的领域之一。该领域中的神经网络需要海量数据来处理诸如目标检测和图像分类等任务。
在计算机视觉中,神经网络的初始层负责检测图像中的边缘,中间层识别形状与轮廓,最后几层则针对具体任务进行定制。迁移学习使我们只需重新训练最后几层即可创建新模型,同时保持初始层与中间层的权重和偏置不变。得益于迁移学习,可以在保持前几层与中间层权重和偏置的同时,仅对网络的末端层进行再训练来构建新模型。
如今,计算机视觉领域有不少公开的预训练神经网络,例如:
- Visual Geometry Group:VGG 是一个用于图像分类的预训练模型,广泛作为许多图像分类任务的起点。
- You Only Look Once:YOLO 是最先进的预训练目标检测模型之一,以其速度快、可检测对象范围广而著称。
自然语言处理
NLP 是人工智能的一个分支,关注计算机与人类通过自然语言进行交互。其目标是让计算机以文本或音频的形式处理和分析海量自然语言数据。
迁移学习在构建 NLP 模型中发挥关键作用。它允许利用在通用语言理解或翻译上预训练的语言模型,并将其微调到具体的 NLP 问题上,例如情感分析或机器翻译。NLP 的应用几乎无处不在,包括语音助手与语音识别等。
一些最受欢迎的 NLP 模型背后都离不开迁移学习,包括:
- Bidirectional Encoder Representations from Transformers:BERT 由谷歌研究人员于 2018 年提出,是最早基于 Transformer 架构的 LLM 之一。它是一个公开的预训练模型,在语言建模、文本分类、机器翻译等众多 NLP 任务中表现出色。
- Generative Pre-Trained Transformer:GPT 由 OpenAI 开发,是引领 GenAI 革命的一系列强大 LLM。GPT-3.5 与 GPT-4 等模型是广为人知的 ChatGPT 背后的基础模型。OpenAI 也近期推出了GPT-4o,迄今为止最强大的版本。
最佳实践与挑战
归根结底,迁移学习本质上是一种提升效率的设计思路。与其从零开始训练模型——对于前沿的生成式 AI 模型而言,这需要大量资源、资金与时间——迁移学习通过利用既有知识,使模型在新任务上更快、更有效地学习。
当用于第二个任务的数据很少时,迁移学习的优势尤为明显。通过借助预训练模型的知识,迁移学习有助于防止过拟合并提升总体准确度。然而,迁移学习并非万无一失,仍存在需要谨慎应对的局限与潜在陷阱。迁移学习中一些常见挑战包括:
- 领域不匹配:当源任务与目标任务相关时,迁移学习更可能取得良好效果。若新任务差异过大,所迁移的可泛化知识可能不足以准确完成新任务。
- 数据稀缺:始终需要一定数量的训练数据。若训练数据极其有限或质量较差,模型可能出现欠拟合。
- 过拟合:迁移学习也不能免于过拟合。若在某任务上过度微调,模型可能学到对新数据泛化不佳的任务特异特征。
- 复杂性:有时目标任务过于复杂,微调过程本身可能具有挑战性、成本高且耗时。
结语与延伸资源
迁移学习是一种提升神经网络效率与潜力的关键设计方法。可以说,没有种种可用的迁移学习技术,就不会有当下的 AI 革命。
如果您想进一步了解迁移学习的细节,DataCamp 随时为您提供帮助。查看我们专门针对 LLM 与神经网络的材料,立即开始您的学习之旅。


迁移学习是一种技术,使机器能够利用在先前任务中获得的知识来改进对另一任务的泛化能力。它是 ChatGPT、Google Gemini 等模型背后的基础概念,并助力完成许多重要且实用的任务,如总结长文档、撰写复杂论文、规划行程,甚至写诗和作曲。
在本指南中,我们将深入探讨迁移学习。我们将讨论其定义、为何与深度学习和现代生成式 AI 模型密切相关,以及这种技术的挑战与局限。我们还会提供进一步学习的资源。准备好了吗?让我们开始吧。
什么是人工智能中的迁移学习?
迁移学习是一种将为某一特定任务开发的模型,复用于第二个任务起点的技术。换言之,您将预训练机器学习模型的组件,重新应用到旨在解决不同但相关问题的新模型上。
这一概念类似于人类学习新技能的方式。举个例子:想象您是一名出色的吉他手,现在决定学习尤克里里。您先前的吉他经验会加速学习进程。这是因为演奏吉他所需的许多技能与知识——如按弦位置、扫弦节奏、指板理解、乐理与节奏感——同样适用于演奏尤克里里。
在 AI 中,迁移学习使您能够利用先前的训练,更高效地解决新的相关问题,从而减少时间和计算资源的消耗。
为何使用迁移学习?
在开发神经网络时采用迁移学习有多项令人信服的理由,包括:
迁移学习如何工作
让我们来了解与迁移学习相关的三个概念:多任务学习、特征提取与微调。
多任务学习
在多任务学习中,一个模型同时被训练以执行多项任务。模型的前几层共享,以通用方式处理数据,随后为每个具体任务设置独立的层。这样既能让模型学习对所有任务都有用的通用特征,也能学习更具针对性的任务特异特征。
这一范式被广泛应用于现代 LLM。查看我们的LLM 入门课程了解全部细节。
特征提取
特征提取是指使用预训练模型从数据中提取有意义的特征或表示,然后将这些特征作为输入,供专注于特定目标的新模型使用。
基于特征的迁移学习利用神经网络在特征提取方面的独特能力。通过特征提取,模型可以“弄清楚”输入中哪些部分对于某个任务(例如图像分类)是重要的。实践中,这意味着当模型应用于新任务时,仅使用模型中包含更具泛化性的预训练的前几层与中间层。
微调
微调超越了特征提取,通常用于两个任务关联性不强的场景。它指的是在预训练模型的基础上,使用领域特定的数据集进行进一步训练。
当今多数 LLM 在整体表现上非常出色,但在特定的任务型问题上常常失手。微调可以使模型更好地适配特定任务,从而在真实世界应用中更高效、更灵活。若想进一步了解微调,请查看我们的LLM 微调入门指南。
迁移学习的应用
迁移学习是应对多种数据科学任务的常用技术,包括计算机视觉和自然语言处理中的任务。
计算机视觉
计算机视觉是迁移学习尤其卓有成效的领域之一。该领域中的神经网络需要海量数据来处理诸如目标检测和图像分类等任务。
在计算机视觉中,神经网络的初始层负责检测图像中的边缘,中间层识别形状与轮廓,最后几层则针对具体任务进行定制。迁移学习使我们只需重新训练最后几层即可创建新模型,同时保持初始层与中间层的权重和偏置不变。得益于迁移学习,可以在保持前几层与中间层权重和偏置的同时,仅对网络的末端层进行再训练来构建新模型。
如今,计算机视觉领域有不少公开的预训练神经网络,例如:
自然语言处理
NLP 是人工智能的一个分支,关注计算机与人类通过自然语言进行交互。其目标是让计算机以文本或音频的形式处理和分析海量自然语言数据。
迁移学习在构建 NLP 模型中发挥关键作用。它允许利用在通用语言理解或翻译上预训练的语言模型,并将其微调到具体的 NLP 问题上,例如情感分析或机器翻译。NLP 的应用几乎无处不在,包括语音助手与语音识别等。
一些最受欢迎的 NLP 模型背后都离不开迁移学习,包括:
最佳实践与挑战
归根结底,迁移学习本质上是一种提升效率的设计思路。与其从零开始训练模型——对于前沿的生成式 AI 模型而言,这需要大量资源、资金与时间——迁移学习通过利用既有知识,使模型在新任务上更快、更有效地学习。
当用于第二个任务的数据很少时,迁移学习的优势尤为明显。通过借助预训练模型的知识,迁移学习有助于防止过拟合并提升总体准确度。然而,迁移学习并非万无一失,仍存在需要谨慎应对的局限与潜在陷阱。迁移学习中一些常见挑战包括:
结语与延伸资源
迁移学习是一种提升神经网络效率与潜力的关键设计方法。可以说,没有种种可用的迁移学习技术,就不会有当下的 AI 革命。
如果您想进一步了解迁移学习的细节,DataCamp 随时为您提供帮助。查看我们专门针对 LLM 与神经网络的材料,立即开始您的学习之旅。