Cours
Introduction au Deep Learning avec PyTorch
4 h
91K
L’apprentissage par transfert est une technique qui permet aux modèles d’exploiter les connaissances acquises sur une première tâche pour mieux généraliser sur une autre. Ce concept est au cœur de modèles comme ChatGPT ou Google Gemini, et soutient de nombreuses tâches utiles au quotidien, comme résumer de longs documents, rédiger des essais complexes, organiser des voyages, ou même écrire des poèmes et des chansons.
Dans ce guide, nous allons approfondir l’apprentissage par transfert : sa définition, sa pertinence pour l’apprentissage profond et les modèles génératifs modernes, ainsi que ses défis et ses limites. Nous vous proposerons également des ressources pour aller plus loin. Prêt à commencer ? Allons-y.
L’apprentissage par transfert consiste à réutiliser un modèle développé pour une tâche donnée comme point de départ pour un modèle dédié à une seconde tâche. Autrement dit, vous réappliquez des composants d’un modèle d’apprentissage automatique pré-entraîné à de nouveaux modèles destinés à un usage différent mais connexe.
Le concept est comparable à la façon dont les humains acquièrent de nouvelles compétences. Exemple : vous jouez très bien de la guitare et décidez d’apprendre le ukulélé. Votre expérience préalable accélérera votre apprentissage, car nombre de compétences requises pour la guitare — positions des doigts, rythmiques, compréhension du manche, théorie musicale et sens du rythme — s’appliquent aussi au ukulélé.
En IA, l’apprentissage par transfert permet de tirer parti d’entraînements antérieurs pour résoudre de nouveaux problèmes apparentés plus efficacement, en réduisant le temps et les ressources de calcul nécessaires.
Plusieurs raisons solides justifient l’adoption de ces techniques lors du développement de réseaux de neurones, notamment :
Explorons trois notions associées à l’apprentissage par transfert : l’apprentissage multitâche, l’extraction de caractéristiques et le fine-tuning.
Dans l’apprentissage multitâche, un même modèle est entraîné à effectuer plusieurs tâches simultanément. Les premières couches, partagées, traitent les données de manière commune, puis des couches distinctes sont dédiées à chaque tâche spécifique. Le modèle apprend ainsi des attributs généraux utiles à toutes les tâches, tout en acquérant des caractéristiques propres à chacune.
Ce paradigme est largement utilisé dans les LLM modernes. Découvrez tous les détails dans notre cours d’introduction aux LLMs.
L’extraction de caractéristiques consiste à utiliser un modèle pré-entraîné pour extraire des représentations pertinentes à partir des données. Ces représentations servent ensuite d’entrées à un nouveau modèle centré sur une tâche précise.
L’apprentissage par transfert basé sur les caractéristiques exploite la capacité unique des réseaux de neurones à extraire des attributs des données. Avec l’extraction, le modèle « repère » les éléments importants de l’entrée pour, par exemple, classer une image. Concrètement, appliqué à une nouvelle tâche, on réutilise surtout les premières couches et les couches intermédiaires pré-entraînées, qui encapsulent le savoir le plus généralisable.
Le fine-tuning va au-delà de l’extraction de caractéristiques et s’emploie souvent lorsque les deux tâches sont moins proches. Il consiste à reprendre un modèle pré-entraîné et à le réentraîner sur un jeu de données spécifique à un domaine.
La plupart des LLM actuels offrent d’excellentes performances globales, mais peuvent échouer sur des tâches très ciblées. Le fine-tuning ajuste alors le modèle pour ces usages précis, le rendant plus efficace et polyvalent en production. Pour en savoir plus, consultez notre guide d’introduction au fine-tuning des LLMs.
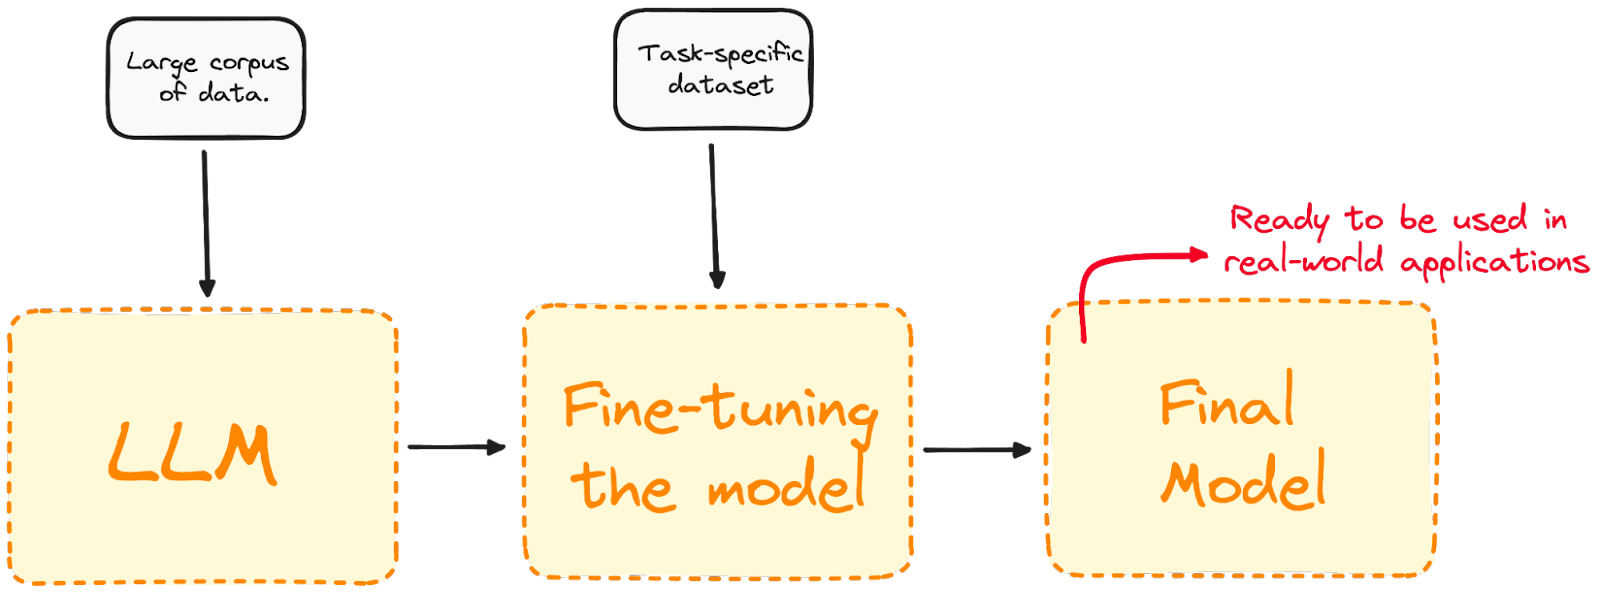 Visualiser le processus de fine-tuning. [DataCamp]
L’apprentissage par transfert est couramment utilisé pour résoudre de multiples tâches en science des données, notamment en vision par ordinateur et en traitement du langage naturel.
La vision par ordinateur est l’un des domaines où l’apprentissage par transfert a été particulièrement fructueux. Les réseaux de neurones y requièrent d’énormes volumes de données pour des tâches comme la détection d’objets et la classification d’images.
Dans ces modèles, les premières couches détectent les contours, les couches intermédiaires identifient des formes, et les dernières couches sont adaptées aux tâches spécifiques. L’apprentissage par transfert permet de créer de nouveaux modèles en ne réentraînant que les dernières couches, tout en conservant les poids et biais des couches initiales et intermédiaires. Grâce à cette approche, on peut bâtir de nouveaux modèles en se concentrant sur la tête de réseau, sans toucher au socle généralisable.
Aujourd’hui, plusieurs réseaux pré-entraînés et publics en vision par ordinateur sont disponibles, par exemple :
Le NLP est une branche de l’IA consacrée aux interactions entre ordinateurs et humains via le langage naturel. L’objectif est d’amener les machines à traiter et analyser de grandes quantités de données textuelles ou audio.
L’apprentissage par transfert est déterminant pour développer des modèles NLP. Il permet de réutiliser des modèles linguistiques pré-entraînés sur la compréhension générale du langage ou la traduction, puis de les affiner pour des problèmes précis comme l’analyse de sentiments ou la traduction automatique. Les applications du NLP sont quasi illimitées, des assistants vocaux à la reconnaissance vocale.
Cette approche est à l’origine de certains des modèles NLP les plus populaires, notamment :
Au fond, l’apprentissage par transfert est une manière de concevoir des modèles plus efficients. Plutôt que d’entraîner des modèles depuis zéro — une démarche coûteuse en ressources, en budget et en temps pour les modèles génératifs de pointe — il permet d’accélérer et d’améliorer l’apprentissage sur de nouvelles tâches en s’appuyant sur des connaissances déjà acquises.
Cette approche brille lorsque peu de données sont disponibles pour entraîner un modèle sur une seconde tâche. En réutilisant le savoir d’un modèle pré-entraîné, elle aide à prévenir le surapprentissage et à accroître la précision globale. Mais elle a aussi ses limites et écueils potentiels, qu’il faut gérer avec soin. Parmi les défis les plus fréquents :
L’apprentissage par transfert est une approche de conception essentielle pour accroître l’efficacité et le potentiel des réseaux de neurones. On peut dire sans exagérer que l’essor actuel de l’IA n’aurait pas été possible sans la diversité des techniques de transfert disponibles.
Pour creuser le sujet, DataCamp est là pour vous accompagner. Parcourez nos ressources dédiées aux LLMs et aux réseaux de neurones et lancez-vous dès aujourd’hui.
Apprenez avec DataCamp
Cours
Cours
Cours