科学突破很少凭空而来。相反,它们往往是建立在累积的人类知识之上的“倒数第二级台阶”。要理解诸如 ChatGPT 和 Google Bard 等大型语言模型(LLM)的成功,我们需要回到过去,从 BERT 讲起。
BERT 由 Google 研究人员于 2018 年提出,是最早的 LLM 之一。凭借惊人的效果,它迅速成为 NLP 任务中的通用基线,包括通用语言理解、问答与命名实体识别等。
想进一步了解 LLM?今天就开始学习我们的《大型语言模型(LLM)概念》课程第一章。
可以说,BERT 为我们如今所见的生成式 AI 革命铺平了道路。尽管是最早的 LLM 之一,BERT 仍被广泛使用,并有数以千计的开源、免费、预训练 BERT 模型可用于特定场景,例如情感分析、临床笔记分析以及有害评论检测。
对 BERT 感到好奇?继续阅读本文,我们将探讨 BERT 的架构、技术原理、部分真实世界应用以及它的局限性。
什么是 BERT?
BERT(Bidirectional Encoder Representations from Transformers,双向编码器表示)是 Google 于 2018 年开源的模型。它是一项雄心勃勃的实验,旨在检验所谓的Transformer——Google 研究人员在 2017 年著名论文 Attention is All You Need 中提出的一种创新神经结构——在自然语言处理(NLP)任务上的表现。
BERT 成功的关键在于其 Transformer 架构。在 Transformer 出现之前,自然语言建模是一项非常具有挑战性的任务。尽管更复杂的神经网络——即循环或卷积神经网络——相继涌现,但成效也只是部分可观。
主要挑战在于神经网络用于预测句子中缺失词的机制。当时,最先进的神经网络依赖于编码器-解码器架构,这是一种强大但耗时、耗资源且不利于并行计算的机制。
考虑到这些挑战,Google 研究人员提出了 Transformer,这是一种基于注意力机制的创新神经架构,详见下一节说明。
BERT 如何工作?
让我们来看看 BERT 的工作方式,涵盖模型背后的技术、训练方式以及数据处理方法。
核心架构与功能
循环和卷积神经网络使用顺序计算来生成预测。也就是说,一旦在海量数据集上完成训练,它们可以预测给定词序列之后可能出现的词。从这个意义上说,它们被视为单向或上下文无关的算法。
相比之下,像 BERT 这样的 Transformer 驱动模型,同样基于编码器-解码器架构,但它们是双向的,因为它们会基于前文和后文来预测词。其实现依赖于自注意力机制,这一层被引入到编码器和解码器中。注意力层的目标是在输入句子中捕捉不同词之间的上下文关系。
如今已有许多预训练 BERT 版本,但在最初的论文中,Google 训练了两个版本:BERTbase 和 BERTlarge,采用不同的神经架构。本质上,BERTbase 包含 12 层 Transformer、12 个注意力头、1.1 亿参数;而 BERTlarge 使用 24 层 Transformer、16 个注意力头、3.4 亿参数。不出所料,BERTlarge 在精度测试中优于体量更小的版本。
想详细了解 Transformer 中编码器-解码器架构的工作原理,我们强烈建议您阅读《Introduction to Using Transformers and Hugging Face》。
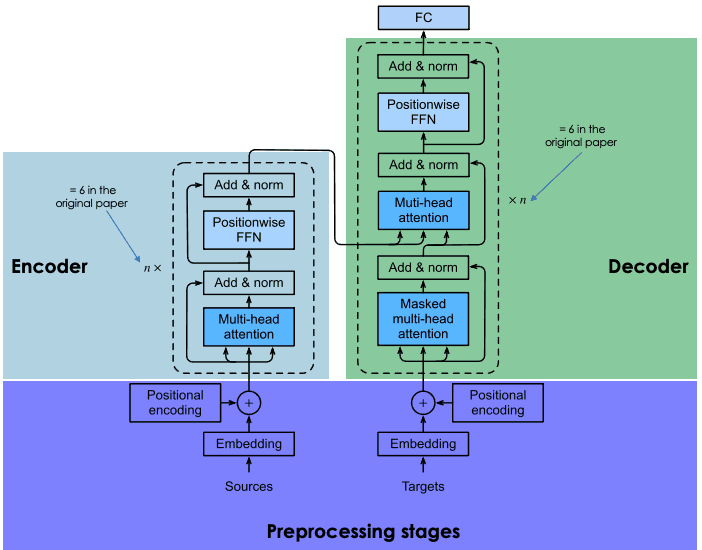
Transformer 架构示意
预训练与微调
Transformer 是在海量语料上从零开始训练的,过程耗时且昂贵(只有包括 Google 在内的少数公司能够承担)。
就 BERT 而言,它在维基百科(约 25 亿词)和 Google 的 BooksCorpus(约 8 亿词)上预训练了四天。这使模型不仅掌握英语知识,也涵盖了全球多种语言。
为优化训练过程,Google 开发了专用硬件 TPU(Tensor Processing Unit,张量处理单元),专为机器学习任务设计。
为避免训练过程中的不必要且昂贵的交互,Google 研究人员使用了迁移学习技术,将(预)训练阶段与微调阶段分离。这使开发者可以选择预训练模型,细化目标任务的输入-输出配对数据,并使用特定领域数据对预训练模型的顶部进行再训练。正是这一特性,使得像 BERT 这样的 LLM 成为无数上层应用的基础模型。
掩码语言建模在 BERT 处理中的作用
在 BERT(以及所有基于 Transformer 的 LLM)中实现双向学习的关键要素是注意力机制。该机制依托于掩码语言建模(MLM)。通过在句子中掩盖一个词,这种技术迫使模型在两个方向上分析句中其余词,以提高预测被掩盖词的概率。MLM 借鉴了计算机视觉领域中已经尝试过的技术,对于需要对整个序列具备良好上下文理解的任务非常有效。
BERT 是第一个应用该技术的 LLM。具体来说,在训练过程中,随机对 15% 的分词进行掩码。结果表明,BERT 能够以较高精度预测被隐藏的词。
对掩码语言建模感兴趣?查看我们的大型语言模型(LLM)概念课程,了解这一创新技术的全部细节。
BERT 用于什么?BERT 对 NLP 的影响
借助 Transformer,BERT 在多项 NLP 任务上达到了最先进水平。以下是 BERT 表现突出的测试:
- 问答。 BERT 是最早的 Transformer 驱动聊天机器人之一,效果令人印象深刻。
- 情感分析。 例如,BERT 成功预测电影评论的正负倾向。
- 文本生成。 作为下一代聊天机器人的先驱,BERT 已能借助简单提示生成长文本。
- 文本摘要。 同样,BERT 能够阅读并总结来自法律、医疗等复杂领域的文本。
- 语言翻译。 BERT 在多语言数据上接受过训练,因此是一个多语种模型,非常适合用于机器翻译。
- 自动补全任务。 BERT 可用于电子邮件或消息服务中的自动补全。
BERT 的真实世界应用
许多 LLM 只在实验环境中尝试过,但鲜有进入成熟应用的案例。BERT 则不同,数以百万计的人每天都在使用它(尽管我们可能并未意识到)。
一个很好的例子是 Google 搜索。2020 年,Google 宣布已在 70 多种语言的 Google 搜索中采用 BERT。这意味着 Google 使用 BERT 来排序内容并展示精选摘要。借助注意力机制,Google 现在可以结合您问题的上下文提供有用信息,如下例所示。
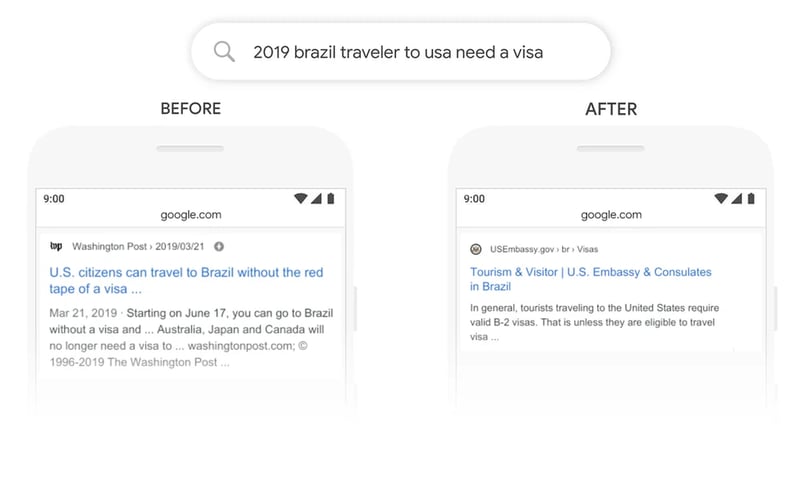
来源:Google
BERT 的变体与改编
但这只是故事的一部分。BERT 的成功很大程度上归功于其开源特性,开发者可以访问原始 BERT 的源代码,并据此创建新功能与改进。
这催生了大量 BERT 变体。以下是一些最知名的变体:
- RoBERTa。“Robustly Optimized BERT Approach”的缩写,RoBERTa 是 Meta 与华盛顿大学合作创建的 BERT 变体。被认为比原版 BERT 更强,RoBERTa 使用比 BERT 大 10 倍的数据集进行训练。在架构方面,最显著的差异是采用动态掩码学习而非静态掩码学习。该技术通过复制训练数据并以 10 种不同的掩码策略分别进行训练,使 RoBERTa 学到更稳健且具泛化能力的词表示。
- DistilBERT。 自 2010 年代末第一批 LLM 问世以来,构建更大更重的 LLM 成为趋势。这有其道理,因为模型规模与准确率似乎成正相关。然而,模型越大,运行所需资源越多,可负担使用的人就越少。DistilBERT 旨在让 BERT 更易用,提供一个更小、更快、更便宜、更轻量的变体。基于原始 BERT 的架构,DistilBERT 在预训练中使用知识蒸馏技术,将体量减少 40%,同时保留 97% 的语言理解能力,并且速度提升 60%。
- ALBERT。 即 “A Lite BERT”,专为在预训练阶段提升 BERTlarge 的效率而设计。由于训练更大模型常伴随内存限制、训练时间更长以及模型退化等问题,ALBERT 的作者提出了两种参数缩减技术,以减少内存占用并在训练中提速。
如果您想了解更多开源 LLM 运动的信息,我们强烈建议阅读我们关于 2023 年顶级开源 LLM 的文章。
针对特定任务微调 BERT
BERT(以及 LLM)的一大优势在于预训练与微调过程相互独立。这意味着开发者可以直接采用预训练版 BERT,并针对自己的特定用例进行定制。
就 BERT 而言,已有数百个针对多样化 NLP 任务的微调版本。下面列出了极其有限的一部分:
- BERT-base-chinese。 针对中文 NLP 任务训练的 BERTbase 版本
- BERT-base-NER。 面向命名实体识别定制的 BERTbase 版本
- Symps_disease_bert_v3_c41。 面向自然语言聊天机器人的症状到疾病分类模型。
- BERT for Patents。 由 Google 在全球 1 亿多份专利上训练的模型,基于 BERTlarge。
理解 BERT 的局限性
BERT 也存在 LLM 的常见局限与问题。BERT 的预测始终依赖于用于训练的数据量与数据质量。如果训练数据有限、质量不高或带有偏见,BERT 可能会给出不准确、有害的结果,甚至出现所谓的LLM 幻觉。
对于最初版本的 BERT,这种情况更有可能发生,因为该模型未采用基于人类反馈的强化学习(RLHF)。而诸如 ChatGPT、LLaMA 2 和 Google Bard 等更先进模型则将其作为提升 AI 安全性的标准技术。RLHF 涉及在训练过程中利用人类反馈来监控并引导 LLM 的学习,从而构建更有效、更安全、更值得信赖的系统。
此外,尽管与 ChatGPT 等最先进的 LLM 相比,BERT 可被视为较小的模型,但运行它(更不用说从零开始训练)仍需要相当可观的算力。因此,资源有限的开发者可能无法使用。
BERT 与 NLP 的未来
BERT 是最早的现代 LLM 之一。但它远非“过时”,依然是最成功、应用最广的 LLM 之一。得益于其开源特性,如今已有多种变体以及数以百计面向特定 NLP 任务的预训练版本。
如果您希望持续关注 BERT 与 NLP 的最新进展,DataCamp 可以助您一臂之力。查看我们精选的资料,紧跟当下生成式 AI 革命!


科学突破很少凭空而来。相反,它们往往是建立在累积的人类知识之上的“倒数第二级台阶”。要理解诸如 ChatGPT 和 Google Bard 等大型语言模型(LLM)的成功,我们需要回到过去,从 BERT 讲起。
BERT 由 Google 研究人员于 2018 年提出,是最早的 LLM 之一。凭借惊人的效果,它迅速成为 NLP 任务中的通用基线,包括通用语言理解、问答与命名实体识别等。
想进一步了解 LLM?今天就开始学习我们的《大型语言模型(LLM)概念》课程第一章。
可以说,BERT 为我们如今所见的生成式 AI 革命铺平了道路。尽管是最早的 LLM 之一,BERT 仍被广泛使用,并有数以千计的开源、免费、预训练 BERT 模型可用于特定场景,例如情感分析、临床笔记分析以及有害评论检测。
对 BERT 感到好奇?继续阅读本文,我们将探讨 BERT 的架构、技术原理、部分真实世界应用以及它的局限性。
什么是 BERT?
BERT(Bidirectional Encoder Representations from Transformers,双向编码器表示)是 Google 于 2018 年开源的模型。它是一项雄心勃勃的实验,旨在检验所谓的Transformer——Google 研究人员在 2017 年著名论文 Attention is All You Need 中提出的一种创新神经结构——在自然语言处理(NLP)任务上的表现。
BERT 成功的关键在于其 Transformer 架构。在 Transformer 出现之前,自然语言建模是一项非常具有挑战性的任务。尽管更复杂的神经网络——即循环或卷积神经网络——相继涌现,但成效也只是部分可观。
主要挑战在于神经网络用于预测句子中缺失词的机制。当时,最先进的神经网络依赖于编码器-解码器架构,这是一种强大但耗时、耗资源且不利于并行计算的机制。
考虑到这些挑战,Google 研究人员提出了 Transformer,这是一种基于注意力机制的创新神经架构,详见下一节说明。
BERT 如何工作?
让我们来看看 BERT 的工作方式,涵盖模型背后的技术、训练方式以及数据处理方法。
核心架构与功能
循环和卷积神经网络使用顺序计算来生成预测。也就是说,一旦在海量数据集上完成训练,它们可以预测给定词序列之后可能出现的词。从这个意义上说,它们被视为单向或上下文无关的算法。
相比之下,像 BERT 这样的 Transformer 驱动模型,同样基于编码器-解码器架构,但它们是双向的,因为它们会基于前文和后文来预测词。其实现依赖于自注意力机制,这一层被引入到编码器和解码器中。注意力层的目标是在输入句子中捕捉不同词之间的上下文关系。
如今已有许多预训练 BERT 版本,但在最初的论文中,Google 训练了两个版本:BERTbase 和 BERTlarge,采用不同的神经架构。本质上,BERTbase 包含 12 层 Transformer、12 个注意力头、1.1 亿参数;而 BERTlarge 使用 24 层 Transformer、16 个注意力头、3.4 亿参数。不出所料,BERTlarge 在精度测试中优于体量更小的版本。
想详细了解 Transformer 中编码器-解码器架构的工作原理,我们强烈建议您阅读《Introduction to Using Transformers and Hugging Face》。
Transformer 架构示意
预训练与微调
Transformer 是在海量语料上从零开始训练的,过程耗时且昂贵(只有包括 Google 在内的少数公司能够承担)。
就 BERT 而言,它在维基百科(约 25 亿词)和 Google 的 BooksCorpus(约 8 亿词)上预训练了四天。这使模型不仅掌握英语知识,也涵盖了全球多种语言。
为优化训练过程,Google 开发了专用硬件 TPU(Tensor Processing Unit,张量处理单元),专为机器学习任务设计。
为避免训练过程中的不必要且昂贵的交互,Google 研究人员使用了迁移学习技术,将(预)训练阶段与微调阶段分离。这使开发者可以选择预训练模型,细化目标任务的输入-输出配对数据,并使用特定领域数据对预训练模型的顶部进行再训练。正是这一特性,使得像 BERT 这样的 LLM 成为无数上层应用的基础模型。
掩码语言建模在 BERT 处理中的作用
在 BERT(以及所有基于 Transformer 的 LLM)中实现双向学习的关键要素是注意力机制。该机制依托于掩码语言建模(MLM)。通过在句子中掩盖一个词,这种技术迫使模型在两个方向上分析句中其余词,以提高预测被掩盖词的概率。MLM 借鉴了计算机视觉领域中已经尝试过的技术,对于需要对整个序列具备良好上下文理解的任务非常有效。
BERT 是第一个应用该技术的 LLM。具体来说,在训练过程中,随机对 15% 的分词进行掩码。结果表明,BERT 能够以较高精度预测被隐藏的词。
对掩码语言建模感兴趣?查看我们的大型语言模型(LLM)概念课程,了解这一创新技术的全部细节。
BERT 用于什么?BERT 对 NLP 的影响
借助 Transformer,BERT 在多项 NLP 任务上达到了最先进水平。以下是 BERT 表现突出的测试:
BERT 的真实世界应用
许多 LLM 只在实验环境中尝试过,但鲜有进入成熟应用的案例。BERT 则不同,数以百万计的人每天都在使用它(尽管我们可能并未意识到)。
一个很好的例子是 Google 搜索。2020 年,Google 宣布已在 70 多种语言的 Google 搜索中采用 BERT。这意味着 Google 使用 BERT 来排序内容并展示精选摘要。借助注意力机制,Google 现在可以结合您问题的上下文提供有用信息,如下例所示。
来源:Google
BERT 的变体与改编
但这只是故事的一部分。BERT 的成功很大程度上归功于其开源特性,开发者可以访问原始 BERT 的源代码,并据此创建新功能与改进。
这催生了大量 BERT 变体。以下是一些最知名的变体:
如果您想了解更多开源 LLM 运动的信息,我们强烈建议阅读我们关于 2023 年顶级开源 LLM 的文章。
针对特定任务微调 BERT
BERT(以及 LLM)的一大优势在于预训练与微调过程相互独立。这意味着开发者可以直接采用预训练版 BERT,并针对自己的特定用例进行定制。
就 BERT 而言,已有数百个针对多样化 NLP 任务的微调版本。下面列出了极其有限的一部分:
理解 BERT 的局限性
BERT 也存在 LLM 的常见局限与问题。BERT 的预测始终依赖于用于训练的数据量与数据质量。如果训练数据有限、质量不高或带有偏见,BERT 可能会给出不准确、有害的结果,甚至出现所谓的LLM 幻觉。
对于最初版本的 BERT,这种情况更有可能发生,因为该模型未采用基于人类反馈的强化学习(RLHF)。而诸如 ChatGPT、LLaMA 2 和 Google Bard 等更先进模型则将其作为提升 AI 安全性的标准技术。RLHF 涉及在训练过程中利用人类反馈来监控并引导 LLM 的学习,从而构建更有效、更安全、更值得信赖的系统。
此外,尽管与 ChatGPT 等最先进的 LLM 相比,BERT 可被视为较小的模型,但运行它(更不用说从零开始训练)仍需要相当可观的算力。因此,资源有限的开发者可能无法使用。
BERT 与 NLP 的未来
BERT 是最早的现代 LLM 之一。但它远非“过时”,依然是最成功、应用最广的 LLM 之一。得益于其开源特性,如今已有多种变体以及数以百计面向特定 NLP 任务的预训练版本。
如果您希望持续关注 BERT 与 NLP 的最新进展,DataCamp 可以助您一臂之力。查看我们精选的资料,紧跟当下生成式 AI 革命!