Kurs
Einführung in Deep Learning mit PyTorch
4 Std.
90.9K
Transfer Learning ist eine Technik, mit der Maschinen das Wissen aus einer vorherigen Aufgabe nutzen, um die Generalisierung bei einer anderen zu verbessern. Sie ist ein Grundprinzip hinter Modellen wie ChatGPT und Google Gemini und hilft bei vielen wichtigen und praktischen Aufgaben wie dem Zusammenfassen langer Dokumente, dem Verfassen komplexer Aufsätze, der Reiseplanung oder sogar beim Schreiben von Gedichten und Songs.
In diesem Leitfaden tauchen wir tief in Transfer Learning ein. Wir klären die Definition, warum es für Deep Learning und moderne generative KI-Modelle relevant ist, und welche Herausforderungen und Grenzen diese Technik hat. Außerdem empfehlen wir Ressourcen, damit du weiterlernen kannst. Bereit? Dann legen wir los.
Transfer Learning bedeutet, dass ein für eine bestimmte Aufgabe entwickeltes Modell als Ausgangspunkt für ein Modell auf einer zweiten Aufgabe wiederverwendet wird. Anders gesagt: Du übernimmst Komponenten eines vortrainierten Machine-Learning-Modells in neue Modelle, die für etwas Anderes, aber Verwandtes gedacht sind.
Das Konzept ist vergleichbar damit, wie Menschen neue Fähigkeiten erlernen. Ein Beispiel: Stell dir vor, du spielst sehr gut Gitarre und willst Ukulele lernen. Deine Gitarrenerfahrung beschleunigt das Lernen, weil vieles übertragbar ist – etwa Fingerpositionen, Schlagmuster, Griffbrettverständnis, Musiktheorie und Rhythmus.
In der KI erlaubt dir Transfer Learning, früheres Training zu nutzen, um neue, verwandte Probleme effizienter zu lösen – das spart Zeit und Rechenressourcen.
Es gibt mehrere gute Gründe, beim Entwickeln neuronaler Netze auf Transfer Learning zu setzen, darunter:
Schauen wir uns drei Konzepte an, die eng mit Transfer Learning verbunden sind: Multitask-Learning, Feature-Extraktion und Fine-Tuning.
Beim Multitask-Learning wird ein einzelnes Modell so trainiert, dass es mehrere Aufgaben gleichzeitig löst. Es verfügt über einen gemeinsamen, frühen Teil der Schichten, der die Daten einheitlich verarbeitet, gefolgt von separaten Schichten für die jeweiligen Aufgaben. So lernt das Modell allgemeine Merkmale, die für alle Aufgaben nützlich sind, und gleichzeitig aufgabenspezifische Merkmale.
Dieses Paradigma ist in modernen LLMs weit verbreitet. Sieh dir unseren Introduction to LLMs Course an, um alle Details zu lernen.
Bei der Feature-Extraktion wird ein vortrainiertes Modell genutzt, um aussagekräftige Merkmale bzw. Repräsentationen aus Daten zu gewinnen. Diese Merkmale dienen dann als Input für ein neues, auf eine konkrete Aufgabe fokussiertes Modell.
Featurebasiertes Transfer Learning nutzt die besondere Fähigkeit neuronaler Netze, Merkmale aus Daten zu extrahieren. Das Modell „erkennt“ dabei gewissermaßen, welcher Teil des Inputs z. B. für die Bildklassifikation wichtig ist. Praktisch bedeutet das: Für eine neue Aufgabe werden nur die vortrainierten ersten und mittleren Schichten mit ihrem verallgemeinerbaren Wissen verwendet.
Fine-Tuning geht über die reine Feature-Extraktion hinaus und wird häufig eingesetzt, wenn die beiden Aufgaben nicht eng verwandt sind. Dabei wird ein vortrainiertes Modell genommen und auf einem domänenspezifischen Datensatz weitertrainiert.
Die meisten LLMs liefern heute global sehr gute Leistungen, scheitern aber oft bei sehr spezifischen, aufgabenorientierten Problemen. Fine-Tuning passt das Modell gezielt auf solche Aufgaben an und macht es in realen Anwendungen wirksamer und vielseitiger. Wenn du mehr über Fine-Tuning wissen möchtest, lies unseren Introductory Guide to fine-tuning LLMs.
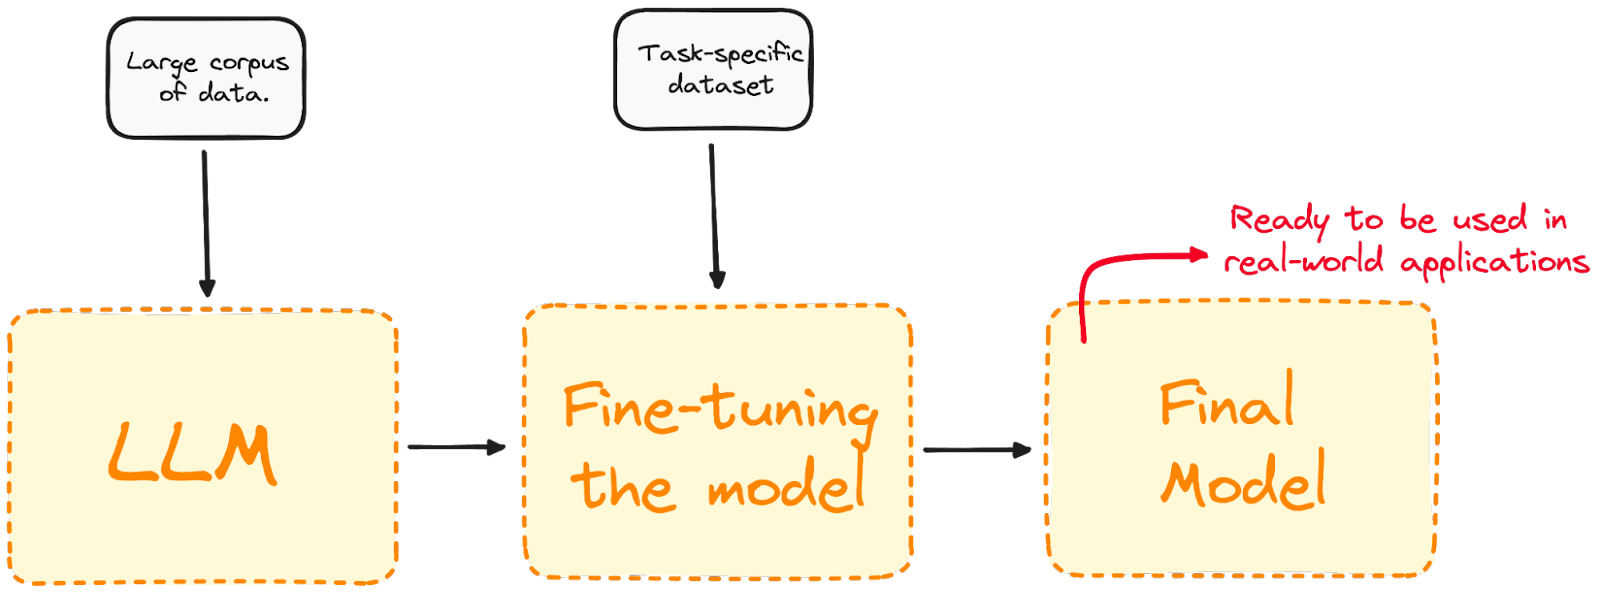 Visualisierung des Fine-Tuning-Prozesses. [DataCamp]
Transfer Learning ist eine gängige Technik für viele Data-Science-Aufgaben, unter anderem in der Computer Vision und im Natural Language Processing.
Computer Vision ist eines der Gebiete, in denen Transfer Learning besonders erfolgreich ist. Neuronale Netze in diesem Bereich benötigen enorme Datenmengen für Aufgaben wie Objekterkennung und Bildklassifikation.
In der Computer Vision erkennen die ersten Schichten eines Netzes Kanten in Bildern, die mittleren Schichten identifizieren Formen und Strukturen. Die letzten Schichten werden auf die spezifische Aufgabe zugeschnitten. Transfer Learning ermöglicht es, neue Modelle zu erstellen, indem nur die letzten Schichten neu trainiert und die Gewichte und Biases der ersten und mittleren Schichten beibehalten werden. Dank Transfer Learning lassen sich neue Modelle also bauen, die lediglich die letzten Netzwerkschichten neu trainieren, während die früheren und mittleren Schichten unverändert bleiben.
Heute gibt es eine ganze Reihe vortrainierter, öffentlich verfügbarer Netze für Computer Vision, zum Beispiel:
NLP ist ein Bereich der KI, der die Interaktion zwischen Computern und Menschen in natürlicher Sprache in den Fokus stellt. Ziel ist es, Computer so zu programmieren, dass sie große Mengen an Sprachdaten – als Text oder Audio – verarbeiten und analysieren.
Transfer Learning spielt bei der Entwicklung von NLP-Modellen eine zentrale Rolle. Vortrainierte Sprachmodelle, die für allgemeines Sprachverständnis oder Übersetzung trainiert wurden, lassen sich für spezifische NLP-Probleme wie Sentimentanalyse oder maschinelle Übersetzung feinabstimmen. Anwendungen von NLP sind praktisch endlos und reichen von Sprachassistenten bis zur Spracherkennung.
Transfer Learning steckt hinter einigen der bekanntesten NLP-Modelle, darunter:
Im Kern ist Transfer Learning ein Designansatz zur Steigerung der Effizienz. Anstatt Modelle von Grund auf neu zu trainieren – was gerade bei modernsten generativen KI-Modellen enorme Ressourcen, Geld und Zeit erfordert – ermöglicht Transfer Learning schnelleres und wirksameres Lernen für neue Aufgaben, indem vorhandenes Wissen genutzt wird.
Transfer Learning spielt seine Stärken aus, wenn nur wenig Daten für die zweite Aufgabe vorhanden sind. Durch das Wissen eines vortrainierten Modells lassen sich Overfitting vermeiden und die Genauigkeit insgesamt erhöhen. Dennoch ist Transfer Learning kein Allheilmittel und hat Grenzen sowie Fallstricke, die man sorgfältig adressieren muss. Zu den häufigsten Herausforderungen zählen:
Transfer Learning ist ein entscheidender Designansatz, um Effizienz und Potenzial neuronaler Netze zu steigern. Man kann mit Recht sagen, dass die aktuelle KI-Revolution ohne die vielen Techniken des Transfer Learnings nicht möglich gewesen wäre.
Wenn du tiefer in die Details von Transfer Learning einsteigen willst, ist DataCamp für dich da. Starte heute mit unseren Materialien zu LLMs und neuronalen Netzen.
Lerne mit DataCamp
Kurs
Kurs
Kurs