

什么是 Adam 优化器?简要回答
Adam(Adaptive Moment Estimation)是一种在机器学习中、尤其是深度学习中常用的优化算法。
Adam 融合了另外两种稳健优化技术的核心思想:动量(momentum)与 RMSprop。它之所以被称为自适应,是因为它会为每个参数调整学习率。
其关键特性与优势包括:
- 自适应性:Adam 会为每个参数自适应调整学习率,在许多情况下可加速学习。
- 动量:利用类似动量的机制,更有效地穿越如沟谷与鞍点等复杂地形。
- 偏置校正:包含偏置校正项,即便在训练初期也能有良好表现。
- 计算效率:相对计算高效且内存占用低。
- 超参数鲁棒性:虽然学习率可能需要调参,但 Adam 往往对超参数更不敏感。
总之,Adam 通过持续为每个参数调整学习率,使模型学习更高效,因此通常比标准随机梯度下降收敛更快。对许多深度学习任务而言,因此是一个很强的默认选择。
前置算法
Adam 将若干关键优化算法的核心思想统一起来,强化其优点并弥补其不足。要理解 Adam 的直觉并在 Python 中实现它,我们需要先回顾这些算法。
优化的类比
为理解这些优化算法背后的直觉,我们延续引言中的类比。
想象您被蒙上眼,置身复杂的丘陵地带。您的任务是找到这片地形的最低点。地形的起伏代表机器学习模型的损失函数。全局的“最低点”(全局最小值)就是系统的最优解。
现在,将一些点连起来看:您在地形中的当前位置对应于模型参数的当前状态。任意点的高度对应这些参数下的损失值。您导航的方式在数学上对应于对模型参数的调整。
每一种优化算法就像是一种成功穿越这片地貌的策略,指导求解器下一步往哪里走、步子多大。有的算法在决定下一步之前扫描整个区域,而有的算法为了更快,只依赖有限信息。
还有的算法会使用动量与步长自适应等工具;一个优秀的求解器知道何时应该加力前行,何时该放缓。
梯度下降
梯度下降是机器学习优化的“圣杯”,因为许多算法都以此为基础构建。
使用梯度下降(GD)时,您在每迈出一步之前,会仔细感知您周围的整个区域(使用全量数据)。这种全面的考察让您能非常准确地判断下坡的方向,但也很耗时。您总是沿着最陡的下降方向移动,这意味着会持续走向低处。然而,如果您到达了一个小洼地(局部最小值),可能会被困在那里,无法察觉别处还有更低的点。
GD 的要点:
- 每一步都使用整个数据集
- 一致性好,但可能很慢
- 可能陷入局部最小值
随机梯度下降(SGD)
在这个场景中,您很匆忙,没时间感知周围的全部区域。相反,您只检查脚边的一个随机点(一个数据点)。这让每一步更快,但也更不精确。您也可以检查一小批点,这就是小批量梯度下降,我们后面会讲。
与梯度下降相比,您的路径更不稳定;有时看起来像醉汉的步伐。您偶尔甚至会往上走。这条带噪的路径反而可能是最大优势:您很可能能逃离局部最小值。
但当接近低点时,您需要迈更小的步子(降低学习率),以避免越过最低点。
SGD 的要点:
- 每一步只使用一个随机数据点
- 迭代更快,但路径更嘈杂
- 更容易逃离局部最小值
- 学习率通常需要随时间降低
注意:此时强烈建议阅读我们的 GD 与 SGD 的独立文章,其中更深入地讲解了这两个关键算法,也有助于您更清晰地理解后续的代码部分。
带动量的 SGD
现在,您站在丘陵间的滑板上。一旦朝某个方向发力,滑板的动量会让您在该方向上继续前进一段时间。
这种动量就像是对过去方向的移动平均。它帮助您跨越小的凸起和局部凹陷,甚至可能帮助您找到更远处更低的位置。
如果您在某个方向上移动了一段时间,动量会积累,速度也会更快。这样,尤其在整体向下的平滑区域中,您能更快地收敛到最低点。
带动量的 SGD 要点:
- 累积过去梯度的移动平均
- 有助于跨越局部的小幅波动
- 可带来更快的收敛
RMSprop(均方根传播)
想象您有一双高科技的鞋子,能根据脚下地形自动调整抓地力。这双鞋记录各个方向上的地面梯度,并保留平方梯度的指数衰减平均。在坡度变化很大的区域,鞋子提供更强的抓地力,让您迈出更小、更谨慎的步子;在坡度平缓、方向一致的区域,鞋子允许您迈更大的步子。
这种自适应“步长”帮助您同时有效应对陡坡与缓坡,避免在陡峭区域步子过大或在平坦区域步子过小。
RMSprop 的要点:
- 为每个参数自适应调整学习率
- 用平方梯度的指数衰减平均来缩放学习率
- 帮助在不同陡峭程度的区域中导航
Adam 优化器的直觉
Adam 好比把您的滑板(动量)和自适应鞋子(RMSprop)合二为一,并再配上一套智能导航系统。
滑板部分(动量)让您保持在正确的大致方向上。这意味着在下坡、平滑且一致的区域,Adam 让您快速前进;在复杂多变的地形中,它帮助您保持稳健但谨慎的步伐。
自适应鞋(RMSprop)感知您的行进方向并调整滑板的抓地力。Adam 中的智能导航系统(偏置校正)在旅程的起点尤为重要,因为您从一个随机点出发,对地形几乎一无所知。
这种组合让 Adam 往往能以非常高效的方式找到最低点(问题的解),并且其结构能够很好地适应不同类型的地形(不同类型的机器学习问题)。
Adam 的要点:
- 结合了动量与 RMSprop 的思想
- 维护过去梯度与过去平方梯度的指数衰减平均
- 为每个参数自适应调整学习率
- 对初始步骤进行偏置校正
如您所见,上述每种算法都在前一者的基础上构建,旨在通过应对不同类型优化问题中的挑战,来改进寻找最低点的过程。
Adam 与其他优化算法的比较
在介绍 Adam 与其它算法的实现细节之前,先给出一个在某个回归问题上的运行时间与 RMSE 表现的对比汇总表:
import pandas as pd
# Disable scientific notation
pd.set_option("display.float_format", "{:.4f}".format)
comparison_table = pd.read_csv('optimization_results.csv')
comparison_table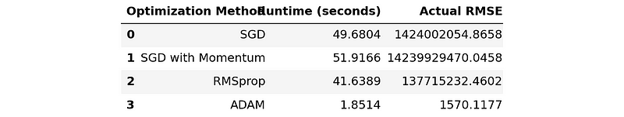
这张表还不足以体现 Adam 与其他算法的巨大差异,因此我们再画一张柱状图:
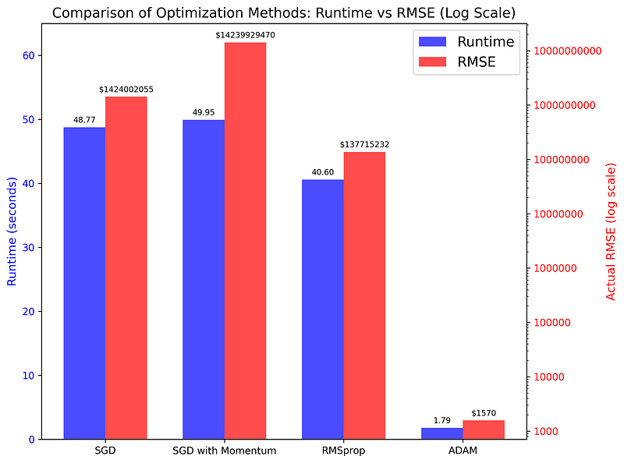
该图比较了四种算法在一个简单回归任务上的运行时间与 RMSE 分数。正如您所见,差异非常惊人(请注意右侧坐标轴为对数刻度),这表明在大多数优化任务中,Adam 往往是更优的选择。
我们稍后会查看生成该表格与图表的代码。
在 Python 中实现 Adam 优化器
现在我们已经了解了 Adam 的前置概念及其直觉,可以开始用 Python 实现它们。过程中我们将解释理解实现所需的数学内容。我们将从随机梯度下降开始,逐步构建代码。
实现带小批量的 SGD
前文提到,SGD 只用单个数据点来决定下一步往哪走。实践中,这种最原始版本很少使用,因为结果可能很嘈杂(在山坡上的路径很不稳)。
为缓解这一点,专业人士常用一种变体——小批量梯度下降(Mini-Batch Gradient Descent),每次使用如 32、64 或 128 个数据点再迈步(这就像在迈步前扫描一条较窄的路径,而不是 360 度全方位)。
因此,我们将以这种 SGD 变体为基础,构建 Adam 的底层代码。
为尽可能简化代码,我们选择一个小型回归问题:根据克拉数预测钻石价格。
首先导入必要的库:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)接下来,从 Seaborn 加载 Diamonds 数据集,抽样并构建特征与目标数组:
# Load the data
dataset_size = 20_000
diamonds = sns.load_dataset("diamonds")
# Extract the target and the feature
xy = diamonds[["carat", "price"]].values
np.random.shuffle(xy) # Shuffle the data
xy = xy[:dataset_size]
xy.shapeOutput:
(20000, 2)线性回归需要我们对数据进行标准化:
# Normalize the data
mean = np.mean(xy, axis=0)
std = np.std(xy, axis=0)
xy_normalized = (xy - mean) / std现在,我们可以划分训练集与测试集:
# Split the data
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape(16000, 2)为解决该任务,我们可选的模型很多,但为保持简单,我们选择简单线性回归,并将其定义为函数:
def model(m, x, b):
"""
Simple Linear Regression: f(x) = m * x + b, where
- x: diamond carat
- m: price increase per carat
- b: base diamond price
- f(x): predicted diamond price
"""
return m * x + b我们的线性回归模型只有两个参数,m 和 b,因此 SGD(以及之后的 Adam)的任务就是为它们找到最优值。
我们还应定义要最小化的损失函数——均方误差(MSE):
def mean_squared_error(y_true, y_pred):
"""
MSE as a loss function. It is defined as:
Loss = (1/n) * Σ((y - f(x))²), where:
- n: the length of the dataset
- y: the true diamond price
- f(x): predicted diamond price, i.e. m*x + b
"""
return np.mean((y_true - y_pred) ** 2)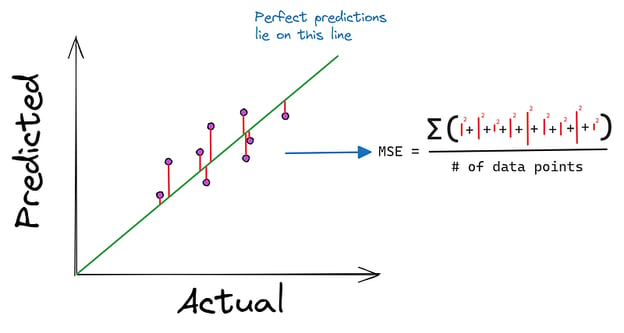
现在,我们定义一个名为 stochastic_gradient_descent 的函数,它接收六个参数:
x与y表示本问题中的单个特征和目标。epochs表示我们想进行多少次下降(后文详述)。learning_rate为步长。batch_size用于控制参数更新的频率stopping_threshold设置每一步损失应下降的最小值
def stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.inf在函数内部,我们首先用随机值初始化需要优化的参数(相当于从山坡上的随机位置出发)。同时将初始损失设为无穷大,表示问题尚未求解。
随后,我们启动一个运行 epochs 次的 for 循环。在循环内,我们打乱数据,以防止学习到依赖顺序的模式:
def stochastic_gradient_descent(...):
...
for i in range(epochs):
# Shuffle the data
indices = np.random.permutation(n)
x = x[indices]
y = y[indices]然后,我们开启另一个由 batch_size 控制的循环,并提取当前批次:
def stochastic_gradient_descent(...):
...
for i in range(epochs):
...
for j in range(0, n, batch_size):
# Extract the current batch
x_batch = x[j:j + batch_size]
y_batch = y[j:j + batch_size]在这个内层循环中,我们为两个参数计算梯度(偏导),指示下一步应往哪里走:
def stochastic_gradient_descent(...):
...
for i in range(epochs):
...
for j in range(0, n, batch_size):
# Extract the current batch
...
# Make predictions with current m, b
y_pred = model(m, x_batch, b)
# Compute the gradients
m_gradient = 2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = 2 * np.mean(y_batch - y_pred)计算出梯度后,有一个关键步骤是对梯度进行裁剪:
def stochastic_gradient_descent(...):
...
for i in range(epochs):
...
for j in range(0, n, batch_size):
# Extract the current batch
...
# Compute the gradients
...
# Gradient clipping
clip_value = 1.0
m_gradient = np.clip(m_gradient, -clip_value, clip_value)
b_gradient = np.clip(b_gradient, -clip_value, clip_value)梯度爆炸是常见问题,梯度裁剪可以防止梯度幅度趋向无穷大。
裁剪后,我们用学习率更新参数(沿梯度方向迈步,步长由学习率控制):
def stochastic_gradient_descent(...):
...
for i in range(epochs):
...
for j in range(0, n, batch_size):
# Extract the current batch
...
# Compute the gradients
...
# Gradient clipping
...
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradient随后,在外层循环下方(所有批次都处理完后),我们计算当前 epoch 的损失(看看从初始位置下降了多少):
def stochastic_gradient_descent(...):
...
for i in range(epochs):
...
for j in range(0, n, batch_size):
# Extract the current batch
...
# Compute the gradients
...
# Gradient clipping
...
# Update the model parameters
...
# Compute the epoch loss
y_pred = model(m, x, b)
current_loss = loss(y, y_pred)如果该 epoch 的损失小于 stopping_threshold,则停止整个过程:
def stochastic_gradient_descent(...):
...
for i in range(epochs):
...
for j in range(0, n, batch_size):
# Extract the current batch
...
# Compute the gradients
...
# Gradient clipping
...
# Update the model parameters
...
# Compute the epoch loss
...
# Check against the stopping threshold
if abs(previous_loss - current_loss) < stopping_threshold:
break
previous_loss = current_loss最后(当 epoch 用尽或达到停止阈值后),返回已优化的 m 与 b:
def stochastic_gradient_descent(...):
...
for i in range(epochs):
...
for j in range(0, n, batch_size):
# Extract the current batch
...
# Compute the gradients
...
# Gradient clipping
...
# Update the model parameters
...
# Compute the epoch loss
...
# Check against the stopping threshold
...
return m, b带动量的 SGD
现在,让我们为 SGD 添加 momentum。这一版本的代码与小批量版本并无太大差异。
我们定义一个带有 momentum 参数的新函数:
def stochastic_gradient_descent_with_momentum(
x, y, epochs=100, learning_rate=0.01, batch_size=32,
stopping_threshold=1e-6, momentum=0.9
):
"""
SGD with momentum and support for mini-batches.
"""
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
# Initialize velocity terms
v_m = 0
v_b = 0
n = len(x)
previous_loss = np.inf在函数中,我们将定义两个额外变量 v_m 与 v_b,用于跟踪充当动量的累积梯度。起初我们将它们设为 0,因为算法开始时并没有动量。
接着,其余代码与前文相同,直到梯度裁剪之后:
def sgd_with_momentum(...):
...
for i in range(epochs):
...
for j in range(0, n, batch_size):
# Extract the current batch
...
# Compute the gradients
...
# Gradient clipping
...
# Update velocity terms
v_m = momentum * v_m + learning_rate * m_gradient
v_b = momentum * v_b + learning_rate * b_gradient
# Update the model parameters using velocity
m -= v_m
b -= v_b在梯度裁剪后,我们用动量的更新规则来更新速度项。下面是更高层次的代码视图:
# Initialize
v_m = 0
v_b = 0
...
# Update velocity terms
v_m = momentum * v_m + learning_rate * m_gradient
v_b = momentum * v_b + learning_rate * b_gradient
# Update the model parameters using velocity
m -= v_m
b -= v_b速度项 v_* 会随时间累积梯度。这意味着如果我们持续朝一个方向移动,就会在该方向上加速。
在梯度变化迅速的区域(例如损失景观中的狭窄山谷),动量有助于抑制振荡。我们会形成足够的惯性,使其不至于被局部最小值或鞍点等小的局部波动困住。
其中 momentum * v_m 负责累积梯度。例如,如果我们有一个较大的正梯度,其速度也会相应较大,对参数的更新也会更大。因此,动量为 0.9 意味着在下一步中会保留前一次变化速度的 90%。在第 N 步,我们会使用来自前 N-1 步梯度总速度的 90%。
此时,建议您自行设定一些随机的 m、b 及其梯度的数值,并用动量的更新规则,看看在上坡或下坡时参数如何变化。
RMSprop
现在来看 RMSprop 的实现。与带动量的 SGD 类似,主要变化发生在参数更新处。
首先,我们定义一个含有两个额外参数 beta 与 epsilon(不含动量)的新函数:
def rmsprop_optimization(
x, y, epochs=100, learning_rate=0.01, batch_size=32,
stopping_threshold=1e-6, beta=0.9, epsilon=1e-8,
):
"""
RMSprop optimization with support for mini-batches.
"""
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
# Initialize accumulators for squared gradients
s_m = 0
s_b = 0
n = len(x)
previous_loss = np.inf此外,在函数内部我们创建两个新变量用于累积平方梯度: s_m 与 s_b。
到更新阶段时,我们会重计算平方梯度,然后更新参数:
def rmsprop_optimization(...):
...
for i in range(epochs):
...
for j in range(0, n, batch_size):
# Extract the current batch
...
# Compute the gradients
...
# RMSprop doesn't need gradient clipping
# Update accumulators
s_m = beta * s_m + (1 - beta) * (m_gradient**2)
s_b = beta * s_b + (1 - beta) * (b_gradient**2)
# Update parameters
m -= learning_rate * m_gradient / (np.sqrt(s_m) + epsilon)
b -= learning_rate * b_gradient / (np.sqrt(s_b) + epsilon)
# The rest of the code is the same这里有两个新参数:
epsilon是一个很小的值,通常为 1e-8,用来在更新时防止除零。beta是衰减率参数,通常约为 0.9。
参数 beta 控制我们考虑多少历史信息。更高的 beta 意味着对过去梯度采取更长期的视角;更低的 beta 则让算法对近期梯度更敏感。
您无需担心 RMSprop 更新规则背后的数学。重要的是其背后的逻辑。
上述四行代码本质上在做三件事:
- 为每个参数自适应调整学习率,这非常关键,因为不同参数可能需要不同的学习率。
- 处理神经网络中常见的“梯度消失”问题,即由于反向传播导致梯度过小。通过对梯度进行归一化,这一效应得到缓解。
- 平衡步长:
- 对于梯度较大的参数(频繁更新),分母中的平方梯度和会更大,从而降低有效学习率。
- 对于梯度较小的参数(更新不频繁),分母会更小,从而提高有效学习率。
实践中,RMSprop 往往比基础的 SGD 或带动量的 SGD 表现更好,尤其在深度学习中常见的非凸优化问题上。
最终实现:Python 中的 Adam
我们再次定义一个新函数:
def adam_optimization(
x,
y,
epochs=100,
learning_rate=0.001,
batch_size=32,
stopping_threshold=1e-6,
beta1=0.9,
beta2=0.999,
epsilon=1e-8,
):
"""
Adam optimization with support for mini-batches.
"""
# Initialize the model parameters
m = np.random.randn()
b = np.random.randn()
# Initialize first and second moment vectors
m_m, v_m = 0, 0
m_b, v_b = 0, 0
n = len(x)
previous_loss = np.inf
t = 0 # Initialize timestep这一次,我们定义五个新变量,用于捕捉一阶与二阶矩向量以及时间步。在 Adam 的语境中:
1. 一阶矩向量(m):
- 是对梯度均值(一阶矩)的估计。
- 以过去梯度的指数衰减平均计算。
- 有助于估计梯度方向。
2. 二阶矩向量(v):
- 是对梯度非中心方差(二阶矩)的估计。
- 同样以指数衰减平均计算,但对象是平方梯度。
- 有助于为每个参数自适应调整学习率。
之后,代码仍与之前相同,直到我们计算出梯度为止(Adam 不需要裁剪梯度):
def adam_optimization(...):
...
for i in range(epochs):
...
for j in range(0, n, batch_size):
# Extract the current batch
...
# Compute the gradients
...
# Adam doesn't need gradient clipping
# Update biased first moment estimate
m_m = beta1 * m_m + (1 - beta1) * m_gradient
m_b = beta1 * m_b + (1 - beta1) * b_gradient
# Update biased second raw moment estimate
v_m = beta2 * v_m + (1 - beta2) * (m_gradient**2)
v_b = beta2 * v_b + (1 - beta2) * (b_gradient**2)
# Compute bias-corrected first moment estimate
m_m_hat = m_m / (1 - beta1**t)
m_b_hat = m_b / (1 - beta1**t)
# Compute bias-corrected second raw moment estimate
v_m_hat = v_m / (1 - beta2**t)
v_b_hat = v_b / (1 - beta2**t)
# Update parameters
m -= learning_rate * m_m_hat / (np.sqrt(v_m_hat) + epsilon)
b -= learning_rate * m_b_hat / (np.sqrt(v_b_hat) + epsilon)
# The rest of the code is the same同样,不必为这些代码行背后的数学担心。实践中您几乎不会从零实现 Adam;了解其更新规则背后的直觉就足够了。
一阶矩类似动量,会累积过去的梯度,为优化带来方向感与“速度”。这帮助 Adam 在方向一致的区域更快移动,并在带噪的梯度景观中抑制振荡。
二阶矩则像 RMSprop 那样,为每个参数自适应地调整学习率。它相当于对参数更新做归一化:对于梯度大的参数减慢学习,对于梯度小的参数加快学习,使 Adam 能有效处理不同尺度的参数。
Adam 还对这些移动平均进行偏置校正,尤其在训练早期非常重要。该校正确保 Adam 一开始就能采用更准确的步长,从而可能带来更快的初期进展。
通过结合这些要素,Adam 往往比更简单的优化方法收敛更快。它在梯度带噪、目标非静态或数据集很大的问题上尤其有效。Adam 的自适应特性使其对初始学习率较不敏感,通常比其他方法需要更少的超参数调优。
创建优化器对比表
现在,让我们看看如何生成前面看到的汇总表:
comparison_table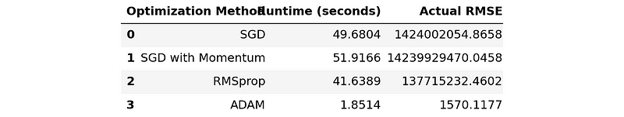
我们定义一个名为 run_optimization 的函数,用于借助我们的优化函数训练线性回归模型。该函数还会记录运行时间与 RMSE 分数:
import time
def run_optimization(opt_func, x, y, **kwargs):
# Start a timer
start_time = time.time()
# Run the optimization function
m, b = opt_func(x, y, **kwargs)
# End the timer
end_time = time.time()
# Run the model on the test set with found parameters
y_preds = model(m, test_xy[:, 0], b)
y_preds_denormalized = y_preds * std[1] + mean[1]
y_true_denormalized = test_xy[:, 1] * std[1] + mean[1]
# Compute MSE and RMSE
actual_mse = np.mean((y_true_denormalized - y_preds_denormalized) ** 2)
return end_time - start_time, np.sqrt(actual_mse)接下来,我们针对四个优化函数分别调用一次该函数,并将结果存入列表中。每个条目是一个三元组(算法名、运行时间(秒)、RMSE 分数):
# Run all optimization methods
results = []
results.append(
(
"SGD",
*run_optimization(
stochastic_gradient_descent,
train_xy[:, 0],
train_xy[:, 1],
learning_rate=0.1,
epochs=10000,
batch_size=64,
),
)
)
results.append(
(
"SGD with Momentum",
*run_optimization(
stochastic_gradient_descent_with_momentum,
train_xy[:, 0],
train_xy[:, 1],
learning_rate=0.1,
epochs=10000,
batch_size=64,
momentum=0.9,
),
)
)
results.append(
(
"RMSprop",
*run_optimization(
rmsprop_optimization,
train_xy[:, 0],
train_xy[:, 1],
learning_rate=0.01,
epochs=10000,
batch_size=64,
beta=0.9,
epsilon=1e-8,
),
)
)
results.append(
(
"Adam",
*run_optimization(
adam_optimization,
train_xy[:, 0],
train_xy[:, 1],
learning_rate=0.01,
epochs=10000,
batch_size=64,
beta1=0.9,
beta2=0.999,
epsilon=1e-8,
),
)
)为公平比较,我们保持学习率、epoch 数与批大小一致。
然后,我们可以创建表格:
from tabulate import tabulate # pip install tabulate
# Create and print the table
headers = ["Optimization Method", "Runtime (seconds)", "Actual RMSE"]
print(tabulate(results, headers=headers, floatfmt=".4f"))
# Save the table
pd.DataFrame(results, columns=headers).to_csv("optimization_results.csv", index=False)最终结果如下:
Optimization Method Runtime (seconds) Actual RMSE
--------------------- ------------------- ----------------
SGD 49.9305 1424002054.8658
SGD with Momentum 50.7744 14239929470.0458
RMSprop 41.9895 137715232.4602
Adam 1.8462 1570.1177继续之前,鼓励您尝试调整每个优化函数的参数。通过调整学习率、增大批大小或控制偏置,您很可能让它们——尤其是 Adam——更快更准。
完整对比脚本与开篇图表的绘制方式请见结论部分的链接。
在 PyTorch 中使用 Adam
在实践中使用 Adam,无需先读完这样一篇长文并从零实现。其在 PyTorch 中的实现已足以应对任何监督学习的深度学习任务。
下面是一段简短、精炼的示例代码,勾勒出使用 Adam(来自 torch.optim 模块)的典型 PyTorch 工作流:
# Import necessary modules
import torch
import torch.nn as nn
import torch.optim as optim
# Define your model
model = nn.Sequential(
nn.Linear(10, 50),
nn.ReLU(),
nn.Linear(50, 1)
)
# Initialize Adam optimizer
optimizer = optim.Adam(model.parameters(), lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0)
# Training loop
for epoch in range(num_epochs):
for batch in dataloader:
# Zero the gradients
optimizer.zero_grad()
# Forward pass
outputs = model(batch)
loss = criterion(outputs, targets)
# Backward pass
loss.backward()
# Update weights
optimizer.step()
# Adjusting learning rate
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=30, gamma=0.1)
for epoch in range(num_epochs):
train(...)
scheduler.step()如欲进一步了解 PyTorch 及其优化算法,请查看 DataCamp 的入门课程:
结论
本文系统讲解了广受欢迎的 Adam 优化器。我们先从其直觉入手,通过讨论梯度下降、SGD 与 RMSprop 等基础算法,看到 Adam 如何将这些思想融合,形成一个高度灵活且性能优异的算法。
随后,我们仅用 NumPy 演示了如何在 Python 中实现 Adam。与其直觉一样,我们从基础算法逐步构建代码:从小批量梯度下降到 RMSprop,再到 Adam。通过一个简单的基准脚本,我们也见证了 Adam 与其他算法在速度与性能上的巨大差异。
最后,我们展示了如何在 PyTorch 中像实际使用那样调用 Adam 解决深度学习问题。以下是教程中使用到的脚本链接:
以及一些与 PyTorch 及其优化函数相关的学习资源:
- PyTorch 教程:从零构建一个简单的神经网络
- Deep Learning in Python 学习路径
- Intermediate Deep Learning in PyTorch 课程
- Deep Learning For Images With PyTorch 课程
感谢阅读!

我是一名数据科学内容创作者,拥有超过 2 年的经验,并在 Medium 上拥有较大的读者群。我喜欢用略带讽刺的笔调撰写有关 AI 和机器学习的深度文章——毕竟总得想点办法让这些内容不那么枯燥。我已发表 130 多篇文章,并制作了一门 DataCamp 课程,另有一门正在筹备中。我的内容已被超过 500 万人次阅读,其中有 2 万人在 Medium 和 LinkedIn 上成为关注者。
您是否试过在蒙着眼的情况下穿越丘陵地带?这和机器学习模型在尝试改进时所做的事情有点类似。它们不断寻找最低点(最佳解),却看不到全貌。这正是优化算法大显身手的地方,而 Adam 则像是在这段旅程中配备了一支聪明的手电筒。
Adam,全称 Adaptive Moment Estimation(自适应矩估计),是一种广受欢迎的优化技术,尤其在深度学习中。在本文中,您将看到为什么如此。我们将介绍其背后的直觉,适度涉及一些数学(别担心,我们会讲得友好易懂),并演示其 Python 实现以及在 PyTorch 中的用法。