
Last chance! 50% off DataCamp Premium
Sale ends in
Adam, wat staat voor Adaptive Moment Estimation, is een populair optimalisatie-algoritme dat wordt gebruikt in machine learning en, het vaakst, in deep learning.
Adam combineert de belangrijkste ideeën uit twee andere robuuste optimalisatietechnieken: momentum en RMSprop. Het heet adaptief omdat het het leerritme voor elke parameter aanpast.
Hier zijn de belangrijkste kenmerken en voordelen:
Kort samengevat laat Adam modellen efficiënter leren door continu het leerritme van elke parameter aan te passen en daardoor vaak veel sneller te convergeren dan standaard stochastic gradient descent. Voor veel deep-learningtoepassingen is het daarom een sterke standaardkeuze.
Adam verenigt kernideeën uit een paar andere cruciale optimalisatie-algoritmen, waarbij het hun voordelen versterkt en hun tekortkomingen aanpakt. We moeten die eerst bekijken voordat we de intuïtie achter Adam begrijpen en het in Python implementeren.
Om de intuïtie achter deze optimalisatie-algoritmen te begrijpen, gaan we verder met onze analogie uit de inleiding.
Stel je voor dat je geblinddoekt bent in een ingewikkeld, heuvelachtig gebied. Je moet het laagste punt in dit terrein vinden. De heuvelachtigheid van het terrein staat voor de verliesfunctie van een machinelearningmodel. Het algehele “laagste” (globale minimum) punt is de optimale oplossing van het systeem.
Laten we nu wat verbanden leggen: je huidige positie in het terrein stelt de huidige staat van de modelparameters voor. De hoogte op elk punt staat voor de verlieswaarde voor die parameters. De manier waarop je navigeert komt overeen met het aanpassen van de modelparameters in wiskundige zin.
Elk optimalisatie-algoritme is als een strategie om het landschap van dit probleem succesvol te doorkruisen, en leidt de oplosser naar waar de volgende stap moet zijn en hoe groot die moet zijn. Sommige algoritmen scannen het hele gebied voordat ze de volgende stap bepalen, terwijl andere voor snelheid op beperkte informatie vertrouwen.
Weer andere algoritmen gebruiken hulpmiddelen zoals momentum en aanpassing van stapgrootte; een goede oplosser weet wanneer hij moet doorzetten en wanneer hij gas terug moet nemen.
Gradient descent is de heilige graal van optimalisatie in machine learning, omdat het de basis legt waarop veel algoritmen voortbouwen.
Gebruik je Gradient Descent (GD), dan voel je zorgvuldig het hele gebied om je heen (met de volledige dataset) voordat je elke stap zet. Deze grondige inspectie stelt je in staat zeer nauwkeurig te bepalen welke kant bergaf is, maar kost veel tijd. Je beweegt altijd in de richting van de steilste afdaling, wat betekent dat je consequent naar lager terrein gaat. Maar als je een kleine kuil bereikt (het lokale minimum), kun je daar vast komen te zitten, zonder te merken dat er elders een nog lager punt is.
Belangrijke kenmerken van GD:
In dit scenario heb je haast en geen tijd om het volledige gebied te verkennen. In plaats daarvan controleer je slechts één willekeurig punt dicht bij je voeten (één datapunt). Dit maakt elke stap sneller maar minder nauwkeurig. Je kunt ook een kleine batch punten bekijken, bekend als mini-batch gradient descent, waar we verderop op ingaan.
Je pad is grilliger dan dat van gradient descent; het lijkt soms zelfs op het pad van een dronken zeeman. Je kunt af en toe bergop gaan. Dit “ruisige” pad kan juist het grootste voordeel zijn: je ontsnapt waarschijnlijker uit lokale minima.
Maar naarmate je dichter bij de bodem komt, moet je kleinere stappen nemen (het leerritme verlagen) om te voorkomen dat je over het laagste punt heen schiet.
Belangrijke kenmerken van SGD:
Opmerking: Op dit punt raad ik je ten zeerste aan ons aparte artikel over GD en SGD te lezen, omdat dit de details van deze twee cruciale algoritmen veel uitgebreider behandelt. Het helpt je ook om de komende code-sectie duidelijker te begrijpen.
Je staat nu op een skateboard tussen de heuvels. Wanneer je in een richting afzet, houdt het momentum van het skateboard je een tijdje min of meer in dezelfde richting in beweging.
Dit momentum is als een voortschrijdend gemiddelde van je eerdere richtingen. Het helpt je kleine hobbels en lokale kuilen te passeren, en misschien zelfs een punt verderop te vinden dat lager ligt.
Als je een tijdje in een richting hebt bewogen, bouwt het momentum op en ga je sneller. Zo kun je sneller naar het laagste punt convergeren, vooral in terreinen met een consistente neerwaartse helling.
Belangrijke kenmerken van SGD met momentum:
Denk aan hightech schoenen die hun grip kunnen aanpassen aan het terrein waar je op loopt. Deze schoenen volgen de gradiënt van de grond in elke richting en houden een exponentieel afnemend gemiddelde van gekwadrateerde gradiënten bij. In gebieden waar de helling veel verandert, geven de schoenen je meer grip, zodat je kleinere, voorzichtige stappen neemt. In gladdere gebieden met consistente hellingen geven de schoenen je langere passen.
Deze adaptieve “stapgrootte” helpt je zowel steile als vlakke hellingen effectief te navigeren, zodat je niet te grote stappen neemt in steile gebieden of te kleine in vlakke gebieden.
Belangrijke kenmerken van RMSprop:
Adam is alsof je je skateboard (momentum) combineert met je adaptieve schoenen (RMSprop) en daar een slim navigatiesysteem aan toevoegt.
Het skateboardgedeelte (momentum) houdt je in de juiste algemene richting. Dat betekent dat Adam je in dalende, gladde en consistente regio’s snel laat bewegen. In lastige, variabele terreinen helpt het je een gestaag maar voorzichtig tempo aan te houden.
De adaptieve schoenen (RMSprop) voelen waar je heen gaat en passen de grip van het skateboard aan. Het slimme navigatiesysteem (bias-correctie) in Adam is vooral belangrijk aan het begin van je tocht, waar je vanaf een willekeurig punt start en nog weinig over het terrein weet.
Deze combinatie van eigenschappen is waarom Adam vaak zeer efficiënt het laagste punt (de oplossing van het probleem) vindt en waarom de structuur verschillende soorten terrein (verschillende soorten machinelearningproblemen) goed aankan.
Belangrijke kenmerken van Adam:
Zoals je hebt gezien, bouwt elk van de genoemde algoritmen voort op de vorige, met als doel het proces van het vinden van het laagste punt te optimaliseren door verschillende uitdagingen aan te pakken die in diverse optimalisatieproblemen voorkomen.
Voordat we ingaan op de details van het implementeren van Adam en de andere genoemde algoritmen, deel ik een samenvattingstabel met je waarin de runtime- en RMSE-prestaties van elk algoritme op een voorbeeldregressieprobleem worden vergeleken:
import pandas as pd
# Disable scientific notation
pd.set_option("display.float_format", "{:.4f}".format)
comparison_table = pd.read_csv('optimization_results.csv')
comparison_table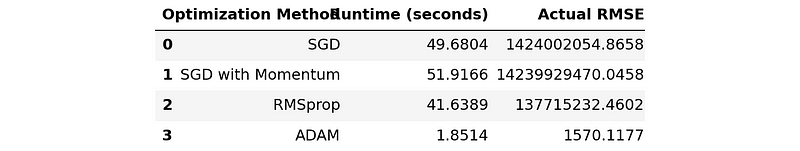
Deze tabel doet geen recht aan het enorme verschil tussen Adam en de rest, dus laat ik een staafdiagram maken:
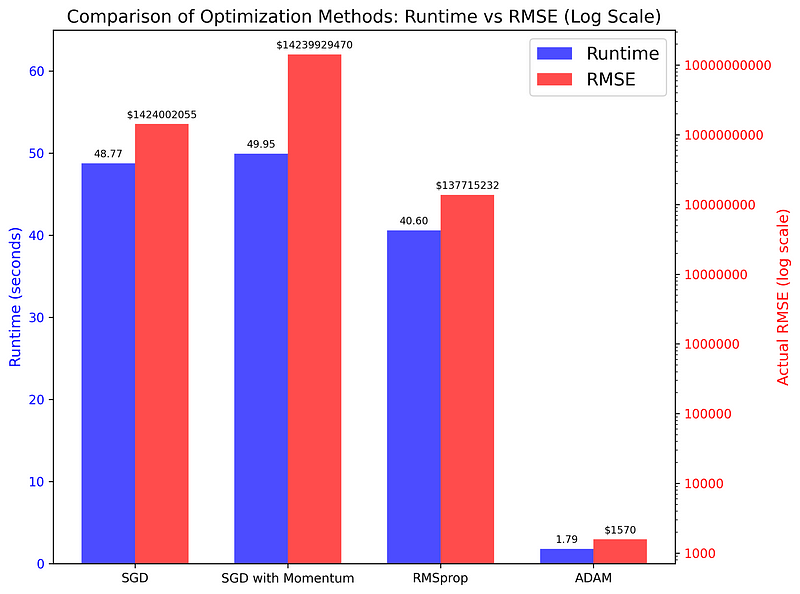
De grafiek vergelijkt de runtime en RMSE-scores van de vier algoritmen die zijn gebruikt op een eenvoudige regressietaak. Zoals je ziet zijn de verschillen enorm (onthoud, de as rechts is logaritmisch), wat aangeeft dat Adam in de meeste optimalisatietaken de betere keuze is.
We bekijken later de code die de tabel en de grafiek heeft gegenereerd.
Nu we de vereiste concepten voor Adam en de intuïtie erachter hebben behandeld, kunnen we beginnen met de implementatie in Python. Onderweg leggen we de benodigde wiskunde uit om de implementatie te begrijpen. We bouwen de code stap voor stap op, beginnend met Stochastic Gradient Descent.
Eerder noemden we dat SGD slechts één datapunt gebruikt om te bepalen waarnaartoe te bewegen. In de praktijk wordt deze “vanilla” versie van SGD zelden gebruikt omdat de resultaten ruisig kunnen zijn (het pad in de heuvels is grillig).
Om dit te beperken gebruiken professionals vaak een variant genaamd Mini-Batch Gradient Descent, die batches datapoints gebruikt, zoals 32, 64 of 128, voordat elke stap wordt gezet (dit is alsof je een smal pad scant in plaats van een 360-gradenblik voordat je een stap zet).
We bouwen de basiscode voor Adam op met deze versie van SGD.
Om de code zo eenvoudig mogelijk te houden, kiezen we een klein regressieprobleem: diamantprijzen voorspellen op basis van karaatmetingen.
Laten we eerst de benodigde libraries importeren:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Vervolgens laden we de Diamonds-dataset uit Seaborn, nemen we er een sample van en bouwen we de feature- en target-arrays:
# Load the data
dataset_size = 20_000
diamonds = sns.load_dataset("diamonds")
# Extract the target and the feature
xy = diamonds[["carat", "price"]].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
Output:
(20000, 2)Lineaire regressie vereist dat we de data normaliseren:
# Normalize the data
mean = np.mean(xy, axis=0)
std = np.std(xy, axis=0)
xy_normalized = (xy - mean) / std
Nu kunnen we de data splitsen om trainings- en testsets te maken:
# Split the data
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(16000, 2)Om de taak op te lossen hebben we een reeks modellen tot onze beschikking, maar om het simpel te houden kiezen we Simple Linear Regression en definiëren we die als een functie:
def model(m, x, b):
   """
   Simple Linear Regression: f(x) = m * x + b, where
   - x: diamond carat
   - m: price increase per carat
   - b: base diamond price
   - f(x): predicted diamond price
   """

   return m * x + b
Ons lineaire regressiemodel heeft slechts twee parameters, m en b, dus de taak voor SGD (en later voor Adam) is om optimale waarden voor hen te vinden.
We moeten ook de verliesfunctie definiëren, Mean Squared Error, die door onze algoritmen geminimaliseerd zal worden:
def mean_squared_error(y_true, y_pred):
   """
   MSE as a loss function. It is defined as:
   Loss = (1/n) * Σ((y - f(x))²), where:
   - n: the length of the dataset
   - y: the true diamond price
   - f(x): predicted diamond price, i.e. m*x + b
   """
   return np.mean((y_true - y_pred) ** 2)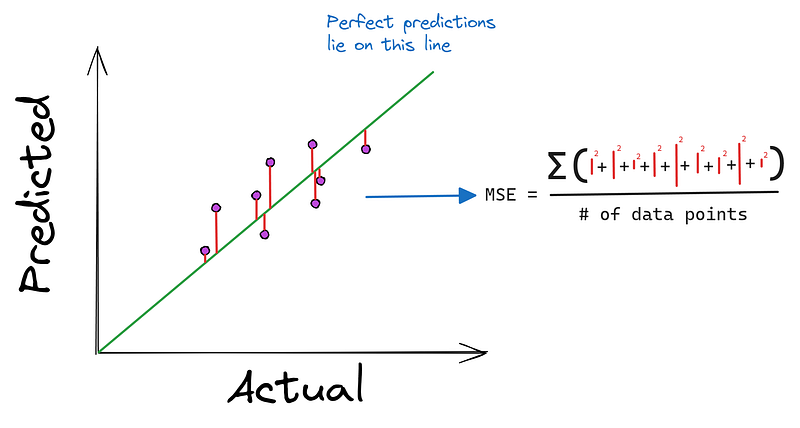
Nu definiëren we een functie genaamd stochastic_gradient_descent die zes argumenten accepteert:
x en y stellen de enkele feature en target in ons probleem voor.epochs geeft aan hoe vaak we de afdaling willen uitvoeren (hierover later meer).learning_rate is de stapgrootte.batch_size om te bepalen hoe vaak we parameterupdates doenstopping_threshold stelt de minimale waarde in waarmee het verlies bij elke stap moet afnemendef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infBinnen de functie initialiseren we eerst de parameters die we willen optimaliseren met willekeurige waarden (starten op een willekeurige locatie in de heuvels). We zetten ook het initiële verlies op oneindig, wat de onopgeloste staat van ons probleem weergeeft.
Vervolgens starten we een for-lus die epochs iteraties draait. Binnen de lus husselen we de data door elkaar om te voorkomen dat er volgorde-afhankelijke patronen worden geleerd:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       # Shuffle the data
       indices = np.random.permutation(n)
       x = x[indices]
       y = y[indices]
Daarna starten we een andere lus, gestuurd door de parameter batch_size, en extraheren we de huidige batch:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           x_batch = x[j:j + batch_size]
           y_batch = y[j:j + batch_size]
In deze binnenste lus berekenen we de gradiënten (partiële afgeleiden) voor beide parameters (die aangeven waar we de volgende stap moeten zetten):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Make predictions with current m, b
           y_pred = model(m, x_batch, b)
           # Compute the gradients
           m_gradient = 2 * np.mean(x_batch * (y_batch - y_pred))
           b_gradient = 2 * np.mean(y_batch - y_pred)
Na het berekenen van de gradiënten is er een cruciale stap: het clippen van de gradiënten:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           clip_value = 1.0
           m_gradient = np.clip(m_gradient, -clip_value, clip_value)
           b_gradient = np.clip(b_gradient, -clip_value, clip_value)
Gradient clipping voorkomt het veelvoorkomende probleem van exploderende gradiënten, waarbij de grootte van gradiënten naar oneindig gaat.
Na het clippen updaten we de parameters met behulp van het leerritme (we zetten een stap in de richting van de gradiënten, gestuurd door het leerritme):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           m -= learning_rate * m_gradient
           b -= learning_rate * b_gradient
Nu, onder de bovenliggende lus (nadat alle batches zijn doorlopen), berekenen we het verlies voor de huidige epoch (kijk hoe ver we gedaald zijn vanaf onze startpositie):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       y_pred = model(m, x, b)
       current_loss = loss(y, y_pred)
Als het verlies per epoch kleiner is dan de stopping_threshold, stoppen we het hele proces:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       if abs(previous_loss - current_loss) < stopping_threshold:
           break
       previous_loss = current_loss
Aan het einde (nadat de epochs op zijn of de drempel is gehaald) geven we m en b terug, die nu geoptimaliseerd zijn:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       ...
return m, bLaten we nu momentum toevoegen aan SGD. De code van deze versie verschilt niet veel van de mini-batchversie.
We definiëren een nieuwe functie met een momentum-parameter:
def stochastic_gradient_descent_with_momentum(
       x, y, epochs=100, learning_rate=0.01, batch_size=32,
       stopping_threshold=1e-6, momentum=0.9
):
   """
   SGD with momentum and support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize velocity terms
   v_m = 0
   v_b = 0

   n = len(x)
   previous_loss = np.inf
Binnen de functie definiëren we nog twee variabelen, v_m en v_b, om de zich ophopende gradiënten bij te houden die als ons momentum dienen. We zetten ze eerst op 0, want we hebben nog geen momentum aan het begin van het algoritme.
Daarna blijft de rest van de code hetzelfde totdat we de gradiënten clippen:
def sgd_with_momentum(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update velocity terms
           v_m = momentum * v_m + learning_rate * m_gradient
           v_b = momentum * v_b + learning_rate * b_gradient
           # Update the model parameters using velocity
           m -= v_m
           b -= v_b
Zodra de gradiënten zijn geclipped, gebruiken we de update-regel van momentum om de snelheids-termen te wijzigen. Hier is een weergave op hoger niveau van de code:
# Initialize
v_m = 0
v_b = 0
...
# Update velocity terms
v_m = momentum * v_m + learning_rate * m_gradient
v_b = momentum * v_b + learning_rate * b_gradient
# Update the model parameters using velocity
m -= v_m
b -= v_b
De snelheid v_* stapelt gradiënten in de tijd op. Dit betekent dat als we in een consistente richting bewegen, we snelheid in die richting opbouwen.
In gebieden waar de gradiënt snel verandert (zoals smalle dalen in het verlieslandschap), helpt het momentum om oscillaties te dempen. We ontwikkelen genoeg traagheid om niet vast te lopen in kleine lokale variaties zoals lokale minima of zadelpunten.
Het deel momentum * v_m is wat de gradiënten ophoopt. Als we bijvoorbeeld een grote positieve gradiënt hebben, zal de snelheid vergelijkbaar groot zijn, en de update van de parameter nog groter. Dus, een momentum van 0,9 betekent dat we 90% van de snelheid van de vorige verandering behouden voor de volgende stap. Bij elke stap N gebruiken we 90% van de totale snelheid van gradiënten van N-1 stappen.
Op dit punt moedig ik je aan om wat willekeurige waarden te bedenken voor m en b en hun gradiënten en de update-regel van momentum te gebruiken om te zien hoe de parameters veranderen als je bergop of bergaf gaat.
Laten we nu de implementatie van RMSprop bekijken. Net als SGD met momentum komt de belangrijkste wijziging bij het updaten van parameters.
Eerst definiëren we een nieuwe functie met twee extra parameters, beta en epsilon (zonder momentum):
def rmsprop_optimization(
   x, y, epochs=100, learning_rate=0.01, batch_size=32,
   stopping_threshold=1e-6, beta=0.9, epsilon=1e-8,
):
   """
   RMSprop optimization with support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize accumulators for squared gradients
   s_m = 0
   s_b = 0
   n = len(x)
   previous_loss = np.inf
Ook maken we binnen de functie twee nieuwe variabelen aan om gekwadrateerde gradiënten op te hopen, s_m en s_b.
Wanneer we dan bij de updatestap komen, herberekenen we de gekwadrateerde gradiënten en updaten we vervolgens de parameters:
def rmsprop_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # RMSprop doesn't need gradient clipping
           # Update accumulators
           s_m = beta * s_m + (1 - beta) * (m_gradient**2)
           s_b = beta * s_b + (1 - beta) * (b_gradient**2)
           # Update parameters
           m -= learning_rate * m_gradient / (np.sqrt(s_m) + epsilon)
           b -= learning_rate * b_gradient / (np.sqrt(s_b) + epsilon)
           # The rest of the code is the same
Hier zien we twee nieuwe parameters in gebruik:
epsilon is een kleine waarde, typisch 1e-8, om deling door nul te voorkomen bij updates.beta is de vervalparameter, meestal rond 0,9.De parameter beta bepaalt hoeveel historie we meenemen. Een hogere beta betekent dat we een langetermijnblik nemen op eerdere gradiënten, terwijl een lagere beta het algoritme gevoeliger maakt voor recente gradiënten.
Je hoeft je geen zorgen te maken over de wiskunde achter de update-regel voor RMSprop. Belangrijk is de logica erachter.
Kort gezegd doen de vier regels hierboven het volgende:
In de praktijk presteert RMSprop vaak beter dan basis-SGD of SGD met momentum, vooral bij niet-convexe optimalisatieproblemen die vaak in deep learning voorkomen.
Wederom definiëren we een nieuwe functie:
def adam_optimization(
   x,
   y,
   epochs=100,
   learning_rate=0.001,
   batch_size=32,
   stopping_threshold=1e-6,
   beta1=0.9,
   beta2=0.999,
   epsilon=1e-8,
):
   """
   Adam optimization with support for mini-batches.
   """
   # Initialize the model parameters
   m = np.random.randn()
   b = np.random.randn()
   # Initialize first and second moment vectors
   m_m, v_m = 0, 0
   m_b, v_b = 0, 0
   n = len(x)
   previous_loss = np.inf
   t = 0  # Initialize timestep
Dit keer definiëren we vijf nieuwe variabelen om eerste- en tweedemomentvectoren en de tijdstap vast te leggen. In de context van Adam:
1. De eerstemomentvector (m):
2. De tweedemomentvector (v):
Daarna blijft de code hetzelfde tot na het berekenen van de gradiënten (we hoeven ze voor Adam niet te clippen):
def adam_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Adam doesn't need gradient clipping

           # Update biased first moment estimate
           m_m = beta1 * m_m + (1 - beta1) * m_gradient
           m_b = beta1 * m_b + (1 - beta1) * b_gradient
           # Update biased second raw moment estimate
           v_m = beta2 * v_m + (1 - beta2) * (m_gradient**2)
           v_b = beta2 * v_b + (1 - beta2) * (b_gradient**2)
           # Compute bias-corrected first moment estimate
           m_m_hat = m_m / (1 - beta1**t)
           m_b_hat = m_b / (1 - beta1**t)
           # Compute bias-corrected second raw moment estimate
           v_m_hat = v_m / (1 - beta2**t)
           v_b_hat = v_b / (1 - beta2**t)
           # Update parameters
           m -= learning_rate * m_m_hat / (np.sqrt(v_m_hat) + epsilon)
           b -= learning_rate * m_b_hat / (np.sqrt(v_b_hat) + epsilon)
       # The rest of the code is the same
Wederom: maak je geen zorgen over deze regels code, ze bevatten veel wiskunde. In de praktijk hoef je Adam nooit from scratch te implementeren, want het enige wat je moet weten is de intuïtie achter de update-regel.
Het eerste moment werkt als momentum en stapelt eerdere gradiënten op om de optimalisatie een gevoel van richting en snelheid te geven. Dit helpt Adam sneller te bewegen in consistente richtingen en oscillaties in ruisige gradiëntlandschappen te dempen.
Het tweede moment past, net als in RMSprop, het leerritme per parameter aan. Het normaliseert de parameterupdates effectief, waardoor het leren langzamer gaat voor parameters met grote gradiënten en sneller voor die met kleine gradiënten. Dit stelt Adam in staat om parameters op verschillende schalen effectief aan te pakken.
Adam bevat ook bias-correctie voor deze voortschrijdende gemiddelden, wat vooral in de beginfase van training belangrijk is. Deze correctie helpt Adam om te starten met nauwkeurigere stapgroottes, wat mogelijk tot snellere initiële vooruitgang leidt.
Door deze elementen te combineren, bereikt Adam vaak een snellere convergentie dan eenvoudigere optimalisatiemethoden. Het is bijzonder effectief bij problemen met ruisige gradiënten, niet-stationaire doelen of zeer grote datasets. Door zijn adaptieve aard is Adam relatief ongevoelig voor het initiële leerritme en is vaak minder hyperparameterafstemming nodig dan bij andere methoden.
Laten we nu bekijken hoe we de samenvattingstabel die we eerder zagen genereren:
comparison_table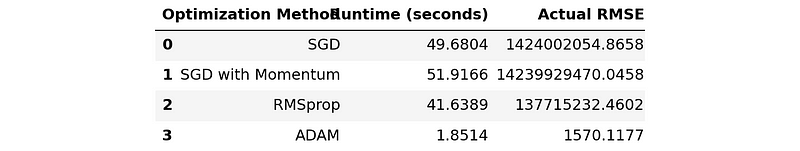
We definiëren een functie genaamd run_optimization om een lineair regressiemodel te trainen met onze optimalisatiefuncties. De functie legt ook de runtime en RMSE-scores vast:
import time
def run_optimization(opt_func, x, y, **kwargs):
   # Start a timer
   start_time = time.time()

   # Run the optimization function
   m, b = opt_func(x, y, **kwargs)

   # End the timer
   end_time = time.time()
   # Run the model on the test set with found parameters
   y_preds = model(m, test_xy[:, 0], b)
   y_preds_denormalized = y_preds * std[1] + mean[1]
   y_true_denormalized = test_xy[:, 1] * std[1] + mean[1]

   # Compute MSE and RMSE
   actual_mse = np.mean((y_true_denormalized - y_preds_denormalized) ** 2)
   return end_time - start_time, np.sqrt(actual_mse)
Nu roepen we deze functie vier keer aan voor elk van onze optimalisatiefuncties, waarbij we de resultaten opslaan in een lijst waarin elk item een drietal is (algoritmenaam, looptijd in seconden, RMSE-score):
# Run all optimization methods
results = []
results.append(
   (
       "SGD",
       *run_optimization(
           stochastic_gradient_descent,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
       ),
   )
)
results.append(
   (
       "SGD with Momentum",
       *run_optimization(
           stochastic_gradient_descent_with_momentum,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
           momentum=0.9,
       ),
   )
)
results.append(
   (
       "RMSprop",
       *run_optimization(
           rmsprop_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta=0.9,
           epsilon=1e-8,
       ),
   )
)
results.append(
   (
       "Adam",
       *run_optimization(
           adam_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta1=0.9,
           beta2=0.999,
           epsilon=1e-8,
       ),
   )
)
Voor een eerlijke vergelijking houden we het leerritme, het aantal epochs en de batchgrootte hetzelfde.
Daarna kunnen we onze tabel maken:
from tabulate import tabulate  # pip install tabulate
# Create and print the table
headers = ["Optimization Method", "Runtime (seconds)", "Actual RMSE"]
print(tabulate(results, headers=headers, floatfmt=".4f"))
# Save the table
pd.DataFrame(results, columns=headers).to_csv("optimization_results.csv", index=False)
Hier is het eindresultaat:
Optimization Method      Runtime (seconds)       Actual RMSE
---------------------  -------------------  ----------------
SGD                                49.9305   1424002054.8658
SGD with Momentum                  50.7744  14239929470.0458
RMSprop                            41.9895    137715232.4602
Adam                                1.8462         1570.1177
Voordat je verdergaat, raad ik je aan te spelen met de parameters van elke optimalisatiefunctie. Het is waarschijnlijk dat je elk algoritme, vooral Adam, nog sneller en nauwkeuriger kunt maken door het leerritme aan te passen, de batchgrootte te vergroten of de bias te sturen.
Zie de conclusie voor links naar de volledige code van het vergelijkingsscript en hoe je de grafiek maakt die we aan het begin hebben gezien.
Adam in de praktijk gebruiken vereist geen lang artikel als dit en het helemaal zelf schrijven. De PyTorch-implementatie is meer dan geschikt voor elke supervised-learningtaak in deep learning.
Hier is een korte, minimale snippet die een typische PyTorch-workflow schetst waarin de Adam-optimizer uit de torch.optim-module wordt gebruikt:
# Import necessary modules
import torch
import torch.nn as nn
import torch.optim as optim
# Define your model
model = nn.Sequential(
   nn.Linear(10, 50),
   nn.ReLU(),
   nn.Linear(50, 1)
)
# Initialize Adam optimizer
optimizer = optim.Adam(model.parameters(), lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0)
# Training loop
for epoch in range(num_epochs):
   for batch in dataloader:
       # Zero the gradients
       optimizer.zero_grad()

       # Forward pass
       outputs = model(batch)
       loss = criterion(outputs, targets)

       # Backward pass
       loss.backward()

       # Update weights
       optimizer.step()
# Adjusting learning rate
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=30, gamma=0.1)
for epoch in range(num_epochs):
   train(...)
   scheduler.step()
Wil je meer leren over het gebruik van PyTorch in het algemeen en de optimalisatie-algoritmen, bekijk dan deze introductiecursus van DataCamp:
In dit artikel hebben we de ins en outs van de populaire Adam-optimizer geleerd. We begonnen met het opbouwen van intuïtie ervoor, via besprekingen van de onderliggende algoritmen, zoals gradient descent, SGD en RMSprop. We zagen hoe Adam de belangrijkste ideeën hiervan combineert, wat resulteert in een zeer flexibel en performant algoritme.
Daarna hebben we behandeld hoe je de Adam-optimizer in Python implementeert met alleen NumPy. Net als de intuïtie hebben we de code opgebouwd vanuit de basisalgoritmen, van mini-batch gradient descent via RMSprop naar Adam. We waren ook getuige van een verbluffend verschil tussen Adam en andere algoritmen qua snelheid en prestaties door een eenvoudig benchmarkscripts te maken.
Tot slot hebben we laten zien hoe je Adam in PyTorch gebruikt, precies zoals je dat in de praktijk zou doen, om deep-learningproblemen op te lossen. Hier zijn enkele links naar de scripts die we in de tutorial hebben gebruikt:
En enkele gerelateerde bronnen om meer te leren over PyTorch en zijn optimalisatiefuncties:
Bedankt voor het lezen!
Topcursussen PyTorch
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


