
Last chance! 50% off DataCamp Premium
Sale ends in
Adam, जिसका अर्थ Adaptive Moment Estimation है, मशीन लर्निंग में—और अधिकतर डीप लर्निंग में—उपयोग किया जाने वाला एक लोकप्रिय ऑप्टिमाइज़ेशन एल्गोरिदम है।
Adam दो अन्य मज़बूत ऑप्टिमाइज़ेशन तकनीकों—momentum और RMSprop—के मुख्य विचारों को जोड़ता है। इसे adaptive कहा जाता है क्योंकि यह प्रत्येक पैरामीटर के लिए लर्निंग रेट को समायोजित करता है।
इसके प्रमुख फीचर और फायदे ये हैं:
संक्षेप में, Adam हर पैरामीटर के लर्निंग रेट को लगातार समायोजित करके मॉडल को अधिक कुशलता से सीखने में मदद करता है और परिणामस्वरूप, मानक stochastic gradient descent की तुलना में कहीं अधिक तेज़ी से कन्वर्ज करता है। इसलिए, कई डीप लर्निंग अनुप्रयोगों में यह एक मजबूत डिफ़ॉल्ट विकल्प है।
Adam कुछ अन्य महत्वपूर्ण ऑप्टिमाइज़ेशन एल्गोरिदम के प्रमुख विचारों को एकीकृत करता है, उनकी खूबियों को मज़बूत करते हुए कमियों का समाधान भी करता है। Adam की सहज समझ विकसित करने और इसे Python में लागू करने से पहले हमें इन्हें देखना होगा।
इन ऑप्टिमाइज़ेशन एल्गोरिदम की सहज समझ के लिए, चलिए प्रस्तावना से शुरू की गई उपमा को आगे बढ़ाते हैं।
कल्पना कीजिए कि आप आंखों पर पट्टी बांधकर एक जटिल, पहाड़ी इलाके में हैं। आपका काम इस भूभाग का सबसे निचला बिंदु ढूंढना है। भूभाग की ढलानें एक मशीन लर्निंग मॉडल के लॉस फ़ंक्शन का प्रतिनिधित्व करती हैं। कुल मिलाकर सबसे “निचला” (ग्लोबल मिनिमा) बिंदु इस सिस्टम का उत्तम समाधान है।
अब कुछ बिंदु जोड़ते हैं: भूभाग में आपका वर्तमान स्थान मॉडल के पैरामीटरों की वर्तमान स्थिति को दर्शाता है। किसी भी बिंदु की ऊंचाई उन पैरामीटरों के लिए लॉस वैल्यू को दर्शाती है। जिस तरह से आप नेविगेट कर रहे हैं, वह गणितीय रूप से मॉडल के पैरामीटरों को समायोजित करने के अनुरूप है।
प्रत्येक ऑप्टिमाइज़ेशन एल्गोरिदम इस परिदृश्य में सफलतापूर्वक नेविगेट करने की एक रणनीति जैसा है—समाधानकर्ता को बताता है कि अगला कदम कहाँ और कितना बड़ा होना चाहिए। कुछ एल्गोरिदम अगला कदम तय करने से पहले पूरे क्षेत्र का मुआयना करते हैं, जबकि अन्य तेज़ होने के लिए सीमित जानकारी पर निर्भर रहते हैं।
कुछ अन्य एल्गोरिदम momentum और step-size adaptation जैसे औज़ार उपयोग करते हैं; एक अच्छा सॉल्वर जानता है कब ज़ोर से आगे बढ़ना है और कब ढीला पड़ना है।
ग्रेडिएंट डिसेंट मशीन लर्निंग में ऑप्टिमाइज़ेशन का मूल स्तंभ है, जिस पर कई एल्गोरिदम बने हैं।
यदि आप Gradient Descent (GD) का उपयोग करते हैं, तो आप प्रत्येक कदम से पहले अपने चारों ओर के पूरे क्षेत्र (पूरे डेटासेट) को ध्यान से टटोलते हैं। यह विस्तृत जाँच आपको यह तय करने में बहुत सटीक बनाती है कि ढलान किस दिशा में है, लेकिन इसमें बहुत समय लगता है। आप हमेशा सबसे तीव्र अवरोह की दिशा में बढ़ते हैं, यानी लगातार नीचे की ओर। लेकिन यदि आप किसी छोटे अवसाद (लोकल मिनिमा) में पहुंच जाते हैं, तो आप वहीं फंस सकते हैं—यह समझे बिना कि कहीं और इससे भी निचला बिंदु है।
GD की प्रमुख विशेषताएँ:
इस परिदृश्य में, आप जल्दी में हैं और पूरे क्षेत्र को महसूस करने का समय नहीं है। इसके बजाय, आप अपने पैरों के पास का केवल एक यादृच्छिक बिंदु (एक डेटा पॉइंट) देखते हैं। इससे हर कदम तेज़ हो जाता है लेकिन कम सटीक। आप बिंदुओं के एक छोटे बैच की भी जाँच कर सकते हैं—इसे मिनी-बैच ग्रेडिएंट डिसेंट कहते हैं, जिसे हम आगे कवर करेंगे।
आपका मार्ग ग्रेडिएंट डिसेंट की तुलना में अधिक अनियमित होता है; कभी-कभी यह नशे में नाविक के रास्ते जैसा लगता है। आप कभी-कभी ऊपर की ओर भी जा सकते हैं। यह शोरयुक्त मार्ग वास्तव में सबसे बड़ा फायदा हो सकता है: आप लोकल मिनिमा से बाहर निकलने की अधिक संभावना रखते हैं।
लेकिन जैसे-जैसे आप नीचे के पास पहुँचते हैं, आपको छोटे कदम (लर्निंग रेट घटाकर) लेने की ज़रूरत होती है ताकि सबसे निचले बिंदु को ओवरशूट करने से बचा जा सके।
SGD की प्रमुख विशेषताएँ:
नोट: इस बिंदु पर, मैं हमारा GD और SGD पर अलग लेख पढ़ने की अत्यधिक अनुशंसा करता हूँ, क्योंकि यह इन दोनों महत्वपूर्ण एल्गोरिदम के विवरण को बहुत गहराई से कवर करता है। यह आपको आगे आने वाले कोडिंग सेक्शन को और स्पष्ट रूप से समझने में भी मदद करेगा।
अब आप पहाड़ियों के बीच एक स्केटबोर्ड पर हैं। जब आप किसी दिशा में धक्का देते हैं, तो स्केटबोर्ड का momentum आपको कुछ देर तक उसी दिशा में आगे बढ़ाता रहता है।
यह momentum आपके पिछले दिशाओं का एक मूविंग एवरेज जैसा है। यह आपको छोटे उभारों और स्थानीय अवसादों से पार पाने में मदद करता है, संभवतः आपको आगे कहीं और अधिक नीचे के बिंदु तक पहुँचा देता है।
यदि आप थोड़ी देर से किसी दिशा में बढ़ रहे हैं, तो momentum बनता है और आप तेज़ हो जाते हैं। इस तरह, विशेषकर सतत नीचे ढलान वाले भूभाग में, आप सबसे निचले बिंदु तक अधिक तेजी से कन्वर्ज कर सकते हैं।
मोमेंटम के साथ SGD की प्रमुख विशेषताएँ:
ऐसे हाई-टेक जूतों के बारे में सोचिए जो जिस भूभाग पर आप चल रहे हैं उसके आधार पर अपनी पकड़ समायोजित कर सकते हैं। ये जूते हर दिशा में ढलान (ग्रेडिएंट) को ट्रैक करते हैं और स्क्वेयर्ड ग्रेडिएंट्स का एक्सपोनेंशियली डिकेइंग एवरेज रखते हैं। जहाँ ढलान बहुत बदलता है, जूते ज्यादा पकड़ देते हैं ताकि आप छोटे, सावधानीपूर्ण कदम लें। और जहाँ ढलान स्थिर और मुलायम हो, जूते आपको लंबी चालें देते हैं।
यह अनुकूलनशील “स्टेप साइज” आपको तीखी और हल्की दोनों ढलानों पर प्रभावी रूप से नेविगेट करने में मदद करता है—न तो बहुत तीखी जगह पर बहुत बड़ा कदम, न ही समतल जगह पर बहुत छोटा।
RMSprop की प्रमुख विशेषताएँ:
Adam आपके स्केटबोर्ड (मोमेंटम) को आपके अनुकूलनशील जूतों (RMSprop) के साथ जोड़ देता है और इसमें एक स्मार्ट नेविगेशन सिस्टम भी जोड़ता है।
स्केटबोर्ड वाला हिस्सा (मोमेंटम) आपको सही सामान्य दिशा में चलते रहने में मदद करता है। यानी, नीचे की ओर, मुलायम और सुसंगत क्षेत्रों में Adam आपको तेज़ी से बढ़ने देता है। जटिल और बदलते भूभाग में, यह आपको स्थिर लेकिन सावधानी से चलने देता है।
अनुकूलनशील जूते (RMSprop) यह महसूस करते हैं कि आप कहाँ जा रहे हैं और स्केटबोर्ड की पकड़ समायोजित करते हैं। Adam में स्मार्ट नेविगेशन सिस्टम (बायस करेक्शन) विशेष रूप से आपकी यात्रा की शुरुआत में महत्वपूर्ण होता है, जब आप किसी यादृच्छिक बिंदु से शुरू करते हैं और भूभाग के बारे में बहुत कम जानते हैं।
इन्हीं गुणों का यह संयोजन है जिसकी वजह से Adam अक्सर बहुत कुशलता से सबसे निचला बिंदु (समस्या का समाधान) खोज लेता है और इसकी संरचना अलग-अलग प्रकार के भूभाग (विभिन्न प्रकार की मशीन लर्निंग समस्याएँ) संभालने में सक्षम होती है।
Adam की प्रमुख विशेषताएँ:
जैसा कि आपने देखा, उपर्युक्त प्रत्येक एल्गोरिदम पिछले पर आधारित है—विभिन्न प्रकार की ऑप्टिमाइज़ेशन समस्याओं में आने वाली चुनौतियों को संबोधित करके सबसे निचला बिंदु खोजने की प्रक्रिया को बेहतर बनाने के लिए।
Adam और अन्य उल्लेखित एल्गोरिदम को लागू करने के विवरण पर जाने से पहले, आइए एक सारणी साझा करता हूँ जो एक नमूना रिग्रेशन समस्या पर इनके रनटाइम और RMSE प्रदर्शन की तुलना करती है:
import pandas as pd
# Disable scientific notation
pd.set_option("display.float_format", "{:.4f}".format)
comparison_table = pd.read_csv('optimization_results.csv')
comparison_table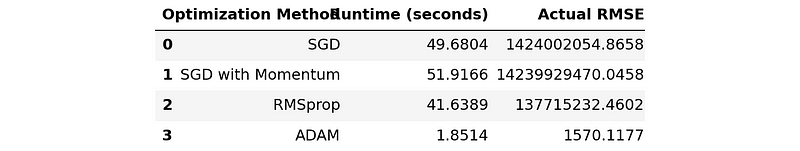
यह तालिका Adam और बाकी के बीच के भारी अंतर को पर्याप्त रूप से नहीं दर्शाती, इसलिए आइए एक बार चार्ट बनाते हैं:
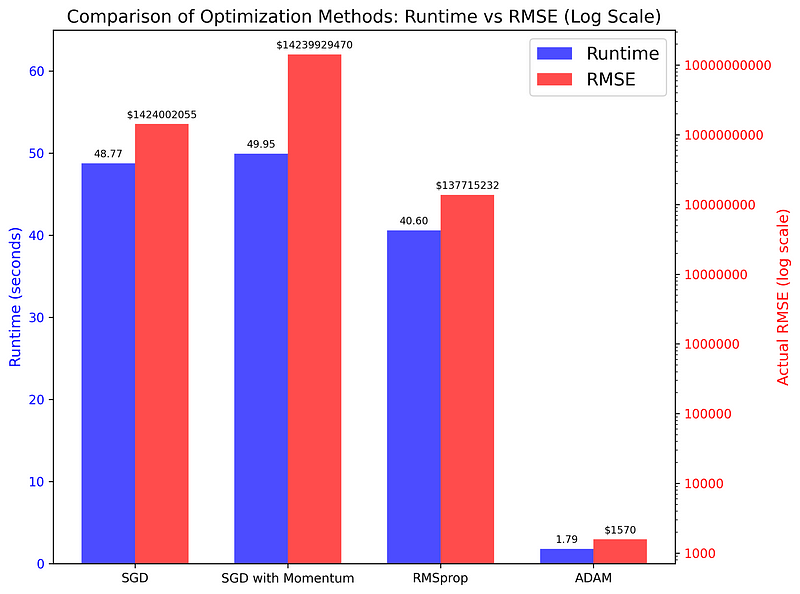
यह प्लॉट एक साधारण रिग्रेशन टास्क पर उपयोग किए गए चार एल्गोरिदम के रनटाइम और RMSE स्कोर की तुलना करता है। जैसा कि आप देख सकते हैं, अंतर चौंकाने वाले हैं (ध्यान रखें, दाएँ हाथ का अक्ष लॉगरिदमिक स्केल पर है), जो दर्शाता है कि अधिकांश ऑप्टिमाइज़ेशन टास्क के लिए Adam श्रेष्ठ विकल्प है।
हम आगे चलकर वह कोड देखेंगे जिसने यह तालिका और प्लॉट जनरेट किया है।
अब जबकि हमने Adam के लिए आवश्यक अवधारणाएँ और उसकी सहज समझ कवर कर ली है, हम Python में इन्हें लागू करना शुरू कर सकते हैं। रास्ते में, हम इम्प्लीमेंटेशन समझने के लिए आवश्यक गणित भी समझाएँगे। हम Stochastic Gradient Descent से शुरू करते हुए, कोड को चरण-दर-चरण बनाएँगे।
पहले, हमने बताया था कि SGD अगला कदम तय करने के लिए केवल एक डेटा पॉइंट का उपयोग करता है। व्यवहार में, इस वैनिला संस्करण का कम ही उपयोग होता है क्योंकि इसके परिणाम शोरयुक्त हो सकते हैं (पहाड़ियों में इसका पथ अनियमित होता है)।
इसे कम करने के लिए, प्रोफेशनल्स अक्सर Mini-Batch Gradient Descent नामक विधि अपनाते हैं, जो प्रत्येक कदम से पहले 32, 64 या 128 जैसे डेटा पॉइंट्स के बैच का उपयोग करती है (यह एक कदम से पहले 360-डिग्री दृश्य के बजाय एक संकरे रास्ते को स्कैन करने जैसा है)।
तो, हम Adam के लिए बुनियादी कोड इसी संस्करण के SGD से बनाएँगे।
कोड को यथासंभव सरल रखने के लिए, हम एक छोटा रिग्रेशन समस्या चुनेंगे: कैरेट माप के आधार पर हीरे की कीमत का पूर्वानुमान।
सबसे पहले आवश्यक लाइब्रेरी इम्पोर्ट करें:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
अगले चरण में, हम Seaborn से Diamonds डेटासेट लोड करेंगे, उससे एक सैंपल लेंगे, और फीचर तथा टार्गेट एर्रेज़ बनाएँगे:
# Load the data
dataset_size = 20_000
diamonds = sns.load_dataset("diamonds")
# Extract the target and the feature
xy = diamonds[["carat", "price"]].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
Output:
(20000, 2)लिनियर रिग्रेशन के लिए हमें डेटा को नॉर्मलाइज़ करना होता है:
# Normalize the data
mean = np.mean(xy, axis=0)
std = np.std(xy, axis=0)
xy_normalized = (xy - mean) / std
अब, हम डेटा को ट्रेनिंग और टेस्ट सेट में बाँट सकते हैं:
# Split the data
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(16000, 2)टास्क हल करने के लिए हमारे पास कई मॉडल हैं, पर सादगी के लिए हम Simple Linear Regression चुनेंगे और इसे एक फ़ंक्शन के रूप में परिभाषित करेंगे:
def model(m, x, b):
   """
   Simple Linear Regression: f(x) = m * x + b, where
   - x: diamond carat
   - m: price increase per carat
   - b: base diamond price
   - f(x): predicted diamond price
   """

   return m * x + b
हमारे Linear Regression मॉडल में केवल दो पैरामीटर m और b हैं, इसलिए SGD (और बाद में Adam) का काम इनके इष्टतम मान ढूँढना है।
हमें लॉस फ़ंक्शन Mean Squared Error भी परिभाषित करना चाहिए, जिसे हमारे एल्गोरिदम न्यूनतम करेंगे:
def mean_squared_error(y_true, y_pred):
   """
   MSE as a loss function. It is defined as:
   Loss = (1/n) * Σ((y - f(x))²), where:
   - n: the length of the dataset
   - y: the true diamond price
   - f(x): predicted diamond price, i.e. m*x + b
   """
   return np.mean((y_true - y_pred) ** 2)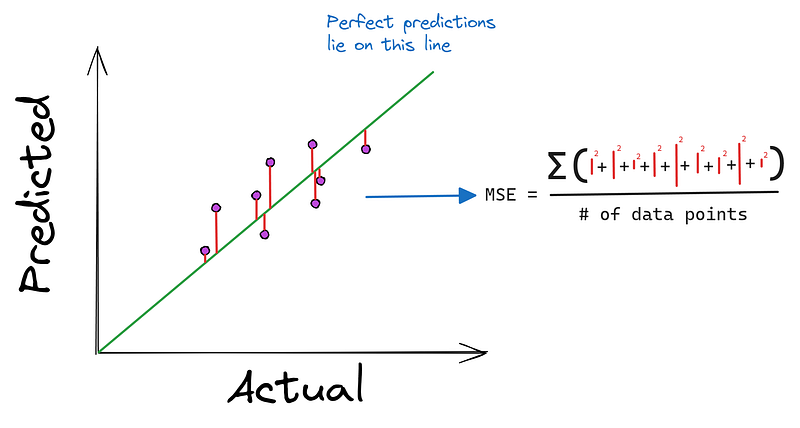
अब, हम stochastic_gradient_descent नामक फ़ंक्शन परिभाषित करते हैं, जो छह आर्ग्युमेंट स्वीकार करता है:
x और y हमारी समस्या के एकल फीचर और टार्गेट का प्रतिनिधित्व करते हैं।epochs दर्शाता है कि हम कितनी बार अवरोह करना चाहते हैं (इस पर आगे और)।learning_rate स्टेप साइज है।batch_size यह नियंत्रित करता है कि हम कितनी बार पैरामीटर अपडेट करेंगेstopping_threshold वह न्यूनतम मान सेट करता है जितना हर कदम पर लॉस घटना चाहिएdef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infफ़ंक्शन के अंदर, हम पहले उन पैरामीटरों को यादृच्छिक मानों से इनिशियलाइज़ करते हैं जिन्हें हमें ऑप्टिमाइज़ करना है (पहाड़ियों में किसी यादृच्छिक स्थान से शुरुआत करना)। हम शुरुआती लॉस को अनंत मान देते हैं, जो हमारी समस्या की अनसुलझी स्थिति को दर्शाता है।
फिर हम एक for लूप शुरू करते हैं जो epochs बार चलता है। लूप के भीतर, हम डेटा शफ़ल करते हैं ताकि डेटा में क्रम-आधारित पैटर्न सीखने से बचा जा सके:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       # Shuffle the data
       indices = np.random.permutation(n)
       x = x[indices]
       y = y[indices]
फिर, हम एक और लूप शुरू करते हैं जिसे batch_size पैरामीटर नियंत्रित करता है और वर्तमान बैच निकालते हैं:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           x_batch = x[j:j + batch_size]
           y_batch = y[j:j + batch_size]
इस भीतरी लूप के अंदर, हम दोनों पैरामीटरों के लिए ग्रेडिएंट (आंशिक अवकलज) निकालते हैं (जो दर्शाते हैं कि अगला कदम कहाँ रखना है):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Make predictions with current m, b
           y_pred = model(m, x_batch, b)
           # Compute the gradients
           m_gradient = 2 * np.mean(x_batch * (y_batch - y_pred))
           b_gradient = 2 * np.mean(y_batch - y_pred)
ग्रेडिएंट निकालने के बाद, एक अहम कदम है—ग्रेडिएंट क्लिपिंग:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           clip_value = 1.0
           m_gradient = np.clip(m_gradient, -clip_value, clip_value)
           b_gradient = np.clip(b_gradient, -clip_value, clip_value)
Exploding gradients की आम समस्या—जहाँ ग्रेडिएंट का परिमाण अनंत की ओर बढ़ जाता है—से बचाव के लिए ग्रेडिएंट क्लिपिंग किया जाता है।
क्लिप करने के बाद, हम लर्निंग रेट का उपयोग करके पैरामीटर अपडेट करते हैं (ग्रेडिएंट की दिशा में लर्निंग रेट द्वारा नियंत्रित कदम लेते हैं):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           m -= learning_rate * m_gradient
           b -= learning_rate * b_gradient
अब, पेरेंट लूप के अंतर्गत (सभी बैचों का उपयोग करने के बाद), हम वर्तमान epoch का लॉस निकालते हैं (देखते हैं कि प्रारंभिक स्थिति से हम कितनी दूर नीचे आए हैं):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       y_pred = model(m, x, b)
       current_loss = loss(y, y_pred)
यदि epoch लॉस stopping_threshold से कम अंतर से घटता है, तो हम पूरी प्रक्रिया रोक देते हैं:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       if abs(previous_loss - current_loss) < stopping_threshold:
           break
       previous_loss = current_loss
अंत में (epochs खत्म होने या स्टॉपिंग थ्रेशहोल्ड पूरा होने पर) हम m और b लौटाते हैं, जो अब ऑप्टिमाइज़ हो चुके हैं:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       ...
return m, bअब, चलिए SGD में momentum जोड़ते हैं। इस संस्करण का कोड मिनी-बैच संस्करण से बहुत अलग नहीं है।
हम एक नया फ़ंक्शन परिभाषित करते हैं, जिसमें एक momentum पैरामीटर होगा:
def stochastic_gradient_descent_with_momentum(
       x, y, epochs=100, learning_rate=0.01, batch_size=32,
       stopping_threshold=1e-6, momentum=0.9
):
   """
   SGD with momentum and support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize velocity terms
   v_m = 0
   v_b = 0

   n = len(x)
   previous_loss = np.inf
फ़ंक्शन के अंदर, हम दो और वेरिएबल्स v_m और v_b, परिभाषित करेंगे—ग्रेडिएंट्स को संचित करने के लिए जो हमारे momentum के रूप में काम करेंगे। शुरुआत में इन्हें 0 रखते हैं, क्योंकि एल्गोरिदम के आरंभ में कोई momentum नहीं होता।
इसके बाद, कोड वही है—बस ग्रेडिएंट क्लिपिंग के बाद बदलाव आता है:
def sgd_with_momentum(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update velocity terms
           v_m = momentum * v_m + learning_rate * m_gradient
           v_b = momentum * v_b + learning_rate * b_gradient
           # Update the model parameters using velocity
           m -= v_m
           b -= v_b
ग्रेडिएंट्स क्लिप होने के बाद, हम momentum के अपडेट नियम का उपयोग करके वेलोसिटी टर्म्स बदलते हैं। कोड का उच्च-स्तरीय दृश्य:
# Initialize
v_m = 0
v_b = 0
...
# Update velocity terms
v_m = momentum * v_m + learning_rate * m_gradient
v_b = momentum * v_b + learning_rate * b_gradient
# Update the model parameters using velocity
m -= v_m
b -= v_b
वेलोसिटी v_* समय के साथ ग्रेडिएंट्स को संचित करती है। यानी यदि हम किसी दिशा में लगातार बढ़ रहे हैं, तो उसी दिशा में गति भी बनती है।
जहाँ ग्रेडिएंट तेज़ी से बदलता है (लॉस लैंडस्केप की तंग घाटियाँ), वहाँ मोमेंटम दोलनों को कम करने में मदद करता है। हम इतना जड़त्व बटोर लेते हैं कि लोकल मिनिमा या सेडल पॉइंट जैसी छोटी स्थानीय विविधताओं में नहीं फँसते।
यहाँ momentum * v_m वाला हिस्सा ग्रेडिएंट्स को संचित करता है। उदाहरण के लिए, यदि ग्रेडिएंट बड़ा और पॉज़िटिव है, तो वेलोसिटी भी बड़ी होगी, और पैरामीटर अपडेट और बड़ा होगा। तो, 0.9 का momentum का अर्थ है कि हम अगले कदम के लिए पिछले बदलाव की वेलोसिटी का 90% बनाए रखते हैं। प्रत्येक कदम N पर हम N-1 कदमों के कुल वेलोसिटी का 90% उपयोग करेंगे।
इस बिंदु पर, मैं आपको प्रोत्साहित करता हूँ कि m और b और उनके ग्रेडिएंट्स के कुछ यादृच्छिक मान लेकर मोमेंटम के अपडेट नियम से देखें कि ऊपर या नीचे जाने पर पैरामीटर कैसे बदलते हैं।
अब, RMSprop का इम्प्लीमेंटेशन देखें। मोमेंटम वाले SGD की तरह, मुख्य बदलाव पैरामीटर अपडेट करते समय आता है।
पहले, हम दो अतिरिक्त पैरामीटर beta और epsilon (बिना मोमेंटम) के साथ नया फ़ंक्शन परिभाषित करेंगे:
def rmsprop_optimization(
   x, y, epochs=100, learning_rate=0.01, batch_size=32,
   stopping_threshold=1e-6, beta=0.9, epsilon=1e-8,
):
   """
   RMSprop optimization with support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize accumulators for squared gradients
   s_m = 0
   s_b = 0
   n = len(x)
   previous_loss = np.inf
साथ ही, फ़ंक्शन के भीतर हम स्क्वेयर्ड ग्रेडिएंट्स संचित करने के लिए दो नए वेरिएबल—s_m और s_b—बनाते हैं।
अब, जब हम अपडेट स्टेज पर पहुँचते हैं, तो स्क्वेयर्ड ग्रेडिएंट्स को फिर से गणना करते हैं और फिर पैरामीटर अपडेट करते हैं:
def rmsprop_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # RMSprop doesn't need gradient clipping
           # Update accumulators
           s_m = beta * s_m + (1 - beta) * (m_gradient**2)
           s_b = beta * s_b + (1 - beta) * (b_gradient**2)
           # Update parameters
           m -= learning_rate * m_gradient / (np.sqrt(s_m) + epsilon)
           b -= learning_rate * b_gradient / (np.sqrt(s_b) + epsilon)
           # The rest of the code is the same
यहाँ, हम दो नए पैरामीटर का उपयोग देखते हैं:
epsilon एक छोटा मान है, सामान्यतः 1e-8, ताकि अपडेट करते समय शून्य से भाग देने की स्थिति न बने।beta डिके रेट पैरामीटर है, आमतौर पर लगभग 0.9।पैरामीटर beta नियंत्रित करता है कि हम कितनी पुरानी हिस्ट्री पर ध्यान दें। ज़्यादा beta का मतलब है पिछले ग्रेडिएंट्स का लंबी अवधि का दृष्टिकोण; कम beta एल्गोरिदम को हाल के ग्रेडिएंट्स के प्रति अधिक प्रतिक्रियाशील बनाता है।
RMSprop के अपडेट नियम के पीछे के गणित की चिंता करने की ज़रूरत नहीं। महत्वपूर्ण इसकी तर्कसंगतता है।
मूल रूप से, ऊपर की चार पंक्तियाँ ये करती हैं:
व्यवहार में, RMSprop अक्सर बेसिक SGD या मोमेंटम वाले SGD से बेहतर काम करता है, खासकर नॉन-कन्वेक्स ऑप्टिमाइज़ेशन समस्याओं में जो डीप लर्निंग में आम हैं।
एक बार फिर, हम नया फ़ंक्शन परिभाषित करते हैं:
def adam_optimization(
   x,
   y,
   epochs=100,
   learning_rate=0.001,
   batch_size=32,
   stopping_threshold=1e-6,
   beta1=0.9,
   beta2=0.999,
   epsilon=1e-8,
):
   """
   Adam optimization with support for mini-batches.
   """
   # Initialize the model parameters
   m = np.random.randn()
   b = np.random.randn()
   # Initialize first and second moment vectors
   m_m, v_m = 0, 0
   m_b, v_b = 0, 0
   n = len(x)
   previous_loss = np.inf
   t = 0  # Initialize timestep
इस बार, हम प्रथम और द्वितीय मोमेंट वेक्टर तथा समय-चरण (टाइमस्टेप) कैप्चर करने के लिए पाँच नए वेरिएबल्स परिभाषित करते हैं। Adam के संदर्भ में:
1. फर्स्ट मोमेंट वेक्टर (m):
2. सेकंड मोमेंट वेक्टर (v):
इसके बाद, कोड तब तक वही रहता है जब तक हम ग्रेडिएंट्स नहीं निकाल लेते (Adam के लिए हमें उन्हें क्लिप करने की ज़रूरत नहीं):
def adam_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Adam doesn't need gradient clipping

           # Update biased first moment estimate
           m_m = beta1 * m_m + (1 - beta1) * m_gradient
           m_b = beta1 * m_b + (1 - beta1) * b_gradient
           # Update biased second raw moment estimate
           v_m = beta2 * v_m + (1 - beta2) * (m_gradient**2)
           v_b = beta2 * v_b + (1 - beta2) * (b_gradient**2)
           # Compute bias-corrected first moment estimate
           m_m_hat = m_m / (1 - beta1**t)
           m_b_hat = m_b / (1 - beta1**t)
           # Compute bias-corrected second raw moment estimate
           v_m_hat = v_m / (1 - beta2**t)
           v_b_hat = v_b / (1 - beta2**t)
           # Update parameters
           m -= learning_rate * m_m_hat / (np.sqrt(v_m_hat) + epsilon)
           b -= learning_rate * m_b_hat / (np.sqrt(v_b_hat) + epsilon)
       # The rest of the code is the same
एक बार फिर, इन पंक्तियों की गणितीय जटिलता की चिंता न करें। व्यवहार में, आपको Adam को शून्य से शायद ही कभी लागू करना पड़े—आपको इसके अपडेट नियम की सहज समझ जानना पर्याप्त है।
फर्स्ट मोमेंट मोमेंटम जैसा काम करता है—पिछले ग्रेडिएंट्स को समेटकर दिशा और वेग का बोध देता है। इससे Adam सुसंगत दिशाओं में तेज़ी से बढ़ता है और शोरयुक्त ग्रेडिएंट लैंडस्केप में दोलनों को कम करता है।
सेकंड मोमेंट, RMSprop की तरह, हर पैरामीटर के लिए लर्निंग रेट एडॉप्ट करता है। यह पैरामीटर अपडेट्स को प्रभावी रूप से नॉर्मलाइज़ करता है—बड़े ग्रेडिएंट वाले पैरामीटरों के लिए सीखना धीमा और छोटे ग्रेडिएंट वाले पैरामीटरों के लिए तेज़ करता है। इससे Adam अलग-अलग स्केल के पैरामीटरों को प्रभावी ढंग से संभालता है।
Adam इन मूविंग एवरेजेज़ के लिए बायस करेक्शन भी शामिल करता है, जो ट्रेनिंग के शुरुआती चरणों में खासा महत्वपूर्ण है। यह करेक्शन Adam को अधिक सटीक स्टेप साइज के साथ शुरू करने में मदद करता है, जिससे शुरुआती प्रगति तेज़ हो सकती है।
इन तत्वों को मिलाकर, Adam अक्सर सरल ऑप्टिमाइज़ेशन विधियों की तुलना में तेज़ कन्वर्ज करता है। यह शोरयुक्त ग्रेडिएंट्स, नॉन-स्टेशनरी उद्देश्यों, या बहुत बड़े डेटासेट वाली समस्याओं में विशेष रूप से प्रभावी है। Adam की अनुकूलनशील प्रकृति इसे शुरुआती लर्निंग रेट के प्रति तुलनात्मक रूप से असंवेदनशील बनाती है, इसलिए अक्सर अन्य तरीकों की तुलना में कम हाइपरपैरामीटर ट्यूनिंग चाहिए होती है।
अब, देखते हैं कि पहले देखी गई सारणी कैसे जनरेट करें:
comparison_table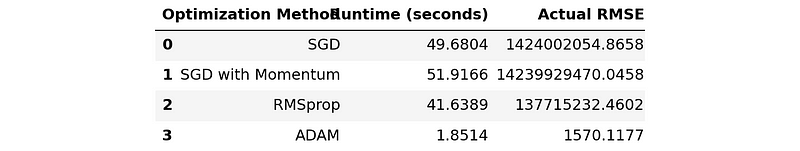
हम run_optimization नामक फ़ंक्शन परिभाषित करते हैं जो हमारे ऑप्टिमाइज़ेशन फ़ंक्शनों का उपयोग करके लिनियर रिग्रेशन मॉडल ट्रेन करता है। यह फ़ंक्शन रनटाइम और RMSE स्कोर भी कैप्चर करेगा:
import time
def run_optimization(opt_func, x, y, **kwargs):
   # Start a timer
   start_time = time.time()

   # Run the optimization function
   m, b = opt_func(x, y, **kwargs)

   # End the timer
   end_time = time.time()
   # Run the model on the test set with found parameters
   y_preds = model(m, test_xy[:, 0], b)
   y_preds_denormalized = y_preds * std[1] + mean[1]
   y_true_denormalized = test_xy[:, 1] * std[1] + mean[1]

   # Compute MSE and RMSE
   actual_mse = np.mean((y_true_denormalized - y_preds_denormalized) ** 2)
   return end_time - start_time, np.sqrt(actual_mse)
अब, हम इस फ़ंक्शन को चारों ऑप्टिमाइज़ेशन फ़ंक्शनों के लिए कॉल करेंगे और परिणामों को एक सूची में स्टोर करेंगे, जहाँ प्रत्येक आइटम एक तीन-टपल होगा (एल्गोरिदम का नाम, रन टाइम सेकंड में, RMSE स्कोर):
# Run all optimization methods
results = []
results.append(
   (
       "SGD",
       *run_optimization(
           stochastic_gradient_descent,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
       ),
   )
)
results.append(
   (
       "SGD with Momentum",
       *run_optimization(
           stochastic_gradient_descent_with_momentum,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
           momentum=0.9,
       ),
   )
)
results.append(
   (
       "RMSprop",
       *run_optimization(
           rmsprop_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta=0.9,
           epsilon=1e-8,
       ),
   )
)
results.append(
   (
       "Adam",
       *run_optimization(
           adam_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta1=0.9,
           beta2=0.999,
           epsilon=1e-8,
       ),
   )
)
निष्पक्ष तुलना के लिए, हम लर्निंग रेट, epochs की संख्या और बैच साइज समान रखते हैं।
इसके बाद, हम अपनी तालिका बना सकते हैं:
from tabulate import tabulate  # pip install tabulate
# Create and print the table
headers = ["Optimization Method", "Runtime (seconds)", "Actual RMSE"]
print(tabulate(results, headers=headers, floatfmt=".4f"))
# Save the table
pd.DataFrame(results, columns=headers).to_csv("optimization_results.csv", index=False)
अंतिम परिणाम इस प्रकार है:
Optimization Method      Runtime (seconds)       Actual RMSE
---------------------  -------------------  ----------------
SGD                                49.9305   1424002054.8658
SGD with Momentum                  50.7744  14239929470.0458
RMSprop                            41.9895    137715232.4602
Adam                                1.8462         1570.1177
आगे बढ़ने से पहले, मैं आपको प्रत्येक ऑप्टिमाइज़ेशन फ़ंक्शन के पैरामीटरों के साथ खेलने के लिए प्रोत्साहित करता हूँ। संभावना है कि आप, खासकर Adam, को लर्निंग रेट समायोजित करके, बैच साइज बढ़ाकर या बायस नियंत्रित करके और तेज़ तथा अधिक सटीक बना सकें।
ट्यूटोरियल के शुरुआत में देखे गए प्लॉट को बनाने और तुलना स्क्रिप्ट के पूरे कोड के लिंक के लिए निष्कर्ष अनुभाग देखें।
व्यवहार में Adam का उपयोग करने के लिए इतना लंबा लेख पढ़ना और इसे खुद से शून्य से लिखना आवश्यक नहीं है। इसका PyTorch इम्प्लीमेंटेशन डीप लर्निंग में किसी भी सुपरवाइज्ड लर्निंग टास्क के लिए पर्याप्त है।
यहाँ एक छोटा-सा, न्यूनतम कोड स्निपेट है जो Adam ऑप्टिमाइज़र को torch.optim मॉड्यूल से उपयोग करने वाले एक सामान्य PyTorch वर्कफ़्लो का खाका देता है:
# Import necessary modules
import torch
import torch.nn as nn
import torch.optim as optim
# Define your model
model = nn.Sequential(
   nn.Linear(10, 50),
   nn.ReLU(),
   nn.Linear(50, 1)
)
# Initialize Adam optimizer
optimizer = optim.Adam(model.parameters(), lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0)
# Training loop
for epoch in range(num_epochs):
   for batch in dataloader:
       # Zero the gradients
       optimizer.zero_grad()

       # Forward pass
       outputs = model(batch)
       loss = criterion(outputs, targets)

       # Backward pass
       loss.backward()

       # Update weights
       optimizer.step()
# Adjusting learning rate
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=30, gamma=0.1)
for epoch in range(num_epochs):
   train(...)
   scheduler.step()
PyTorch और इसके ऑप्टिमाइज़ेशन एल्गोरिदम के बारे में अधिक जानने के लिए, DataCamp का यह प्रारंभिक कोर्स देखें:
इस लेख में, हमने लोकप्रिय Adam ऑप्टिमाइज़र की बारीकियाँ सीखीं। हमने इसकी सहज समझ से शुरुआत की—इसके बुनियादी एल्गोरिदम जैसे ग्रेडिएंट डिसेंट, SGD और RMSprop पर चर्चा करके। हमने देखा कि Adam इनके मुख्य विचारों को कैसे जोड़ता है, और नतीजतन एक अत्यंत लचीला और उच्च-प्रदर्शन एल्गोरिदम बनता है।
इसके बाद, हमने केवल NumPy का उपयोग करके Python में Adam Optimizer कैसे लागू करें, यह कवर किया। इसकी सहज समझ की तरह, हमने कोड को भी बुनियादी एल्गोरिदम से बनाते हुए—मिनी-बैच ग्रेडिएंट डिसेंट से लेकर RMSprop और फिर Adam तक—तैयार किया। एक साधारण बेंचमार्किंग स्क्रिप्ट बनाकर हमने गति और प्रदर्शन के लिहाज़ से Adam और अन्य एल्गोरिदम के बीच चौंकाने वाला अंतर भी देखा।
आखिर में, हमने दिखाया कि व्यवहार में डीप लर्निंग समस्याएँ हल करने के लिए PyTorch में Adam का उपयोग कैसे करें। यहाँ उन स्क्रिप्ट्स के लिंक हैं जिन्हें हमने ट्यूटोरियल में उपयोग किया है:
और PyTorch व इसके ऑप्टिमाइज़ेशन फ़ंक्शनों के बारे में और जानने के लिए कुछ संबंधित संसाधन:
पढ़ने के लिए धन्यवाद!
सर्वश्रेष्ठ PyTorch कोर्स
कोर्स
कोर्स
कोर्स
