
Kurs
Einführung in Deep Learning mit PyTorch
4 Std.
90.9K
Adam (Adaptive Moment Estimation) ist ein verbreiteter Optimierungsalgorithmus im Machine Learning, vor allem im Deep Learning.
Adam kombiniert die Kernideen zweier robuster Verfahren: Momentum und RMSprop. Er heißt adaptiv, weil er die Lernrate für jeden Parameter individuell anpasst.
Die wichtigsten Merkmale und Vorteile:
Kurz gesagt: Adam lässt Modelle effizienter lernen, indem er die Lernrate pro Parameter fortlaufend anpasst und so meist deutlich schneller konvergiert als stochastic gradient descent. Für viele Deep-Learning-Anwendungen ist er daher eine starke Standardwahl.
Adam vereint zentrale Ideen mehrerer wichtiger Optimierungsalgorithmen, verstärkt ihre Stärken und adressiert ihre Schwächen. Bevor wir die Intuition hinter Adam wirklich greifen und ihn in Python umsetzen, frischen wir diese Bausteine auf.
Um die Intuition hinter den Algorithmen zu verstehen, knüpfen wir an die Analogie aus der Einleitung an.
Stell dir vor, du bist mit verbundenen Augen in schwierigem Hügelland und sollst den tiefsten Punkt finden. Die „Hügeligkeit“ entspricht der Loss-Funktion eines Machine-Learning-Modells. Das globale Minimum ist die optimale Lösung.
Deine aktuelle Position steht für den aktuellen Zustand der Modellparameter. Die Höhe an einem Punkt ist der Loss-Wert für diese Parameter. Deine Art der Fortbewegung entspricht der mathematischen Anpassung der Parameter.
Jeder Optimierungsalgorithmus ist eine Strategie, diese Landschaft zu durchqueren: Er sagt dir, wohin der nächste Schritt geht und wie groß er sein sollte. Manche schauen sich erst die ganze Umgebung an, andere handeln schneller auf Basis begrenzter Informationen.
Wieder andere nutzen Werkzeuge wie Momentum und adaptive Schrittweiten: Ein guter Solver weiß, wann er Gas geben und wann er Tempo rausnehmen muss.
Gradient Descent ist der Klassiker der Optimierung im Machine Learning und bildet das Fundament vieler Verfahren.
Mit Gradient Descent (GD) tastest du vor jedem Schritt die gesamte Umgebung ab (das volle Dataset). Das ist sehr genau bei der Wahl der Abwärtsrichtung, kostet aber Zeit. Du gehst stets in Richtung des steilsten Abstiegs – damit zuverlässig bergab. Landest du aber in einer kleinen Senke (lokales Minimum), bleibst du womöglich stecken und übersiehst ein tieferes Tal anderswo.
Haupteigenschaften von GD:
Hier hast du es eilig und keine Zeit, die volle Umgebung zu prüfen. Stattdessen checkst du nur einen zufälligen Punkt in deiner Nähe (ein Datenpunkt). Das macht jeden Schritt schneller, aber ungenauer. Alternativ nimmst du kleine Batches – Mini-Batch Gradient Descent –, darauf kommen wir gleich zurück.
Dein Weg ist unruhiger als beim klassischen GD – manchmal sogar mit kurzen Anstiegen. Dieses „Rauschen“ ist oft ein Vorteil: Lokale Minima lassen sich leichter verlassen.
Je näher du dem Talboden kommst, solltest du kleinere Schritte machen (Lernrate verringern), um nicht am Minimum vorbeizuschießen.
Haupteigenschaften von SGD:
Hinweis: An dieser Stelle empfehle ich dringend unseren separaten Artikel zu GD und SGD. Dort findest du die Details beider Algorithmen – und es hilft dir, den kommenden Code-Teil besser zu verstehen.
Jetzt fährst du auf einem Skateboard durch die Hügel. Stoßt du dich in eine Richtung ab, hält dich der Schwung eine Weile auf Kurs.
Dieses Momentum ist wie ein gleitender Mittelwert deiner vergangenen Richtungen. Es hilft, kleine Bodenwellen und Dellen zu überrollen – und vielleicht sogar ein tieferes Tal weiter vorn zu finden.
Bleibst du eine Weile in eine Richtung, baut sich Schwung auf und du wirst schneller. So konvergierst du in Regionen mit gleichmäßiger Neigung zügiger zum Minimum.
Haupteigenschaften von SGD mit Momentum:
Denk an Hightech-Schuhe, die ihren Grip dem Untergrund anpassen. Sie verfolgen die Steigung in jede Richtung und halten einen exponentiell abklingenden Durchschnitt der quadrierten Gradienten. Wo die Steigung stark variiert, geben sie dir mehr Halt – du machst kleinere, vorsichtige Schritte. In glatteren Regionen erlauben sie längere Schritte.
Diese adaptive „Schrittgröße“ hilft, steile wie flache Passagen sicher zu meistern und übergroße Schritte in steilen Zonen bzw. zu kleine in flachen zu vermeiden.
Haupteigenschaften von RMSprop:
Adam ist wie die Kombination aus deinem Skateboard (Momentum) und den adaptiven Schuhen (RMSprop) – plus einem cleveren Navi.
Das Skateboard (Momentum) hält dich in der richtigen Richtung. In glatten, gleichmäßig abfallenden Bereichen kommst du damit schnell voran. In schwierigerem Terrain bleibst du kontrolliert, aber stetig unterwegs.
Die adaptiven Schuhe (RMSprop) spüren, wohin du gehst, und passen den Grip an. Das smarte Navi (Bias-Korrektur) ist vor allem am Start wichtig, wenn du zufällig positioniert bist und das Gelände noch nicht kennst.
Diese Kombination macht Adam oft extrem effizient bei der Suche nach dem tiefsten Punkt (der Lösung) und robust gegenüber unterschiedlichen „Geländearten“ (Problemklassen im Machine Learning).
Kernmerkmale von Adam:
Wie du siehst, baut jeder genannte Algorithmus auf dem vorherigen auf – mit dem Ziel, die Suche nach dem Minimum für verschiedene Optimierungsprobleme zu verbessern.
Bevor wir Adam und die anderen Algorithmen implementieren, hier eine Übersichtstabelle mit Laufzeit und RMSE auf einem Beispiel-Regressionstask:
import pandas as pd
# Disable scientific notation
pd.set_option("display.float_format", "{:.4f}".format)
comparison_table = pd.read_csv('optimization_results.csv')
comparison_table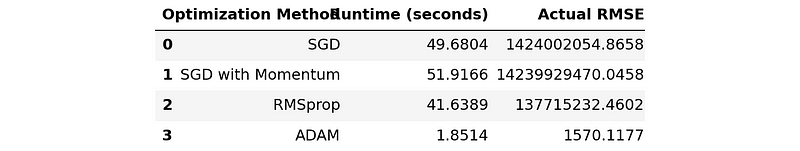
Die Tabelle zeigt den enormen Unterschied nur bedingt – daher hier ein Balkendiagramm:
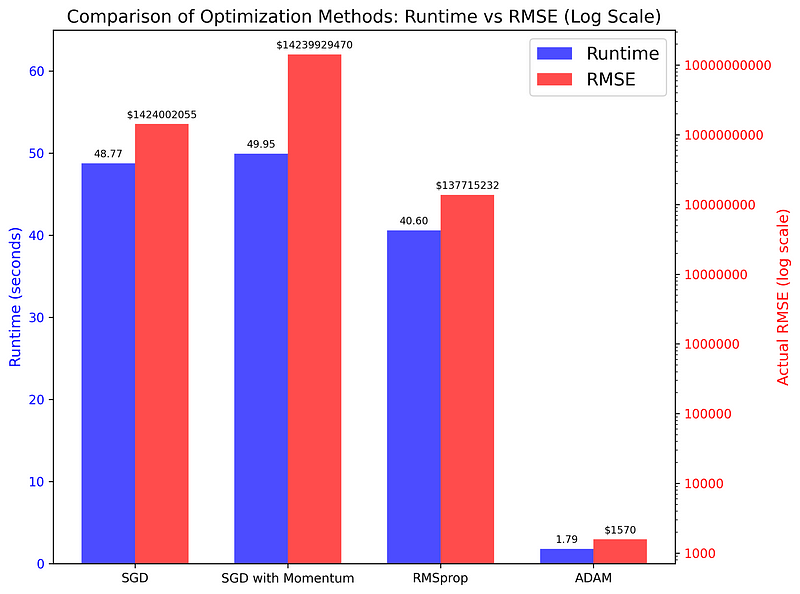
Der Plot vergleicht Laufzeit und RMSE der vier Algorithmen auf einem einfachen Regressionstask. Die Unterschiede sind gewaltig (Achtung: rechte Achse ist logarithmisch) – Adam ist in den meisten Fällen die beste Wahl.
Den Code zur Erstellung von Tabelle und Plot schauen wir uns später an.
Nachdem wir die Grundlagen und die Intuition hinter Adam geklärt haben, setzen wir ihn in Python um. Unterwegs erläutern wir die nötige Mathematik. Wir bauen den Code Schritt für Schritt auf – beginnend mit Stochastic Gradient Descent.
SGD nutzt in der reinen Form nur einen einzelnen Datenpunkt pro Schritt. In der Praxis wird diese „Vanilla“-Variante selten genutzt, weil die Ergebnisse stark rauschen (der Pfad im Hügelland ist erratisch).
Um das zu mildern, verwendet man meist Mini-Batch Gradient Descent: Vor jedem Schritt werden kleine Batches, etwa 32, 64 oder 128 Punkte, ausgewertet (vergleichbar mit dem Scannen eines schmalen Korridors statt einer 360-Grad-Rundumsicht).
Mit dieser SGD-Variante bauen wir den Fundamentcode für Adam auf.
Damit der Code möglichst einfach bleibt, wählen wir ein kleines Regressionsproblem: Diamantpreise anhand von Karat vorhersagen.
Zuerst importieren wir die nötigen Bibliotheken:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Dann laden wir das Diamonds-Dataset aus Seaborn, ziehen eine Stichprobe und bauen Feature- und Zielvektoren:
# Load the data
dataset_size = 20_000
diamonds = sns.load_dataset("diamonds")
# Extract the target and the feature
xy = diamonds[["carat", "price"]].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
Output:
(20000, 2)Für lineare Regression normalisieren wir die Daten:
# Normalize the data
mean = np.mean(xy, axis=0)
std = np.std(xy, axis=0)
xy_normalized = (xy - mean) / std
Anschließend teilen wir in Trainings- und Testdaten:
# Split the data
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(16000, 2)Zur Lösung gäbe es viele Modelle, wir bleiben bei Einfacher Linearer Regression und definieren sie als Funktion:
def model(m, x, b):
   """
   Simple Linear Regression: f(x) = m * x + b, where
   - x: diamond carat
   - m: price increase per carat
   - b: base diamond price
   - f(x): predicted diamond price
   """

   return m * x + b
Unser Modell hat nur zwei Parameter, m und b. Aufgabe von SGD (und später Adam) ist es, optimale Werte dafür zu finden.
Wir definieren außerdem die Loss-Funktion Mean Squared Error, die minimiert werden soll:
def mean_squared_error(y_true, y_pred):
   """
   MSE as a loss function. It is defined as:
   Loss = (1/n) * Σ((y - f(x))²), where:
   - n: the length of the dataset
   - y: the true diamond price
   - f(x): predicted diamond price, i.e. m*x + b
   """
   return np.mean((y_true - y_pred) ** 2)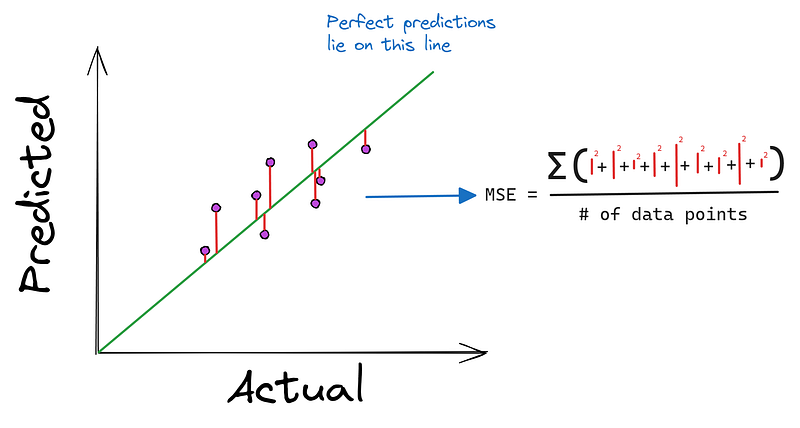
Nun definieren wir stochastic_gradient_descent mit sechs Argumenten:
x und y sind Feature und Zielvariable.epochs gibt an, wie oft wir den Abstieg durchführen (mehr dazu gleich).learning_rate ist die Schrittweite.batch_size steuert, wie oft Parameterupdates erfolgenstopping_threshold setzt die minimale Loss-Verbesserung pro Schrittdef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infZunächst initialisieren wir die zu optimierenden Parameter zufällig (Start an einem Zufallspunkt im Hügelland). Die anfängliche Loss setzen wir auf unendlich – der Ausgangszustand ist „ungelöst“.
Dann starten wir eine for-Schleife für epochs Iterationen. Darin mischen wir die Daten durch, um Reihenfolgeeffekte zu vermeiden:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       # Shuffle the data
       indices = np.random.permutation(n)
       x = x[indices]
       y = y[indices]
Dann folgt eine weitere Schleife gesteuert von batch_size, in der wir das aktuelle Batch ziehen:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           x_batch = x[j:j + batch_size]
           y_batch = y[j:j + batch_size]
In der inneren Schleife berechnen wir die Gradienten (partielle Ableitungen) beider Parameter – also die Richtung des nächsten Schritts:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Make predictions with current m, b
           y_pred = model(m, x_batch, b)
           # Compute the gradients
           m_gradient = 2 * np.mean(x_batch * (y_batch - y_pred))
           b_gradient = 2 * np.mean(y_batch - y_pred)
Danach folgt ein wichtiger Schritt: Gradient Clipping.
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           clip_value = 1.0
           m_gradient = np.clip(m_gradient, -clip_value, clip_value)
           b_gradient = np.clip(b_gradient, -clip_value, clip_value)
Gradient Clipping verhindert das gängige Problem der „explodierenden Gradienten“, also sehr große Beträge, die Updates instabil machen.
Nach dem Clipping aktualisieren wir die Parameter mit der Lernrate (ein Schritt in Gradientenrichtung, skaliert durch die Lernrate):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           m -= learning_rate * m_gradient
           b -= learning_rate * b_gradient
Nach allen Batches berechnen wir die Loss für die aktuelle Epoche (wie weit sind wir schon hinabgestiegen?):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       y_pred = model(m, x, b)
       current_loss = loss(y, y_pred)
Ist die Verbesserung kleiner als stopping_threshold, brechen wir ab:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       if abs(previous_loss - current_loss) < stopping_threshold:
           break
       previous_loss = current_loss
Am Ende (nach allen Epochen oder Abbruch) geben wir die optimierten m und b zurück:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       ...
return m, bJetzt fügen wir momentum hinzu. Der Code unterscheidet sich kaum von der Mini-Batch-Version.
Wir definieren eine neue Funktion mit einem momentum-Parameter:
def stochastic_gradient_descent_with_momentum(
       x, y, epochs=100, learning_rate=0.01, batch_size=32,
       stopping_threshold=1e-6, momentum=0.9
):
   """
   SGD with momentum and support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize velocity terms
   v_m = 0
   v_b = 0

   n = len(x)
   previous_loss = np.inf
Innerhalb der Funktion halten zwei Variablen, v_m und v_b, den aufsummierten Gradienten-Schwung fest. Zu Beginn sind sie 0, da es noch keinen Schwung gibt.
Der restliche Code bleibt gleich – bis nach dem Clipping der Gradienten:
def sgd_with_momentum(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update velocity terms
           v_m = momentum * v_m + learning_rate * m_gradient
           v_b = momentum * v_b + learning_rate * b_gradient
           # Update the model parameters using velocity
           m -= v_m
           b -= v_b
Sobald die Gradienten geclippt sind, aktualisieren wir die Velocity gemäß Momentum-Regel. In kompakter Form:
# Initialize
v_m = 0
v_b = 0
...
# Update velocity terms
v_m = momentum * v_m + learning_rate * m_gradient
v_b = momentum * v_b + learning_rate * b_gradient
# Update the model parameters using velocity
m -= v_m
b -= v_b
Die Velocity v_* akkumuliert Gradienten über die Zeit. Bewegen wir uns konsistent in eine Richtung, gewinnen wir Tempo.
In Regionen mit schnell wechselndem Gradienten (engem Tal) dämpft Momentum Schwingungen. So vermeiden wir, an lokalen Minima oder Sattelpunkten zu hängen zu bleiben.
Der Term momentum * v_m sorgt für die Aufsummierung. Ein großer positiver Gradient erzeugt eine entsprechend große Velocity – das Update wird stärker. Momentum 0,9 bedeutet: 90% der vorherigen Velocity bleiben für den nächsten Schritt erhalten. In Schritt N nutzen wir 90% der aufsummierten Velocity aus N-1 Schritten.
Probier an dieser Stelle ruhig eigene Werte für m, b und ihre Gradienten aus und sieh dir an, wie sich die Parameter mit der Momentum-Regel verändern – bergauf vs. bergab.
Schauen wir uns nun RMSprop an. Wie bei SGD mit Momentum liegt die wesentliche Änderung in den Parameterupdates.
Wir definieren eine neue Funktion mit zwei zusätzlichen Parametern, beta und epsilon (ohne Momentum):
def rmsprop_optimization(
   x, y, epochs=100, learning_rate=0.01, batch_size=32,
   stopping_threshold=1e-6, beta=0.9, epsilon=1e-8,
):
   """
   RMSprop optimization with support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize accumulators for squared gradients
   s_m = 0
   s_b = 0
   n = len(x)
   previous_loss = np.inf
Im Funktionskörper sammeln wir die quadrierten Gradienten in s_m und s_b.
Beim Update berechnen wir die quadrierten Gradienten neu und aktualisieren dann die Parameter:
def rmsprop_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # RMSprop doesn't need gradient clipping
           # Update accumulators
           s_m = beta * s_m + (1 - beta) * (m_gradient**2)
           s_b = beta * s_b + (1 - beta) * (b_gradient**2)
           # Update parameters
           m -= learning_rate * m_gradient / (np.sqrt(s_m) + epsilon)
           b -= learning_rate * b_gradient / (np.sqrt(s_b) + epsilon)
           # The rest of the code is the same
Hier kommen zwei Parameter ins Spiel:
epsilon ist ein kleiner Wert (typisch 1e-8), um Division durch Null zu verhindern.beta ist die Abklingrate, meist um 0,9.Der Parameter beta steuert, wie viel Historie wir berücksichtigen: höher = langfristiger Blick, niedriger = reaktiver auf aktuelle Gradienten.
Du musst die Mathematik hinter der Update-Regel nicht auswendig können – wichtig ist die Logik dahinter.
Im Kern bewirken die vier Zeilen:
In der Praxis schlägt RMSprop oft einfaches SGD oder SGD mit Momentum – besonders bei nichtkonvexen Problemen im Deep Learning.
Erneut definieren wir eine neue Funktion:
def adam_optimization(
   x,
   y,
   epochs=100,
   learning_rate=0.001,
   batch_size=32,
   stopping_threshold=1e-6,
   beta1=0.9,
   beta2=0.999,
   epsilon=1e-8,
):
   """
   Adam optimization with support for mini-batches.
   """
   # Initialize the model parameters
   m = np.random.randn()
   b = np.random.randn()
   # Initialize first and second moment vectors
   m_m, v_m = 0, 0
   m_b, v_b = 0, 0
   n = len(x)
   previous_loss = np.inf
   t = 0  # Initialize timestep
Hier nutzen wir fünf neue Variablen für erste und zweite Momentvektoren sowie den Zeitschritt. Bei Adam gilt:
1. Erster Momentvektor (m):
2. Zweiter Momentvektor (v):
Der Code bleibt gleich, bis wir die Gradienten berechnet haben (Clipping ist bei Adam nicht nötig):
def adam_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Adam doesn't need gradient clipping

           # Update biased first moment estimate
           m_m = beta1 * m_m + (1 - beta1) * m_gradient
           m_b = beta1 * m_b + (1 - beta1) * b_gradient
           # Update biased second raw moment estimate
           v_m = beta2 * v_m + (1 - beta2) * (m_gradient**2)
           v_b = beta2 * v_b + (1 - beta2) * (b_gradient**2)
           # Compute bias-corrected first moment estimate
           m_m_hat = m_m / (1 - beta1**t)
           m_b_hat = m_b / (1 - beta1**t)
           # Compute bias-corrected second raw moment estimate
           v_m_hat = v_m / (1 - beta2**t)
           v_b_hat = v_b / (1 - beta2**t)
           # Update parameters
           m -= learning_rate * m_m_hat / (np.sqrt(v_m_hat) + epsilon)
           b -= learning_rate * m_b_hat / (np.sqrt(v_b_hat) + epsilon)
       # The rest of the code is the same
Lass dich von der Mathematik nicht abschrecken – in der Praxis implementierst du Adam selten von Grund auf. Wichtig ist, die Intuition hinter den Updates zu verstehen.
Der erste Moment wirkt wie Momentum: Er sammelt vergangene Gradienten und gibt Richtung und Tempo. Das beschleunigt die Bewegung in konsistenten Richtungen und dämpft Rauschen.
Der zweite Moment (wie bei RMSprop) passt die Lernrate pro Parameter an: Große Gradienten werden gebremst, kleine beschleunigt. So kommt Adam mit Parametern auf unterschiedlichen Skalen gut zurecht.
Zusätzlich korrigiert Adam den Bias dieser gleitenden Durchschnitte – gerade zu Beginn wichtig. So startet Adam mit passenderen Schrittgrößen und macht oft schneller Fortschritte.
Durch diese Kombination konvergiert Adam oft schneller als einfachere Verfahren. Er ist besonders effektiv bei rauschigen Gradienten, nichtstationären Zielen oder sehr großen Datensätzen. Dank seiner Adaptivität ist er oft weniger empfindlich gegenüber der initialen Lernrate und braucht weniger Hyperparameter-Tuning.
So erzeugst du die oben gezeigte Übersichtstabelle:
comparison_table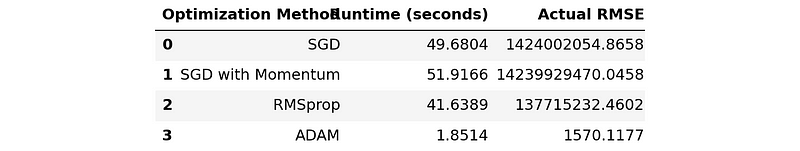
Wir definieren eine Funktion run_optimization, die ein lineares Regressionsmodell mit unseren Optimierungsfunktionen trainiert – inklusive Messung von Laufzeit und RMSE:
import time
def run_optimization(opt_func, x, y, **kwargs):
   # Start a timer
   start_time = time.time()

   # Run the optimization function
   m, b = opt_func(x, y, **kwargs)

   # End the timer
   end_time = time.time()
   # Run the model on the test set with found parameters
   y_preds = model(m, test_xy[:, 0], b)
   y_preds_denormalized = y_preds * std[1] + mean[1]
   y_true_denormalized = test_xy[:, 1] * std[1] + mean[1]

   # Compute MSE and RMSE
   actual_mse = np.mean((y_true_denormalized - y_preds_denormalized) ** 2)
   return end_time - start_time, np.sqrt(actual_mse)
Diese Funktion rufen wir viermal auf – für jeden Optimierer – und speichern Name, Laufzeit (Sekunden) und RMSE als Tupel:
# Run all optimization methods
results = []
results.append(
   (
       "SGD",
       *run_optimization(
           stochastic_gradient_descent,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
       ),
   )
)
results.append(
   (
       "SGD with Momentum",
       *run_optimization(
           stochastic_gradient_descent_with_momentum,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
           momentum=0.9,
       ),
   )
)
results.append(
   (
       "RMSprop",
       *run_optimization(
           rmsprop_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta=0.9,
           epsilon=1e-8,
       ),
   )
)
results.append(
   (
       "Adam",
       *run_optimization(
           adam_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta1=0.9,
           beta2=0.999,
           epsilon=1e-8,
       ),
   )
)
Für einen fairen Vergleich halten wir Lernrate, Epochenanzahl und Batchgröße konsistent.
Danach erzeugen wir die Tabelle:
from tabulate import tabulate  # pip install tabulate
# Create and print the table
headers = ["Optimization Method", "Runtime (seconds)", "Actual RMSE"]
print(tabulate(results, headers=headers, floatfmt=".4f"))
# Save the table
pd.DataFrame(results, columns=headers).to_csv("optimization_results.csv", index=False)
Das finale Ergebnis sieht so aus:
Optimization Method      Runtime (seconds)       Actual RMSE
---------------------  -------------------  ----------------
SGD                                49.9305   1424002054.8658
SGD with Momentum                  50.7744  14239929470.0458
RMSprop                            41.9895    137715232.4602
Adam                                1.8462         1570.1177
Experimentiere gerne mit den Parametern der Optimierer. Besonders Adam lässt sich oft noch schneller und genauer machen – etwa über Lernrate, Batchgröße oder Bias-Kontrolle.
In der Schlusssektion findest du Links zum vollständigen Vergleichsskript und zur Plot-Erstellung.
In der Praxis musst du Adam nicht selbst implementieren. Die PyTorch-Variante ist für nahezu jeden Supervised-Learning-Task im Deep Learning bestens geeignet.
Hier ein minimalistischer PyTorch-Workflow mit dem Adam-Optimizer aus dem Modul torch.optim:
# Import necessary modules
import torch
import torch.nn as nn
import torch.optim as optim
# Define your model
model = nn.Sequential(
   nn.Linear(10, 50),
   nn.ReLU(),
   nn.Linear(50, 1)
)
# Initialize Adam optimizer
optimizer = optim.Adam(model.parameters(), lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0)
# Training loop
for epoch in range(num_epochs):
   for batch in dataloader:
       # Zero the gradients
       optimizer.zero_grad()

       # Forward pass
       outputs = model(batch)
       loss = criterion(outputs, targets)

       # Backward pass
       loss.backward()

       # Update weights
       optimizer.step()
# Adjusting learning rate
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=30, gamma=0.1)
for epoch in range(num_epochs):
   train(...)
   scheduler.step()
Mehr zu PyTorch und Optimierungsalgorithmen lernst du in diesem Einsteigerkurs von DataCamp:
In diesem Artikel hast du den beliebten Adam-Optimizer von Grund auf kennengelernt. Ausgehend von den Basisalgorithmen wie Gradient Descent, SGD und RMSprop haben wir die Intuition aufgebaut und gesehen, wie Adam deren Stärken vereint – zu einem flexiblen und leistungsfähigen Verfahren.
Anschließend haben wir Adam in Python mit NumPy implementiert – Schritt für Schritt von Mini-Batch Gradient Descent über RMSprop bis zu Adam. Ein einfaches Benchmarking-Skript hat den deutlichen Geschwindigkeits- und Performance-Vorsprung von Adam gezeigt.
Zum Schluss haben wir gezeigt, wie du Adam in PyTorch so einsetzt, wie es in der Praxis üblich ist. Hier sind die Links zu den im Tutorial verwendeten Skripten:
Und ein paar weiterführende Ressourcen zu PyTorch und Optimierung:
Danke fürs Lesen!
Top-PyTorch-Kurse
Kurs
Kurs
Kurs
Tutorial
Mark Pedigo
10 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
DataCamp Team
3 Min.





