
Cours
Introduction au Deep Learning avec PyTorch
4 h
91.9K
Adam, acronyme de Adaptive Moment Estimation, est un algorithme d’optimisation utilisé en machine learning et, le plus souvent, en deep learning.
Adam combine les idées principales de deux techniques robustes : le momentum et RMSprop. On parle d’algorithme adaptatif car il ajuste le taux d’apprentissage pour chaque paramètre.
Voici ses caractéristiques et avantages clés :
En résumé, Adam rend l’apprentissage plus efficace en ajustant en continu le taux d’apprentissage de chaque paramètre et, par conséquent, converge bien plus vite que la descente de gradient stochastique classique. Pour de nombreux cas de deep learning, c’est un excellent choix par défaut.
Adam unifie des idées clés issues de quelques algorithmes d’optimisation majeurs, en renforçant leurs atouts tout en corrigeant leurs limites. Passons-les en revue pour saisir l’intuition d’Adam et l’implémenter en Python.
Pour comprendre l’intuition derrière ces algorithmes, poursuivons l’analogie de l’introduction.
Imaginez que vous avez les yeux bandés dans une région vallonnée complexe. Votre mission : trouver le point le plus bas. Le relief correspond à la fonction de perte d’un modèle de machine learning. Le « point le plus bas » (minimum global) est la solution optimale.
Relions les points : votre position actuelle représente l’état des paramètres du modèle. L’altitude en un point donné correspond à la valeur de perte pour ces paramètres. La manière dont vous vous déplacez équivaut aux ajustements des paramètres du modèle.
Chaque algorithme d’optimisation est une stratégie pour naviguer efficacement dans ce paysage, en indiquant où poser le pied et de quelle amplitude. Certains examinent toute la zone avant de décider, d’autres vont plus vite avec une information partielle.
D’autres encore utilisent des outils comme le momentum et l’adaptation de la taille de pas ; un bon solveur sait quand accélérer et quand lever le pied.
La descente de gradient est la base de l’optimisation en machine learning ; elle sert de fondation à de nombreux algorithmes.
Avec la descente de gradient (GD), vous « palpez » soigneusement toute la zone autour de vous (dataset complet) avant chaque pas. Cette analyse minutieuse vous indique précisément la pente la plus forte vers le bas, mais elle prend du temps. Vous avancez toujours dans la direction de la plus forte pente descendante. En revanche, si vous atteignez une petite cuvette (minimum local), vous pouvez y rester bloqué sans détecter un point encore plus bas ailleurs.
Caractéristiques clés de GD :
Ici, vous êtes pressé et n’avez pas le temps d’examiner toute la zone. Vous ne regardez qu’un point au hasard près de vos pieds (une donnée). Chaque pas est plus rapide mais moins précis. Vous pouvez aussi regarder un petit lot de points, c’est le mini-batch gradient descent, que nous voyons plus loin.
Votre trajectoire est plus erratique que celle de la descente de gradient ; parfois, on dirait un marin ivre. Il arrive que vous montiez. Ce « bruit » est en fait un atout : vous avez plus de chances d’échapper aux minima locaux.
Mais à l’approche du fond, il faut raccourcir les pas (diminuer le taux d’apprentissage) pour éviter de dépasser le point le plus bas.
Caractéristiques clés de SGD :
Remarque : à ce stade, nous vous recommandons vivement de lire notre article dédié à GD et SGD, qui approfondit ces deux algorithmes essentiels. Il vous aidera aussi à mieux comprendre la section de code qui arrive.
Vous êtes maintenant sur un skateboard dans les collines. Quand vous vous lancez, l’inertie vous maintient dans la même direction un certain temps.
Ce momentum ressemble à une moyenne mobile de vos directions passées. Il aide à franchir bosses et creux locaux, et peut vous conduire plus loin vers un point plus bas.
Si vous gardez une direction un moment, l’inertie s’accumule et vous allez plus vite. Vous convergeez ainsi plus vite vers le point le plus bas, surtout quand la pente est régulière.
Caractéristiques clés de SGD avec momentum :
Imaginez des chaussures high-tech qui ajustent leur adhérence selon le terrain. Elles suivent la pente dans chaque direction en conservant une moyenne exponentiellement décroissante des gradients au carré. Là où la pente varie fortement, elles augmentent l’adhérence et vous font faire de petits pas prudents. Sur les zones plus lisses, elles allongent la foulée.
Cette « taille de pas » adaptative vous aide à gérer pentes fortes et faibles, en évitant des pas trop grands en terrain escarpé ou trop petits en terrain plat.
Caractéristiques clés de RMSprop :
Adam, c’est la fusion de votre skateboard (momentum) avec vos chaussures adaptatives (RMSprop) et un système de navigation intelligent en plus.
La partie skateboard (momentum) vous maintient dans la bonne direction générale. Dans des zones à pente régulière et descendante, Adam vous permet d’aller vite. Sur des terrains plus chaotiques, il aide à garder un rythme stable et prudent.
Les chaussures adaptatives (RMSprop) « sentent » la direction et ajustent l’adhérence du skateboard. Le système de navigation (correction de biais) est crucial au départ, quand on part d’un point aléatoire et qu’on connaît peu le terrain.
Cette combinaison explique pourquoi Adam trouve souvent le point le plus bas (la solution) de manière très efficace et s’adapte bien à des terrains variés (problèmes de machine learning hétérogènes).
Caractéristiques clés d’Adam :
Comme vous l’avez vu, chaque algorithme cité s’appuie sur le précédent pour optimiser la recherche du point le plus bas en répondant à des difficultés différentes.
Avant de passer aux détails d’implémentation d’Adam et des autres méthodes, voici un tableau récapitulatif comparant le temps d’exécution et la RMSE de chacune sur un problème de régression simple :
import pandas as pd
# Disable scientific notation
pd.set_option("display.float_format", "{:.4f}".format)
comparison_table = pd.read_csv('optimization_results.csv')
comparison_table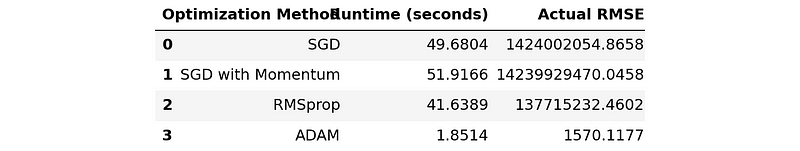
Ce tableau ne rend pas justice à l’écart immense entre Adam et les autres, alors traçons un diagramme en barres :
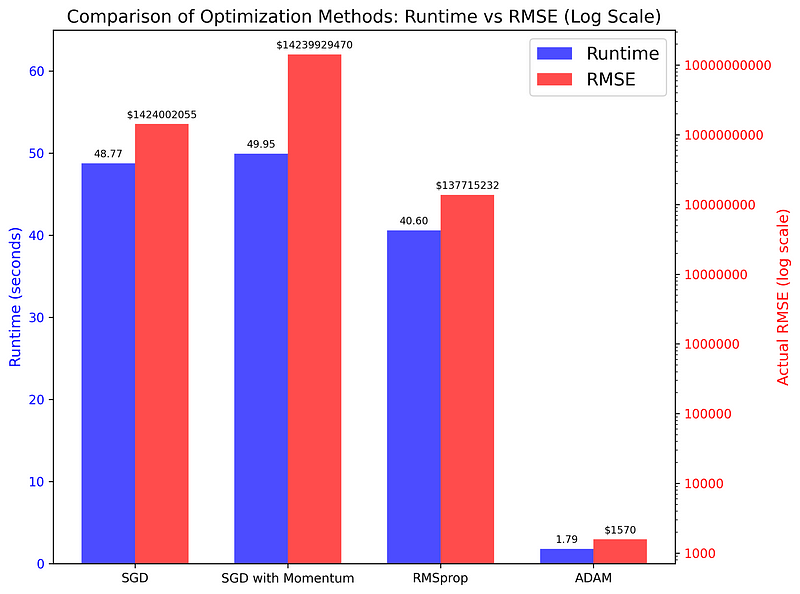
Ce graphique compare le temps d’exécution et la RMSE des quatre algorithmes sur une tâche de régression simple. Les écarts sont frappants (l’axe de droite est en échelle logarithmique), ce qui montre qu’Adam est souvent la meilleure option pour la plupart des tâches d’optimisation.
Nous verrons plus loin le code ayant produit ce tableau et ce graphique.
Maintenant que nous avons couvert les notions préalables et l’intuition d’Adam, passons à l’implémentation en Python. En chemin, nous expliquerons les éléments mathématiques nécessaires. Nous construirons le code pas à pas, en commençant par la descente de gradient stochastique.
Nous avons mentionné que SGD n’utilise qu’un seul point pour décider du prochain mouvement. En pratique, cette version « vanille » est rarement utilisée car ses résultats sont bruyants (trajectoire erratique).
Pour y remédier, on utilise souvent une variante appelée mini-batch gradient descent, qui s’appuie sur des lots de données (32, 64, 128, etc.) avant chaque mise à jour (comme balayer un couloir étroit plutôt qu’une vue à 360°).
Nous allons donc bâtir le socle d’Adam avec cette version de SGD.
Pour rester simple, choisissons une petite régression : prédire le prix des diamants à partir du carat.
Commençons par importer les bibliothèques nécessaires :
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Ensuite, chargeons le dataset Diamonds depuis Seaborn, échantillonnons-le et construisons les tableaux de variables explicatives et cible :
# Load the data
dataset_size = 20_000
diamonds = sns.load_dataset("diamonds")
# Extract the target and the feature
xy = diamonds[["carat", "price"]].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
Output:
(20000, 2)La régression linéaire nécessite de normaliser les données :
# Normalize the data
mean = np.mean(xy, axis=0)
std = np.std(xy, axis=0)
xy_normalized = (xy - mean) / std
Nous pouvons maintenant séparer les données en ensembles d’entraînement et de test :
# Split the data
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(16000, 2)Plusieurs modèles sont possibles ; pour rester clair, prenons une régression linéaire simple et définissons-la comme fonction :
def model(m, x, b):
   """
   Simple Linear Regression: f(x) = m * x + b, where
   - x: diamond carat
   - m: price increase per carat
   - b: base diamond price
   - f(x): predicted diamond price
   """

   return m * x + b
Notre modèle n’a que deux paramètres, m et b. La tâche de SGD (et plus tard d’Adam) est donc de trouver leurs valeurs optimales.
Définissons la fonction de perte, l’erreur quadratique moyenne (MSE), que nos algorithmes vont minimiser :
def mean_squared_error(y_true, y_pred):
   """
   MSE as a loss function. It is defined as:
   Loss = (1/n) * Σ((y - f(x))²), where:
   - n: the length of the dataset
   - y: the true diamond price
   - f(x): predicted diamond price, i.e. m*x + b
   """
   return np.mean((y_true - y_pred) ** 2)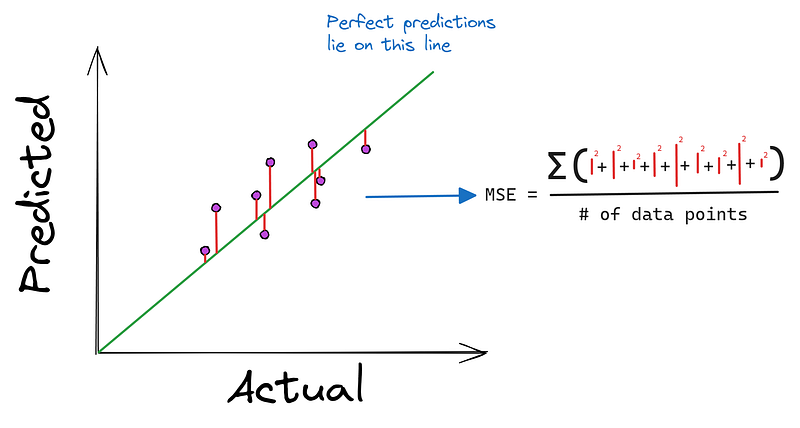
Définissons maintenant une fonction stochastic_gradient_descent qui accepte six arguments :
x et y représentent l’unique variable explicative et la cible.epochs désigne le nombre de passages d’apprentissage.learning_rate est la taille de pas.batch_size contrôle la fréquence des mises à jour des paramètresstopping_threshold définit la baisse minimale de perte attendue entre deux étapesdef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infDans la fonction, nous initialisons d’abord aléatoirement les paramètres à optimiser (départ aléatoire dans les collines). Nous fixons aussi la perte initiale à l’infini, représentant l’état non résolu du problème.
Puis nous lançons une boucle for de epochs itérations. À l’intérieur, nous mélangeons les données pour éviter l’apprentissage de motifs liés à l’ordre :
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       # Shuffle the data
       indices = np.random.permutation(n)
       x = x[indices]
       y = y[indices]
Ensuite, nous démarrons une autre boucle contrôlée par batch_size et extrayons le mini-batch courant :
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           x_batch = x[j:j + batch_size]
           y_batch = y[j:j + batch_size]
Dans cette boucle interne, nous calculons les gradients (dérivées partielles) des deux paramètres (où poser le prochain pas) :
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Make predictions with current m, b
           y_pred = model(m, x_batch, b)
           # Compute the gradients
           m_gradient = 2 * np.mean(x_batch * (y_batch - y_pred))
           b_gradient = 2 * np.mean(y_batch - y_pred)
Après avoir calculé les gradients, étape cruciale : le clipping des gradients :
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           clip_value = 1.0
           m_gradient = np.clip(m_gradient, -clip_value, clip_value)
           b_gradient = np.clip(b_gradient, -clip_value, clip_value)
Le gradient clipping évite le problème fréquent des gradients explosifs, où leur norme tend vers l’infini.
Après clipping, nous mettons à jour les paramètres via le taux d’apprentissage :
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           m -= learning_rate * m_gradient
           b -= learning_rate * b_gradient
Ensuite, après avoir parcouru tous les lots, nous calculons la perte de l’époque courante :
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       y_pred = model(m, x, b)
       current_loss = loss(y, y_pred)
Si la perte diminue de moins que stopping_threshold, on arrête l’entraînement :
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       if abs(previous_loss - current_loss) < stopping_threshold:
           break
       previous_loss = current_loss
À la fin (quand les époques sont épuisées ou le critère atteint), nous renvoyons m et b, désormais optimisés :
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       ...
return m, bAjoutons maintenant le momentum à SGD. Le code diffère peu de la version mini-batch.
Nous définissons une nouvelle fonction avec un paramètre momentum :
def stochastic_gradient_descent_with_momentum(
       x, y, epochs=100, learning_rate=0.01, batch_size=32,
       stopping_threshold=1e-6, momentum=0.9
):
   """
   SGD with momentum and support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize velocity terms
   v_m = 0
   v_b = 0

   n = len(x)
   previous_loss = np.inf
Dans la fonction, nous définissons deux variables supplémentaires, v_m et v_b, pour suivre l’accumulation de gradients, qui sert de momentum. On les initialise à 0, car on n’a pas encore d’inertie au départ.
Le reste du code est identique jusqu’au clipping des gradients :
def sgd_with_momentum(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update velocity terms
           v_m = momentum * v_m + learning_rate * m_gradient
           v_b = momentum * v_b + learning_rate * b_gradient
           # Update the model parameters using velocity
           m -= v_m
           b -= v_b
Une fois les gradients limités, on applique la règle de mise à jour du momentum aux termes de vitesse. Vue d’ensemble :
# Initialize
v_m = 0
v_b = 0
...
# Update velocity terms
v_m = momentum * v_m + learning_rate * m_gradient
v_b = momentum * v_b + learning_rate * b_gradient
# Update the model parameters using velocity
m -= v_m
b -= v_b
La vitesse v_* accumule les gradients au fil du temps. Si l’on progresse dans une direction cohérente, on gagne en vitesse dans cette direction.
Là où la pente varie vite (vallées étroites du paysage de perte), le momentum amortit les oscillations. On acquiert assez d’inertie pour éviter de se bloquer dans de petites variations locales (minima locaux, points selles).
Le terme momentum * v_m est celui qui accumule les gradients. Par exemple, un gradient positif important donne une grande vitesse et donc une mise à jour plus forte. Un momentum de 0,9 signifie que 90 % de la vitesse précédente est conservée au pas suivant. À l’étape N, on exploite 90 % de la vitesse cumulée des N-1 étapes.
À ce stade, essayez de choisir des valeurs aléatoires pour m et b et leurs gradients, puis appliquez la règle du momentum pour voir comment évoluent les paramètres en montée ou en descente.
Voyons maintenant l’implémentation de RMSprop. Comme SGD avec momentum, le changement majeur intervient lors de la mise à jour des paramètres.
On définit d’abord une nouvelle fonction avec deux paramètres additionnels, beta et epsilon (sans momentum) :
def rmsprop_optimization(
   x, y, epochs=100, learning_rate=0.01, batch_size=32,
   stopping_threshold=1e-6, beta=0.9, epsilon=1e-8,
):
   """
   RMSprop optimization with support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize accumulators for squared gradients
   s_m = 0
   s_b = 0
   n = len(x)
   previous_loss = np.inf
Dans la fonction, nous créons aussi deux variables d’accumulation des gradients au carré, s_m et s_b.
Au moment de la mise à jour, nous recalculons les gradients au carré, puis mettons à jour les paramètres :
def rmsprop_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # RMSprop doesn't need gradient clipping
           # Update accumulators
           s_m = beta * s_m + (1 - beta) * (m_gradient**2)
           s_b = beta * s_b + (1 - beta) * (b_gradient**2)
           # Update parameters
           m -= learning_rate * m_gradient / (np.sqrt(s_m) + epsilon)
           b -= learning_rate * b_gradient / (np.sqrt(s_b) + epsilon)
           # The rest of the code is the same
Ici, deux nouveaux paramètres entrent en jeu :
epsilon est une petite valeur (généralement 1e-8) pour éviter une division par zéro.beta est le taux de décroissance, autour de 0,9.Le paramètre beta contrôle la part d’historique prise en compte. Un beta élevé prend plus en compte le passé lointain, un beta plus faible réagit davantage aux gradients récents.
Pas besoin de s’attarder sur les formules de RMSprop ; retenez la logique.
En substance, ces quatre lignes permettent :
En pratique, RMSprop performe souvent mieux que SGD basique ou SGD avec momentum, surtout pour les problèmes non convexes fréquents en deep learning.
Définissons à présent une nouvelle fonction :
def adam_optimization(
   x,
   y,
   epochs=100,
   learning_rate=0.001,
   batch_size=32,
   stopping_threshold=1e-6,
   beta1=0.9,
   beta2=0.999,
   epsilon=1e-8,
):
   """
   Adam optimization with support for mini-batches.
   """
   # Initialize the model parameters
   m = np.random.randn()
   b = np.random.randn()
   # Initialize first and second moment vectors
   m_m, v_m = 0, 0
   m_b, v_b = 0, 0
   n = len(x)
   previous_loss = np.inf
   t = 0  # Initialize timestep
Ici, nous définissons cinq nouvelles variables pour les premiers et seconds moments ainsi que le pas de temps. Dans Adam :
1. Le premier moment (m) :
2. Le second moment (v) :
Le code reste identique jusqu’au calcul des gradients (pas de clipping nécessaire pour Adam) :
def adam_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Adam doesn't need gradient clipping

           # Update biased first moment estimate
           m_m = beta1 * m_m + (1 - beta1) * m_gradient
           m_b = beta1 * m_b + (1 - beta1) * b_gradient
           # Update biased second raw moment estimate
           v_m = beta2 * v_m + (1 - beta2) * (m_gradient**2)
           v_b = beta2 * v_b + (1 - beta2) * (b_gradient**2)
           # Compute bias-corrected first moment estimate
           m_m_hat = m_m / (1 - beta1**t)
           m_b_hat = m_b / (1 - beta1**t)
           # Compute bias-corrected second raw moment estimate
           v_m_hat = v_m / (1 - beta2**t)
           v_b_hat = v_b / (1 - beta2**t)
           # Update parameters
           m -= learning_rate * m_m_hat / (np.sqrt(v_m_hat) + epsilon)
           b -= learning_rate * m_b_hat / (np.sqrt(v_b_hat) + epsilon)
       # The rest of the code is the same
Ne vous attardez pas sur ces lignes : elles impliquent pas mal de maths. En pratique, vous n’aurez presque jamais à coder Adam à la main ; l’important est de comprendre son intuition.
Le premier moment agit comme le momentum, en accumulant les gradients passés pour donner direction et vitesse. Adam avance plus vite quand la direction est stable et amortit les oscillations dans des paysages de gradient bruyants.
Le second moment, comme dans RMSprop, adapte le taux d’apprentissage pour chaque paramètre. Il normalise efficacement les mises à jour, ralentissant celles des paramètres aux grands gradients et accélérant celles des petits gradients. Adam gère ainsi des paramètres sur des échelles différentes.
Adam intègre aussi une correction de biais pour ces moyennes mobiles, particulièrement utile en début d’entraînement. Elle permet de démarrer avec des tailles de pas plus justes et d’accélérer les premiers progrès.
En combinant ces éléments, Adam converge souvent plus vite que des méthodes plus simples. Il est particulièrement efficace avec des gradients bruyants, des objectifs non stationnaires ou de très grands jeux de données. Son caractère adaptatif le rend relativement peu sensible au taux d’apprentissage initial, avec moins d’ajustements d’hyperparamètres à prévoir.
Voyons maintenant comment générer le tableau récapitulatif vu plus haut :
comparison_table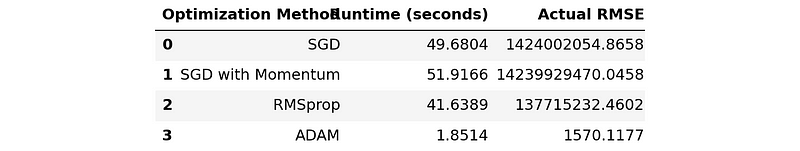
Nous définissons une fonction run_optimization pour entraîner une régression linéaire avec nos fonctions d’optimisation. Elle mesurera aussi le temps d’exécution et la RMSE :
import time
def run_optimization(opt_func, x, y, **kwargs):
   # Start a timer
   start_time = time.time()

   # Run the optimization function
   m, b = opt_func(x, y, **kwargs)

   # End the timer
   end_time = time.time()
   # Run the model on the test set with found parameters
   y_preds = model(m, test_xy[:, 0], b)
   y_preds_denormalized = y_preds * std[1] + mean[1]
   y_true_denormalized = test_xy[:, 1] * std[1] + mean[1]

   # Compute MSE and RMSE
   actual_mse = np.mean((y_true_denormalized - y_preds_denormalized) ** 2)
   return end_time - start_time, np.sqrt(actual_mse)
Nous appelons ensuite cette fonction quatre fois, une par méthode, et stockons les résultats sous forme de triplets (nom, durée en secondes, RMSE) :
# Run all optimization methods
results = []
results.append(
   (
       "SGD",
       *run_optimization(
           stochastic_gradient_descent,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
       ),
   )
)
results.append(
   (
       "SGD with Momentum",
       *run_optimization(
           stochastic_gradient_descent_with_momentum,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
           momentum=0.9,
       ),
   )
)
results.append(
   (
       "RMSprop",
       *run_optimization(
           rmsprop_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta=0.9,
           epsilon=1e-8,
       ),
   )
)
results.append(
   (
       "Adam",
       *run_optimization(
           adam_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta1=0.9,
           beta2=0.999,
           epsilon=1e-8,
       ),
   )
)
Pour une comparaison équitable, nous gardons identiques le taux d’apprentissage, le nombre d’époques et la taille de lot.
Ensuite, créons le tableau :
from tabulate import tabulate  # pip install tabulate
# Create and print the table
headers = ["Optimization Method", "Runtime (seconds)", "Actual RMSE"]
print(tabulate(results, headers=headers, floatfmt=".4f"))
# Save the table
pd.DataFrame(results, columns=headers).to_csv("optimization_results.csv", index=False)
Voici le résultat final :
Optimization Method      Runtime (seconds)       Actual RMSE
---------------------  -------------------  ----------------
SGD                                49.9305   1424002054.8658
SGD with Momentum                  50.7744  14239929470.0458
RMSprop                            41.9895    137715232.4602
Adam                                1.8462         1570.1177
Avant de poursuivre, testez différentes valeurs pour chaque méthode. Vous pourrez sans doute rendre chacune, et surtout Adam, plus rapide et plus précise en ajustant le taux d’apprentissage, la taille des lots ou les paramètres de biais.
Reportez-vous à la conclusion pour les liens vers le code complet du script de comparaison et la création du graphique présenté au début.
En pratique, utiliser Adam ne nécessite pas de lire un long article ni de tout coder à la main. L’implémentation PyTorch est parfaitement adaptée à la plupart des tâches supervisées en deep learning.
Voici un court extrait illustrant un workflow PyTorch typique avec l’optimiseur Adam du module torch.optim :
# Import necessary modules
import torch
import torch.nn as nn
import torch.optim as optim
# Define your model
model = nn.Sequential(
   nn.Linear(10, 50),
   nn.ReLU(),
   nn.Linear(50, 1)
)
# Initialize Adam optimizer
optimizer = optim.Adam(model.parameters(), lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0)
# Training loop
for epoch in range(num_epochs):
   for batch in dataloader:
       # Zero the gradients
       optimizer.zero_grad()

       # Forward pass
       outputs = model(batch)
       loss = criterion(outputs, targets)

       # Backward pass
       loss.backward()

       # Update weights
       optimizer.step()
# Adjusting learning rate
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=30, gamma=0.1)
for epoch in range(num_epochs):
   train(...)
   scheduler.step()
Pour en savoir plus sur PyTorch et ses algorithmes d’optimisation, consultez ce cours d’introduction sur DataCamp :
Dans cet article, nous avons passé en revue l’optimiseur Adam, de l’intuition à la pratique. Nous sommes partis de ses fondations — descente de gradient, SGD, RMSprop — pour montrer comment Adam en combine les idées et en tire un algorithme souple et performant.
Nous avons ensuite vu comment implémenter Adam en Python avec NumPy uniquement. Comme pour l’intuition, nous avons construit le code progressivement, du mini-batch gradient descent à RMSprop puis Adam. Un simple script de benchmarking a mis en évidence l’écart spectaculaire de vitesse et de performance en faveur d’Adam.
Enfin, nous avons montré comment utiliser Adam dans PyTorch, comme on le fait en pratique, pour résoudre des problèmes de deep learning. Voici quelques liens vers les scripts utilisés dans ce tutoriel :
Et quelques ressources complémentaires pour approfondir PyTorch et ses fonctions d’optimisation :
Merci de votre lecture !
Meilleures formations PyTorch
Cours
Cours
Cours
Tutoriel
Mark Pedigo
10 min
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Aditya Sharma
7 min
Tutoriel
Sejal Jaiswal
9 min
Tutoriel
Satyabrata Pal
15 min
Tutoriel


