
Kurs
PyTorch ile Deep Learning'e Giriş
4 sa
93K
Adaptive Moment Estimation’ın kısaltması olan Adam, makine öğreniminde ve çoğunlukla derin öğrenmede kullanılan popüler bir optimizasyon algoritmasıdır.
Adam, iki başka sağlam optimizasyon tekniğinin ana fikirlerini birleştirir: momentum ve RMSprop. Uyarlanabilir olarak adlandırılır çünkü her parametre için öğrenme oranını ayarlar.
İşte temel özellikleri ve avantajları:
Özetle, Adam her parametrenin öğrenme oranını sürekli ayarlayarak modellerin daha verimli öğrenmesini sağlar ve bunun bir sonucu olarak, standart stokastik gradyan inişinden çok daha hızlı yakınsama eğilimindedir. Bu nedenle, pek çok derin öğrenme uygulaması için güçlü bir varsayılan tercihtir.
Adam, birkaç kritik optimizasyon algoritmasının kilit fikirlerini birleştirerek onların avantajlarını güçlendirir ve eksiklerini giderir. Adam’ın sezgisini kavrayıp Python’da uygulayabilmek için önce bunları gözden geçirmemiz gerekir.
Bu optimizasyon algoritmalarının arkasındaki sezgiyi anlamak için, girişteki benzetmemizle devam edelim.
Gözleriniz bağlı, karmaşık ve engebeli bir bölgede olduğunuzu hayal edin. Bu arazideki en düşük noktayı bulmakla görevlendirildiniz. Arazinin engebeliliği, bir makine öğrenimi modelinin kayıp fonksiyonunu temsil eder. Genel “en düşük” (küresel minimum) nokta, sistemin en iyi çözümüdür.
Şimdi bazı bağlantılar kuralım: Arazideki mevcut konumunuz, modelin parametrelerinin mevcut durumunu temsil eder. Herhangi bir noktadaki yükseklik, bu parametreler için kayıp değerini temsil eder. Sizin arazide gezinme biçiminiz de, matematiksel olarak modelin parametrelerini ayarlamaya karşılık gelir.
Her optimizasyon algoritması, bu problemin manzarasında başarılı bir şekilde gezinmek için bir strateji gibidir; çözümü bir sonraki adımı nereye atacağı ve bu adımların ne kadar büyük olması gerektiği konusunda yönlendirir. Bazı algoritmalar, bir sonraki hamleye karar vermeden önce tüm alanı tarar; diğerleri ise daha hızlı olmak için sınırlı bilgiye güvenir.
Başka algoritmalar ise momentum ve adım boyutu uyarlaması gibi araçlar kullanır; iyi bir çözücü, ne zaman zorlaması ve ne zaman yumuşaması gerektiğini bilir.
Gradyan inişi, makine öğrenimindeki optimizasyonun mihenk taşıdır; pek çok algoritmanın üzerine inşa edildiği temeli oluşturur.
Gradyan İnişi (GD) kullanırsanız, her adımı atmadan önce (tüm veri kümesini kullanarak) etrafınızdaki tüm alanı dikkatlice yoklarsınız. Bu kapsamlı inceleme, aşağı yöne ilişkin çok doğru kararlar almanızı sağlar; ancak çok zaman alır. Her zaman en dik iniş yönünde ilerlersiniz; bu, tutarlı şekilde daha alçak seviyelere hareket edeceğiniz anlamına gelir. Ancak küçük bir çöküntüye (yerel minimum) ulaşırsanız, başka bir yerde daha da alçak bir nokta olduğunu fark edemeyip oraya sıkışabilirsiniz.
GD’nin temel özellikleri:
Bu senaryoda acele ediyorsunuz ve etrafınızdaki tüm bölgeyi yoklayacak zamanınız yok. Bunun yerine, ayaklarınızın yakınındaki rastgele tek bir noktayı (bir veri noktası) kontrol edersiniz. Bu, her adımı daha hızlı ama daha az isabetli yapar. Küçük bir grup noktayı da kontrol edebilirsiniz; buna mini-yığın gradyan inişi denir ve aşağıda ele alacağız.
İzlediğiniz yol, gradyan inişine göre daha dengesizdir; hatta bazen sarhoş bir denizcinin yolu gibi görünür. Zaman zaman yukarı da çıkabilirsiniz. Bu gürültülü yol aslında en büyük avantaj olabilir: yerel minimumlardan kaçma olasılığınız yüksektir.
Ancak dibe yaklaştıkça, en düşük noktayı ıskalamamak için daha küçük adımlar atmanız (öğrenme oranını düşürmeniz) gerekir.
SGD’nin temel özellikleri:
Not: Bu noktada, çok daha ayrıntılı bir şekilde ele aldığımız GD ve SGD ile ilgili ayrı makalemizi okumanızı şiddetle öneririm. Bu, bu iki kritik algoritmanın ayrıntılarını kapsar ve yaklaşan kod bölümüyle ilgili anlayışınızı da netleştirir.
Artık tepeler arasında bir kaykayın üzerindesiniz. Bir yöne doğru kendinizi ittiğinizde, kaykayın momentumu sizi bir süre aynı yönde hareket ettirir.
Bu momentum, geçmiş yönlerinizin hareketli ortalaması gibidir. Küçük tümsekleri ve yerel çukurları aşmanıza yardımcı olur; hatta ileride daha alçakta bir noktayı bulmanıza da katkı sağlayabilir.
Bir süre bir yönde hareket ettiyseniz, momentum artar ve daha hızlı gidersiniz. Bu şekilde, özellikle eğimin tutarlı bir şekilde aşağı olduğu arazilerde en düşük noktaya daha hızlı yakınsayabilirsiniz.
Momentumlu SGD’nin temel özellikleri:
Yürüdüğünüz arazinin durumuna göre tutuşunu ayarlayabilen yüksek teknolojili ayakkabılara sahip olduğunuzu düşünün. Bu ayakkabılar, her yöndeki zeminin gradyanını takip eder ve karesel gradyanların üstel olarak azalan ortalamasını tutar. Eğimlerin çok değiştiği bölgelerde, ayakkabılar daha fazla tutuş sağlar; böylece daha küçük, daha dikkatli adımlar atarsınız. Eğimlerin tutarlı olduğu daha düz bölgelerde ise daha uzun adımlar atmanızı sağlar.
Bu uyarlanabilir “adım boyutu”, hem dik hem de sığ eğimleri etkili şekilde aşmanıza yardımcı olur; dik bir bölgede çok büyük, düz bir bölgede ise çok küçük adımlar atmanızı engeller.
RMSprop’un temel özellikleri:
Adam, kaykayınızı (momentum) uyarlanabilir ayakkabılarınızla (RMSprop) birleştirip üzerine akıllı bir navigasyon sistemi eklemek gibidir.
Kaykay kısmı (momentum) sizi doğru genel yönde ilerletir. Bu, aşağı eğimli, pürüzsüz ve tutarlı bölgelerde Adam’ın hızlı ilerlemenize izin verdiği anlamına gelir. Zor, değişken arazide ise istikrarlı ama temkinli bir hızda kalmanıza yardım eder.
Uyarlanabilir ayakkabılar (RMSprop) nereye gittiğinizi algılar ve kaykayın tutuşunu ayarlar. Adam’daki akıllı navigasyon sistemi (önyargı düzeltmesi) özellikle yolculuğun başında, rastgele bir noktadan başladığınız ve arazi hakkında pek bir şey bilmediğiniz zamanda önemlidir.
Bu özelliklerin birleşimi, Adam’ın çoğu zaman en düşük noktayı (problemin çözümünü) çok verimli bir şekilde bulmasının ve yapısının farklı arazi türleriyle (farklı makine öğrenimi problemleri) iyi başa çıkabilmesinin nedenidir.
Adam’ın temel özellikleri:
Gördüğünüz gibi, anılan algoritmaların her biri bir öncekilerin üzerine inşa olur; farklı optimizasyon problemlerinde karşılaşılan zorlukları ele alarak en düşük noktayı bulma sürecini iyileştirmeyi amaçlar.
Adam’ı ve diğer anılan algoritmaları uygulama ayrıntılarına geçmeden önce, örnek bir regresyon probleminde her birinin çalışma süresi ve RMSE performansını karşılaştıran özet bir tabloyu paylaşayım:
import pandas as pd
# Disable scientific notation
pd.set_option("display.float_format", "{:.4f}".format)
comparison_table = pd.read_csv('optimization_results.csv')
comparison_table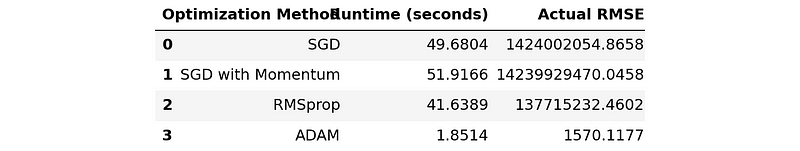
Bu tablo, Adam ile diğerleri arasındaki büyük farkı tam yansıtmıyor; bu yüzden bir çubuk grafik çizelim:
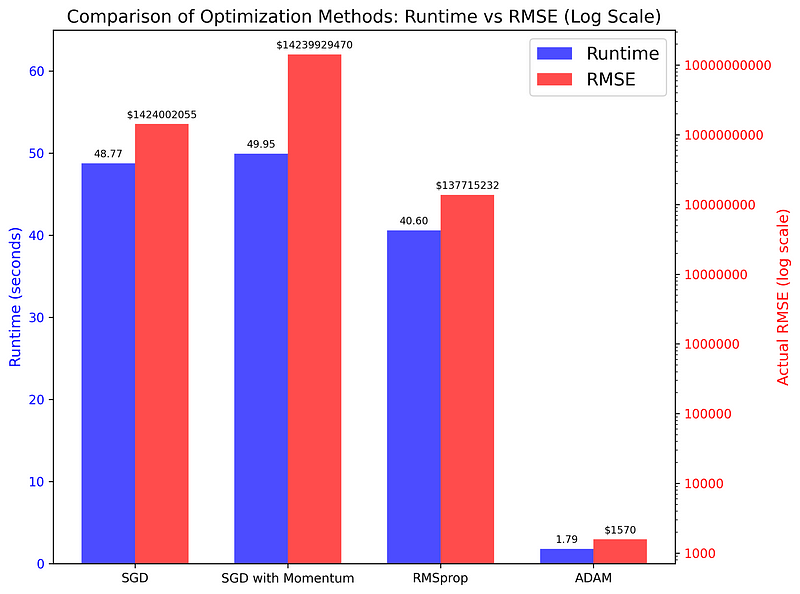
Grafik, basit bir regresyon görevinde kullanılan dört algoritmanın çalışma süresi ve RMSE skorlarını karşılaştırır. Gördüğünüz gibi farklar çarpıcıdır (sağ eksenin logaritmik ölçekte olduğunu unutmayın); bu da Adam’ın çoğu optimizasyon görevi için üstün bir seçim olduğunu gösterir.
Tabloyu ve grafiği oluşturan koda daha sonra bakacağız.
Artık Adam için gerekli ön kavramları ve sezgiyi ele aldığımıza göre, Python’da uygulamaya başlayabiliriz. Yol boyunca, uygulamayı anlamak için gerekli olan matematiği açıklayacağız. Kodu adım adım inşa edeceğiz; Stokastik Gradyan İnişi ile başlayarak.
Daha önce, SGD’nin bir sonraki adımın nereye olacağına karar vermek için yalnızca tek bir veri noktası kullandığından bahsetmiştik. Pratikte, bu sade SGD sürümü nadiren kullanılır; çünkü sonuçları gürültülü olabilir (tepelerdeki yolu dengesizdir).
Bunu azaltmak için, uzmanlar genellikle her adımdan önce 32, 64 veya 128 gibi veri noktalarından oluşan yığınlar kullanan Mini-Yığın Gradyan İnişi adlı bir varyasyon kullanır (bu, bir adım atmadan önce 360 dereceyi taramak yerine dar bir patikayı taramak gibidir).
Dolayısıyla Adam için temel kodu, bu SGD sürümüyle inşa edeceğiz.
Kodu olabildiğince basit tutmak için küçük bir regresyon problemi seçeceğiz: karat ölçümleri verilen pırlanta fiyatlarını tahmin etmek.
Önce gerekli kütüphaneleri içe aktaralım:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Sonra Seaborn’dan Diamonds veri setini yüklüyor, ondan bir örnek alıyor ve özellik ile hedef dizilerini oluşturuyoruz:
# Load the data
dataset_size = 20_000
diamonds = sns.load_dataset("diamonds")
# Extract the target and the feature
xy = diamonds[["carat", "price"]].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
Output:
(20000, 2)Doğrusal regresyon verilerin normalize edilmesini gerektirir:
# Normalize the data
mean = np.mean(xy, axis=0)
std = np.std(xy, axis=0)
xy_normalized = (xy - mean) / std
Şimdi, eğitim ve test kümeleri oluşturmak için veriyi bölebiliriz:
# Split the data
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(16000, 2)Görevi çözmek için elimizde çeşitli modeller var; ancak basit tutmak adına, Basit Doğrusal Regresyonu seçecek ve bir fonksiyon olarak tanımlayacağız:
def model(m, x, b):
   """
   Simple Linear Regression: f(x) = m * x + b, where
   - x: diamond carat
   - m: price increase per carat
   - b: base diamond price
   - f(x): predicted diamond price
   """

   return m * x + b
Doğrusal Regresyon modelimizin yalnızca iki parametresi vardır, m ve b; dolayısıyla SGD’nin (ve daha sonra Adam’ın) görevi onlar için en iyi değerleri bulmaktır.
Ayrıca, algoritmalarımızın minimize edeceği kayıp fonksiyonu olarak Ortalama Kare Hatasını tanımlamalıyız:
def mean_squared_error(y_true, y_pred):
   """
   MSE as a loss function. It is defined as:
   Loss = (1/n) * Σ((y - f(x))²), where:
   - n: the length of the dataset
   - y: the true diamond price
   - f(x): predicted diamond price, i.e. m*x + b
   """
   return np.mean((y_true - y_pred) ** 2)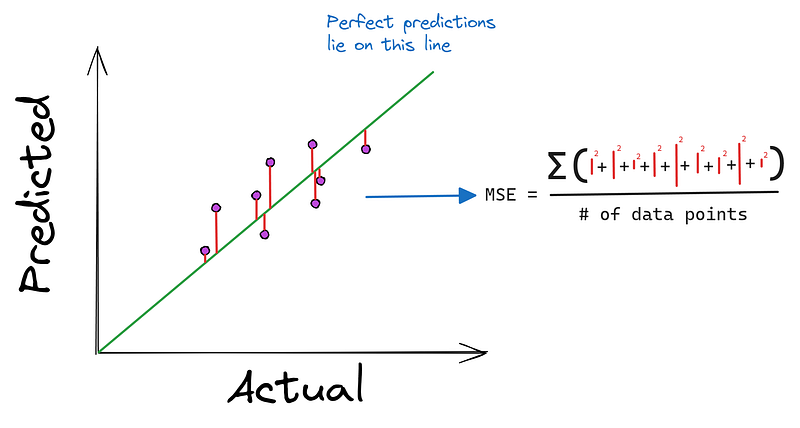
Şimdi, altı argüman alan stochastic_gradient_descent adlı bir fonksiyon tanımlıyoruz:
x ve y, problemimizdeki tek özellik ve hedefi temsil eder.epochs, inişi kaç kez gerçekleştirmek istediğimizi belirtir (buna daha sonra değineceğiz).learning_rate adım boyutudur.batch_size, parametre güncellemelerini ne sıklıkta yapacağımızı kontrol ederstopping_threshold, kaybın her adımda azalması gereken minimum değeri belirlerdef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infFonksiyonun içinde, önce optimize etmek istediğimiz parametreleri rastgele değerlerle başlatırız (tepelerde rastgele bir konumda başlamak). Ayrıca, problemimizin çözülmemiş durumunu temsil eden başlangıç kaybını sonsuz olarak ayarlarız.
Sonra, epochs kez çalışan bir for döngüsü başlatırız. Döngünün içinde, veride sıralamaya bağlı kalıpların öğrenilmesini önlemek için veriyi karıştırırız:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       # Shuffle the data
       indices = np.random.permutation(n)
       x = x[indices]
       y = y[indices]
Ardından, batch_size parametresi tarafından kontrol edilen başka bir döngü başlatır ve mevcut yığını çıkarırız:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           x_batch = x[j:j + batch_size]
           y_batch = y[j:j + batch_size]
Bu iç döngünün içinde, her iki parametre için gradyanları (kısmi türevler) hesaplarız (bir sonraki adımı nereye atmamız gerektiğini gösterir):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Make predictions with current m, b
           y_pred = model(m, x_batch, b)
           # Compute the gradients
           m_gradient = 2 * np.mean(x_batch * (y_batch - y_pred))
           b_gradient = 2 * np.mean(y_batch - y_pred)
Gradyanları hesapladıktan sonra, gradyanları kırpmak gibi kritik bir adım vardır:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           clip_value = 1.0
           m_gradient = np.clip(m_gradient, -clip_value, clip_value)
           b_gradient = np.clip(b_gradient, -clip_value, clip_value)
Patlayan gradyanlar olarak bilinen, gradyan büyüklüklerinin sonsuza gitmesi problemine karşı gradyan kırpma koruma sağlar.
Kırpmadan sonra, parametreleri öğrenme oranını kullanarak güncelleriz (öğrenme oranı tarafından kontrol edilen gradyanlar yönünde bir adım atarız):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           m -= learning_rate * m_gradient
           b -= learning_rate * b_gradient
Şimdi, ana döngünün altında (tüm yığınlar incelendikten sonra), mevcut epoch için kaybı hesaplarız (başlangıç konumumuzdan ne kadar aşağı indiğimize bakarız):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       y_pred = model(m, x, b)
       current_loss = loss(y, y_pred)
Epoch kaybı stopping_threshold değerinden küçükse, tüm süreci durdururuz:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       if abs(previous_loss - current_loss) < stopping_threshold:
           break
       previous_loss = current_loss
Sonunda (epoch’lar bittiğinde veya durdurma eşiğine ulaşıldığında), artık optimize edilmiş olan m ve b değerlerini döndürürüz:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       ...
return m, bŞimdi SGD’ye momentum ekleyelim. Bu sürümün kodu, mini-yığın sürümünden çok da farklı değildir.
Bir momentum parametresi olan yeni bir fonksiyon tanımlarız:
def stochastic_gradient_descent_with_momentum(
       x, y, epochs=100, learning_rate=0.01, batch_size=32,
       stopping_threshold=1e-6, momentum=0.9
):
   """
   SGD with momentum and support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize velocity terms
   v_m = 0
   v_b = 0

   n = len(x)
   previous_loss = np.inf
Fonksiyonun içinde, momentum görevi görecek biriken gradyanları takip etmek için iki değişken daha tanımlayacağız: v_m ve v_b,. Algoritmanın başlangıcında momentuma sahip olmadığımız için başlangıçta 0’a ayarlarız.
Sonrasında, gradyanları kırptıktan sonraya kadar kodun geri kalanı aynıdır:
def sgd_with_momentum(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update velocity terms
           v_m = momentum * v_m + learning_rate * m_gradient
           v_b = momentum * v_b + learning_rate * b_gradient
           # Update the model parameters using velocity
           m -= v_m
           b -= v_b
Gradyanlar kırpıldıktan sonra, momentumu güncelleme kuralını kullanarak hız (velocity) terimlerini değiştiririz. İşte kodun daha üst düzey bir görünümü:
# Initialize
v_m = 0
v_b = 0
...
# Update velocity terms
v_m = momentum * v_m + learning_rate * m_gradient
v_b = momentum * v_b + learning_rate * b_gradient
# Update the model parameters using velocity
m -= v_m
b -= v_b
Hız terimi v_* zamanla gradyanları biriktirir. Bu, tutarlı bir yönde hareket ediyorsak, o yönde hız kazanacağımız anlamına gelir.
Gradyanın hızla değiştiği bölgelerde (kayıp manzarasındaki dar vadiler gibi), momentum salınımları sönümlemeye yardımcı olur. Yerel minimumlar veya eyer noktaları gibi küçük yerel dalgalanmalara takılıp kalmayacak kadar atalet geliştiririz.
momentum * v_m kısmı gradyanları biriktiren kısımdır. Örneğin, büyük bir pozitif gradyanımız varsa, hızı da benzer şekilde büyük olacak ve parametredeki güncelleme daha da büyük olacaktır. Dolayısıyla 0,9’luk bir momentum, bir sonraki adım için önceki değişimin hızının %90’ını koruduğumuz anlamına gelir. Her N adımında, N-1 adımlarından gelen toplam gradyan hızının %90’ını kullanıyor olacağız.
Bu noktada, m ve b için bazı rastgele değerler ve gradyanlarını üretmenizi ve yokuş yukarı veya yokuş aşağı giderseniz parametrelerin nasıl değiştiğini görmek için momentumun güncelleme kuralını kullanmanızı öneririm.
Şimdi RMSprop’un uygulanmasına bakalım. Momentumlu SGD’de olduğu gibi, temel değişiklik parametre güncellemeleri yapılırken gelir.
Önce, iki ek parametreye sahip yeni bir fonksiyon tanımlarız: beta ve epsilon (momentumsuz):
def rmsprop_optimization(
   x, y, epochs=100, learning_rate=0.01, batch_size=32,
   stopping_threshold=1e-6, beta=0.9, epsilon=1e-8,
):
   """
   RMSprop optimization with support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize accumulators for squared gradients
   s_m = 0
   s_b = 0
   n = len(x)
   previous_loss = np.inf
Ayrıca fonksiyonun içinde, karesel gradyanları biriktirmek için iki yeni değişken oluştururuz: s_m ve s_b.
Şimdi, güncelleme aşamasına geldiğimizde, karesel gradyanları yeniden hesaplar ve ardından parametreleri güncelleriz:
def rmsprop_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # RMSprop doesn't need gradient clipping
           # Update accumulators
           s_m = beta * s_m + (1 - beta) * (m_gradient**2)
           s_b = beta * s_b + (1 - beta) * (b_gradient**2)
           # Update parameters
           m -= learning_rate * m_gradient / (np.sqrt(s_m) + epsilon)
           b -= learning_rate * b_gradient / (np.sqrt(s_b) + epsilon)
           # The rest of the code is the same
Burada iki yeni parametrenin kullanımını görüyoruz:
epsilon genellikle 1e-8 olan küçük bir değerdir; güncellemeler yapılırken sıfıra bölmeyi önlemek için kullanılır.beta çürüme hızını belirleyen parametredir; genellikle 0,9 civarındadır.beta parametresi, ne kadar geçmişi dikkate aldığımızı kontrol eder. Daha yüksek beta, geçmiş gradyanlara daha uzun vadeli bir bakış anlamına gelirken; daha düşük beta, algoritmayı son gradyanlara karşı daha duyarlı yapar.
RMSprop’un güncelleme kuralının arkasındaki matematik hakkında endişelenmenize gerek yok. Önemli olan arkalarındaki mantıktır.
Özünde, yukarıdaki dört satır şunu yapar:
Pratikte RMSprop, özellikle derin öğrenmede sıklıkla karşılaşılan dışbükey olmayan optimizasyon problemlerinde, temel SGD veya momentumlu SGD’den daha iyi performans gösterir.
Yine, yeni bir fonksiyon tanımlıyoruz:
def adam_optimization(
   x,
   y,
   epochs=100,
   learning_rate=0.001,
   batch_size=32,
   stopping_threshold=1e-6,
   beta1=0.9,
   beta2=0.999,
   epsilon=1e-8,
):
   """
   Adam optimization with support for mini-batches.
   """
   # Initialize the model parameters
   m = np.random.randn()
   b = np.random.randn()
   # Initialize first and second moment vectors
   m_m, v_m = 0, 0
   m_b, v_b = 0, 0
   n = len(x)
   previous_loss = np.inf
   t = 0  # Initialize timestep
Bu kez, birinci ve ikinci moment vektörlerini ve zaman adımını yakalamak için beş yeni değişken tanımlıyoruz. Adam bağlamında:
1. Birinci moment vektörü (m):
2. İkinci moment vektörü (v):
Daha sonra, gradyanları hesapladıktan sonrasına kadar kod aynı kalır (Adam için kırpmaya gerek yoktur):
def adam_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Adam doesn't need gradient clipping

           # Update biased first moment estimate
           m_m = beta1 * m_m + (1 - beta1) * m_gradient
           m_b = beta1 * m_b + (1 - beta1) * b_gradient
           # Update biased second raw moment estimate
           v_m = beta2 * v_m + (1 - beta2) * (m_gradient**2)
           v_b = beta2 * v_b + (1 - beta2) * (b_gradient**2)
           # Compute bias-corrected first moment estimate
           m_m_hat = m_m / (1 - beta1**t)
           m_b_hat = m_b / (1 - beta1**t)
           # Compute bias-corrected second raw moment estimate
           v_m_hat = v_m / (1 - beta2**t)
           v_b_hat = v_b / (1 - beta2**t)
           # Update parameters
           m -= learning_rate * m_m_hat / (np.sqrt(v_m_hat) + epsilon)
           b -= learning_rate * m_b_hat / (np.sqrt(v_b_hat) + epsilon)
       # The rest of the code is the same
Yine, bu satırlar fazla matematik içerdiğinden endişelenmemenizi rica ediyorum. Pratikte, Adam’ı sıfırdan uygulamanız gerekmez; bilmeniz gereken, güncelleme kuralının arkasındaki sezgidir.
Birinci moment, momentum gibi davranır; geçmiş gradyanları biriktirerek optimizasyona yön ve hız hissi verir. Bu, Adam’ın tutarlı yönlerde daha hızlı hareket etmesine ve gürültülü gradyan manzaralarında salınımları sönümlemesine yardımcı olur.
İkinci moment, RMSprop’ta olduğu gibi, her parametre için öğrenme oranını uyarlar. Parametre güncellemelerini fiilen normalize eder; büyük gradyanlı parametreler için öğrenmeyi yavaşlatır, küçük gradyanlılar için hızlandırır. Bu, Adam’ın farklı ölçeklerdeki parametrelerle etkili biçimde başa çıkmasını sağlar.
Adam ayrıca bu hareketli ortalamalar için önyargı düzeltmesi içerir; bu, özellikle eğitimin ilk aşamalarında önemlidir. Bu düzeltme, Adam’ın daha doğru adım boyutlarıyla başlamasına yardımcı olarak başlangıçta daha hızlı ilerlemeye yol açabilir.
Bu öğeleri birleştirerek Adam, daha basit optimizasyon yöntemlerinden daha hızlı yakınsama elde eder. Gürültülü gradyanlar, durağan olmayan amaçlar veya çok büyük veri kümeleri içeren problemler için özellikle etkilidir. Adam’ın uyarlanabilir doğası, başlangıç öğrenme oranına nispeten duyarsız olmasını sağlar; bu da çoğu zaman diğer yöntemlere kıyasla daha az hiperparametre ayarı gerektirdiği anlamına gelir.
Şimdi, daha önce gördüğümüz özet tabloyu nasıl üreteceğimize bakalım:
comparison_table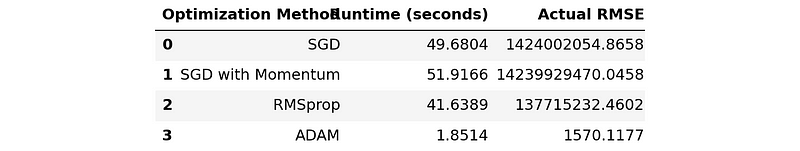
run_optimization adlı bir fonksiyon tanımlıyoruz; bu fonksiyon, optimizasyon fonksiyonlarımızı kullanarak bir doğrusal regresyon modelini eğitir. Fonksiyon, çalışma süresini ve RMSE skorlarını da yakalayacaktır:
import time
def run_optimization(opt_func, x, y, **kwargs):
   # Start a timer
   start_time = time.time()

   # Run the optimization function
   m, b = opt_func(x, y, **kwargs)

   # End the timer
   end_time = time.time()
   # Run the model on the test set with found parameters
   y_preds = model(m, test_xy[:, 0], b)
   y_preds_denormalized = y_preds * std[1] + mean[1]
   y_true_denormalized = test_xy[:, 1] * std[1] + mean[1]

   # Compute MSE and RMSE
   actual_mse = np.mean((y_true_denormalized - y_preds_denormalized) ** 2)
   return end_time - start_time, np.sqrt(actual_mse)
Şimdi bu fonksiyonu, her bir optimizasyon fonksiyonumuz için dört kez çağıracağız ve sonuçları her öğesi üçlü (algoritma adı, saniye cinsinden çalışma süresi, RMSE skoru) olan bir listeye depolayacağız:
# Run all optimization methods
results = []
results.append(
   (
       "SGD",
       *run_optimization(
           stochastic_gradient_descent,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
       ),
   )
)
results.append(
   (
       "SGD with Momentum",
       *run_optimization(
           stochastic_gradient_descent_with_momentum,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
           momentum=0.9,
       ),
   )
)
results.append(
   (
       "RMSprop",
       *run_optimization(
           rmsprop_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta=0.9,
           epsilon=1e-8,
       ),
   )
)
results.append(
   (
       "Adam",
       *run_optimization(
           adam_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta1=0.9,
           beta2=0.999,
           epsilon=1e-8,
       ),
   )
)
Adil bir karşılaştırma için, öğrenme oranını, epoch sayısını ve yığın boyutunu aynı tutuyoruz.
Ardından, tablomuzu oluşturabiliriz:
from tabulate import tabulate  # pip install tabulate
# Create and print the table
headers = ["Optimization Method", "Runtime (seconds)", "Actual RMSE"]
print(tabulate(results, headers=headers, floatfmt=".4f"))
# Save the table
pd.DataFrame(results, columns=headers).to_csv("optimization_results.csv", index=False)
İşte nihai sonuç:
Optimization Method      Runtime (seconds)       Actual RMSE
---------------------  -------------------  ----------------
SGD                                49.9305   1424002054.8658
SGD with Momentum                  50.7744  14239929470.0458
RMSprop                            41.9895    137715232.4602
Adam                                1.8462         1570.1177
Devam etmeden önce, her optimizasyon fonksiyonunun parametreleriyle oynamanızı öneririm. Özellikle öğrenme oranını ayarlayarak, yığın boyutunu artırarak veya önyargıyı kontrol ederek her birini, özellikle de Adam’ı, daha da hızlı ve hassas hale getirebilirsiniz.
Başta gördüğümüz grafiği nasıl oluşturacağımıza ve karşılaştırma betiğinin tam koduna ilişkin bağlantılar için sonuç bölümüne bakın.
Pratikte Adam’ı kullanmak, bu tür uzun bir makale okumayı ve sıfırdan yazmayı gerektirmez. PyTorch’taki uygulaması, derin öğrenmedeki herhangi bir gözetimli öğrenme görevi için fazlasıyla yeterlidir.
İşte Adam optimize edicisini torch.optim modülünden kullanan tipik bir PyTorch iş akışını özetleyen kısa, yalın bir kod parçası:
# Import necessary modules
import torch
import torch.nn as nn
import torch.optim as optim
# Define your model
model = nn.Sequential(
   nn.Linear(10, 50),
   nn.ReLU(),
   nn.Linear(50, 1)
)
# Initialize Adam optimizer
optimizer = optim.Adam(model.parameters(), lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0)
# Training loop
for epoch in range(num_epochs):
   for batch in dataloader:
       # Zero the gradients
       optimizer.zero_grad()

       # Forward pass
       outputs = model(batch)
       loss = criterion(outputs, targets)

       # Backward pass
       loss.backward()

       # Update weights
       optimizer.step()
# Adjusting learning rate
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=30, gamma=0.1)
for epoch in range(num_epochs):
   train(...)
   scheduler.step()
Genel olarak PyTorch’u ve optimizasyon algoritmalarını kullanmayı öğrenmek için DataCamp’ten bu giriş niteliğindeki kursa göz atın:
Bu yazıda, popüler Adam optimize edicinin inceliklerini öğrendik. Önce gradyan inişi, SGD ve RMSprop gibi temel algoritmalarını tartışarak onun için bir sezgi oluşturduk. Adam’ın bu fikirleri nasıl birleştirdiğini ve bunun sonucunda son derece esnek ve yüksek performanslı bir algoritma ortaya çıktığını gördük.
Ardından, yalnızca NumPy kullanarak Python’da Adam Optimize Edicinin nasıl uygulanacağını ele aldık. Sezgisi gibi, kodu da temel algoritmalardan, mini-yığın gradyan inişinden RMSprop’a ve oradan Adam’a doğru adım adım inşa ettik. Basit bir kıyaslama betiği oluşturarak, hız ve performans açısından Adam ile diğer algoritmalar arasındaki çarpıcı farkı da gözlemledik.
Son olarak, uygulamada olduğu gibi derin öğrenme problemlerini çözmek için PyTorch’ta Adam’ın nasıl kullanılacağını gösterdik. İşte eğitimde kullandığımız betiklere bazı bağlantılar:
Ve PyTorch ve optimizasyon fonksiyonları hakkında daha fazla bilgi edinmek için bazı ilgili kaynaklar:
Okuduğunuz için teşekkürler!
En İyi PyTorch Kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




