
Khóa học
Nhập môn Deep Learning với PyTorch
4 giờ
93K
Adam, viết tắt của Adaptive Moment Estimation, là một thuật toán tối ưu hóa phổ biến dùng trong machine learning và thường xuyên nhất là trong deep learning.
Adam kết hợp các ý tưởng chính từ hai kỹ thuật tối ưu hóa mạnh mẽ khác: momentum và RMSprop. Nó được gọi là adaptive vì nó điều chỉnh tốc độ học cho từng tham số.
Dưới đây là các đặc trưng và ưu điểm chính:
Tóm lại, Adam giúp mô hình học hiệu quả hơn bằng cách liên tục điều chỉnh tốc độ học của từng tham số và vì thế có xu hướng hội tụ nhanh hơn nhiều so với stochastic gradient descent tiêu chuẩn. Với nhiều ứng dụng deep learning, vì vậy nó là lựa chọn mặc định mạnh mẽ.
Adam hợp nhất các ý tưởng then chốt từ một vài thuật toán tối ưu quan trọng khác, củng cố ưu điểm của chúng đồng thời khắc phục nhược điểm. Chúng ta cần điểm lại chúng trước khi nắm trực giác đằng sau Adam và triển khai bằng Python.
Để hiểu trực giác đằng sau các thuật toán tối ưu này, hãy tiếp tục phép ẩn dụ từ phần mở đầu.
Hãy tưởng tượng bạn bịt mắt trong một vùng đồi núi phức tạp. Nhiệm vụ của bạn là tìm điểm thấp nhất trên địa hình này. Độ lồi lõm của địa hình đại diện cho hàm mất mát của một mô hình machine learning. Điểm “thấp nhất” toàn cục (cực tiểu toàn cục) là lời giải tối ưu của hệ.
Giờ hãy nối các điểm: Vị trí hiện tại của bạn trên địa hình đại diện cho trạng thái hiện tại của các tham số mô hình. Độ cao tại bất kỳ điểm nào biểu diễn giá trị mất mát cho các tham số đó. Cách bạn di chuyển cũng tương ứng với việc điều chỉnh tham số mô hình theo nghĩa toán học.
Mỗi thuật toán tối ưu giống như một chiến lược để điều hướng thành công bức tranh này, hướng dẫn lời giải nên bước tiếp theo ở đâu và bước dài bao nhiêu. Một số thuật toán quét toàn bộ khu vực trước khi quyết định nước đi tiếp theo, trong khi các thuật toán khác dựa vào thông tin hạn chế để nhanh hơn.
Lại có những thuật toán dùng công cụ như momentum và điều chỉnh kích thước bước; một bộ giải tốt biết khi nào cần đẩy mạnh và khi nào nên giảm tốc.
Gradient descent là chén thánh của tối ưu hóa trong machine learning, vì nó đặt nền tảng cho nhiều thuật toán khác xây dựng.
Nếu dùng Gradient Descent (GD), bạn cẩn thận dò xét toàn bộ khu vực xung quanh (dùng toàn bộ dữ liệu) trước mỗi bước. Sự kiểm tra kỹ lưỡng này cho phép bạn quyết định rất chính xác hướng đi xuống dốc, nhưng tốn nhiều thời gian. Bạn luôn di chuyển theo hướng dốc xuống nhất, nghĩa là liên tục tiến về vùng thấp hơn. Tuy nhiên, nếu đến một hõm nhỏ (cực tiểu cục bộ), bạn có thể bị kẹt ở đó, không phát hiện được còn điểm thấp hơn ở nơi khác.
Đặc điểm chính của GD:
Trong kịch bản này, bạn vội và không có thời gian cảm nhận cả khu vực xung quanh. Thay vào đó, bạn chỉ kiểm tra một điểm ngẫu nhiên gần chân (một điểm dữ liệu). Điều này khiến mỗi bước nhanh hơn nhưng kém chính xác hơn. Bạn cũng có thể kiểm tra một nhóm nhỏ điểm, gọi là mini-batch gradient descent, chúng ta sẽ đề cập bên dưới.
Đường đi của bạn ngẫu nhiên hơn so với gradient descent; thực ra đôi khi trông như lảo đảo của thủy thủ say. Đôi lúc bạn có thể đi lên dốc. Con đường nhiễu này lại có thể là ưu điểm lớn nhất: bạn rất có khả năng thoát khỏi các cực tiểu cục bộ.
Nhưng khi đến gần đáy, bạn cần bước nhỏ hơn (giảm tốc độ học) để tránh vượt quá điểm thấp nhất.
Đặc điểm chính của SGD:
Lưu ý: Tại thời điểm này, tôi rất khuyến nghị đọc bài viết riêng về GD và SGD của chúng tôi, vì nó trình bày chi tiết hai thuật toán quan trọng này sâu hơn nhiều. Nó cũng sẽ giúp bạn hiểu rõ phần mã ở đoạn sau.
Giờ bạn đang trên ván trượt giữa các ngọn đồi. Khi bạn đẩy theo một hướng, quán tính của ván trượt giữ bạn tiếp tục di chuyển gần như cùng hướng một lúc.
Momentum này giống như trung bình động của các hướng đi trước đó. Nó giúp bạn vượt qua các gờ nhỏ và hõm cục bộ, thậm chí có thể giúp bạn tìm điểm thấp hơn ở xa hơn.
Nếu bạn đã di chuyển theo một hướng một thời gian, quán tính tăng lên, và bạn đi nhanh hơn. Bằng cách này, bạn có thể hội tụ tới điểm thấp nhất nhanh hơn, đặc biệt ở những vùng có độ dốc xuống đều đặn.
Đặc điểm chính của SGD với Momentum:
Hãy nghĩ về việc có đôi giày công nghệ cao có thể điều chỉnh độ bám dựa trên địa hình bạn đang đi. Những đôi giày này theo dõi gradient của mặt đất theo từng hướng, giữ một trung bình suy giảm theo hàm mũ của các gradient bình phương. Ở nơi độ dốc thay đổi nhiều, giày cho bạn độ bám tốt hơn, giúp bạn bước ngắn và cẩn thận hơn. Ở vùng phẳng hơn với độ dốc ổn định, giày cho bạn sải chân dài hơn.
Kích thước “bước chân” thích nghi này giúp bạn di chuyển hiệu quả cả trên dốc đứng lẫn dốc thoải, tránh bước quá lớn ở vùng dốc hoặc quá nhỏ ở vùng phẳng.
Đặc điểm chính của RMSprop:
Adam giống như kết hợp ván trượt của bạn (momentum) với đôi giày thích nghi (RMSprop) và thêm một hệ thống dẫn đường thông minh.
Phần ván trượt (momentum) giữ bạn đi đúng hướng chung. Điều này nghĩa là ở những vùng dốc xuống, mượt và nhất quán, Adam cho phép bạn di chuyển nhanh. Ở địa hình phức tạp, thay đổi thất thường, nó giúp bạn duy trì nhịp độ ổn định nhưng thận trọng.
Đôi giày thích nghi (RMSprop) cảm nhận hướng bạn đang đi và điều chỉnh độ bám của ván trượt. Hệ thống dẫn đường thông minh (hiệu chỉnh sai lệch) trong Adam đặc biệt quan trọng ở đầu hành trình, khi bạn xuất phát từ một điểm ngẫu nhiên và chưa biết nhiều về địa hình.
Sự kết hợp các thuộc tính này là lý do Adam thường tìm được điểm thấp nhất (lời giải của bài toán) một cách rất hiệu quả và cấu trúc của nó xử lý tốt các loại địa hình khác nhau (các loại bài toán machine learning khác nhau).
Đặc điểm chính của Adam:
Như bạn đã thấy, mỗi thuật toán được nhắc tới đều xây dựng trên thuật toán trước đó, nhằm tối ưu hóa quá trình tìm điểm thấp nhất bằng cách giải quyết các thách thức khác nhau có trong nhiều loại bài toán tối ưu.
Trước khi đi vào chi tiết triển khai Adam và các thuật toán khác đã nêu, tôi muốn chia sẻ với bạn một bảng tóm tắt so sánh thời gian chạy và hiệu năng RMSE của mỗi thuật toán trên một bài toán hồi quy mẫu:
import pandas as pd
# Disable scientific notation
pd.set_option("display.float_format", "{:.4f}".format)
comparison_table = pd.read_csv('optimization_results.csv')
comparison_table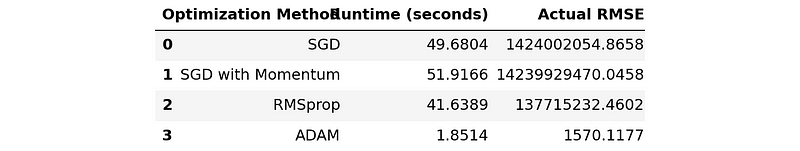
Bảng này chưa lột tả hết sự khác biệt lớn giữa Adam và phần còn lại, nên hãy vẽ thêm một biểu đồ cột:
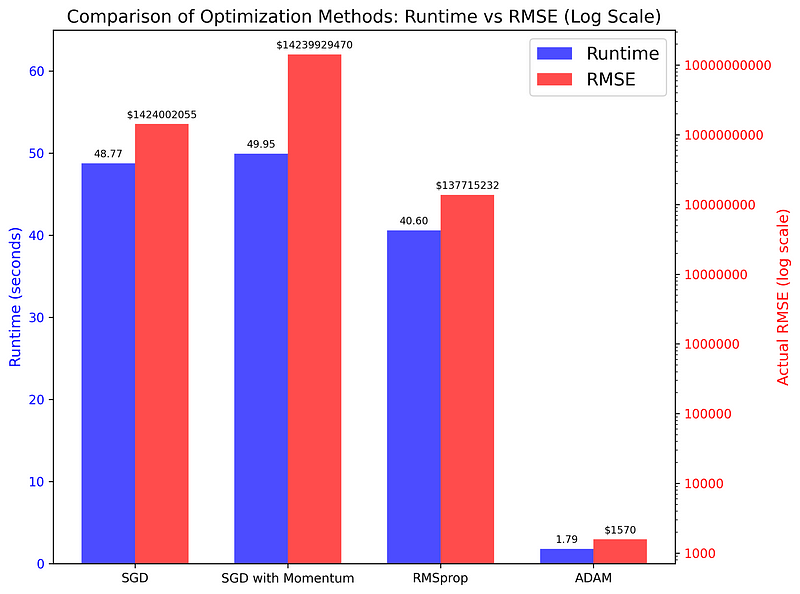
Biểu đồ so sánh thời gian chạy và điểm RMSE của bốn thuật toán dùng cho một tác vụ hồi quy đơn giản. Như bạn thấy, khác biệt là rất lớn (nhớ rằng trục bên phải ở thang log), cho thấy Adam là lựa chọn vượt trội cho hầu hết các tác vụ tối ưu.
Chúng ta sẽ xem mã đã tạo ra bảng và biểu đồ ở phần sau.
Giờ khi đã bao quát các khái niệm tiền đề cho Adam và trực giác của nó, chúng ta có thể bắt đầu triển khai bằng Python. Trong quá trình đó, chúng ta sẽ giải thích phần toán cần thiết để hiểu việc triển khai. Chúng ta sẽ xây dựng mã dần từng bước, bắt đầu từ Stochastic Gradient Descent.
Trước đó, chúng ta đã đề cập rằng SGD chỉ dùng một điểm dữ liệu để quyết định bước tiếp theo. Trên thực tế, phiên bản thuần này của SGD hiếm khi được dùng vì kết quả có thể nhiễu (đường đi trên đồi núi thất thường).
Để giảm bớt điều này, các chuyên gia thường dùng biến thể gọi là Mini-Batch Gradient Descent, sử dụng các lô dữ liệu như 32, 64 hoặc 128 trước mỗi bước (giống như quét một lối đi hẹp thay vì quan sát 360 độ trước khi bước).
Vì vậy, chúng ta sẽ xây dựng mã nền tảng cho Adam dựa trên phiên bản SGD này.
Để giữ mã đơn giản nhất có thể, chúng ta chọn một bài toán hồi quy nhỏ: dự đoán giá kim cương dựa trên chỉ số carat.
Trước hết, hãy import các thư viện cần thiết:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Tiếp theo, ta tải bộ dữ liệu Diamonds từ Seaborn, lấy một mẫu từ đó, và xây dựng mảng đặc trưng và mục tiêu:
# Load the data
dataset_size = 20_000
diamonds = sns.load_dataset("diamonds")
# Extract the target and the feature
xy = diamonds[["carat", "price"]].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
Output:
(20000, 2)Hồi quy tuyến tính yêu cầu chúng ta chuẩn hóa dữ liệu:
# Normalize the data
mean = np.mean(xy, axis=0)
std = np.std(xy, axis=0)
xy_normalized = (xy - mean) / std
Giờ ta có thể chia dữ liệu thành tập huấn luyện và kiểm tra:
# Split the data
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(16000, 2)Để giải bài toán, ta có nhiều mô hình trong tay, nhưng để đơn giản, ta chọn Hồi quy tuyến tính đơn và định nghĩa nó như một hàm:
def model(m, x, b):
   """
   Simple Linear Regression: f(x) = m * x + b, where
   - x: diamond carat
   - m: price increase per carat
   - b: base diamond price
   - f(x): predicted diamond price
   """

   return m * x + b
Mô hình Hồi quy tuyến tính của chúng ta chỉ có hai tham số, m và b, nên nhiệm vụ của SGD (và sau đó, của Adam) là tìm giá trị tối ưu cho chúng.
Chúng ta cũng nên định nghĩa hàm mất mát, Mean Squared Error, thứ sẽ được các thuật toán tối thiểu hóa:
def mean_squared_error(y_true, y_pred):
   """
   MSE as a loss function. It is defined as:
   Loss = (1/n) * Σ((y - f(x))²), where:
   - n: the length of the dataset
   - y: the true diamond price
   - f(x): predicted diamond price, i.e. m*x + b
   """
   return np.mean((y_true - y_pred) ** 2)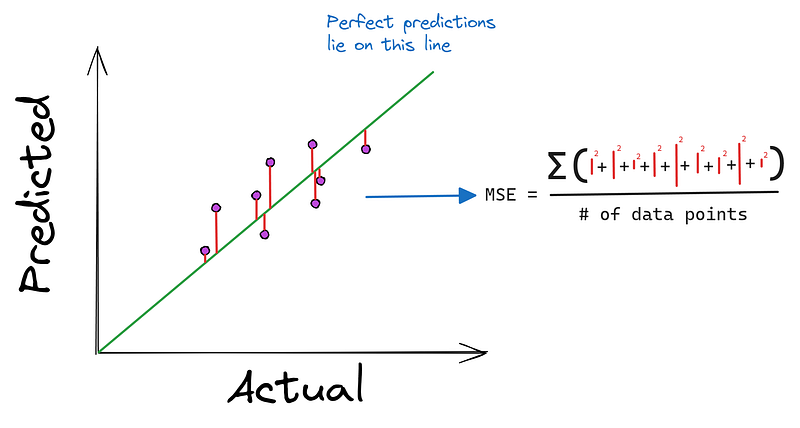
Giờ, chúng ta định nghĩa một hàm gọi là stochastic_gradient_descent nhận sáu đối số:
x và y đại diện cho đặc trưng đơn và mục tiêu trong bài toán của chúng ta.epochs biểu thị số lần chúng ta muốn thực hiện quá trình descent (sẽ nói thêm ngay sau).learning_rate là kích thước bước.batch_size để kiểm soát tần suất cập nhật tham sốstopping_threshold đặt giá trị tối thiểu mà tại đó mất mát nên giảm ở mỗi bướcdef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infBên trong hàm, đầu tiên ta khởi tạo ngẫu nhiên các tham số cần tối ưu (bắt đầu tại một vị trí ngẫu nhiên trên đồi). Ta cũng đặt mất mát ban đầu là vô cùng, đại diện cho trạng thái bài toán chưa được giải.
Sau đó, chúng ta bắt đầu một vòng lặp for chạy trong epochs lần lặp. Bên trong vòng lặp, chúng ta xáo trộn dữ liệu để tránh học các mẫu phụ thuộc thứ tự trong dữ liệu:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       # Shuffle the data
       indices = np.random.permutation(n)
       x = x[indices]
       y = y[indices]
Tiếp đó, ta bắt đầu một vòng lặp khác được điều khiển bởi tham số batch_size và trích xuất batch hiện tại:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           x_batch = x[j:j + batch_size]
           y_batch = y[j:j + batch_size]
Bên trong vòng lặp con này, ta tính các gradient (đạo hàm riêng phần) cho cả hai tham số (chỉ ra chúng ta cần bước tiếp theo ở đâu):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Make predictions with current m, b
           y_pred = model(m, x_batch, b)
           # Compute the gradients
           m_gradient = 2 * np.mean(x_batch * (y_batch - y_pred))
           b_gradient = 2 * np.mean(y_batch - y_pred)
Sau khi tính các gradient, có một bước quan trọng là cắt ngưỡng gradient:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           clip_value = 1.0
           m_gradient = np.clip(m_gradient, -clip_value, clip_value)
           b_gradient = np.clip(b_gradient, -clip_value, clip_value)
Gradient clipping ngăn vấn đề phổ biến gradient bùng nổ, nơi độ lớn gradient tiến tới vô cực.
Sau khi cắt ngưỡng, chúng ta cập nhật tham số bằng tốc độ học (chúng ta bước theo hướng gradient được kiểm soát bởi tốc độ học):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           m -= learning_rate * m_gradient
           b -= learning_rate * b_gradient
Giờ, dưới vòng lặp cha (sau khi tất cả các batch đã được duyệt), ta tính mất mát cho epoch hiện tại (xem chúng ta đã xuống bao xa so với vị trí ban đầu):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       y_pred = model(m, x, b)
       current_loss = loss(y, y_pred)
Nếu mất mát của epoch nhỏ hơn stopping_threshold, chúng ta dừng toàn bộ quá trình:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       if abs(previous_loss - current_loss) < stopping_threshold:
           break
       previous_loss = current_loss
Cuối cùng (sau khi hết epochs hoặc đạt ngưỡng dừng), chúng ta trả về m và b, giờ đã được tối ưu:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       ...
return m, bGiờ hãy thêm momentum vào SGD. Mã của phiên bản này không khác nhiều so với phiên bản mini-batch.
Chúng ta định nghĩa một hàm mới với tham số momentum:
def stochastic_gradient_descent_with_momentum(
       x, y, epochs=100, learning_rate=0.01, batch_size=32,
       stopping_threshold=1e-6, momentum=0.9
):
   """
   SGD with momentum and support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize velocity terms
   v_m = 0
   v_b = 0

   n = len(x)
   previous_loss = np.inf
Bên trong hàm, ta sẽ định nghĩa thêm hai biến, v_m và v_b, để theo dõi các gradient tích lũy sẽ đóng vai trò momentum. Ta đặt chúng bằng 0 lúc đầu, vì chưa có quán tính ở thời điểm bắt đầu thuật toán.
Sau đó, phần còn lại của mã giống nhau cho đến sau khi chúng ta cắt ngưỡng gradient:
def sgd_with_momentum(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update velocity terms
           v_m = momentum * v_m + learning_rate * m_gradient
           v_b = momentum * v_b + learning_rate * b_gradient
           # Update the model parameters using velocity
           m -= v_m
           b -= v_b
Sau khi gradient được cắt ngưỡng, chúng ta dùng quy tắc cập nhật của momentum để điều chỉnh các biến vận tốc. Dưới đây là cái nhìn tổng quát hơn về mã:
# Initialize
v_m = 0
v_b = 0
...
# Update velocity terms
v_m = momentum * v_m + learning_rate * m_gradient
v_b = momentum * v_b + learning_rate * b_gradient
# Update the model parameters using velocity
m -= v_m
b -= v_b
Vận tốc v_* tích lũy gradient theo thời gian. Nghĩa là nếu chúng ta di chuyển theo một hướng nhất quán, ta sẽ tích lũy tốc độ theo hướng đó.
Ở những vùng gradient thay đổi nhanh (như các thung lũng hẹp trong cảnh quan mất mát), momentum giúp giảm dao động. Ta tạo đủ quán tính để không mắc kẹt trong các biến thiên cục bộ nhỏ như cực tiểu cục bộ hoặc điểm yên.
Phần momentum * v_m là thứ tích lũy gradient. Ví dụ, nếu ta có gradient dương lớn, vận tốc tương ứng cũng lớn, và cập nhật tham số sẽ còn lớn hơn. Do đó, momentum 0,9 nghĩa là ta giữ lại 90% vận tốc của thay đổi trước cho bước kế tiếp. Ở mỗi bước N, ta sẽ dùng 90% tổng vận tốc gradient từ N-1 bước trước.
Tại thời điểm này, tôi khuyến khích bạn tự nghĩ ra một vài giá trị ngẫu nhiên cho m và b và gradient của chúng, rồi dùng quy tắc cập nhật momentum để xem các tham số thay đổi thế nào nếu bạn đi lên hay xuống dốc.
Giờ hãy xem cách triển khai RMSprop. Giống SGD với momentum, thay đổi lớn diễn ra khi cập nhật tham số.
Trước tiên, chúng ta định nghĩa một hàm mới với hai tham số bổ sung, beta và epsilon (không có momentum):
def rmsprop_optimization(
   x, y, epochs=100, learning_rate=0.01, batch_size=32,
   stopping_threshold=1e-6, beta=0.9, epsilon=1e-8,
):
   """
   RMSprop optimization with support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize accumulators for squared gradients
   s_m = 0
   s_b = 0
   n = len(x)
   previous_loss = np.inf
Ngoài ra, bên trong hàm, chúng ta tạo hai biến mới để tích lũy các gradient bình phương, s_m và s_b.
Khi đến giai đoạn cập nhật, ta tính lại các gradient bình phương rồi cập nhật tham số:
def rmsprop_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # RMSprop doesn't need gradient clipping
           # Update accumulators
           s_m = beta * s_m + (1 - beta) * (m_gradient**2)
           s_b = beta * s_b + (1 - beta) * (b_gradient**2)
           # Update parameters
           m -= learning_rate * m_gradient / (np.sqrt(s_m) + epsilon)
           b -= learning_rate * b_gradient / (np.sqrt(s_b) + epsilon)
           # The rest of the code is the same
Ở đây, ta thấy hai tham số mới được dùng:
epsilon là một giá trị nhỏ, thường là 1e-8, để tránh chia cho 0 khi cập nhật.beta là tham số tốc độ suy giảm, thường khoảng 0,9.Tham số beta kiểm soát mức độ lịch sử chúng ta xem xét. Beta cao hơn nghĩa là ta có cái nhìn dài hạn hơn về gradient quá khứ, trong khi beta thấp làm thuật toán phản ứng nhạy hơn với gradient gần đây.
Bạn không cần lo về toán đằng sau quy tắc cập nhật của RMSprop. Điều quan trọng là logic đằng sau chúng.
Về bản chất, bốn dòng trên đang làm những việc sau:
Trong thực tế, RMSprop thường hoạt động tốt hơn SGD cơ bản hoặc SGD có momentum, đặc biệt cho các bài toán tối ưu không lồi thường gặp trong deep learning.
Một lần nữa, chúng ta định nghĩa một hàm mới:
def adam_optimization(
   x,
   y,
   epochs=100,
   learning_rate=0.001,
   batch_size=32,
   stopping_threshold=1e-6,
   beta1=0.9,
   beta2=0.999,
   epsilon=1e-8,
):
   """
   Adam optimization with support for mini-batches.
   """
   # Initialize the model parameters
   m = np.random.randn()
   b = np.random.randn()
   # Initialize first and second moment vectors
   m_m, v_m = 0, 0
   m_b, v_b = 0, 0
   n = len(x)
   previous_loss = np.inf
   t = 0  # Initialize timestep
Lần này, chúng ta định nghĩa năm biến mới để ghi nhận véc-tơ moment bậc nhất và bậc hai cùng bước thời gian. Trong ngữ cảnh Adam:
1. Véc-tơ moment bậc nhất (m):
2. Véc-tơ moment bậc hai (v):
Sau đó, mã vẫn giống nhau cho đến sau khi tính gradient (chúng ta không cần cắt ngưỡng cho Adam):
def adam_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Adam doesn't need gradient clipping

           # Update biased first moment estimate
           m_m = beta1 * m_m + (1 - beta1) * m_gradient
           m_b = beta1 * m_b + (1 - beta1) * b_gradient
           # Update biased second raw moment estimate
           v_m = beta2 * v_m + (1 - beta2) * (m_gradient**2)
           v_b = beta2 * v_b + (1 - beta2) * (b_gradient**2)
           # Compute bias-corrected first moment estimate
           m_m_hat = m_m / (1 - beta1**t)
           m_b_hat = m_b / (1 - beta1**t)
           # Compute bias-corrected second raw moment estimate
           v_m_hat = v_m / (1 - beta2**t)
           v_b_hat = v_b / (1 - beta2**t)
           # Update parameters
           m -= learning_rate * m_m_hat / (np.sqrt(v_m_hat) + epsilon)
           b -= learning_rate * m_b_hat / (np.sqrt(v_b_hat) + epsilon)
       # The rest of the code is the same
Một lần nữa, tôi đề nghị bạn đừng quá lo về các dòng mã này, vì chúng liên quan nhiều đến toán. Trong thực tế, bạn hầu như không phải tự cài đặt Adam từ đầu vì điều bạn cần biết là trực giác đằng sau quy tắc cập nhật của nó.
Moment bậc nhất hoạt động như momentum, tích lũy các gradient quá khứ để cung cấp cho quá trình tối ưu hóa cảm giác về hướng và vận tốc. Điều này giúp Adam di chuyển nhanh hơn theo các hướng nhất quán và giảm dao động trong cảnh quan gradient nhiễu.
Moment bậc hai, như trong RMSprop, điều chỉnh tốc độ học cho từng tham số. Nó thực chất chuẩn hóa các cập nhật tham số, làm chậm quá trình học với tham số có gradient lớn và tăng tốc với tham số có gradient nhỏ. Điều này cho phép Adam xử lý hiệu quả các tham số ở những thang đo khác nhau.
Adam cũng kết hợp hiệu chỉnh sai lệch cho các trung bình động này, điều đặc biệt quan trọng ở giai đoạn đầu huấn luyện. Hiệu chỉnh này giúp Adam bắt đầu với kích thước bước chính xác hơn, có thể dẫn đến tiến bộ ban đầu nhanh hơn.
Bằng cách kết hợp các yếu tố này, Adam thường đạt hội tụ nhanh hơn các phương pháp tối ưu đơn giản hơn. Nó đặc biệt hiệu quả với các bài toán có gradient nhiễu, mục tiêu không tĩnh, hoặc tập dữ liệu rất lớn. Tính thích nghi của Adam khiến nó tương đối kém nhạy với tốc độ học ban đầu, thường cần ít tinh chỉnh siêu tham số hơn các phương pháp khác.
Giờ hãy xem cách tạo bảng tóm tắt mà chúng ta đã thấy trước đó:
comparison_table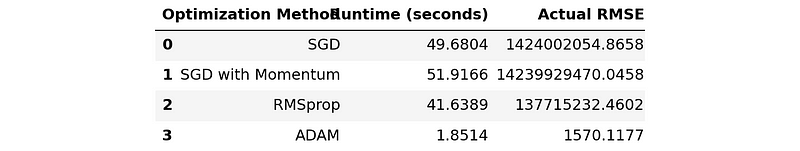
Chúng ta định nghĩa một hàm gọi là run_optimization để huấn luyện một mô hình hồi quy tuyến tính bằng các hàm tối ưu của chúng ta. Hàm cũng sẽ ghi nhận thời gian chạy và điểm RMSE:
import time
def run_optimization(opt_func, x, y, **kwargs):
   # Start a timer
   start_time = time.time()

   # Run the optimization function
   m, b = opt_func(x, y, **kwargs)

   # End the timer
   end_time = time.time()
   # Run the model on the test set with found parameters
   y_preds = model(m, test_xy[:, 0], b)
   y_preds_denormalized = y_preds * std[1] + mean[1]
   y_true_denormalized = test_xy[:, 1] * std[1] + mean[1]

   # Compute MSE and RMSE
   actual_mse = np.mean((y_true_denormalized - y_preds_denormalized) ** 2)
   return end_time - start_time, np.sqrt(actual_mse)
Giờ chúng ta sẽ gọi hàm này bốn lần cho mỗi hàm tối ưu, lưu kết quả vào một danh sách nơi mỗi mục là bộ ba (tên thuật toán, thời gian chạy tính bằng giây, điểm RMSE):
# Run all optimization methods
results = []
results.append(
   (
       "SGD",
       *run_optimization(
           stochastic_gradient_descent,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
       ),
   )
)
results.append(
   (
       "SGD with Momentum",
       *run_optimization(
           stochastic_gradient_descent_with_momentum,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
           momentum=0.9,
       ),
   )
)
results.append(
   (
       "RMSprop",
       *run_optimization(
           rmsprop_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta=0.9,
           epsilon=1e-8,
       ),
   )
)
results.append(
   (
       "Adam",
       *run_optimization(
           adam_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta1=0.9,
           beta2=0.999,
           epsilon=1e-8,
       ),
   )
)
Để so sánh công bằng, chúng ta giữ nguyên tốc độ học, số epoch và kích thước batch.
Sau đó, chúng ta tạo bảng:
from tabulate import tabulate  # pip install tabulate
# Create and print the table
headers = ["Optimization Method", "Runtime (seconds)", "Actual RMSE"]
print(tabulate(results, headers=headers, floatfmt=".4f"))
# Save the table
pd.DataFrame(results, columns=headers).to_csv("optimization_results.csv", index=False)
Đây là kết quả cuối cùng:
Optimization Method      Runtime (seconds)       Actual RMSE
---------------------  -------------------  ----------------
SGD                                49.9305   1424002054.8658
SGD with Momentum                  50.7744  14239929470.0458
RMSprop                            41.9895    137715232.4602
Adam                                1.8462         1570.1177
Trước khi tiếp tục, tôi khuyến khích bạn thử thay đổi các tham số của mỗi hàm tối ưu. Nhiều khả năng bạn có thể khiến từng hàm, đặc biệt là Adam, nhanh hơn và chính xác hơn nữa bằng cách điều chỉnh tốc độ học, tăng kích thước batch hoặc kiểm soát sai lệch.
Xem phần kết luận để lấy liên kết tới toàn bộ mã của script so sánh và cách tạo biểu đồ mà chúng ta đã thấy ở đầu bài.
Việc dùng Adam trong thực tế không đòi hỏi đọc một bài dài như thế này và tự viết từ đầu. Triển khai của PyTorch đủ sức đáp ứng bất kỳ tác vụ học có giám sát nào trong deep learning.
Đây là một đoạn snippet tối giản phác thảo quy trình PyTorch điển hình dùng bộ tối ưu Adam từ mô-đun torch.optim:
# Import necessary modules
import torch
import torch.nn as nn
import torch.optim as optim
# Define your model
model = nn.Sequential(
   nn.Linear(10, 50),
   nn.ReLU(),
   nn.Linear(50, 1)
)
# Initialize Adam optimizer
optimizer = optim.Adam(model.parameters(), lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0)
# Training loop
for epoch in range(num_epochs):
   for batch in dataloader:
       # Zero the gradients
       optimizer.zero_grad()

       # Forward pass
       outputs = model(batch)
       loss = criterion(outputs, targets)

       # Backward pass
       loss.backward()

       # Update weights
       optimizer.step()
# Adjusting learning rate
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=30, gamma=0.1)
for epoch in range(num_epochs):
   train(...)
   scheduler.step()
Để tìm hiểu thêm về việc dùng PyTorch nói chung và các thuật toán tối ưu của nó, hãy xem khóa học nhập môn này từ DataCamp:
Trong bài viết này, chúng ta đã tìm hiểu tường tận về bộ tối ưu hóa Adam phổ biến. Chúng ta bắt đầu bằng cách xây dựng trực giác cho nó thông qua thảo luận về các thuật toán nền tảng như gradient descent, SGD và RMSprop. Chúng ta đã thấy Adam kết hợp các ý tưởng chính từ những thuật toán này, tạo thành một thuật toán linh hoạt và hiệu năng cao.
Sau đó, chúng ta đề cập cách triển khai Adam Optimizer trong Python chỉ dùng NumPy. Giống như trực giác, chúng ta xây dựng mã từ các thuật toán nền tảng, từ mini-batch gradient descent qua RMSprop đến Adam. Chúng ta cũng chứng kiến khác biệt đáng kinh ngạc giữa Adam và các thuật toán khác về tốc độ và hiệu năng bằng cách tạo một script benchmark đơn giản.
Cuối cùng, chúng ta đã cho thấy cách dùng Adam trong PyTorch, giống như trong thực tế, để giải các bài toán deep learning. Dưới đây là một số liên kết tới các script đã dùng trong hướng dẫn:
Và một số tài nguyên liên quan để tìm hiểu thêm về PyTorch và các hàm tối ưu của nó:
Cảm ơn bạn đã đọc!
Các khóa học PyTorch hàng đầu
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
