
Corso
Introduzione al Deep Learning con PyTorch
4 ore
92K
Adam, che sta per Adaptive Moment Estimation, è un algoritmo di ottimizzazione molto diffuso nel machine learning e, più spesso, nel deep learning.
Adam combina le idee principali di altre due tecniche robuste di ottimizzazione: momentum e RMSprop. Si chiama adaptivo perché regola il learning rate per ciascun parametro.
Ecco le sue caratteristiche e i vantaggi principali:
In sintesi, Adam rende l’apprendimento dei modelli più efficiente regolando continuamente il learning rate di ciascun parametro e, di conseguenza, tende a convergere molto più rapidamente rispetto al gradient descent stocastico standard. Per molte applicazioni di deep learning, è quindi un’ottima scelta predefinita.
Adam unifica idee chiave di alcuni altri algoritmi di ottimizzazione fondamentali, rafforzandone i vantaggi e affrontandone al contempo i limiti. Dobbiamo rivederli prima di poter cogliere l’intuizione dietro Adam e implementarlo in Python.
Per capire l’intuizione dietro questi algoritmi di ottimizzazione, continuiamo l’analogia dell’introduzione.
Immagina di essere bendato in una zona collinare complessa. Il tuo compito è trovare il punto più basso di questo terreno. La “collinosità” del terreno rappresenta la funzione di loss di un modello di machine learning. Il punto “più basso” globale (minimo globale) è la soluzione ottimale del sistema.
Ora, colleghiamo i punti: la tua posizione attuale nel terreno rappresenta lo stato corrente dei parametri del modello. L’altezza in ogni punto rappresenta il valore della loss per quei parametri. Il modo in cui ti muovi corrisponde, in senso matematico, all’aggiornamento dei parametri del modello.
Ogni algoritmo di ottimizzazione è come una strategia per navigare con successo il paesaggio del problema, guidando il risolutore su dove mettere il piede successivo e quanto grandi debbano essere quei passi. Alcuni algoritmi scandagliano l’intera area prima di decidere la mossa successiva, mentre altri si basano su informazioni limitate per essere più veloci.
Altri ancora usano strumenti come il momentum e l’adattamento della dimensione del passo; un buon risolutore sa quando spingere e quando allentare.
Gradient descent è il “sacro graal” dell’ottimizzazione nel machine learning, perché fa da base a molti algoritmi successivi.
Se usi il Gradient Descent (GD), senti con cura tutta l’area attorno a te (usando l’intero dataset) prima di ogni passo. Questo esame approfondito ti permette di decidere con precisione in quale direzione si scende, ma richiede molto tempo. Ti muovi sempre nella direzione della massima discesa, quindi andrai costantemente verso il basso. Tuttavia, se raggiungi una piccola conca (minimo locale), potresti rimanere bloccato lì, senza riuscire a rilevare che altrove c’è un punto ancora più basso.
Caratteristiche chiave del GD:
In questo scenario, hai fretta e non hai tempo di percepire l’intera regione attorno a te. Invece, controlli un solo punto casuale vicino ai tuoi piedi (un dato). Questo rende ogni passo più veloce ma meno accurato. Puoi anche controllare un piccolo batch di punti: è il cosiddetto mini-batch gradient descent, che vedremo tra poco.
Il tuo percorso è più irregolare rispetto al gradient descent; a volte sembra davvero quello di un marinaio ubriaco. Puoi talvolta andare in salita. Questa traiettoria rumorosa può essere in realtà il vantaggio più grande: è molto probabile che tu esca dai minimi locali.
Ma man mano che ti avvicini al fondo, devi fare passi più piccoli (ridurre il learning rate) per evitare di superare il punto più basso.
Caratteristiche chiave dell’SGD:
Nota: a questo punto, ti consiglio vivamente di leggere il nostro articolo separato su GD e SGD, perché approfondisce molto di più i dettagli di questi due algoritmi fondamentali. Ti aiuterà anche a capire meglio la sezione di codice che segue.
Ora sei su uno skateboard tra le colline. Quando ti dai una spinta in una direzione, il momentum dello skateboard ti mantiene più o meno nella stessa direzione per un po’.
Questo momentum è come una media mobile delle direzioni passate. Ti aiuta a superare piccoli dossi e avvallamenti locali, magari permettendoti di trovare un punto più basso più avanti.
Se ti muovi in una direzione per un po’, il momentum cresce e vai più veloce. In questo modo, puoi convergere sul punto più basso più rapidamente, soprattutto in terreni con pendenza costante verso il basso.
Caratteristiche chiave dell’SGD con Momentum:
Pensa di avere scarpe hi-tech che regolano l’aderenza in base al terreno su cui cammini. Queste scarpe tracciano il gradiente del terreno in ogni direzione, mantenendo una media esponenzialmente decrescente dei gradienti al quadrato. Nelle aree dove la pendenza cambia molto, le scarpe ti danno più grip, permettendoti di fare passi più piccoli e più cauti. Nelle zone più uniformi con pendenze costanti, le scarpe ti concedono falcate più lunghe.
Questa “dimensione del passo” adattiva ti aiuta a navigare efficacemente sia pendenze ripide sia dolci, evitando di fare passi troppo grandi in aree ripide o troppo piccoli in aree piatte.
Caratteristiche chiave di RMSprop:
Adam è come unire il tuo skateboard (momentum) con le scarpe adattive (RMSprop) e aggiungere un sistema di navigazione intelligente.
La parte skateboard (momentum) ti mantiene nella giusta direzione generale. Questo significa che, in regioni in discesa, lisce e coerenti, Adam ti permette di muoverti rapidamente. In terreni difficili e variabili, ti aiuta a mantenere un’andatura stabile ma prudente.
Le scarpe adattive (RMSprop) percepiscono dove stai andando e regolano l’aderenza dello skateboard. Il sistema di navigazione intelligente (correzione del bias) in Adam è particolarmente importante all’inizio del viaggio, quando parti da un punto casuale e conosci poco il terreno.
Questa combinazione di attributi è il motivo per cui Adam spesso trova il punto più basso (la soluzione del problema) in modo molto efficiente e perché la sua struttura gestisce bene diversi tipi di terreni (diversi tipi di problemi di machine learning).
Caratteristiche chiave di Adam:
Come hai visto, ognuno degli algoritmi menzionati si basa sui precedenti, cercando di ottimizzare la ricerca del punto più basso affrontando sfide diverse nei vari tipi di problemi di ottimizzazione.
Prima di arrivare ai dettagli dell’implementazione di Adam e degli altri algoritmi citati, condivido una tabella riassuntiva che confronta runtime e prestazioni in termini di RMSE su un problema di regressione di esempio:
import pandas as pd
# Disable scientific notation
pd.set_option("display.float_format", "{:.4f}".format)
comparison_table = pd.read_csv('optimization_results.csv')
comparison_table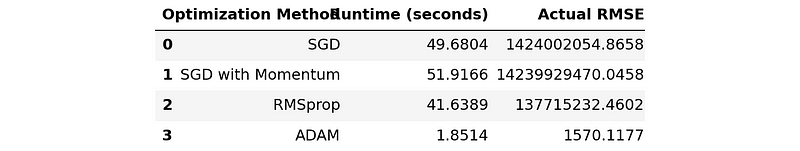
Questa tabella non rende giustizia alla grande differenza tra Adam e gli altri, quindi disegniamo un grafico a barre:
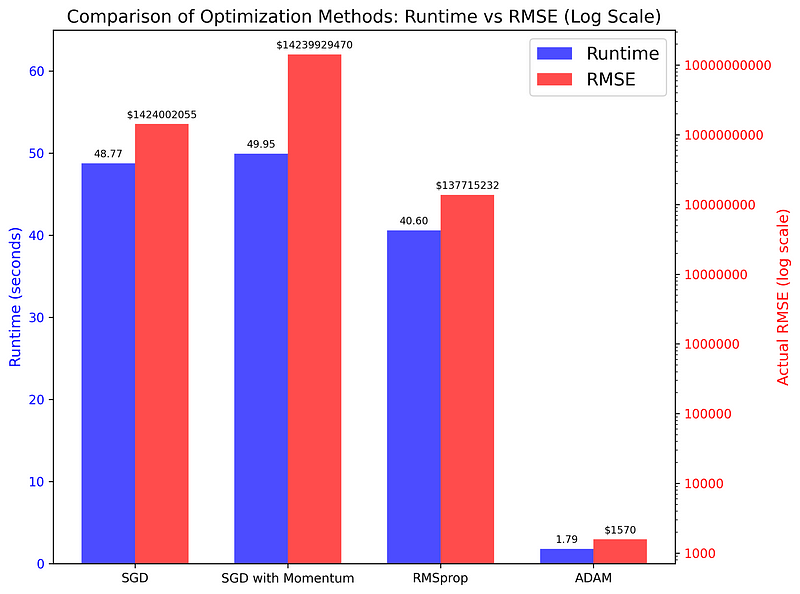
Il grafico confronta runtime e punteggi RMSE dei quattro algoritmi su un semplice compito di regressione. Come vedi, le differenze sono impressionanti (ricorda, l’asse destro è in scala logaritmica), a indicare che Adam è spesso la scelta superiore per la maggior parte dei compiti di ottimizzazione.
Più avanti vedremo il codice che ha generato la tabella e il grafico.
Ora che abbiamo coperto i concetti preliminari di Adam e la sua intuizione, possiamo iniziare a implementarli in Python. Lungo il percorso, spiegheremo la matematica necessaria a comprendere l’implementazione. Costruiremo il codice passo dopo passo, partendo dallo Stochastic Gradient Descent.
In precedenza, abbiamo detto che l’SGD usa un solo dato per decidere come muoversi. In pratica, questa versione “vanilla” dell’SGD è raramente usata perché i suoi risultati possono essere rumorosi (il suo percorso tra le colline è irregolare).
Per attenuare il problema, i professionisti usano spesso una variante chiamata Mini-Batch Gradient Descent, che usa batch di dati, per esempio 32, 64 o 128, prima di ogni passo (è come scandagliare un sentiero stretto invece di guardare a 360 gradi prima di fare un passo).
Quindi costruiremo il codice di base per Adam partendo da questa versione dell’SGD.
Per mantenere il codice il più semplice possibile, sceglieremo un piccolo problema di regressione: prevedere i prezzi dei diamanti a partire dai carati.
Importiamo prima le librerie necessarie:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Poi carichiamo il dataset Diamonds da Seaborn, ne estraiamo un campione e costruiamo gli array di feature e target:
# Load the data
dataset_size = 20_000
diamonds = sns.load_dataset("diamonds")
# Extract the target and the feature
xy = diamonds[["carat", "price"]].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
Output:
(20000, 2)La regressione lineare richiede di normalizzare i dati:
# Normalize the data
mean = np.mean(xy, axis=0)
std = np.std(xy, axis=0)
xy_normalized = (xy - mean) / std
Ora possiamo dividere i dati per creare set di training e di test:
# Split the data
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(16000, 2)Per risolvere il compito abbiamo a disposizione diversi modelli, ma per semplicità scegliamo la Regressione Lineare Semplice e la definiamo come funzione:
def model(m, x, b):
   """
   Simple Linear Regression: f(x) = m * x + b, where
   - x: diamond carat
   - m: price increase per carat
   - b: base diamond price
   - f(x): predicted diamond price
   """

   return m * x + b
Il nostro modello di Regressione Lineare ha solo due parametri, m e b, quindi il compito per l’SGD (e poi per Adam) è trovare i valori ottimali per essi.
Dovremmo anche definire la funzione di loss, la Mean Squared Error, che sarà minimizzata dai nostri algoritmi:
def mean_squared_error(y_true, y_pred):
   """
   MSE as a loss function. It is defined as:
   Loss = (1/n) * Σ((y - f(x))²), where:
   - n: the length of the dataset
   - y: the true diamond price
   - f(x): predicted diamond price, i.e. m*x + b
   """
   return np.mean((y_true - y_pred) ** 2)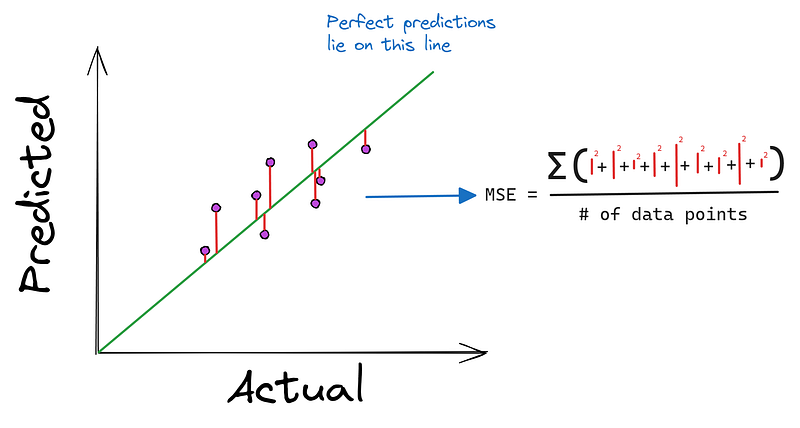
Ora definiamo una funzione chiamata stochastic_gradient_descent che accetta sei argomenti:
x e y rappresentano la singola feature e il target nel nostro problema.epochs indica quante volte vogliamo eseguire la discesa (ne parleremo più avanti).learning_rate è la dimensione del passo.batch_size per controllare la frequenza degli aggiornamenti dei parametristopping_threshold imposta il valore minimo di diminuzione della loss a ogni passodef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infAll’interno della funzione, inizializziamo prima i parametri da ottimizzare con valori casuali (partendo da una posizione casuale tra le colline). Impostiamo anche la loss iniziale a infinito, a rappresentare lo stato non risolto del problema.
Poi avviamo un ciclo for che gira per epochs iterazioni. All’interno del ciclo, rimescoliamo i dati per evitare di apprendere pattern dipendenti dall’ordine:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       # Shuffle the data
       indices = np.random.permutation(n)
       x = x[indices]
       y = y[indices]
Poi avviamo un altro ciclo controllato dal parametro batch_size ed estraiamo il batch corrente:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           x_batch = x[j:j + batch_size]
           y_batch = y[j:j + batch_size]
Dentro questo ciclo interno, calcoliamo i gradienti (derivate parziali) per entrambi i parametri (indicando dove dobbiamo muoverci):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Make predictions with current m, b
           y_pred = model(m, x_batch, b)
           # Compute the gradients
           m_gradient = 2 * np.mean(x_batch * (y_batch - y_pred))
           b_gradient = 2 * np.mean(y_batch - y_pred)
Dopo aver calcolato i gradienti, c’è un passaggio fondamentale: il clipping dei gradienti:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           clip_value = 1.0
           m_gradient = np.clip(m_gradient, -clip_value, clip_value)
           b_gradient = np.clip(b_gradient, -clip_value, clip_value)
Il gradient clipping previene il comune problema degli exploding gradients, in cui la magnitudine dei gradienti tende all’infinito.
Dopo il clipping, aggiorniamo i parametri usando il learning rate (facciamo un passo nella direzione dei gradienti, controllato dal learning rate):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           m -= learning_rate * m_gradient
           b -= learning_rate * b_gradient
Ora, sotto il ciclo principale (dopo aver elaborato tutti i batch), calcoliamo la loss per l’epoch corrente (per vedere quanto siamo scesi dalla posizione iniziale):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       y_pred = model(m, x, b)
       current_loss = loss(y, y_pred)
Se la loss dell’epoch è più piccola di stopping_threshold, interrompiamo l’intero processo:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       if abs(previous_loss - current_loss) < stopping_threshold:
           break
       previous_loss = current_loss
Alla fine (dopo che le epoch finiscono o si raggiunge la soglia di arresto), restituiamo m e b, ora ottimizzati:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       ...
return m, bOra aggiungiamo il momentum all’SGD. Il codice di questa versione non è molto diverso dalla versione mini-batch.
Definiamo una nuova funzione con un parametro momentum:
def stochastic_gradient_descent_with_momentum(
       x, y, epochs=100, learning_rate=0.01, batch_size=32,
       stopping_threshold=1e-6, momentum=0.9
):
   """
   SGD with momentum and support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize velocity terms
   v_m = 0
   v_b = 0

   n = len(x)
   previous_loss = np.inf
All’interno della funzione, definiamo due variabili in più, v_m e v_b, per tenere traccia dei gradienti accumulati che fungeranno da momentum. Li impostiamo a 0 all’inizio, perché non abbiamo momentum all’avvio dell’algoritmo.
Poi, il resto del codice è lo stesso fino a dopo il clipping dei gradienti:
def sgd_with_momentum(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update velocity terms
           v_m = momentum * v_m + learning_rate * m_gradient
           v_b = momentum * v_b + learning_rate * b_gradient
           # Update the model parameters using velocity
           m -= v_m
           b -= v_b
Una volta tagliati i gradienti, usiamo la regola di aggiornamento del momentum per modificare i termini di velocità. Ecco una vista di più alto livello del codice:
# Initialize
v_m = 0
v_b = 0
...
# Update velocity terms
v_m = momentum * v_m + learning_rate * m_gradient
v_b = momentum * v_b + learning_rate * b_gradient
# Update the model parameters using velocity
m -= v_m
b -= v_b
La velocità v_* accumula gradienti nel tempo. Questo significa che, se ci muoviamo in una direzione coerente, accumuleremo velocità in quella direzione.
Nelle aree in cui il gradiente cambia rapidamente (come strette valli nel paesaggio della loss), il momentum aiuta a smorzare le oscillazioni. Sviluppiamo abbastanza inerzia da non rimanere bloccati in piccole variazioni locali come minimi locali o punti di sella.
La parte momentum * v_m è ciò che accumula i gradienti. Per esempio, se abbiamo un gradiente positivo grande, la sua velocità sarà ugualmente grande e l’aggiornamento del parametro sarà ancora maggiore. Quindi, un momentum di 0,9 significa che preserviamo il 90% della velocità del cambiamento precedente per il passo successivo. A ogni passo N, useremo il 90% della velocità totale dei gradienti dei passi N-1.
A questo punto, ti incoraggio a inventare alcuni valori casuali per m e b e i loro gradienti e a usare la regola di aggiornamento del momentum per vedere come cambiano i parametri se vai in salita o in discesa.
Ora vediamo l’implementazione di RMSprop. Come per l’SGD con momentum, il cambiamento principale arriva nella fase di aggiornamento dei parametri.
Per prima cosa, definiamo una nuova funzione con due parametri extra, beta ed epsilon (senza momentum):
def rmsprop_optimization(
   x, y, epochs=100, learning_rate=0.01, batch_size=32,
   stopping_threshold=1e-6, beta=0.9, epsilon=1e-8,
):
   """
   RMSprop optimization with support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize accumulators for squared gradients
   s_m = 0
   s_b = 0
   n = len(x)
   previous_loss = np.inf
Inoltre, all’interno della funzione, creiamo due nuove variabili per accumulare i gradienti al quadrato, s_m e s_b.
Ora, nella fase di aggiornamento, ricalcoliamo i gradienti al quadrato e poi aggiorniamo i parametri:
def rmsprop_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # RMSprop doesn't need gradient clipping
           # Update accumulators
           s_m = beta * s_m + (1 - beta) * (m_gradient**2)
           s_b = beta * s_b + (1 - beta) * (b_gradient**2)
           # Update parameters
           m -= learning_rate * m_gradient / (np.sqrt(s_m) + epsilon)
           b -= learning_rate * b_gradient / (np.sqrt(s_b) + epsilon)
           # The rest of the code is the same
Qui vediamo due nuovi parametri in uso:
epsilon è un valore piccolo, tipicamente 1e-8, per prevenire la divisione per zero negli aggiornamenti.beta è il parametro di decadimento, di solito attorno a 0,9.Il parametro beta controlla quanta storia consideriamo. Un beta più alto significa prendere una visione più di lungo periodo dei gradienti passati, mentre un beta più basso rende l’algoritmo più reattivo ai gradienti recenti.
Non preoccuparti della matematica dietro la regola di aggiornamento di RMSprop. Conta la logica che la guida.
In sostanza, le quattro righe sopra fanno:
In pratica, RMSprop spesso rende meglio dell’SGD di base o dell’SGD con momentum, soprattutto per problemi di ottimizzazione non convessi tipici del deep learning.
Ancora una volta, definiamo una nuova funzione:
def adam_optimization(
   x,
   y,
   epochs=100,
   learning_rate=0.001,
   batch_size=32,
   stopping_threshold=1e-6,
   beta1=0.9,
   beta2=0.999,
   epsilon=1e-8,
):
   """
   Adam optimization with support for mini-batches.
   """
   # Initialize the model parameters
   m = np.random.randn()
   b = np.random.randn()
   # Initialize first and second moment vectors
   m_m, v_m = 0, 0
   m_b, v_b = 0, 0
   n = len(x)
   previous_loss = np.inf
   t = 0  # Initialize timestep
Questa volta definiamo cinque nuove variabili per catturare i vettori del primo e del secondo momento e il passo temporale. Nel contesto di Adam:
1. Il vettore del primo momento (m):
2. Il vettore del secondo momento (v):
Poi, il codice resta uguale fino a dopo il calcolo dei gradienti (non serve il clipping per Adam):
def adam_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Adam doesn't need gradient clipping

           # Update biased first moment estimate
           m_m = beta1 * m_m + (1 - beta1) * m_gradient
           m_b = beta1 * m_b + (1 - beta1) * b_gradient
           # Update biased second raw moment estimate
           v_m = beta2 * v_m + (1 - beta2) * (m_gradient**2)
           v_b = beta2 * v_b + (1 - beta2) * (b_gradient**2)
           # Compute bias-corrected first moment estimate
           m_m_hat = m_m / (1 - beta1**t)
           m_b_hat = m_b / (1 - beta1**t)
           # Compute bias-corrected second raw moment estimate
           v_m_hat = v_m / (1 - beta2**t)
           v_b_hat = v_b / (1 - beta2**t)
           # Update parameters
           m -= learning_rate * m_m_hat / (np.sqrt(v_m_hat) + epsilon)
           b -= learning_rate * m_b_hat / (np.sqrt(v_b_hat) + epsilon)
       # The rest of the code is the same
Anche qui, ti chiedo di non preoccuparti troppo di queste righe: coinvolgono molta matematica. In pratica, quasi mai dovrai implementare Adam da zero, perché ti basta conoscere l’intuizione dietro la sua regola di aggiornamento.
Il primo momento agisce come il momentum, accumulando gradienti passati per dare all’ottimizzazione un senso di direzione e velocità. Questo aiuta Adam a muoversi più rapidamente in direzioni coerenti e a smorzare le oscillazioni in paesaggi di gradienti rumorosi.
Il secondo momento, come in RMSprop, adatta il learning rate per ciascun parametro. Normalizza di fatto gli aggiornamenti, rallentando l’apprendimento per parametri con gradienti grandi e accelerandolo per quelli con gradienti piccoli. Questo permette ad Adam di gestire efficacemente parametri su scale diverse.
Adam include anche una correzione del bias per queste medie mobili, particolarmente importante nelle prime fasi dell’addestramento. Questa correzione aiuta Adam a partire con dimensioni di passo più accurate, portando potenzialmente a progressi iniziali più rapidi.
Combinando questi elementi, Adam spesso raggiunge una convergenza più rapida rispetto a metodi più semplici. È particolarmente efficace in problemi con gradienti rumorosi, obiettivi non stazionari o dataset molto grandi. La natura adattiva di Adam lo rende relativamente poco sensibile al learning rate iniziale, richiedendo spesso meno tuning degli iperparametri rispetto ad altri metodi.
Vediamo ora come generare la tabella di riepilogo vista prima:
comparison_table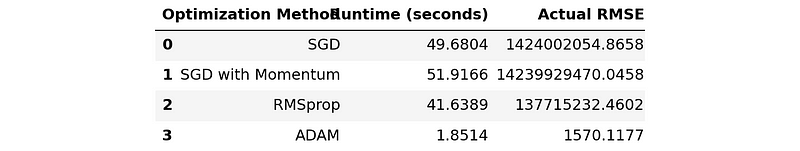
Definiamo una funzione chiamata run_optimization per addestrare un modello di regressione lineare usando le nostre funzioni di ottimizzazione. La funzione registrerà anche runtime e punteggi RMSE:
import time
def run_optimization(opt_func, x, y, **kwargs):
   # Start a timer
   start_time = time.time()

   # Run the optimization function
   m, b = opt_func(x, y, **kwargs)

   # End the timer
   end_time = time.time()
   # Run the model on the test set with found parameters
   y_preds = model(m, test_xy[:, 0], b)
   y_preds_denormalized = y_preds * std[1] + mean[1]
   y_true_denormalized = test_xy[:, 1] * std[1] + mean[1]

   # Compute MSE and RMSE
   actual_mse = np.mean((y_true_denormalized - y_preds_denormalized) ** 2)
   return end_time - start_time, np.sqrt(actual_mse)
Ora chiameremo questa funzione quattro volte per ciascuna delle funzioni di ottimizzazione, salvando i risultati in una lista in cui ogni elemento è una tripla (nome algoritmo, tempo di esecuzione in secondi, punteggio RMSE):
# Run all optimization methods
results = []
results.append(
   (
       "SGD",
       *run_optimization(
           stochastic_gradient_descent,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
       ),
   )
)
results.append(
   (
       "SGD with Momentum",
       *run_optimization(
           stochastic_gradient_descent_with_momentum,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
           momentum=0.9,
       ),
   )
)
results.append(
   (
       "RMSprop",
       *run_optimization(
           rmsprop_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta=0.9,
           epsilon=1e-8,
       ),
   )
)
results.append(
   (
       "Adam",
       *run_optimization(
           adam_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta1=0.9,
           beta2=0.999,
           epsilon=1e-8,
       ),
   )
)
Per un confronto equo, manteniamo uguali il learning rate, il numero di epoch e la dimensione del batch.
Dopodiché, possiamo creare la nostra tabella:
from tabulate import tabulate  # pip install tabulate
# Create and print the table
headers = ["Optimization Method", "Runtime (seconds)", "Actual RMSE"]
print(tabulate(results, headers=headers, floatfmt=".4f"))
# Save the table
pd.DataFrame(results, columns=headers).to_csv("optimization_results.csv", index=False)
Ecco il risultato finale:
Optimization Method      Runtime (seconds)       Actual RMSE
---------------------  -------------------  ----------------
SGD                                49.9305   1424002054.8658
SGD with Momentum                  50.7744  14239929470.0458
RMSprop                            41.9895    137715232.4602
Adam                                1.8462         1570.1177
Prima di proseguire, ti invito a sperimentare con i parametri di ciascuna funzione di ottimizzazione. È probabile che tu riesca a rendere ognuna, soprattutto Adam, ancora più veloce e accurata regolando il learning rate, aumentando il batch size o controllando il bias.
Vedi la sezione conclusioni per i link al codice completo dello script di confronto e a come creare il grafico visto all’inizio.
Usare Adam in pratica non richiede di leggere un articolo lungo come questo né di scriverlo da zero. La sua implementazione in PyTorch è più che adeguata per qualsiasi compito di apprendimento supervisionato nel deep learning.
Ecco uno snippet essenziale che delinea un tipico workflow in PyTorch che usa l’ottimizzatore Adam dal modulo torch.optim:
# Import necessary modules
import torch
import torch.nn as nn
import torch.optim as optim
# Define your model
model = nn.Sequential(
   nn.Linear(10, 50),
   nn.ReLU(),
   nn.Linear(50, 1)
)
# Initialize Adam optimizer
optimizer = optim.Adam(model.parameters(), lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0)
# Training loop
for epoch in range(num_epochs):
   for batch in dataloader:
       # Zero the gradients
       optimizer.zero_grad()

       # Forward pass
       outputs = model(batch)
       loss = criterion(outputs, targets)

       # Backward pass
       loss.backward()

       # Update weights
       optimizer.step()
# Adjusting learning rate
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=30, gamma=0.1)
for epoch in range(num_epochs):
   train(...)
   scheduler.step()
Per saperne di più sull’uso generale di PyTorch e dei suoi algoritmi di ottimizzazione, dai un’occhiata a questo corso introduttivo di DataCamp:
In questo articolo abbiamo imparato i dettagli dell’ottimizzatore Adam. Siamo partiti costruendone l’intuizione, discutendo gli algoritmi fondativi come il gradient descent, l’SGD e RMSprop. Abbiamo visto come Adam combini le idee principali da questi, risultando in un algoritmo molto flessibile e performante.
Poi abbiamo trattato come implementare l’ottimizzatore Adam in Python usando solo NumPy. Come per l’intuizione, abbiamo costruito il codice partendo dagli algoritmi base, dal mini-batch gradient descent fino a RMSprop e ad Adam. Abbiamo anche osservato una differenza impressionante tra Adam e gli altri algoritmi in termini di velocità e performance creando un semplice script di benchmarking.
Infine, abbiamo mostrato come usare Adam in PyTorch, proprio come faresti in pratica, per risolvere problemi di deep learning. Ecco alcuni link agli script usati nel tutorial:
E alcune risorse correlate per approfondire PyTorch e le sue funzioni di ottimizzazione:
Grazie per la lettura!
I migliori corsi su PyTorch
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



