

Apache Parquet 的特性
让我们通过其关键特性来理解 Apache Parquet 的架构:
列式存储
与 CSV 等行式格式不同,Parquet 按列组织数据。这意味着当我们运行查询时,它只会提取所需的列,而不是加载全部数据。这提升了性能并降低了 I/O 开销。
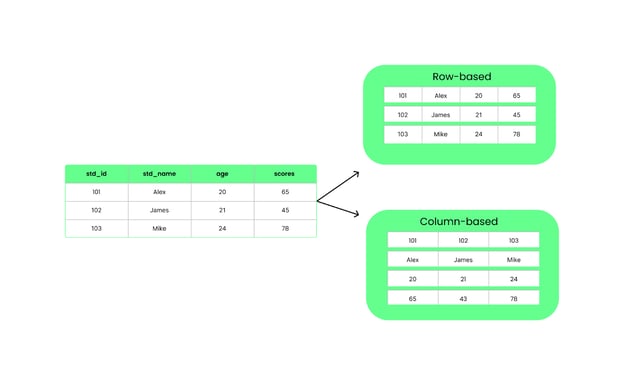
行式 vs 列式结构。图片来源:作者。
Parquet 文件被划分为行组(row group),每个行组包含一批行。每个行组又被拆分为列块(column chunk),每个列块包含某一列的数据。这些列块进一步被分成更小的页面(page),并通过压缩来节省空间。
此外,Parquet 文件在尾部还存储了称为元数据(metadata)的附加信息,用于定位并仅读取我们所需的数据。
其结构大致如下所示:
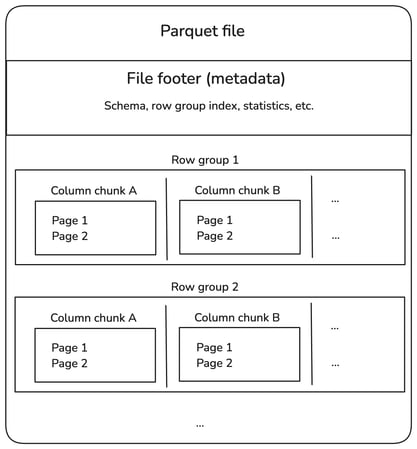
Parquet 文件内部结构。图片来源:作者。
下面我们来拆解上图中的各个组件。
行组(Row groups)
- 一个行组包含多行数据,但以列式方式存储,便于高效读取。
- 示例:一个包含 100 万行的数据集,可能被拆分为 10 个行组,每组 10 万行。
列块(Column chunks)
- 在每个行组内,数据按照列进行分隔。
- 这种设计支持列裁剪(column pruning),我们可以仅读取相关列,而无需扫描整个文件。
页面(Pages)
- 每个列块进一步被分割为多个页面,以优化内存使用。
- 页面通常会被压缩,从而降低存储成本。
尾部(元数据)
- Parquet 文件末尾的尾部存储索引信息:
- 模式(Schema): 定义数据类型和列名。
- 行组偏移: 有助于快速定位特定数据。
- 统计信息: 最小/最大值以支持谓词下推(在存储层进行过滤)。
压缩与编码
如前所述,Parquet 按列对数据进行压缩,常用压缩方法包括 Snappy 和 Gzip。它还使用两种编码技术:
- 游程编码(Run-length encoding)以紧凑方式存储重复值。
- 字典编码(Dictionary encoding)通过字典引用来替换重复值。
这能显著减小文件体积并加快数据读取速度,尤其适用于处理大数据时。
模式演进(Schema evolution)
模式演进指修改数据集结构,例如添加或更改列。听起来简单,但根据您的数据存储方式不同,修改模式可能会缓慢且资源开销大。
我们通过对比 CSV 与 Parquet 的模式演进来理解这一点。
假设您有一个 CSV 文件,包含 student_id、student_name 和 student_age 等列。如果您想添加一个新的 scores 列,需要进行以下操作:
- 将整个文件读入内存。
- 更新表头以包含新列
scores。 - 为每位学生添加分数。这意味着为所有行追加值(即使缺失,也可能需要空字符串或
NULL之类的占位符)。 - 将所有内容保存为新的 CSV 文件。
CSV 是一种纯文本格式,缺乏内置的模式支持。这意味着结构上的任何变更都需要重写整个文件;而且如果旧系统预期的结构不同,读取被修改后的文件时可能会出错!
使用 Parquet,您可以添加、移除或更新字段,而不会破坏现有文件。正如之前所述,Parquet 在文件尾部(元数据)中存储模式信息,从而允许在不修改现有文件的情况下演进模式。
其工作方式如下:
- 添加新列时,现有的 Parquet 文件保持不变。
- 新文件会包含新增列,而旧文件仍遵循之前的模式。
- 删除某列无需对历史数据重新处理;查询会忽略缺失的列。
- 如果旧文件中不存在某列,Parquet 引擎(如 Apache Spark、Hive 或 BigQuery)会返回
NULL,而不是让查询失败。 - 在模式修改之后,仍可读取旧的 Parquet 文件。
- 包含新增列的新 Parquet 文件依然可以被期望旧模式的系统读取。
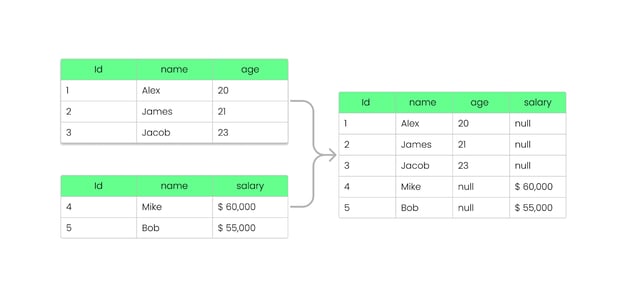
向 Parquet 文件添加列而不破坏兼容性。图片来源:作者。
语言与平台支持
Parquet 支持多种编程语言,如 Java、Python、C++ 和 Rust。这意味着无论平台如何,开发者都能轻松使用。它还与 Apache Spark、Hive, Presto、Flink 和 Trino 等大数据框架原生集成,确保在大规模场景下实现高效数据处理。
因此,无论您使用的是 Python(通过 PySpark)还是其他语言,Parquet 都能以便于跨平台查询与分析的方式来管理数据。
如果您刚接触大数据框架,建议学习 Introduction to PySpark 课程,这是一个很好的起点。
如何读写 Parquet 文件
了解了 Apache Parquet 的基础之后,我将带您完成使用 与 pandas、PyArrow 以及 Spark 等大数据框架集成 Parquet 文件的写入与读取。
使用 pandas 写入 Parquet 文件
要将 DataFrame 保存为 Parquet 文件,您需要安装 pandas 和诸如 PyArrow 的 Parquet 引擎:
pip install pandas pyarrow接下来,使用以下代码写入一个 Parquet 文件:
import pandas as pd
# Sample DataFrame
data = {
"Name": ["Alice", "Bob", "Charlie"],
"Age": [25, 30, 35],
"City": ["New York", "Los Angeles", "Chicago"]
}
df = pd.DataFrame(data)
# Write to Parquet file
df.to_parquet("data.parquet", engine="pyarrow", index=False)
print("Parquet file written successfully!")
使用 pandas 写入 Parquet 文件。图片来源:作者。
使用 pandas 读取 Parquet 文件
以下是读取 Parquet 文件的简单代码:
import pandas as pd
# Read the Parquet file
df = pd.read_parquet("data.parquet", engine="pyarrow")
print("Data from Parquet file:")
print(df)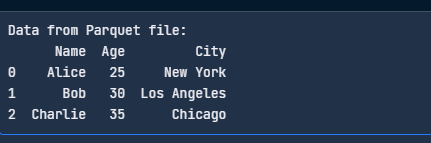
使用 pandas 读取 Parquet 文件。图片来源:作者。
使用 PyArrow 写入 Parquet 文件
PyArrow 是 Apache Arrow 项目提供的工具,便于操作 Parquet 文件。以下示例展示如何使用 PyArrow 写入 Parquet 文件:
import pandas as pd
import pyarrow as pa
import pyarrow.parquet as pq
# Sample data
df = pd.DataFrame({
"Name": ["Jacob", "Lauren", "Oliver"],
"Age": [25, 30, 35],
"City": ["New York", "Los Angeles", "Chicago"]
})
# Convert to a PyArrow table
table = pa.Table.from_pandas(df)
# Write to Parquet file
pq.write_table(table, "data.parquet")
print("Parquet file written successfully!")
使用 PyArrow 写入 Parquet 文件。图片来源:作者。
使用 PyArrow 读取 Parquet 文件
以下是使用 PyArrow 读取 Parquet 文件的方法:
import pyarrow.parquet as pq
# Read the Parquet file
table = pq.read_table("data.parquet")
# Convert to a pandas DataFrame
df = table.to_pandas()
print("Data from Parquet file:")
print(df)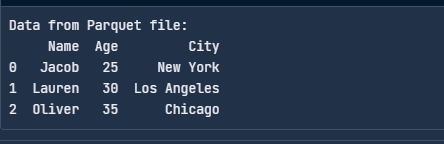
使用 PyArrow 读取 Parquet 文件。图片来源:作者。
与大数据框架集成
我们可以使用 Spark 直接读写 Parquet 文件。您可以从d Apache Spark 官网 下载或按说明进行配置。
完成后,导入库并创建一个 DataFrame:
from pyspark.sql import SparkSession
# Initialize a Spark session
spark = SparkSession.builder.appName("SparkExample").getOrCreate()
# Define the schema for the dataset
schema = ["Name", "Age", "City"]
# Create a sample data
data = [
("Jacob", 30, "New York"),
("Lauren", 35, "Los Angeles"),
("Billy", 25, "Chicago")
]
# Create a DataFrame from the sample data
df = spark.createDataFrame(data, schema)
# Show the DataFrame
df.show()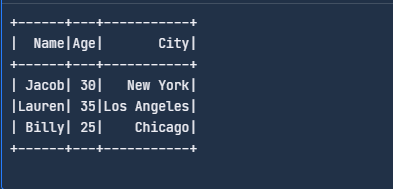
在 Spark 中创建示例 DataFrame。图片来源:作者。
接下来,将该 DataFrame 写入 Parquet 文件:
# Write DataFrame to Parquet
df.write.parquet("data.parquet")write.parquet() 会将 DataFrame 以 Parquet 格式保存,文件名为 employee.parquet。现在,您可以使用以下代码读取该 Parquet 文件:
# Read the Parquet file
parquet_df = spark.read.parquet("data.parquet")
# Show the DataFrame
parquet_df.show()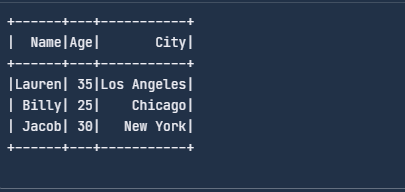
读取 Parquet 文件。图片来源:作者。
除了 Spark,Parquet 也可以与 Hive 配合使用。创建 Hive 表时,使用 STORED AS PARQUET 将 Parquet 作为存储格式。
使用 Parquet 的实用操作
除了读写之外,还有一些每位开发者在处理 Parquet 文件时都应掌握的基础操作。本节我们来一一回顾。
我将使用 pandas 和 PyArrow 来演示这些概念。
向现有 Parquet 文件追加数据
当需要添加新记录但又不想重写整个数据集时,追加数据非常有用。
import pyarrow.parquet as pq
import pyarrow as pa
# Load existing Parquet file
existing_table = pq.read_table("data.parquet")
# New data
new_data = pd.DataFrame({
"Name": ["David", "Emma"],
"Age": [40, 28],
"City": ["San Francisco", "Seattle"]
})
# Convert new data to PyArrow table
new_table = pa.Table.from_pandas(new_data)
# Concatenate both tables
merged_table = pa.concat_tables([existing_table, new_table])
# Write back to Parquet file
pq.write_table(merged_table, "data.parquet")仅读取 Parquet 文件中的特定列
与其加载整个数据集,不如只选择必要的列,以减少内存使用并提升性能。这比读取全量数据集要快得多:
df = pd.read_parquet("data.parquet", columns=["Name", "Age"])
print(df)读取时过滤数据(谓词下推)
Parquet 支持在存储层进行高效过滤,即谓词下推,避免加载不必要的数据。这样无需扫描整个文件,大幅加速查询:
import pyarrow.parquet as pq
# Read only rows where Age > 30
table = pq.read_table("data.parquet", filters=[("Age", ">", 30)])
df = table.to_pandas()
print(df)合并多个 Parquet 文件
Parquet 文件常以分区的方式分别存储。您可以将它们合并为单个 Parquet 文件,这在合并来自不同来源的数据集时很有用:
import pyarrow.parquet as pq
import pyarrow as pa
# List of Parquet files to merge
file_list = ["data_part1.parquet", "data_part2.parquet"]
# Read all files and merge
tables = [pq.read_table(f) for f in file_list]
merged_table = pa.concat_tables(tables)
# Write merged Parquet file
pq.write_table(merged_table, "merged_data.parquet")将 CSV 转换为 Parquet
如果您有现有的 CSV 文件,将其转换为 Parquet 可以节省空间并加速处理,显著减小文件体积并提升读取性能:
df = pd.read_csv("data.csv")
df.to_parquet("data.parquet", engine="pyarrow", index=False)对 Parquet 文件进行分区以加快查询
分区会根据某一列的值将数据组织到子目录中,从而显著加快查询速度。
以下是写入分区数据的方法:
df.to_parquet("partitioned_data/", engine="pyarrow", partition_cols=["City"])上述代码将创建如下子目录:
partitioned_data/City=New York/
partitioned_data/City=Los Angeles/
partitioned_data/City=Chicago/然后,您可以仅读取特定分区:
df = pd.read_parquet("partitioned_data/City=New York/")
print(df)这样一来,仅扫描相关分区即可加速分析!
使用压缩优化存储
Parquet 支持 Snappy、Gzip 和 Brotli 等压缩算法以减小文件大小:
df.to_parquet("compressed.parquet", engine="pyarrow", compression="snappy")使用 Apache Parquet 的最佳实践
我刚开始使用 Apache Parquet 时就意识到,一些细微调整就能显著提升效率。以下是我在真实场景中优化 Parquet 的几点心得。
选择合适的压缩编解码器
如果您想节省存储,Snappy 或 Gzip 通常是不错的选择——Snappy 提供快速的压缩与解压,非常适合速度优先的场景。
相反,如果您更在意存储空间且能接受稍慢的读取速度,Gzip 更合适。关键在于理解您的工作负载——若经常访问文件,更快的 Snappy 往往更胜一筹;而对归档数据而言,Gzip 则更适用。
有效地对数据进行分区
将数据按逻辑子集划分,例如按日期、区域或其他常被查询的字段分区,以减少查询时需要扫描的数据量。曾经我处理过包含多年交易日志的数据集,将其按年和月进行分区,查询特定时间段从分钟级缩短到秒级。
监控模式演进
我始终确保以不干扰现有流程的方式添加新列,通常是以追加的方式而非修改现有列。为此,您可以利用 Apache Spark 的模式演进支持来实现更平滑的过渡。
Apache Parquet 与其他数据格式对比
让我们将 Parquet 与其他数据存储格式进行对比。
Parquet vs CSV
我们已在文中多次提及,但我想再强调一次:Parquet 和 CSV 是两种处理数据方式截然不同的格式。
Parquet 按列组织数据,而 CSV 按行排列。使用 Parquet 时,同一列的数据被集中存储,因此您可以轻松地从特定列中提取数据,而无需遍历其他内容。它速度更快、占用空间更小,因为 Parquet 会对数据进行压缩。
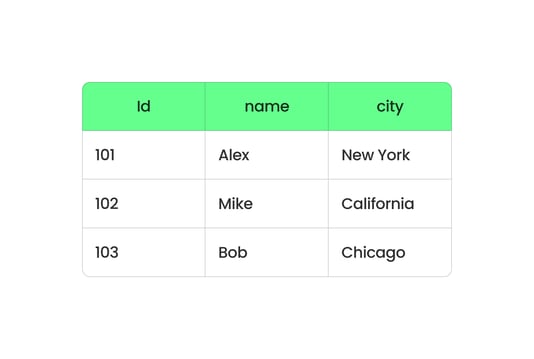
Parquet 列式格式。图片来源:作者。
而 CSV 逐行存储数据。它简单直观,适用于小型数据集,但并不适合大型数据。每次查询都必须读取整行,即使您只需要其中的几个列。这会降低速度并消耗更多内存。
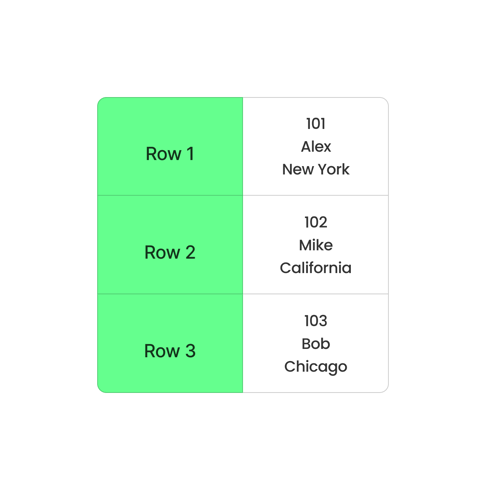
CSV 行式格式。图片来源:作者。
Parquet vs JSON
JSON 非常适合以易于理解的方式组织数据,但它也有一个缺点:在存储效率或速度方面并不理想。下面通过一个例子说明为什么 Parquet 比 JSON 更高效。
假设我们有一个员工数据表,包含三列:EmployeeID、Department 和 Location:
|
EmployeeID |
Department |
Location |
|
1 |
HR |
New York |
|
2 |
HR |
New York |
|
3 |
HR |
New York |
|
4 |
IT |
San Francisco |
|
5 |
IT |
San Francisco |
如果将这些数据保存为 JSON,可能如下所示:
[
{"EmployeeID": 1, "Department": "HR", "Location": "New York"},
{"EmployeeID": 2, "Department": "HR", "Location": "New York"},
{"EmployeeID": 3, "Department": "HR", "Location": "New York"},
{"EmployeeID": 4, "Department": "IT", "Location": "San Francisco"},
{"EmployeeID": 5, "Department": "IT", "Location": "San Francisco"}
]请注意,JSON 会在每条记录中重复列名,如 EmployeeID、Department 和 Location。它也会多次重复 HR 和 New York 这样的值。这会让文件更大、更慢。
现在我们来“想象”(因为 Parquet 不可读)将相同数据保存为 Parquet 的样子:
- EmployeeID:[1, 2, 3, 4, 5]
- Department:[HR, HR, HR, IT, IT](可压缩为 HR: 3,IT: 2)
- Location:[New York, New York, New York, San Francisco, San Francisco](可压缩为 New York: 3,San Francisco: 2)。
Parquet 不按行存储,而是按列组织并对重复值进行压缩。
Parquet vs Avro
Avro 是一种行式格式,适合不断新增记录或检索完整行的场景,如流数据或日志处理。但 Parquet 的列式格式则非常适合分析。如果您需要对海量数据进行分析查询,Parquet 更为合适。它只提取必要列的数据,跳过其余部分,从而节省时间与资源。
简而言之,Parquet 更适合读取和分析大型数据集,而 Avro 则适合以易于更新的方式写入和存储数据。
下面是 Parquet、CSV、JSON 与 Avro 的对比表,包括优缺点与使用场景:
|
Format |
Pros |
Cons |
Use cases |
|
Parquet |
✅ 列式格式,适合快速分析 ✅ 压缩效率高 ✅ 支持模式演进 ✅ 针对大数据框架(Spark、Hive、Presto)优化 ✅ 支持谓词下推(高效过滤) |
❌ 不可读 ❌ 行式操作较慢 ❌ 写入操作更复杂 |
|
|
CSV |
✅ 可读且简单 ✅ 易于生成和解析 ✅ 与几乎所有工具兼容 |
❌ 无模式支持 ❌ 面对大数据集较慢 ❌ 文件体积大(无压缩) ❌ 查询需扫描整个文件 |
|
|
JSON |
✅ 支持嵌套与半结构化数据 ✅ 可读 ✅ 在 Web API 中广泛使用 ✅ 模式灵活 |
❌ 文件较大(文本格式所致) ❌ 大数据查询较慢 ❌ 无原生索引 |
|
|
Avro |
✅ 行式格式,写入速度快 ✅ 紧凑二进制格式(存储高效) ✅ 支持模式演进 ✅ 适用于流处理与消息队列 |
❌ 不可读 ❌ 相比 Parquet,分析型查询效率较低 ❌ 处理需依赖 Avro 库 |
|
何时使用 Apache Parquet
总而言之,以下几种情况最适合使用 Parquet:
- 以分析为主的工作负载:Parquet 的列式格式允许我们仅获取所需数据,从而加速查询、节省时间。我在使用 Apache Spark 处理数据集时就有切身体会——得益于 Parquet 的高效结构,原本需要几分钟的查询能在几秒内完成。
- 数据湖架构:构建数据湖时,存储成本会迅速攀升。而 Parquet 的压缩能力能有效缩小存储数据的体积,帮助您在不牺牲性能的前提下节省存储成本。
- 涉及海量数据集的场景:Parquet 能优雅地处理大型且复杂的数据集,尤其是具有嵌套或层次结构的数据。其对丰富数据类型与模式演进的支持,确保您能随需求变化而调整数据。
结语
Apache Parquet 非常适合处理大数据。它速度快、节省存储空间,并能与 Spark 等工具协同工作。如果您期待进一步学习,请查看以下资源:
- Introduction to Databricks 课程,了解 Databricks 这一统一数据平台,助您简化大数据工作流。
- Cleaning Data with PySpark 课程,学习如何使用 PySpark 清洗与预处理数据集。
- Big Data with PySpark 学习路径,使用 PySpark API 扩展 Apache Spark 的数据处理能力。
常见问题
Parquet 与 ORC(Optimized Row Columnar)相比如何?
Parquet 和 ORC 都是针对大数据优化的列式存储格式,但 ORC 主要在 Hadoop 生态(尤其是 Hive)中使用,而 Parquet 在 Spark、Presto 等大数据框架中有更广泛的支持。ORC 在高度结构化数据上的压缩更佳,而 Parquet 在模式演进方面更灵活,并且能在不同环境中良好工作。
Parquet 能处理实时数据摄取吗,还是主要用于批处理?
Parquet 主要针对批处理设计,并不适合实时流式写入。不过,仍有一些变通方案:
- Kafka + Parquet:您可以先将流数据存储为 Avro,随后定期转换为 Parquet 用于分析。
- Delta Lake/Iceberg:这些格式在 Parquet 之上扩展了对实时写入与 ACID 事务的支持,使其更适用于实时场景。
在云数据湖中存储 Parquet 文件的最佳实践有哪些?
以下是一些在云环境(AWS S3、Azure Data Lake、GCS)中优化 Parquet 性能的最佳实践:
- 分区:按逻辑分区(如
year/month/day)存放文件,加速查询。 - 压缩:读取频繁用 Snappy,更高压缩率选 Gzip/Zstd。
- 文件大小优化:单个文件以 100MB–1GB 为宜,平衡读取性能与元数据开销。
- 列裁剪:仅查询必要列以减少 I/O。
- 使用支持 Parquet 的引擎:使用 Athena、BigQuery 或 Spark 查询,避免裸文件扫描。
如何在 Parquet 文件中更新或删除记录?

我是内容策略专家,热衷于将复杂主题化繁为简。我曾帮助 Splunk、Hackernoon 和 Tiiny Host 等公司为其受众打造兼具吸引力与信息量的内容。
大数据常常让人应接不暇——我们往往觉得没有简单的方法来管理它。但实际上,Apache Parquet 能让这一切变得容易得多。它是一种智能的数据存储格式,能够高效处理海量数据集,为您节省时间和资源。
在本文中,我将带您了解 Parquet 的独特之处,以及如何在您的项目中使用它。读完后,您将明白为什么它深受数据专业人士青睐,并学会如何结合 Python 和 Spark 等工具开始使用它。
什么是 Apache Parquet?
Apache Parquet 是一种开源的列式存储格式,旨在解决大数据处理中的难题。与传统的行式存储不同,它按列组织数据。这样的结构允许您只读取所需的列,从而加速查询并降低资源消耗。
例如,您可以只处理相关数据,而不是为了找到某个属性而处理整个数据集。这也是(还有许多其他原因,稍后会看到)Parquet 天然适配 Apache Hadoop、Apache Spark 和 Apache Hive 等大数据框架的主要原因之一。
除了框架之外,Parquet 也广泛用于数据湖和分析平台。团队通常在 Amazon S3、Azure Data Lake Storage 或 Google Cloud Storage 中存储大规模数据集。由于 Parquet 针对高效查询进行了优化,它是存储结构化与半结构化数据的首选格式。
例如,在 Amazon S3 中,典型工作流程可能包括使用 AWS Glue 编目 Parquet 文件,并通过 Amazon Athena 在无需将数据加载到数据库的情况下运行 SQL 查询。