

Apache Parquet की विशेषताएँ
Apache Parquet की आर्किटेक्चर को इसकी प्रमुख विशेषताओं के साथ समझते हैं:
कॉलमनर स्टोरेज
CSV जैसे रो-बेस्ड फॉर्मेट्स के विपरीत, Parquet डेटा को कॉलम्स में व्यवस्थित करता है। इसका मतलब है कि जब हम क्वेरी चलाते हैं, तो यह सबकुछ लोड करने के बजाय केवल वही कॉलम लाता है जिनकी हमें ज़रूरत है। इससे परफॉर्मेंस बेहतर होती है और I/O उपयोग कम होता है।
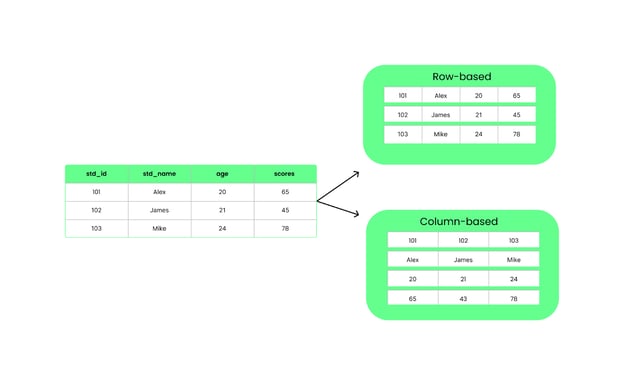
रो बनाम कॉलम-आधारित संरचना। चित्र: लेखक।
Parquet फाइल्स को रो ग्रुप्स में बाँटा जाता है, जिनमें कई रो का बैच होता है। हर रो ग्रुप को कॉलम चंक्स में तोड़ा जाता है, जिनमें प्रत्येक एक कॉलम का डेटा रखता है। ये चंक्स आगे पेजेज़ में विभाजित होते हैं, जिन्हें स्पेस बचाने के लिए कंप्रेस किया जाता है।
इसके अलावा, Parquet फाइल्स फूटर में अतिरिक्त जानकारी, यानी मेटाडेटा, स्टोर करती हैं, जो केवल आवश्यक डेटा ढूँढने और पढ़ने में मदद करता है।
संरचना कुछ इस तरह दिखती है:
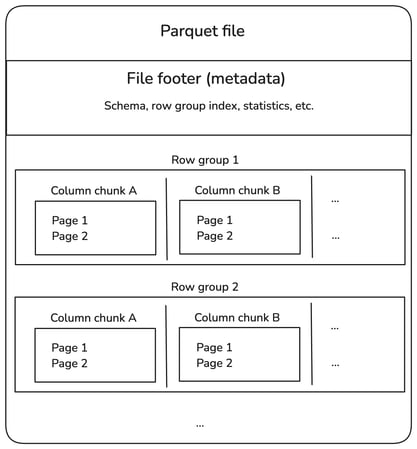
Parquet फाइल की आंतरिक संरचना। चित्र: लेखक।
आइए ऊपर दिए आरेख के प्रत्येक घटक को समझते हैं।
रो ग्रुप्स
- एक रो ग्रुप में कई रो होते हैं लेकिन कुशल रीडिंग के लिए डेटा कॉलम-वाइज स्टोर होता है।
- उदाहरण: 10 लाख रो वाले डेटासेट को 100,000 रो के 10 ग्रुप्स में बाँटा जा सकता है।
कॉलम चंक्स
- हर रो ग्रुप के भीतर, डेटा कॉलम्स के आधार पर अलग होता है।
- यह डिज़ाइन कॉलमन प्रूनिंग की अनुमति देता है, जहाँ हम पूरी फाइल स्कैन करने के बजाय केवल प्रासंगिक कॉलम्स पढ़ते हैं।
पेजेज़
- प्रत्येक कॉलम chunk को आगे पेजेज़ में बाँटा जाता है ताकि मेमोरी उपयोग बेहतर हो।
- पेजेज़ आमतौर पर कंप्रेस होते हैं, जिससे स्टोरेज लागत घटती है।
फूटर (मेटाडेटा)
- Parquet फाइल के अंत में फूटर इंडेक्स जानकारी स्टोर करता है:
- स्कीमा: डेटा टाइप्स और कॉलम नाम परिभाषित करता है।
- रो ग्रुप ऑफ़सेट्स: विशिष्ट डेटा को जल्दी ढूँढने में मदद करता है।
- स्टैटिस्टिक्स: न्यूनतम/अधिकतम मान, जो प्रेडिकेट पुशडाउन (स्टोरेज लेवल पर फ़िल्टरिंग) सक्षम करते हैं।
कंप्रेशन और एन्कोडिंग
जैसा बताया गया, Parquet डेटा को कॉलम-दर-कॉलम कंप्रेस करता है, जैसे Snappy और Gzip जैसी विधियों का उपयोग करके। यह दो एन्कोडिंग तकनीकें भी उपयोग करता है:
- रन-लेंग्थ एन्कोडिंग ताकि दोहराए गए मान कॉम्पैक्ट रूप में स्टोर हों।
- डिक्शनरी एन्कोडिंग जिसमें डुप्लिकेट्स को डिक्शनरी रेफरेंसेज़ से बदला जाता है।
इससे फाइल आकार कम होता है और डेटा रीडिंग तेज़ होती है, जो बिग डेटा के साथ काम करते समय विशेष रूप से मददगार है।
स्कीमा इवोल्यूशन
स्कीमा इवोल्यूशन का मतलब डेटासेट्स की संरचना में बदलाव करना है, जैसे कॉलम जोड़ना या बदलना। सुनने में यह सरल लगता है, लेकिन आपका डेटा कैसे स्टोर है इस पर निर्भर करते हुए, स्कीमा बदलना धीमा और संसाधन-गहन हो सकता है।
इसे CSV और Parquet के स्कीमा इवोल्यूशन की तुलना से समझते हैं।
मान लें आपके पास एक CSV फाइल है, जिसमें student_id, student_name, और student_age कॉलम हैं। यदि आप नया scores कॉलम जोड़ना चाहते हैं, तो आपको यह करना होगा:
- पूरी फाइल को मेमोरी में पढ़ें।
- हेडर अपडेट करें और नया कॉलम
scoresजोड़ें। - हर छात्र के लिए स्कोर जोड़ें। यानी सभी रो में मान जोड़ने होंगे (भले ही गायब हों, आपको खाली स्ट्रिंग्स या
NULLजैसे प्लेसहोल्डर्स चाहिए होंगे)। - सबकुछ नई CSV फाइल के रूप में सेव करें।
CSV एक सरल टेक्स्ट-आधारित फॉर्मेट है जिसमें बिल्ट-इन स्कीमा सपोर्ट नहीं होता। यानी संरचना में कोई भी बदलाव पूरी फाइल को फिर से लिखने की मांग करता है, और संशोधित फाइल को पढ़ने वाले पुराने सिस्टम्स, यदि वे अलग संरचना की उम्मीद करते हैं, तो टूट सकते हैं!
Parquet के साथ, आप फील्ड्स जोड़, हटा या अपडेट कर सकते हैं, बिना मौजूदा फाइल्स को तोड़े। जैसा कि हमने देखा, Parquet फाइल के फूटर (मेटाडेटा) में स्कीमा जानकारी स्टोर करता है, जिससे मौजूदा फाइल्स बदले बिना स्कीमा विकसित किया जा सकता है।
यह ऐसे काम करता है:
- जब आप नया कॉलम जोड़ते हैं, मौजूदा Parquet फाइल्स अपरिवर्तित रहती हैं।
- नई फाइल्स में अतिरिक्त कॉलम होगा, जबकि पुरानी फाइल्स पहले वाले स्कीमा का पालन करेंगी।
- कॉलम हटाने पर पिछले डेटा को फिर से प्रोसेस करने की ज़रूरत नहीं; क्वेरी गायब कॉलम को नज़रअंदाज़ कर देगी।
- यदि किसी पुराने फाइल में कॉलम मौजूद नहीं है, तो Parquet इंजन (जैसे Apache Spark, Hive, या BigQuery) क्वेरी तोड़े बिना
NULLलौटाते हैं। - स्कीमा संशोधनों के बाद भी पुरानी Parquet फाइल्स पढ़ी जा सकती हैं।
- अतिरिक्त कॉलम वाली नई Parquet फाइल्स को वे सिस्टम भी पढ़ सकते हैं जो पुराने स्कीमा की उम्मीद करते हैं।
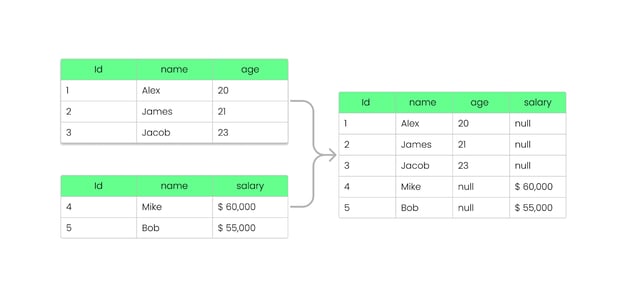
Parquet फाइल में कॉलम जोड़ना, बिना उसे तोड़े। चित्र: लेखक।
भाषा और प्लेटफ़ॉर्म सपोर्ट
Parquet Java, Python, C++, और Rust जैसी विभिन्न प्रोग्रामिंग भाषाओं का समर्थन करता है। यानी डेवलपर्स प्लेटफ़ॉर्म की परवाह किए बिना इसे आसानी से उपयोग कर सकते हैं। यह Apache Spark, Hive, Presto, Flink, और Trino जैसे बिग डेटा फ्रेमवर्क्स के साथ नैटिव रूप से इंटीग्रेटेड है, जो बड़े पैमाने पर कुशल डेटा प्रोसेसिंग सुनिश्चित करता है।
तो चाहे आप Python (PySpark के माध्यम से) उपयोग कर रहे हों या कोई और भाषा, Parquet डेटा को इस तरह मैनेज करता है कि विभिन्न प्लेटफ़ॉर्म्स पर क्वेरी और विश्लेषण आसान हो जाता है।
यदि आप बिग डेटा फ्रेमवर्क्स में नए हैं, तो मैं Introduction to PySpark कोर्स करने की सलाह दूँगा। यह शुरुआत करने का एक बढ़िया तरीका है।
Parquet फाइल्स को कैसे पढ़ें और लिखें
अब जब आप Apache Parquet की बुनियाद जान चुके हैं, मैं आपको Parquet फाइल्स को लिखने, पढ़ने और pandas, PyArrow, और Spark जैसे अन्य बिग डेटा फ्रेमवर्क्स के साथ इंटीग्रेट करने की प्रक्रिया दिखाऊँगा।
pandas का उपयोग करके Parquet फाइल लिखें
DataFrames को Parquet फाइल्स के रूप में सेव करने के लिए आपको pandas और PyArrow जैसे Parquet इंजन की ज़रूरत होगी:
pip install pandas pyarrowअब, नीचे दिया गया कोड उपयोग करके Parquet फाइल लिखें:
import pandas as pd
# Sample DataFrame
data = {
"Name": ["Alice", "Bob", "Charlie"],
"Age": [25, 30, 35],
"City": ["New York", "Los Angeles", "Chicago"]
}
df = pd.DataFrame(data)
# Write to Parquet file
df.to_parquet("data.parquet", engine="pyarrow", index=False)
print("Parquet file written successfully!")
pandas के साथ Parquet फाइल लिखें। चित्र: लेखक।
pandas का उपयोग करके Parquet फाइल पढ़ें
अपनी Parquet फाइल पढ़ने के लिए यह सरल कोड देखें:
import pandas as pd
# Read the Parquet file
df = pd.read_parquet("data.parquet", engine="pyarrow")
print("Data from Parquet file:")
print(df)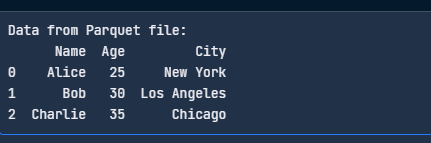
pandas के साथ Parquet फाइल पढ़ें। चित्र: लेखक।
PyArrow का उपयोग करके Parquet फाइल लिखें
PyArrow Apache Arrow प्रोजेक्ट का एक टूल है जो Parquet फाइल्स के साथ काम करना आसान बनाता है। PyArrow का उपयोग करके Parquet फाइल इस तरह लिख सकते हैं:
import pandas as pd
import pyarrow as pa
import pyarrow.parquet as pq
# Sample data
df = pd.DataFrame({
"Name": ["Jacob", "Lauren", "Oliver"],
"Age": [25, 30, 35],
"City": ["New York", "Los Angeles", "Chicago"]
})
# Convert to a PyArrow table
table = pa.Table.from_pandas(df)
# Write to Parquet file
pq.write_table(table, "data.parquet")
print("Parquet file written successfully!")
PyArrow के साथ Parquet फाइल लिखें। चित्र: लेखक।
PyArrow का उपयोग करके Parquet फाइल पढ़ें
PyArrow का उपयोग करके Parquet फाइल इस तरह पढ़ें:
import pyarrow.parquet as pq
# Read the Parquet file
table = pq.read_table("data.parquet")
# Convert to a pandas DataFrame
df = table.to_pandas()
print("Data from Parquet file:")
print(df)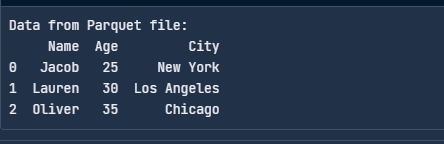
PyArrow के साथ Parquet फाइल पढ़ें। चित्र: लेखक।
बिग डेटा फ्रेमवर्क्स के साथ इंटीग्रेट करें
हम Spark का उपयोग करके सीधे Parquet फाइल्स को पढ़ और लिख सकते हैं। इसे Apache Spark की वेबसाइट से डाउनलोड करें या निर्देशों का पालन करते हुए सेटअप करें।
हो जाने पर, लाइब्रेरीज़ इंपोर्ट करें और एक DataFrame बनाएँ:
from pyspark.sql import SparkSession
# Initialize a Spark session
spark = SparkSession.builder.appName("SparkExample").getOrCreate()
# Define the schema for the dataset
schema = ["Name", "Age", "City"]
# Create a sample data
data = [
("Jacob", 30, "New York"),
("Lauren", 35, "Los Angeles"),
("Billy", 25, "Chicago")
]
# Create a DataFrame from the sample data
df = spark.createDataFrame(data, schema)
# Show the DataFrame
df.show()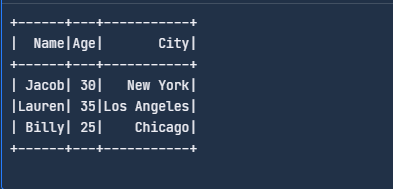
Spark में एक सैंपल DataFrame बनाएँ। चित्र: लेखक।
अब, इस DataFrame को Parquet फाइल के रूप में लिखें:
# Write DataFrame to Parquet
df.write.parquet("data.parquet")write.parquet() DataFrame को Parquet फॉर्मेट में सेव करता है, और फाइल का नाम employee.parquet होगा। अब, इस Parquet फाइल को पढ़ने के लिए आप नीचे दिया गया कोड उपयोग कर सकते हैं:
# Read the Parquet file
parquet_df = spark.read.parquet("data.parquet")
# Show the DataFrame
parquet_df.show()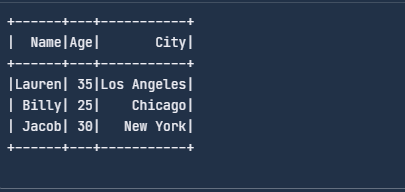
Parquet फाइल पढ़ें। चित्र: लेखक।
Spark के अलावा, Parquet Hive के साथ भी काम कर सकता है। जब आप Hive टेबल बनाते हैं, तो स्टोरेज फॉर्मेट Parquet करने के लिए STORED AS PARQUET का उपयोग करें।
Parquet के साथ उपयोगी ऑपरेशंस
रीड और राइट के अलावा, कुछ बेसिक ऑपरेशंस हैं जो हर डेवलपर को जानने चाहिए, क्योंकि Parquet फाइल्स के साथ काम करते समय ये उपयोगी होते हैं। इस सेक्शन में हम इन्हें देखते हैं।
मैं उदाहरणों के लिए pandas और PyArrow का उपयोग करूँगा।
मौजूदा Parquet फाइल में डेटा जोड़ें
जब नए रिकॉर्ड्स जोड़ने हों और पूरे डेटासेट को फिर से न लिखना हो, तो एपेंडिंग उपयोगी होती है।
import pyarrow.parquet as pq
import pyarrow as pa
# Load existing Parquet file
existing_table = pq.read_table("data.parquet")
# New data
new_data = pd.DataFrame({
"Name": ["David", "Emma"],
"Age": [40, 28],
"City": ["San Francisco", "Seattle"]
})
# Convert new data to PyArrow table
new_table = pa.Table.from_pandas(new_data)
# Concatenate both tables
merged_table = pa.concat_tables([existing_table, new_table])
# Write back to Parquet file
pq.write_table(merged_table, "data.parquet")Parquet फाइल से केवल विशिष्ट कॉलम पढ़ें
पूरे डेटासेट को लोड करने के बजाय, आप केवल आवश्यक कॉलम्स चुन सकते हैं, जिससे मेमोरी उपयोग कम होता है और परफॉर्मेंस बेहतर होती है। यह पूरे डेटासेट को पढ़ने से काफी तेज़ है:
df = pd.read_parquet("data.parquet", columns=["Name", "Age"])
print(df)रीडिंग के दौरान डेटा फ़िल्टर करना (प्रेडिकेट पुशडाउन)
Parquet स्टोरेज लेवल पर कुशल फ़िल्टरिंग की अनुमति देता है, जिसे प्रेडिकेट पुशडाउन कहते हैं, जो अनावश्यक डेटा लोड होने से रोकता है। इससे पूरी फाइल स्कैन करने की ज़रूरत नहीं पड़ती और क्वेरी काफी तेज़ होती हैं:
import pyarrow.parquet as pq
# Read only rows where Age > 30
table = pq.read_table("data.parquet", filters=[("Age", ">", 30)])
df = table.to_pandas()
print(df)कई Parquet फाइल्स मर्ज करें
अक्सर Parquet फाइल्स अलग-अलग पार्टिशन्स के रूप में स्टोर होती हैं। आप उन्हें एक एकल Parquet फाइल में मर्ज कर सकते हैं। यह विभिन्न स्रोतों से डेटासेट्स को संयोजित करते समय उपयोगी है:
import pyarrow.parquet as pq
import pyarrow as pa
# List of Parquet files to merge
file_list = ["data_part1.parquet", "data_part2.parquet"]
# Read all files and merge
tables = [pq.read_table(f) for f in file_list]
merged_table = pa.concat_tables(tables)
# Write merged Parquet file
pq.write_table(merged_table, "merged_data.parquet")CSV को Parquet में बदलें
यदि आपके पास मौजूदा CSV फाइल्स हैं, तो उन्हें Parquet में बदलने से स्पेस बचता है और प्रोसेसिंग तेज़ होती है, जिससे फाइल साइज में भारी कमी आती है और रीड परफॉर्मेंस बेहतर होती है:
df = pd.read_csv("data.csv")
df.to_parquet("data.parquet", engine="pyarrow", index=False)तेज़ क्वेरीज़ के लिए Parquet फाइल्स को पार्टिशन करें
पार्टिशनिंग डेटा को किसी कॉलम मान के आधार पर सबडायरेक्टरीज़ में व्यवस्थित करती है, जिससे क्वेरीज़ काफी तेज़ हो जाती हैं।
पार्टिशन्ड डेटा इस तरह लिख सकते हैं:
df.to_parquet("partitioned_data/", engine="pyarrow", partition_cols=["City"])ऊपर का कोड ये सबडायरेक्टरीज़ बनाता है:
partitioned_data/City=New York/
partitioned_data/City=Los Angeles/
partitioned_data/City=Chicago/फिर, आप किसी एक विशिष्ट पार्टिशन को ही पढ़ सकते हैं:
df = pd.read_parquet("partitioned_data/City=New York/")
print(df)इससे सिर्फ़ संबंधित पार्टिशन्स स्कैन होते हैं, और विश्लेषण तेज़ हो जाता है!
स्टोरेज को ऑप्टिमाइज़ करने के लिए कंप्रेशन का उपयोग करें
Parquet फाइल साइज घटाने के लिए Snappy, Gzip, और Brotli जैसे कंप्रेशन एल्गोरिद्म सपोर्ट करता है:
df.to_parquet("compressed.parquet", engine="pyarrow", compression="snappy")Apache Parquet उपयोग करने के सर्वोत्तम तरीके
जब मैंने पहली बार Apache Parquet का उपयोग शुरू किया, तो महसूस हुआ कि छोटे-छोटे समायोजन इसकी दक्षता को बहुत बढ़ा सकते हैं। वास्तविक परिदृश्यों में Parquet को ऑप्टिमाइज़ करने के लिए मेरे कुछ शीर्ष सुझाव यहाँ हैं।
सही कंप्रेशन कोडेक चुनें
यदि आप स्टोरेज बचाना चाहते हैं, तो Snappy या Gzip जैसे कोडेक्स बेहतरीन विकल्प हैं—Snappy तेज़ कंप्रेशन और डिकंप्रेशन देता है, जो स्पीड महत्वपूर्ण होने पर उपयुक्त है।
इसके विपरीत, यदि स्टोरेज बहुत सीमित है और आप थोड़ी धीमी रीड सह सकते हैं, तो Gzip आदर्श है। कुंजी है अपने वर्कलोड को समझना—यदि आप फाइल्स को बार-बार एक्सेस करते हैं, तो Snappy जैसे तेज़ कोडेक अक्सर बेहतर रहते हैं। जबकि आर्काइवल डेटा के लिए Gzip उपयुक्त है।
डेटा को प्रभावी ढंग से पार्टिशन करें
अपने डेटा को तार्किक सबसेट्स में बाँटें, जैसे डेट, रीज़न, या किसी भी अक्सर क्वेरी किए जाने वाले फ़ील्ड के आधार पर, ताकि क्वेरी के दौरान स्कैन होने वाले डेटा की मात्रा घटे। मैंने एक बार वर्षों के ट्रांज़ैक्शन लॉग्स वाले डेटासेट को वर्ष और माह के आधार पर पार्टिशन किया था, जिससे विशिष्ट अवधि सेकंड्स में मिल जाती थी, मिनट्स में नहीं।
स्कीमा इवोल्यूशन पर नज़र रखें
मैं हमेशा सुनिश्चित करता हूँ कि नए कॉलम इस तरह जोड़े जाएँ कि मौजूदा प्रक्रियाएँ बाधित न हों। इसका सामान्य अर्थ है मौजूदा कॉलम्स को बदलने के बजाय उन्हें जोड़ना। ऐसा करने के लिए, आप सुगम ट्रांज़िशन्स हेतु Apache Spark के स्कीमा इवोल्यूशन सपोर्ट का उपयोग कर सकते हैं।
Apache Parquet बनाम अन्य डेटा फॉर्मेट्स
आइए Parquet की अन्य डेटा स्टोरेज फॉर्मेट्स से तुलना करते हैं।
Parquet बनाम CSV
हमने इसे पूरे ब्लॉग में कवर किया है, लेकिन एक बार फिर ज़ोर देता हूँ: Parquet और CSV दो अलग फॉर्मेट्स हैं जो डेटा को अलग तरीके से हैंडल करते हैं।
Parquet डेटा को कॉलम्स में संगठित करता है, जबकि CSV इसे रो में व्यवस्थित करता है। Parquet उपयोग करने पर, एक ही कॉलम का सारा डेटा साथ रहता है, इसलिए आप अन्य सब कुछ छाँटने के बजाय विशिष्ट कॉलम्स से डेटा आसानी से खींच सकते हैं। यह तेज़ है और कम स्पेस लेता है क्योंकि Parquet डेटा को कंप्रेस करता है।
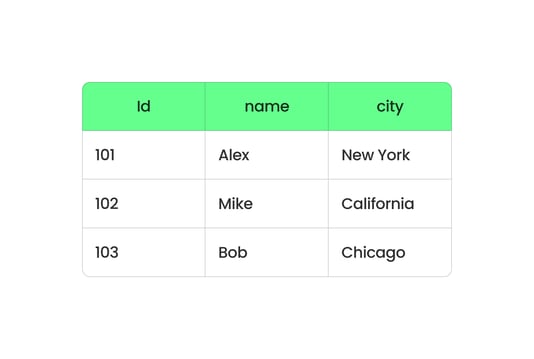
Parquet कॉलम-आधारित फॉर्मेट। चित्र: लेखक।
दूसरी ओर, CSV डेटा को रो-दर-रो स्टोर करता है। यह सरल है और छोटे डेटासेट्स के लिए अच्छा काम करता है, लेकिन बड़े डेटासेट्स के लिए आदर्श नहीं। हर क्वेरी को पूरी रो पढ़नी पड़ती है, भले ही आपको केवल कुछ कॉलम्स चाहिए हों। इससे गति धीमी होती है और प्रोसेस करने के लिए अधिक मेमोरी लगती है।
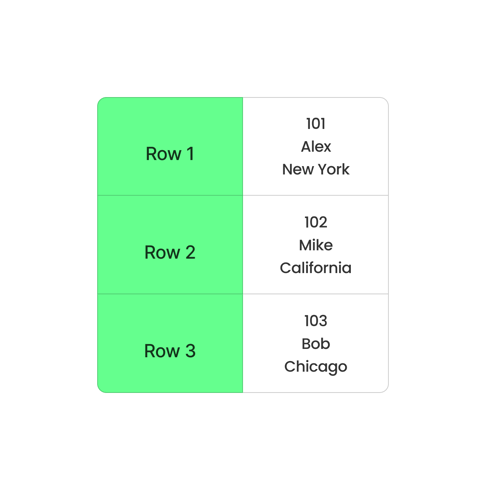
CSV रो-आधारित फॉर्मेट। चित्र: लेखक।
Parquet बनाम JSON
JSON डेटा स्ट्रक्चर करने के लिए बेहतरीन है और समझने में आसान भी, लेकिन इसकी एक कमी है: स्टोरेज या स्पीड के लिहाज से यह बहुत कुशल नहीं है। तो, मैं एक उदाहरण से समझाता हूँ कि Parquet JSON से अधिक कुशल क्यों है।
मान लें हमारे पास तीन कॉलम वाला एक कर्मचारी डेटा टेबल है: EmployeeID, Department, और Location:
|
EmployeeID |
Department |
Location |
|
1 |
HR |
New York |
|
2 |
HR |
New York |
|
3 |
HR |
New York |
|
4 |
IT |
San Francisco |
|
5 |
IT |
San Francisco |
अब, यदि हम इस डेटा को JSON के रूप में सेव करें, तो यह कुछ इस तरह दिखेगा:
[
{"EmployeeID": 1, "Department": "HR", "Location": "New York"},
{"EmployeeID": 2, "Department": "HR", "Location": "New York"},
{"EmployeeID": 3, "Department": "HR", "Location": "New York"},
{"EmployeeID": 4, "Department": "IT", "Location": "San Francisco"},
{"EmployeeID": 5, "Department": "IT", "Location": "San Francisco"}
]ध्यान दें कि JSON हर रिकॉर्ड के लिए EmployeeID, Department, और Location जैसे कॉलम नामों को दोहराता है। यह HR और New York मानों को भी कई बार दोहराता है। इससे फाइल बड़ी और धीमी हो जाती है।
अब कल्पना करें (क्योंकि Parquet मानव-पठनीय नहीं है) कि हम यही डेटा Parquet में सेव करें:
- EmployeeID: [1, 2, 3, 4, 5]
- Department: [HR, HR, HR, IT, IT] (कंप्रेस्ड: HR: 3, IT: 2)
- Location: [New York, New York, New York, San Francisco, San Francisco] (कंप्रेस्ड: New York: 3, San Francisco: 2).
रो-दर-रो स्टोर करने के बजाय, Parquet डेटा को कॉलम्स के हिसाब से व्यवस्थित करता है और दोहराए गए मानों को कंप्रेस करता है।
Parquet बनाम Avro
Avro एक रो-बेस्ड फॉर्मेट है। यह स्ट्रीमिंग डेटा या लॉग प्रोसेसिंग जैसे कार्यों के लिए बढ़िया है, जहाँ आप लगातार नए रिकॉर्ड जोड़ते हैं या पूरी रो प्राप्त करते हैं। लेकिन Parquet का कॉलम-बेस्ड फॉर्मेट एनालिटिक्स के लिए उपयुक्त है। यदि आप बड़े पैमाने पर डेटा का विश्लेषण करने वाली क्वेरी चलाते हैं, तो Parquet बेहतर काम करेगा। यह आवश्यक कॉलम्स से डेटा खींचता है और बाकी को छोड़ देता है, जिससे समय और संसाधन बचते हैं।
संक्षेप में, Parquet बड़े डेटासेट्स को पढ़ने और विश्लेषण करने के लिए बेहतर है, जबकि Avro डेटा को तेज़ी से लिखने और सरलता से अपडेट-योग्य तरीके से स्टोर करने के लिए आदर्श है।
यहाँ Parquet बनाम CSV बनाम JSON बनाम Avro की तुलना तालिका है, जिसमें फायदे, कमियाँ और उपयोग के मामले शामिल हैं:
|
फॉर्मेट |
फायदे |
कमियाँ |
उपयोग के मामले |
|
Parquet |
✅ तेज़ एनालिटिक्स के लिए कॉलमनर फॉर्मेट ✅ उच्च कंप्रेशन दक्षता ✅ स्कीमा इवोल्यूशन सपोर्ट ✅ बिग डेटा फ्रेमवर्क्स (Spark, Hive, Presto) के लिए ऑप्टिमाइज़्ड ✅ प्रेडिकेट पुशडाउन सपोर्ट (कुशल फ़िल्टरिंग) |
❌ मानव-पठनीय नहीं ❌ रो-बेस्ड ऑपरेशंस के लिए धीमा ❌ लिखने के ऑपरेशंस अधिक जटिल |
|
|
CSV |
✅ मानव-पठनीय और सरल ✅ जनरेट और पार्स करना आसान ✅ लगभग सभी टूल्स के साथ संगत |
❌ स्कीमा सपोर्ट नहीं ❌ बड़े डेटासेट्स के लिए धीमा ❌ बड़ा फाइल साइज (कोई कंप्रेशन नहीं) ❌ क्वेरीज़ के लिए पूरी फाइल स्कैन करनी पड़ती है |
|
|
JSON |
✅ नेस्टेड और सेमी-स्ट्रक्चर्ड डेटा सपोर्ट ✅ मानव-पठनीय ✅ वेब APIs में व्यापक उपयोग ✅ लचीला स्कीमा |
❌ बड़ा फाइल साइज (टेक्स्ट फॉर्मेट के कारण) ❌ बिग डेटा क्वेरीज़ के लिए धीमा ❌ नैटिव इंडेक्सिंग नहीं |
|
|
Avro |
✅ रो-बेस्ड फॉर्मेट, तेज़ राइट्स के लिए ✅ कॉम्पैक्ट बाइनरी फॉर्मेट (कुशल स्टोरेज) ✅ स्कीमा इवोल्यूशन सपोर्ट ✅ स्ट्रीमिंग और मैसेज क्यूज़ के लिए अच्छा |
❌ मानव-पठनीय नहीं ❌ एनालिटिकल क्वेरीज़ के लिए Parquet की तुलना में कम कुशल ❌ प्रोसेसिंग के लिए Avro लाइब्रेरीज़ चाहिए |
|
Apache Parquet कब उपयोग करें
सारांश में, ये कुछ स्थितियाँ हैं जहाँ Parquet सर्वोत्तम विकल्प है:
- एनालिटिक्स-हेवी वर्कलोड्स: Parquet का कॉलमनर फॉर्मेट हमें केवल आवश्यक डेटा लाने देता है, जिससे क्वेरीज़ तेज़ होती हैं और समय बचता है। मैंने इसे Apache Spark के साथ डेटासेट्स प्रोसेस करते समय प्रत्यक्ष रूप से देखा है — जो क्वेरीज़ मिनट्स लेती थीं, Parquet की कुशल संरचना की वजह से सेकंड्स में चलने लगीं।
- डेटा लेक आर्किटेक्चर: डेटा लेक बनाते समय स्टोरेज लागत जल्दी बढ़ती है। लेकिन Parquet की कंप्रेशन क्षमता स्टोर्ड डेटा का आकार घटाती है, जिससे परफॉर्मेंस से समझौता किए बिना स्टोरेज बचता है।
- बड़े डेटासेट्स से जुड़े यूज़ केसेज़: Parquet बड़े और जटिल डेटासेट्स को सुव्यवस्थित ढंग से सँभालता है, खासकर वे जिनमें नेस्टेड या हायरार्किकल संरचनाएँ हों। इसके समृद्ध डेटा टाइप्स और स्कीमा इवोल्यूशन सपोर्ट से आप आवश्यकताओं के अनुसार अपने डेटा को अनुकूलित कर सकते हैं।
अंतिम विचार
Apache Parquet बिग डेटा सँभालने के लिए बेहतरीन है। यह तेज़ है, स्टोरेज स्पेस बचाता है, और Spark जैसे टूल्स के साथ अच्छी तरह काम करता है। यदि आप और सीखने के इच्छुक हैं, तो निम्न संसाधन देखें:
- Introduction to Databricks कोर्स, Databricks—एक यूनिफाइड डेटा प्लेटफ़ॉर्म—को समझने के लिए जो बिग डेटा वर्कफ़्लोज़ को सरल बनाता है।
- Cleaning Data with PySpark कोर्स, PySpark का उपयोग करके डेटासेट्स को साफ़ और प्री-प्रोसेस करने के लिए।
- Big Data with PySpark ट्रैक, PySpark API का उपयोग करके Apache Spark के साथ डेटा प्रोसेसिंग को स्केल करने के लिए।
FAQs
Parquet की ORC (Optimized Row Columnar) से तुलना कैसे होती है?
Parquet और ORC दोनों कॉलमनर स्टोरेज फॉर्मेट्स हैं जो बिग डेटा के लिए ऑप्टिमाइज़्ड हैं, लेकिन ORC मुख्य रूप से Hadoop इकोसिस्टम (खासकर Hive) में उपयोग होता है, जबकि Parquet का Spark, Presto और अन्य बिग डेटा फ्रेमवर्क्स में व्यापक सपोर्ट है। अत्यधिक स्ट्रक्चर्ड डेटा के लिए ORC बेहतर कंप्रेशन देता है, वहीं Parquet स्कीमा इवोल्यूशन के साथ अधिक लचीला है और विभिन्न परिवेशों में अच्छी तरह काम करता है।
क्या Parquet रियल-टाइम डेटा इन्गेस्ट को संभाल सकता है, या यह मुख्यतः बैच प्रोसेसिंग के लिए है?
Parquet मुख्य रूप से बैच प्रोसेसिंग के लिए डिज़ाइन किया गया है, और रियल-टाइम स्ट्रीमिंग इन्गेस्ट के लिए आदर्श नहीं है। फिर भी, कुछ वर्कअराउंड मौजूद हैं:
- Kafka + Parquet: आप स्ट्रीमिंग डेटा को पहले Avro में स्टोर कर सकते हैं और समय-समय पर उसे एनालिटिक्स के लिए Parquet में बदल सकते हैं।
- Delta Lake/Iceberg: ये फॉर्मेट्स Parquet को रियल-टाइम राइट्स और ACID ट्रांज़ैक्शंस सपोर्ट देने के लिए विस्तारित करते हैं, जिससे Parquet रियल-टाइम परिदृश्यों में अधिक उपयोगी हो जाता है।
क्लाउड डेटा लेक्स में Parquet फाइल्स स्टोर करने के सर्वोत्तम तरीके क्या हैं?
क्लाउड एनवायरनमेंट्स (AWS S3, Azure Data Lake, GCS) में Parquet परफॉर्मेंस को ऑप्टिमाइज़ करने के लिए कुछ सर्वोत्तम तरीके:
- पार्टिशनिंग: क्वेरीज़ तेज़ करने के लिए फाइल्स को तार्किक पार्टिशन्स (जैसे
year/month/day) के आधार पर स्टोर करें। - कंप्रेशन: तेज़ रीड्स के लिए Snappy, या बेहतर कंप्रेशन अनुपात के लिए Gzip/Zstd का उपयोग करें।
- फाइल साइज ऑप्टिमाइज़ेशन: रीड परफॉर्मेंस और मेटाडेटा ओवरहेड के बीच संतुलन के लिए प्रति फाइल 100MB–1GB का लक्ष्य रखें।
- कॉलम प्रूनिंग: केवल आवश्यक कॉलम्स की क्वेरी करें ताकि I/O कम हो।
- Parquet-अवेयर इंजनों का उपयोग करें: रॉ फाइल स्कैन्स की बजाय Athena, BigQuery, या Spark से क्वेरी करें।
मैं Parquet फाइल में रिकॉर्ड्स को कैसे अपडेट या डिलीट कर सकता/सकती हूँ?
Parquet इन-प्लेस अपडेट्स या डिलीशंस सपोर्ट नहीं करता क्योंकि यह अपेंड-ओनली राइट्स के लिए ऑप्टिमाइज़्ड है। हालाँकि, आप अपडेट्स और डिलीट्स के लिए Parquet के ऊपर ACID-कंप्लाइंट स्टोरेज लेयर्स, जैसे Delta Lake / Apache Iceberg, का उपयोग कर सकते हैं।
pandas/Spark के लिए एक वर्कअराउंड भी है: Parquet फाइल पढ़ें, रिकॉर्ड्स फ़िल्टर करें, और नई फाइल लिखें:
df = pd.read_parquet("data.parquet")
df = df[df["Name"] != "Alice"] # Delete Alice's record
df.to_parquet("data.parquet", index=False)
मैं एक कंटेंट स्ट्रैटेजिस्ट हूँ जिसे जटिल विषयों को सरल बनाना पसंद है। मैंने Splunk, Hackernoon, और Tiiny Host जैसी कंपनियों को अपने दर्शकों के लिए आकर्षक और सूचनात्मक सामग्री बनाने में मदद की है।
बिग डेटा भारी लग सकता है — अक्सर लगता है कि इसे सँभालने का आसान तरीका नहीं है। लेकिन हकीकत में, Apache Parquet इसे कहीं आसान बना देता है। यह एक स्मार्ट डेटा स्टोरेज फॉर्मेट है जो बड़े डेटासेट्स को ऐसे हैंडल करता है कि आपका समय और संसाधन बचें।
इस लेख में, मैं आपको बताऊँगा कि Parquet को खास क्या बनाता है और इसे अपने प्रोजेक्ट्स में कैसे इस्तेमाल करें। अंत तक, आप जानेंगे कि यह डेटा प्रोफेशनल्स की पसंद क्यों है और Python तथा Spark जैसे टूल्स के साथ इसका उपयोग कैसे शुरू करें।
Apache Parquet क्या है?
Apache Parquet एक ओपन-सोर्स कॉलमनर स्टोरेज फॉर्मेट है जो बिग डेटा प्रोसेसिंग की चुनौतियों का समाधान करता है। पारंपरिक रो-बेस्ड स्टोरेज के विपरीत, यह डेटा को कॉलम्स में व्यवस्थित करता है। इस संरचना से आप केवल आवश्यक कॉलम्स ही पढ़ते हैं, जिससे क्वेरी तेज़ होती है और संसाधन खपत कम होती है।
उदाहरण के लिए, किसी एक एट्रिब्यूट को खोजने के लिए पूरे डेटासेट को प्रोसेस करने के बजाय आप संबंधित डेटा को ही टारगेट कर सकते हैं। यही एक बड़ा कारण है (जैसा हम आगे देखेंगे) कि Parquet, Apache Hadoop, Apache Spark, और Apache Hive जैसे बिग डेटा फ्रेमवर्क्स के लिए स्वाभाविक रूप से उपयुक्त है।
फ्रेमवर्क्स के अलावा, Parquet डेटा लेक्स और एनालिटिक्स प्लेटफ़ॉर्म्स में भी व्यापक रूप से इस्तेमाल होता है। टीमें Amazon S3, Azure Data Lake Storage, या Google Cloud Storage का इस्तेमाल करके डेटा लेक में बड़े पैमाने पर डेटासेट्स स्टोर करती हैं। चूँकि Parquet कुशल क्वेरी के लिए ऑप्टिमाइज़्ड है, यह स्ट्रक्चर्ड और सेमी-स्ट्रक्चर्ड डेटा स्टोर करने के लिए पसंदीदा फॉर्मेट है।
उदाहरण के लिए, Amazon S3 में एक सामान्य वर्कफ़्लो में AWS Glue से Parquet फाइल्स को कैटलॉग करना और Amazon Athena से बिना डेटा को डेटाबेस में लोड किए SQL क्वेरीज़ चलाना शामिल हो सकता है।