

DCLM-7B:关键特性与能力
Apple 最新推出的 DCLM-7B(DataComp for Language Models)基础模型,是 LLM 领域颇具分量的一项新增成果。下面我们来看看它的核心特性。
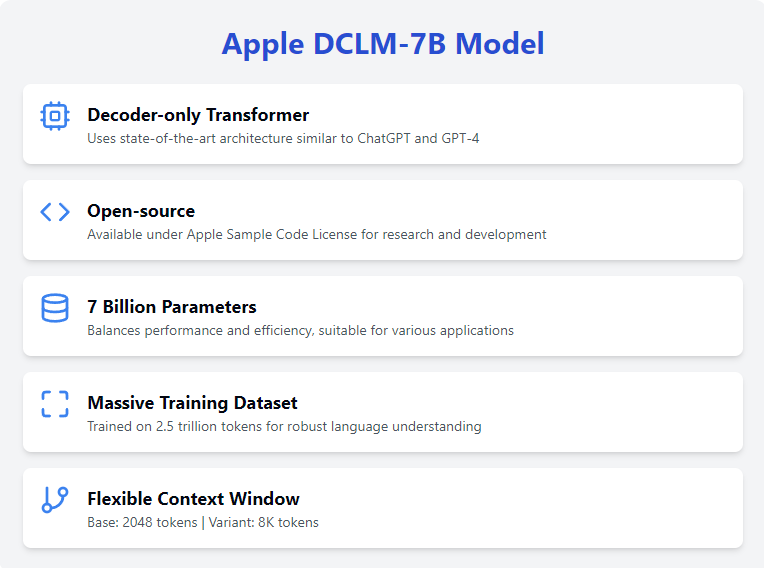
仅解码器 Transformer
DCLM-7B 模型采用仅解码器的Transformer 架构,这是一种让模型一次预测一个 token 的设计,每个生成的 token都会被回传给模型以生成下一个。
这种架构针对生成连贯且具上下文相关性的文本进行了优化,非常适用于各类自然语言处理任务。它与ChatGPT和GPT-4o等前沿模型使用相同的架构,充分证明了其在理解与生成类人文本方面的有效性。
开源
DCLM-7B 模型可在Apple Sample Code License许可下用于研究与开发。此开源方式鼓励 AI 社区广泛使用与协作。
通过开放模型的可用性,Apple 支持 AI 的民主化,让全球研究人员与开发者都能基于这一基础模型进行试验与构建。
70 亿参数
凭借 70 亿参数,DCLM-7B 在性能与计算效率之间取得了平衡。
这种规模使其可以在多数高内存/显存设备和云平台上运行,因而在多种应用中具有通用性与可达性。大量参数使模型能够捕捉复杂的语言模式,从而更好地胜任各类任务。
海量数据集训练
该模型在包含 2.5 万亿个 token 的超大数据集上训练,为广泛的语言任务提供了坚实基础。这使 DCLM-7B 能以较高的准确性与相关性理解并生成文本。此外,它也非常适合进行任务定向微调,因为其对英语具备稳健的基础理解。
上下文窗口
基础版 DCLM-7B 具有 2048 token 的上下文窗口,可处理相对较长的文本序列。尽管以当今标准来看这一数值偏小,Apple 也发布了 8K token 上下文窗口的变体。
更长的上下文窗口为处理更长输入提供了更大灵活性,使该模型适用于需要处理长文本或文档的应用,例如检索增强生成(RAG)。
开始使用 DCLM-7B
Apple 已使 DCLM-7B 模型兼容Hugging Face 的 transformers 库,便于访问与使用。
您可以在Hugging Face 上找到该模型的页面,并查看GitHub 仓库获取更多详情。要使用并访问该模型,我们需要安装 transformers 库:
pip install transformers此外,我们还需要安装 open_lm 框架:
pip install git+https://github.com/mlfoundations/open_lm.git全精度的 DCLM-7B 模型体积相当大,约 27.5GB,运行时需要大量 RAM 或 VRAM。您需要高端计算机或某种云环境。我将使用 Google Colab 的高级订阅笔记本,配备 50GB RAM 和 L4 GPU。
安装好所有必要的库后,我们就可以开始使用该模型了!
DCLM-7B:示例用法
在示例中,我将运行该模型在 Huggingface 页面上提供的一个基础示例。首先,导入所有必要的库:
from open_lm.hf import *
from transformers import AutoTokenizer, AutoModelForCausalLM然后,我们需要下载并初始化分词器与模型(请注意,本示例中我们在 CPU 上以全精度浮点运行模型):
tokenizer = AutoTokenizer.from_pretrained("apple/DCLM-Baseline-7B")
model = AutoModelForCausalLM.from_pretrained("apple/DCLM-Baseline-7B")最后,运行示例提示词:
inputs = tokenizer(["Machine learning is"], return_tensors="pt")
gen_kwargs = {"max_new_tokens": 50, "top_p": 0.8, "temperature": 0.8, "do_sample": True, "repetition_penalty": 1.1}
output = model.generate(inputs['input_ids'], **gen_kwargs)
output = tokenizer.decode(output[0].tolist(), skip_special_tokens=True)我得到如下输出:
[Machine learning is not the solution to everything, it just enables you to solve a problem that otherwise would have been impossible. The biggest challenge for me as a manager of an AI team was to identify those problems where machine learning can really add value and be successful.]高级用法与微调
通过微调 DCLM-7B,您可以将其定制用于特定任务,从而提升在您的应用中的表现。遗憾的是,DCLM-7B 尚未被 Huggingface 的 peft 库支持,因此我们需要使用 transformers 库来进行微调。
在没有LoRA 等工具的情况下,微调如此规模的模型需要极其庞大的资源,几乎等同于从零开始训练。因此,这里我只概述微调流程,而不实际运行以查看结果。
准备数据集
要下载并使用公开可用的数据集,我们将使用 Hugging Face 的 datasets 库。使用以下命令进行安装:
pip install datasets安装完成后,导入并使用 load_dataset 函数。本示例中我将使用 wikitext 数据集:
from datasets import load_dataset
dataset = load_dataset('wikitext', 'wikitext-2-raw-v1')接下来,我们需要对数据集进行分词:
def tokenize_function(examples):
return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=512)
tokenized_datasets = dataset.map(tokenize_function, batched=True)现在,我们已准备好开始微调!
微调
进行微调时,我们需要导入并初始化 TrainingArguments 与 Trainer 对象,然后运行 train() 函数。
from transformers import TrainingArguments, Trainer
training_args = TrainingArguments(
report_to = "none",
output_dir="./results",
evaluation_strategy="epoch",
learning_rate=2e-5, # Controls how much to change the model weights during training
per_device_train_batch_size=2, # Number of samples per batch per device during training
per_device_eval_batch_size=2, # Number of samples per batch per device during evaluation
num_train_epochs=3, # Number of times the entire training dataset will be passed through the model
weight_decay=0.01, # Regularization technique to prevent overfitting
)
trainer = Trainer(
model=model,
args=training_args,
train_dataset=tokenized_datasets['train'],
eval_dataset=tokenized_datasets['test'],
data_collator=data_collator,
tokenizer=tokenizer,
)
trainer.train()结语
总体而言,Apple 的 DCLM-7B 为开源语言模型版图带来了重要补充,为研究人员与开发者提供了应对各类 NLP 任务的强大工具。
作为仅解码器的 Transformer 模型,它针对文本生成进行了优化,能够输出连贯、上下文相关的结果。该模型在 Apple Academic Software License Agreement 下的可用性,进一步鼓励了 AI 社区的协作与创新。

Apple 长期以来一直是科技领域的先驱,不断树立创新标杆。最近,Apple 面向社区发布了一款新的开源大型语言模型(LLM)DCLM-7B。
看到像 Apple 这样的行业巨头以开源形式发布新模型令人鼓舞,这一举措契合了推动 AI 民主化、让更广泛群体能够使用强大工具的趋势。