
Cursus
LLM-toepassingen ontwikkelen met LangChain
3 uur
51.2K
Apple’s nieuwste bijdrage, het DCLM-7B (DataComp for Language Models) basismodel, valt op als een noemenswaardige toevoeging aan het LLM-veld. Laten we de belangrijkste kenmerken bekijken.
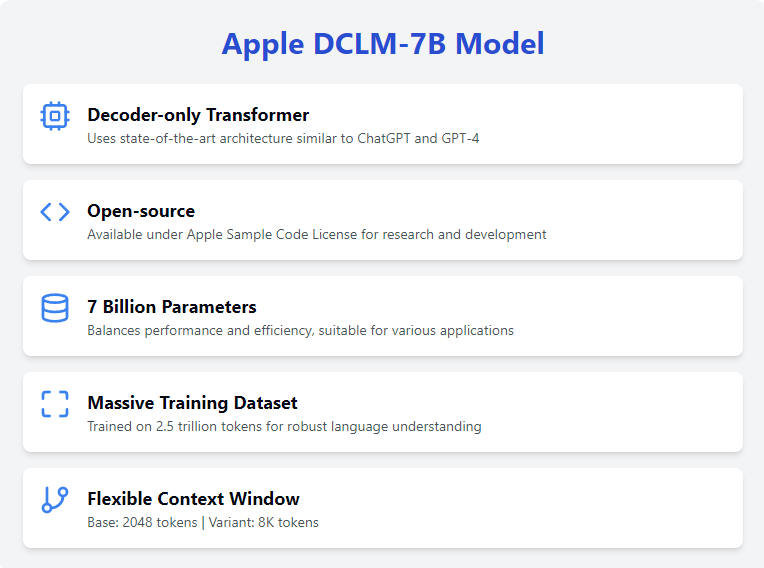
Het DCLM-7B-model gebruikt een alleen-decoder Transformer-architectuur, een ontwerp waarbij het model één token per keer voorspelt en elk gegenereerd token weer aan het model wordt doorgegeven om het volgende te genereren.
Deze architectuur is geoptimaliseerd voor het genereren van samenhangende en contextueel relevante tekst, wat het ideaal maakt voor diverse natural language processing-taken. Het is dezelfde architectuur die wordt gebruikt in state-of-the-art modellen zoals ChatGPT en GPT-4o, wat de effectiviteit aantoont in het begrijpen en genereren van mensachtige tekst.
Het DCLM-7B-model is beschikbaar voor onderzoek en ontwikkeling onder de Apple Sample Code License. Deze open-sourcestrategie stimuleert wijdverbreid gebruik en samenwerking binnen de AI-community.
Door dit model toegankelijk te maken, ondersteunt Apple de democratisering van AI, waardoor onderzoekers en ontwikkelaars wereldwijd kunnen experimenteren met en voortbouwen op het basismodel.
Met 7 miljard parameters slaat het DCLM-7B-model een balans tussen prestaties en rekenkundige efficiëntie.
Deze omvang maakt het mogelijk om het model op de meeste rigs met veel RAM/VRAM en cloudplatforms te draaien, waardoor het veelzijdig en toegankelijk is voor uiteenlopende toepassingen. Het grote aantal parameters stelt het model in staat complexe taalpatronen vast te leggen, wat de capaciteit vergroot om een breed scala aan taken uit te voeren.
Het model is getraind op een uitgebreide dataset van 2,5 biljoen tokens, wat een solide basis biedt voor het aanpakken van een breed scala aan taaltaken. Hierdoor kan het DCLM-7B-model tekst begrijpen en genereren met een hoge mate van nauwkeurigheid en relevantie. Daarnaast maakt dit het model een goede keuze voor taakspecifieke fine-tuning, omdat het een robuuste basiskennis van de Engelse taal heeft.
Het DCLM-7B-basismodel heeft een contextvenster van 2048 tokens, waardoor het relatief lange tekstsequenties kan verwerken. Hoewel dit naar huidige maatstaven relatief klein is, heeft Apple ook een variant uitgebracht met een contextvenster van 8K tokens.
Dit grotere contextvenster biedt nog meer flexibiliteit voor het verwerken van langere input, waardoor het model geschikt is voor toepassingen die uitgebreide teksten of documenten moeten verwerken, zoals Retrieval Augmented Generation (RAG).
Apple heeft het DCLM-7B-model compatibel gemaakt met Hugging Face’ transformers-bibliotheek, waardoor het eenvoudig te benaderen en te gebruiken is.
Je vindt de webpagina van het model op Hugging Face en bekijk de GitHub-repository voor meer details. Om het model te gebruiken en te benaderen, moeten we de transformers-bibliotheek installeren:
pip install transformersDaarnaast moeten we het open_lm-framework installeren:
pip install git+https://github.com/mlfoundations/open_lm.gitHet DCLM-7B-model met volledige precisie is behoorlijk groot, ongeveer 27,5 GB, en vereist veel RAM of VRAM om te draaien. Je hebt een high-end computer of een cloudomgeving nodig. Ik gebruik het premium-abonnement van Google Colab met 50 GB RAM en een L4-GPU.
Met alle benodigde bibliotheken geïnstalleerd, zijn we klaar om het model te gebruiken!
Voor het voorbeeld voer ik een basisvoorbeeld uit dat op de Hugging Face-pagina van het model staat. Eerst importeren we alle benodigde bibliotheken:
from open_lm.hf import *
from transformers import AutoTokenizer, AutoModelForCausalLM
Vervolgens moeten we zowel de tokenizer als het model downloaden en initialiseren (merk op dat we het model met floats op volledige precisie op een CPU draaien voor dit voorbeeld):
tokenizer = AutoTokenizer.from_pretrained("apple/DCLM-Baseline-7B")
model = AutoModelForCausalLM.from_pretrained("apple/DCLM-Baseline-7B")
En tot slot voeren we de voorbeeldprompt uit:
inputs = tokenizer(["Machine learning is"], return_tensors="pt")
gen_kwargs = {"max_new_tokens": 50, "top_p": 0.8, "temperature": 0.8, "do_sample": True, "repetition_penalty": 1.1}
output = model.generate(inputs['input_ids'], **gen_kwargs)
output = tokenizer.decode(output[0].tolist(), skip_special_tokens=True)
Ik kreeg de volgende output:
[Machine learning is not the solution to everything, it just enables you to solve a problem that otherwise would have been impossible. The biggest challenge for me as a manager of an AI team was to identify those problems where machine learning can really add value and be successful.]Fine-tunen van het DCLM-7B-model kan helpen om het af te stemmen op specifieke taken, waardoor de prestaties in je toepassingen verbeteren. Helaas wordt het DCLM-7B-model niet ondersteund door de peft-bibliotheek van Hugging Face, en moeten we daarom de transformers-bibliotheek gebruiken om het te fine-tunen.
Zonder tools zoals LoRA vereist het fine-tunen van een model van deze omvang enorme resources, omdat het in feite neerkomt op trainen vanaf nul. Daarom schets ik hier alleen het fine-tuningproces zonder het daadwerkelijk uit te voeren om de resultaten te zien.
Om een openlijk beschikbare dataset te downloaden en te gebruiken, maken we gebruik van de datasets-bibliotheek van Hugging Face. We installeren die met de volgende opdracht:
pip install datasetsNa installatie importeren en gebruiken we de functie load_dataset; voor dit voorbeeld gebruik ik de wikitext-dataset:
from datasets import load_dataset
dataset = load_dataset('wikitext', 'wikitext-2-raw-v1')
Nu moeten we de dataset tokenizen:
def tokenize_function(examples):
	return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=512)
tokenized_datasets = dataset.map(tokenize_function, batched=True)
Nu zijn we klaar om te beginnen met fine-tunen!
Voor fine-tuning moeten we de objecten TrainingArguments en Trainer importeren en initialiseren en vervolgens de functie train() uitvoeren.
from transformers import TrainingArguments, Trainer
training_args = TrainingArguments(
	    report_to = "none",
	    output_dir="./results",
	    evaluation_strategy="epoch",
	    learning_rate=2e-5,  # Controls how much to change the model weights during training
	    per_device_train_batch_size=2,  # Number of samples per batch per device during training
	    per_device_eval_batch_size=2,  # Number of samples per batch per device during evaluation
	    num_train_epochs=3,  # Number of times the entire training dataset will be passed through the model
	    weight_decay=0.01,  # Regularization technique to prevent overfitting
	)
trainer = Trainer(
	    model=model,
	    args=training_args,
	    train_dataset=tokenized_datasets['train'],
	    eval_dataset=tokenized_datasets['test'],
	    data_collator=data_collator,
	    tokenizer=tokenizer,
	)
trainer.train()Al met al is Apple’s DCLM-7B een belangrijke toevoeging aan het open-sourcelandschap voor taalmodellen, en biedt het onderzoekers en ontwikkelaars een krachtig hulpmiddel voor uiteenlopende NLP-taken.
Als alleen-decoder Transformer-model is het geoptimaliseerd voor tekstgeneratie, met samenhangende en contextueel relevante output. De beschikbaarheid van het model onder de Apple Academic Software License Agreement stimuleert bovendien samenwerking en innovatie binnen de AI-community.
Leer AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

