
Kursus
Mengembangkan Aplikasi LLM dengan LangChain
3 jam
51.3K
Kontribusi terbaru Apple, model dasar DCLM-7B (DataComp for Language Models), menonjol sebagai tambahan yang patut diperhatikan di bidang LLM. Mari kita telusuri fitur-fiturnya.
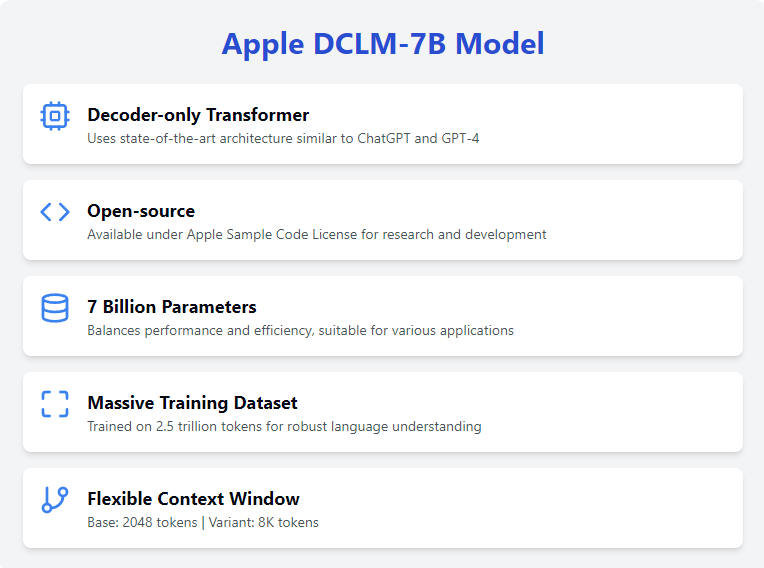
Model DCLM-7B memanfaatkan arsitektur Transformer yang hanya menggunakan decoder, yaitu desain di mana model memprediksi satu token pada satu waktu, dan setiap token yang dihasilkan dimasukkan kembali ke dalam model untuk menghasilkan token berikutnya.
Arsitektur ini dioptimalkan untuk menghasilkan teks yang koheren dan relevan secara kontekstual, sehingga ideal untuk berbagai tugas pemrosesan bahasa alami. Ini adalah arsitektur yang sama yang digunakan pada model terdepan seperti ChatGPT dan GPT-4o, yang membuktikan efektivitasnya dalam memahami dan menghasilkan teks yang menyerupai bahasa manusia.
Model DCLM-7B tersedia untuk riset dan pengembangan di bawah Apple Sample Code License. Pendekatan open-source ini mendorong penggunaan luas dan kolaborasi dalam komunitas AI.
Dengan membuat model ini dapat diakses, Apple mendukung demokratisasi AI, memungkinkan peneliti dan pengembang dari seluruh dunia untuk bereksperimen dan membangun di atas model dasar tersebut.
Dengan 7 miliar parameter, model DCLM-7B menyeimbangkan antara kinerja dan efisiensi komputasi.
Ukuran ini memungkinkan model dijalankan pada sebagian besar rig RAM/VRAM tinggi dan platform cloud, sehingga serbaguna dan mudah diakses untuk berbagai aplikasi. Jumlah parameter yang besar memungkinkan model menangkap pola bahasa yang kompleks, meningkatkan kemampuannya untuk menjalankan beragam tugas.
Model ini telah dilatih pada dataset yang luas berisi 2,5 triliun token, memberikan fondasi yang kuat untuk menangani beragam tugas bahasa. Ini memungkinkan model DCLM-7B memahami dan menghasilkan teks dengan tingkat akurasi dan relevansi yang tinggi. Selain itu, hal ini menjadikan model pilihan yang baik untuk fine-tuning khusus tugas, karena memiliki pemahaman dasar bahasa Inggris yang kuat.
Model dasar DCLM-7B memiliki jendela konteks 2048 token, yang memungkinkannya memproses urutan teks yang relatif panjang. Meskipun ini relatif kecil menurut standar saat ini, Apple juga merilis varian dengan jendela konteks 8K token.
Jendela konteks yang diperluas ini memberikan fleksibilitas lebih besar untuk menangani masukan yang lebih panjang, menjadikan model ini cocok untuk aplikasi yang memerlukan pemrosesan teks atau dokumen panjang, seperti Retrieval Augmented Generation (RAG).
Apple membuat model DCLM-7B kompatibel dengan pustaka transformers milik Hugging Face, sehingga mudah diakses dan digunakan.
Anda dapat menemukan halaman model di Hugging Face, dan lihat repositori GitHub untuk detail lebih lanjut. Untuk menggunakan dan mengakses model, kita perlu memasang pustaka transformers:
pip install transformersSelain itu, kita perlu memasang kerangka kerja open_lm:
pip install git+https://github.com/mlfoundations/open_lm.gitModel DCLM-7B dengan presisi penuh cukup besar, sekitar 27,5GB, sehingga memerlukan RAM atau VRAM yang signifikan untuk dijalankan. Anda akan membutuhkan komputer kelas atas atau semacam lingkungan cloud. Saya akan menggunakan notebook langganan premium Google Colab dengan RAM 50GB dan GPU L4.
Dengan semua pustaka yang diperlukan sudah terpasang, kita siap mulai menggunakan model!
Untuk contoh ini, saya akan menjalankan contoh dasar yang disediakan pada halaman Huggingface model. Pertama, kita impor semua pustaka yang diperlukan:
from open_lm.hf import *
from transformers import AutoTokenizer, AutoModelForCausalLM
Lalu, kita perlu mengunduh dan menginisialisasi tokenizer dan model (perhatikan bahwa untuk contoh ini kita menjalankan model dengan float presisi penuh pada CPU):
tokenizer = AutoTokenizer.from_pretrained("apple/DCLM-Baseline-7B")
model = AutoModelForCausalLM.from_pretrained("apple/DCLM-Baseline-7B")
Terakhir, kita jalankan prompt contoh:
inputs = tokenizer(["Machine learning is"], return_tensors="pt")
gen_kwargs = {"max_new_tokens": 50, "top_p": 0.8, "temperature": 0.8, "do_sample": True, "repetition_penalty": 1.1}
output = model.generate(inputs['input_ids'], **gen_kwargs)
output = tokenizer.decode(output[0].tolist(), skip_special_tokens=True)
Saya mendapatkan keluaran berikut:
[Machine learning is not the solution to everything, it just enables you to solve a problem that otherwise would have been impossible. The biggest challenge for me as a manager of an AI team was to identify those problems where machine learning can really add value and be successful.]Fine-tuning model DCLM-7B dapat membantu menyesuaikannya untuk tugas spesifik, sehingga meningkatkan kinerjanya dalam aplikasi Anda. Sayangnya, model DCLM-7B belum didukung oleh pustaka peft milik Huggingface, sehingga kita perlu menggunakan pustaka transformers untuk melakukan fine-tuning.
Tanpa alat seperti LoRA, melakukan fine-tuning pada model sebesar ini memerlukan sumber daya yang sangat besar, karena pada dasarnya setara dengan melatih dari awal. Oleh karena itu, saya hanya akan menguraikan proses fine-tuning di sini tanpa benar-benar menjalankannya untuk melihat hasilnya.
Untuk mengunduh dan menggunakan dataset yang tersedia secara terbuka, kita akan menggunakan pustaka datasets milik Hugging Face. Kita pasang dengan perintah berikut:
pip install datasetsSetelah terpasang, kita impor dan gunakan fungsi load_dataset; untuk contoh ini saya akan menggunakan dataset wikitext:
from datasets import load_dataset
dataset = load_dataset('wikitext', 'wikitext-2-raw-v1')
Sekarang, kita perlu melakukan tokenisasi pada dataset:
def tokenize_function(examples):
	return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=512)
tokenized_datasets = dataset.map(tokenize_function, batched=True)
Sekarang, kita siap untuk mulai melakukan fine-tuning!
Untuk fine-tuning, kita perlu mengimpor dan menginisialisasi objek TrainingArguments dan Trainer lalu menjalankan fungsi train().
from transformers import TrainingArguments, Trainer
training_args = TrainingArguments(
	    report_to = "none",
	    output_dir="./results",
	    evaluation_strategy="epoch",
	    learning_rate=2e-5,  # Controls how much to change the model weights during training
	    per_device_train_batch_size=2,  # Number of samples per batch per device during training
	    per_device_eval_batch_size=2,  # Number of samples per batch per device during evaluation
	    num_train_epochs=3,  # Number of times the entire training dataset will be passed through the model
	    weight_decay=0.01,  # Regularization technique to prevent overfitting
	)
trainer = Trainer(
	    model=model,
	    args=training_args,
	    train_dataset=tokenized_datasets['train'],
	    eval_dataset=tokenized_datasets['test'],
	    data_collator=data_collator,
	    tokenizer=tokenizer,
	)
trainer.train()Secara keseluruhan, DCLM-7B dari Apple merupakan tambahan penting dalam lanskap model bahasa open-source, yang menawarkan alat kuat bagi peneliti dan pengembang untuk berbagai tugas NLP.
Sebagai model Transformer yang hanya menggunakan decoder, model ini dioptimalkan untuk generasi teks, memberikan keluaran yang koheren dan relevan secara kontekstual. Ketersediaan model ini di bawah Apple Academic Software License Agreement semakin mendorong kolaborasi dan inovasi di komunitas AI.
Pelajari AI lewat kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




