
Corso
Sviluppare applicazioni LLM con LangChain
3 ore
51.3K
L'ultimo contributo di Apple, il modello base DCLM-7B (DataComp for Language Models), spicca come un'aggiunta di rilievo nel campo degli LLM. Vediamo le sue caratteristiche chiave.
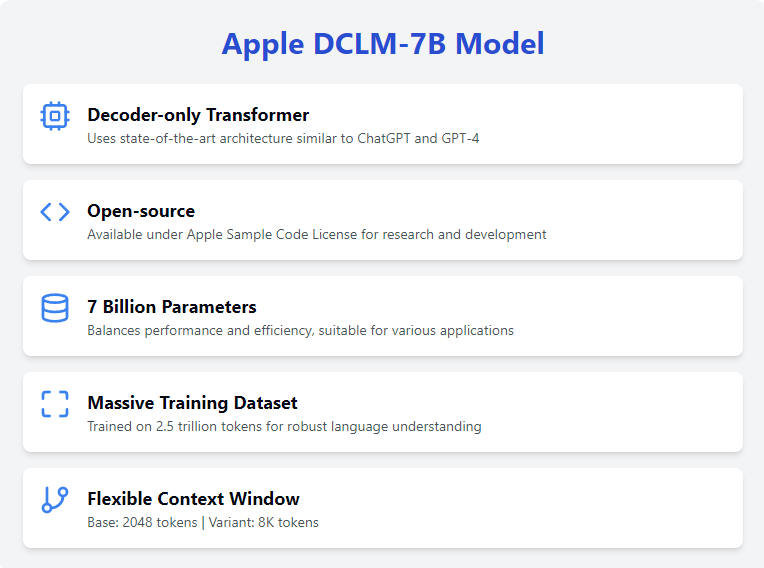
Il modello DCLM-7B utilizza un'architettura Transformer solo decoder, ovvero un design in cui il modello predice un token alla volta e ogni token generato viene reinserito nel modello per generare il successivo.
Questa architettura è ottimizzata per generare testo coerente e contestualmente pertinente, rendendola ideale per vari compiti di elaborazione del linguaggio naturale. È la stessa architettura usata in modelli all'avanguardia come ChatGPT e GPT-4o, a dimostrazione della sua efficacia nel comprendere e generare testo simile a quello umano.
Il modello DCLM-7B è disponibile per ricerca e sviluppo con la Apple Sample Code License. Questo approccio open-source incentiva l'uso diffuso e la collaborazione all'interno della community di IA.
Rendendo il modello accessibile, Apple sostiene la democratizzazione dell'IA, permettendo a ricercatori e sviluppatori di tutto il mondo di sperimentare e costruire a partire dal modello base.
Con 7 miliardi di parametri, il modello DCLM-7B trova un equilibrio tra prestazioni ed efficienza computazionale.
Queste dimensioni consentono di eseguirlo sulla maggior parte delle workstation con molta RAM/VRAM e sulle piattaforme cloud, rendendolo versatile e accessibile a molte applicazioni. L'elevato numero di parametri permette di catturare pattern linguistici complessi, migliorando la capacità di svolgere un'ampia gamma di compiti.
Il modello è stato addestrato su un dataset molto esteso di 2,5 trilioni di token, fornendo una base solida per affrontare un'ampia varietà di compiti linguistici. Questo consente a DCLM-7B di comprendere e generare testo con un alto grado di accuratezza e pertinenza. Inoltre, lo rende una buona scelta per il fine-tuning specifico per il task, grazie a una solida comprensione di base della lingua inglese.
Il modello base DCLM-7B ha una finestra di contesto di 2048 token, che gli consente di elaborare sequenze di testo relativamente lunghe. Sebbene oggi sia relativamente piccola, Apple ha anche rilasciato una variante con una finestra di contesto da 8K token.
Questa finestra estesa offre ancora maggiore flessibilità nella gestione di input lunghi, rendendo il modello adatto ad applicazioni che richiedono l'elaborazione di testi o documenti estesi, come la Retrieval Augmented Generation (RAG).
Apple ha reso il modello DCLM-7B compatibile con la libreria transformers di Hugging Face, rendendolo facile da accedere e utilizzare.
Puoi trovare la pagina del modello su Hugging Face e consultare il repository GitHub per maggiori dettagli. Per usare e accedere al modello, dobbiamo installare la libreria transformers:
pip install transformersInoltre, dobbiamo installare il framework open_lm:
pip install git+https://github.com/mlfoundations/open_lm.gitIl modello DCLM-7B a piena precisione è piuttosto grande, circa 27,5 GB, e richiede una notevole quantità di RAM o VRAM per l'esecuzione. Ti servirà un computer di fascia alta o un qualche ambiente cloud. Io userò il notebook con abbonamento premium di Google Colab con 50 GB di RAM e una GPU L4.
Con tutte le librerie necessarie installate, siamo pronti a iniziare a usare il modello!
Per l'esempio, eseguirò un caso di base fornito sulla pagina Hugging Face del modello. Per prima cosa importiamo tutte le librerie necessarie:
from open_lm.hf import *
from transformers import AutoTokenizer, AutoModelForCausalLM
Poi dobbiamo scaricare e inizializzare sia il tokenizer sia il modello (nota che in questo esempio eseguiamo il modello con float a piena precisione su CPU):
tokenizer = AutoTokenizer.from_pretrained("apple/DCLM-Baseline-7B")
model = AutoModelForCausalLM.from_pretrained("apple/DCLM-Baseline-7B")
Infine, eseguiamo il prompt di esempio:
inputs = tokenizer(["Machine learning is"], return_tensors="pt")
gen_kwargs = {"max_new_tokens": 50, "top_p": 0.8, "temperature": 0.8, "do_sample": True, "repetition_penalty": 1.1}
output = model.generate(inputs['input_ids'], **gen_kwargs)
output = tokenizer.decode(output[0].tolist(), skip_special_tokens=True)
Ho ottenuto il seguente output:
[Machine learning is not the solution to everything, it just enables you to solve a problem that otherwise would have been impossible. The biggest challenge for me as a manager of an AI team was to identify those problems where machine learning can really add value and be successful.]Il fine-tuning del modello DCLM-7B può aiutarti ad adattarlo a compiti specifici, migliorandone le prestazioni nelle tue applicazioni. Purtroppo, DCLM-7B non è supportato dalla libreria peft di Hugging Face e quindi dobbiamo usare la libreria transformers per eseguire il fine-tuning.
Senza strumenti come LoRA, eseguire il fine-tuning di un modello così grande richiede risorse immense, poiché è sostanzialmente come addestrarlo da zero. Perciò qui mi limiterò a delineare il processo di fine-tuning senza eseguirlo per vedere i risultati.
Per scaricare e utilizzare un dataset disponibile liberamente, useremo la libreria datasets di Hugging Face. La installiamo con il seguente comando:
pip install datasetsUna volta installata, importiamo e usiamo la funzione load_dataset; per questo esempio userò il dataset wikitext:
from datasets import load_dataset
dataset = load_dataset('wikitext', 'wikitext-2-raw-v1')
Ora dobbiamo tokenizzare il dataset:
def tokenize_function(examples):
	return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=512)
tokenized_datasets = dataset.map(tokenize_function, batched=True)
Ora siamo pronti per iniziare il fine-tuning!
Per il fine-tuning, dobbiamo importare e inizializzare gli oggetti TrainingArguments e Trainer e poi eseguire la funzione train().
from transformers import TrainingArguments, Trainer
training_args = TrainingArguments(
	    report_to = "none",
	    output_dir="./results",
	    evaluation_strategy="epoch",
	    learning_rate=2e-5,  # Controls how much to change the model weights during training
	    per_device_train_batch_size=2,  # Number of samples per batch per device during training
	    per_device_eval_batch_size=2,  # Number of samples per batch per device during evaluation
	    num_train_epochs=3,  # Number of times the entire training dataset will be passed through the model
	    weight_decay=0.01,  # Regularization technique to prevent overfitting
	)
trainer = Trainer(
	    model=model,
	    args=training_args,
	    train_dataset=tokenized_datasets['train'],
	    eval_dataset=tokenized_datasets['test'],
	    data_collator=data_collator,
	    tokenizer=tokenizer,
	)
trainer.train()Nel complesso, DCLM-7B di Apple è un'aggiunta importante al panorama dei modelli linguistici open-source, offrendo a ricercatori e sviluppatori uno strumento potente per vari task di NLP.
In quanto modello Transformer solo decoder, è ottimizzato per la generazione di testo, producendo output coerenti e contestualmente pertinenti. La disponibilità del modello secondo l'Apple Academic Software License Agreement incoraggia ulteriormente la collaborazione e l'innovazione nella community dell'IA.
Impara l'IA con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



