Kurs
Entwickeln von LLM-Anwendungen mit LangChain
3 Std.
50.6K
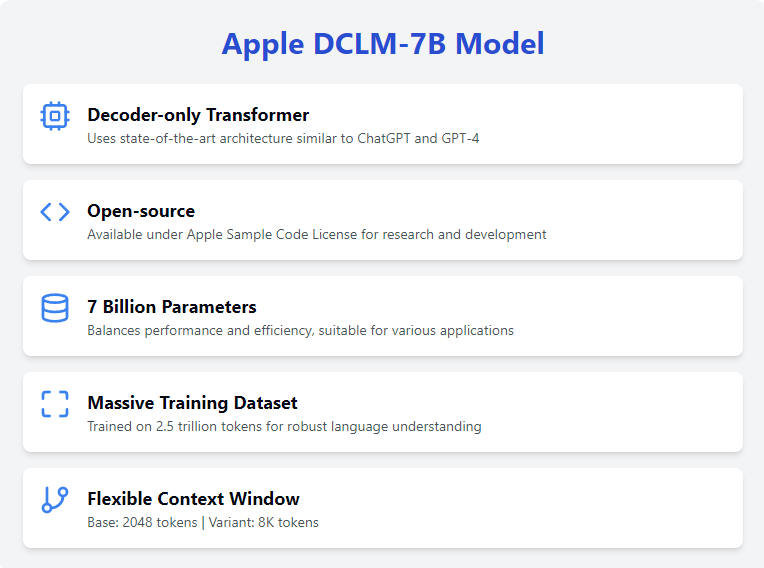
Apples neuester Beitrag, das Basismodell DCLM-7B (DataComp for Language Models), ist eine bemerkenswerte Ergänzung im LLM-Bereich. Schauen wir uns die wichtigsten Merkmale an.
Das DCLM-7B-Modell nutzt eine reine Decoder-Transformer-Architektur. Dabei sagt das Modell jeweils ein Token voraus und speist jedes generierte Token wieder ein, um das nächste zu erzeugen.
Diese Architektur ist auf die Generierung kohärenter, kontextrelevanter Texte ausgelegt und damit ideal für vielfältige Natural-Language-Processing-Aufgaben. Es ist dieselbe Architektur wie in State-of-the-Art-Modellen wie ChatGPT und GPT-4o, was ihre Stärke bei der Verarbeitung und Erzeugung natürlichsprachlicher Texte belegt.
Das DCLM-7B-Modell ist für Forschung und Entwicklung unter der Apple Sample Code License verfügbar. Dieser Open-Source-Ansatz fördert die breite Nutzung und Zusammenarbeit in der KI-Community.
Indem Apple das Modell zugänglich macht, treibt das Unternehmen die Demokratisierung von KI voran und ermöglicht Forscherinnen, Forschern und Entwicklerinnen und Entwicklern weltweit, mit dem Basismodell zu experimentieren und darauf aufzubauen.
Mit 7 Milliarden Parametern findet DCLM-7B einen guten Kompromiss zwischen Leistung und Rechenaufwand.
Damit lässt sich das Modell auf den meisten Rechnern mit viel RAM/VRAM sowie in Cloud-Umgebungen betreiben. Die hohe Parameterzahl hilft, komplexe Sprachmuster abzubilden und eine breite Palette an Aufgaben zu bewältigen.
Das Modell wurde auf einem umfangreichen Datensatz mit 2,5 Billionen Tokens trainiert und verfügt damit über eine starke Basis für vielfältige Sprachaufgaben. So kann DCLM-7B Texte mit hoher Präzision und Relevanz verstehen und generieren. Außerdem ist es dadurch eine gute Wahl für aufgabenspezifisches Feintuning, da es ein robustes Grundverständnis der englischen Sprache mitbringt.
Das Basismodell DCLM-7B verfügt über ein Kontextfenster von 2.048 Tokens und kann damit relativ lange Textsequenzen verarbeiten. Auch wenn das heute eher klein wirkt, hat Apple zusätzlich eine Variante mit 8K-Token-Kontextfenster veröffentlicht.
Das erweiterte Kontextfenster schafft mehr Spielraum für längere Eingaben und eignet sich für Anwendungen, die große Textmengen oder Dokumente verarbeiten, etwa Retrieval Augmented Generation (RAG).
Apple hat DCLM-7B mit der Hugging Face-Bibliothek transformers kompatibel gemacht. So lässt es sich bequem einbinden und nutzen.
Die Modellseite findest du auf Hugging Face. Weitere Details gibt es im GitHub-Repository. Um das Modell zu verwenden, installieren wir zunächst die Bibliothek transformers:
pip install transformersZusätzlich installieren wir das Framework open_lm:
pip install git+https://github.com/mlfoundations/open_lm.gitDas DCLM-7B-Modell in voller Genauigkeit ist mit rund 27,5 GB sehr groß und benötigt entsprechend viel RAM bzw. VRAM. Du brauchst einen leistungsstarken Rechner oder eine Cloud-Umgebung. Ich nutze für das Beispiel ein Google-Colab-Premium-Notebook mit 50 GB RAM und einer L4-GPU.
Sind alle Bibliotheken installiert, können wir loslegen!
Für das Beispiel verwende ich ein kurzes Snippet von der Hugging-Face-Seite des Modells. Zuerst importieren wir die benötigten Bibliotheken:
from open_lm.hf import *
from transformers import AutoTokenizer, AutoModelForCausalLM
Dann laden und initialisieren wir Tokenizer und Modell (im Beispiel laufen volle Fließkomma-Präzision und CPU):
tokenizer = AutoTokenizer.from_pretrained("apple/DCLM-Baseline-7B")
model = AutoModelForCausalLM.from_pretrained("apple/DCLM-Baseline-7B")
Zum Schluss führen wir die Beispiel-Eingabe aus:
inputs = tokenizer(["Machine learning is"], return_tensors="pt")
gen_kwargs = {"max_new_tokens": 50, "top_p": 0.8, "temperature": 0.8, "do_sample": True, "repetition_penalty": 1.1}
output = model.generate(inputs['input_ids'], **gen_kwargs)
output = tokenizer.decode(output[0].tolist(), skip_special_tokens=True)
Ich habe folgende Ausgabe erhalten:
[Machine learning is not the solution to everything, it just enables you to solve a problem that otherwise would have been impossible. The biggest challenge for me as a manager of an AI team was to identify those problems where machine learning can really add value and be successful.]Mit Feintuning kannst du DCLM-7B auf spezifische Aufgaben zuschneiden und die Leistung in deinen Anwendungen steigern. Leider wird DCLM-7B nicht von Hugging Faces peft-Bibliothek unterstützt, daher müssen wir zum Feintuning direkt die transformers-Bibliothek nutzen.
Ohne Werkzeuge wie LoRA erfordert das Feintuning eines so großen Modells enorme Ressourcen und ähnelt faktisch einem Training von Grund auf. Deshalb skizziere ich hier nur den Ablauf, ohne ihn vollständig auszuführen.
Zum Herunterladen und Verwenden eines offenen Datensatzes nutzen wir Hugging Faces datasets-Bibliothek. Installation mit folgendem Befehl:
pip install datasetsNach der Installation importieren wir die Funktion load_dataset. In diesem Beispiel verwende ich den Datensatz wikitext:
from datasets import load_dataset
dataset = load_dataset('wikitext', 'wikitext-2-raw-v1')
Als Nächstes tokenisieren wir den Datensatz:
def tokenize_function(examples):
	return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=512)
tokenized_datasets = dataset.map(tokenize_function, batched=True)
Jetzt können wir mit dem Feintuning starten!
Für das Feintuning importieren und initialisieren wir TrainingArguments und Trainer und starten anschließend train().
from transformers import TrainingArguments, Trainer
training_args = TrainingArguments(
	    report_to = "none",
	    output_dir="./results",
	    evaluation_strategy="epoch",
	    learning_rate=2e-5,  # Controls how much to change the model weights during training
	    per_device_train_batch_size=2,  # Number of samples per batch per device during training
	    per_device_eval_batch_size=2,  # Number of samples per batch per device during evaluation
	    num_train_epochs=3,  # Number of times the entire training dataset will be passed through the model
	    weight_decay=0.01,  # Regularization technique to prevent overfitting
	)
trainer = Trainer(
	    model=model,
	    args=training_args,
	    train_dataset=tokenized_datasets['train'],
	    eval_dataset=tokenized_datasets['test'],
	    data_collator=data_collator,
	    tokenizer=tokenizer,
	)
trainer.train()In Summe ist Apples DCLM-7B eine wertvolle Bereicherung der Open-Source-Landschaft für Sprachmodelle und bietet Forschung und Entwicklung ein starkes Werkzeug für vielfältige NLP-Aufgaben.
Als reines Decoder-Transformer-Modell ist es für die Textgenerierung optimiert und liefert kohärente, kontextsensible Ausgaben. Die Verfügbarkeit unter der Apple Academic Software License Agreement fördert zudem Zusammenarbeit und Innovation in der KI-Community.
Lerne KI mit diesen Kursen!
Kurs
Kurs
Kurs