Cours
Développement d'applications LLM avec LangChain
3 h
50.6K
Dernière contribution d'Apple, le modèle de base DCLM-7B (DataComp for Language Models) s'impose comme une référence notable dans le domaine des LLM. Voyons ses principaux atouts.
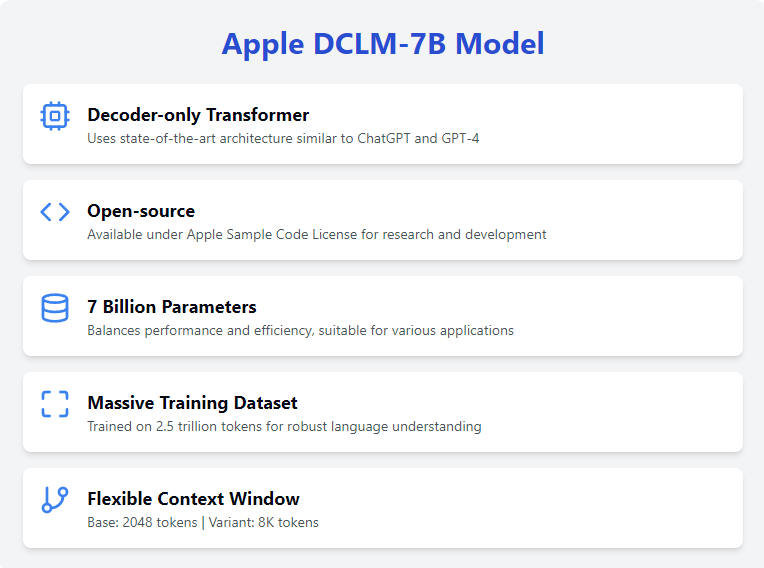
Le modèle DCLM-7B s'appuie sur une architecture Transformer à décodeur seul : le modèle prédit un jeton à la fois et chaque jeton généré est réinjecté pour produire le suivant.
Cette architecture est optimisée pour générer un texte fluide et pertinent dans son contexte, ce qui la rend idéale pour de nombreuses tâches de traitement du langage naturel. C'est la même architecture que celle des modèles de pointe comme ChatGPT et GPT-4o, preuve de son efficacité pour comprendre et générer un texte proche du langage humain.
Le modèle DCLM-7B est disponible pour la recherche et le développement sous la licence Apple Sample Code. Cette approche open source favorise l'adoption et la collaboration au sein de la communauté IA.
En rendant ce modèle accessible, Apple soutient la démocratisation de l'IA et permet aux chercheurs et développeurs du monde entier d'expérimenter et de bâtir sur ce modèle de base.
Avec 7 milliards de paramètres, DCLM-7B trouve un bon compromis entre performances et efficacité de calcul.
Cette taille autorise l'exécution sur la plupart des configurations hautes RAM/VRAM et sur les plateformes cloud, ce qui le rend polyvalent et accessible pour de nombreux usages. Le grand nombre de paramètres lui permet de capturer des schémas linguistiques complexes et d'élargir l'éventail des tâches qu'il peut mener.
Le modèle a été entraîné sur un vaste jeu de données de 2,5 billions de jetons, offrant une base solide pour de nombreuses tâches de langage. Cela permet à DCLM-7B de comprendre et de générer du texte avec un haut niveau de précision et de pertinence. Par ailleurs, cela en fait un bon candidat pour un affinage spécifique à une tâche, puisqu'il dispose d'une compréhension robuste de l'anglais.
Le modèle de base DCLM-7B dispose d'une fenêtre de contexte de 2 048 jetons, ce qui lui permet de traiter des séquences de texte relativement longues. Même si cela reste modeste au regard des standards actuels, Apple a également publié une variante avec une fenêtre de 8 000 jetons.
Cette fenêtre étendue offre davantage de souplesse pour traiter de longues entrées, ce qui convient aux applications nécessitant l'analyse de textes ou documents volumineux, comme la génération augmentée par la recherche (RAG).
Apple a rendu le modèle DCLM-7B compatible avec la bibliothèque transformers de Hugging Face, ce qui facilite son accès et son utilisation.
Vous trouverez la page du modèle sur Hugging Face et des informations complémentaires dans le dépôt GitHub. Pour utiliser et accéder au modèle, installez la bibliothèque transformers :
pip install transformersNous aurons également besoin d'installer le framework open_lm :
pip install git+https://github.com/mlfoundations/open_lm.gitLa version en pleine précision de DCLM-7B est volumineuse, environ 27,5 Go, et nécessite beaucoup de RAM ou de VRAM pour tourner. Vous aurez besoin d'une machine haut de gamme ou d'un environnement cloud. Pour ma part, j'utilise un notebook Google Colab premium avec 50 Go de RAM et un GPU L4.
Une fois les bibliothèques installées, nous pouvons commencer à utiliser le modèle.
Pour l'exemple, j'exécute un cas de base fourni sur la page Hugging Face du modèle. D'abord, importons les bibliothèques nécessaires :
from open_lm.hf import *
from transformers import AutoTokenizer, AutoModelForCausalLM
Ensuite, il faut télécharger et initialiser le tokenizer et le modèle (notez que, pour cet exemple, nous faisons tourner le modèle en pleine précision sur un CPU) :
tokenizer = AutoTokenizer.from_pretrained("apple/DCLM-Baseline-7B")
model = AutoModelForCausalLM.from_pretrained("apple/DCLM-Baseline-7B")
Enfin, exécutons l'invite d'exemple :
inputs = tokenizer(["Machine learning is"], return_tensors="pt")
gen_kwargs = {"max_new_tokens": 50, "top_p": 0.8, "temperature": 0.8, "do_sample": True, "repetition_penalty": 1.1}
output = model.generate(inputs['input_ids'], **gen_kwargs)
output = tokenizer.decode(output[0].tolist(), skip_special_tokens=True)
J'ai obtenu la sortie suivante :
[Machine learning is not the solution to everything, it just enables you to solve a problem that otherwise would have been impossible. The biggest challenge for me as a manager of an AI team was to identify those problems where machine learning can really add value and be successful.]L'affinage du modèle DCLM-7B permet de l'adapter à des tâches spécifiques et d'améliorer ses performances dans vos applications. Malheureusement, DCLM-7B n'est pas pris en charge par la bibliothèque peft de Hugging Face ; il faut donc utiliser la bibliothèque transformers pour l'affiner.
Sans des outils comme LoRA, affiner un modèle de cette taille demande d'énormes ressources, quasiment équivalentes à un entraînement complet depuis zéro. Je me contente donc d'esquisser ici le processus d'affinage sans l'exécuter pour en observer les résultats.
Pour télécharger et utiliser un jeu de données ouvertement disponible, nous allons utiliser la bibliothèque datasets de Hugging Face. Installez-la avec la commande suivante :
pip install datasetsUne fois installée, importez et utilisez la fonction load_dataset. Pour cet exemple, j'utilise le jeu de données wikitext :
from datasets import load_dataset
dataset = load_dataset('wikitext', 'wikitext-2-raw-v1')
Nous devons maintenant tokenizer le jeu de données :
def tokenize_function(examples):
	return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=512)
tokenized_datasets = dataset.map(tokenize_function, batched=True)
Nous sommes prêts à lancer l'affinage.
Pour l'affinage, importez et initialisez les objets TrainingArguments et Trainer, puis exécutez la fonction train().
from transformers import TrainingArguments, Trainer
training_args = TrainingArguments(
	    report_to = "none",
	    output_dir="./results",
	    evaluation_strategy="epoch",
	    learning_rate=2e-5,  # Contrôle l'ampleur de la mise à jour des poids du modèle pendant l'entraînement
	    per_device_train_batch_size=2,  # Nombre d'échantillons par lot et par appareil en entraînement
	    per_device_eval_batch_size=2,  # Nombre d'échantillons par lot et par appareil en évaluation
	    num_train_epochs=3,  # Nombre de passages complets sur le jeu de données d'entraînement
	    weight_decay=0.01,  # Technique de régularisation pour éviter le surapprentissage
	)
trainer = Trainer(
	    model=model,
	    args=training_args,
	    train_dataset=tokenized_datasets['train'],
	    eval_dataset=tokenized_datasets['test'],
	    data_collator=data_collator,
	    tokenizer=tokenizer,
	)
trainer.train()Dans l'ensemble, DCLM-7B d'Apple constitue une avancée notable dans le paysage des modèles de langage open source, offrant aux chercheurs et développeurs un outil puissant pour diverses tâches de NLP.
En tant que modèle Transformer à décodeur seul, il est optimisé pour la génération de texte, avec des sorties cohérentes et pertinentes. Sa disponibilité sous la licence Apple Academic Software License Agreement encourage encore davantage la collaboration et l'innovation au sein de la communauté IA.
Formez-vous à l'IA avec ces cours !
Cours
Cours
Cours